
生成式AI的崛起:一本 2023 年的行业剪报,两个同名章暴露了它没人通读
微信读书《生成式AI的崛起》· 抓取 256 屏 / 27 章 / 135 条目录 · 读到书尾,用时 390.0 秒
逐字核对 6 屏 · p0006 书名条核对为本书(目录名与真实书名一致)· 2026-11-11
抽样点位怎么定的:这本书没有「节」的概念,256 屏被切成 140 段,平均一段 1.8 屏,所以均匀抽样没有意义,我按「结构疑点」定点核:p0012(第二章开头,看它怎么讲历史)、p0032(生成式AI的局限性与挑战,看论证密度)、p0067(第 8 章里出现 Whisper 论文图的那一屏)、p0083(第九章开头的市场预测图,看书里唯一的硬数字)、p0121 与 p0162(第十三章和第十八章,两章同名,去核对是不是真重复)。六屏约占 2.3%,样本不大,但这本书每屏的信息量也就那么多,六屏足够看清它的写法。
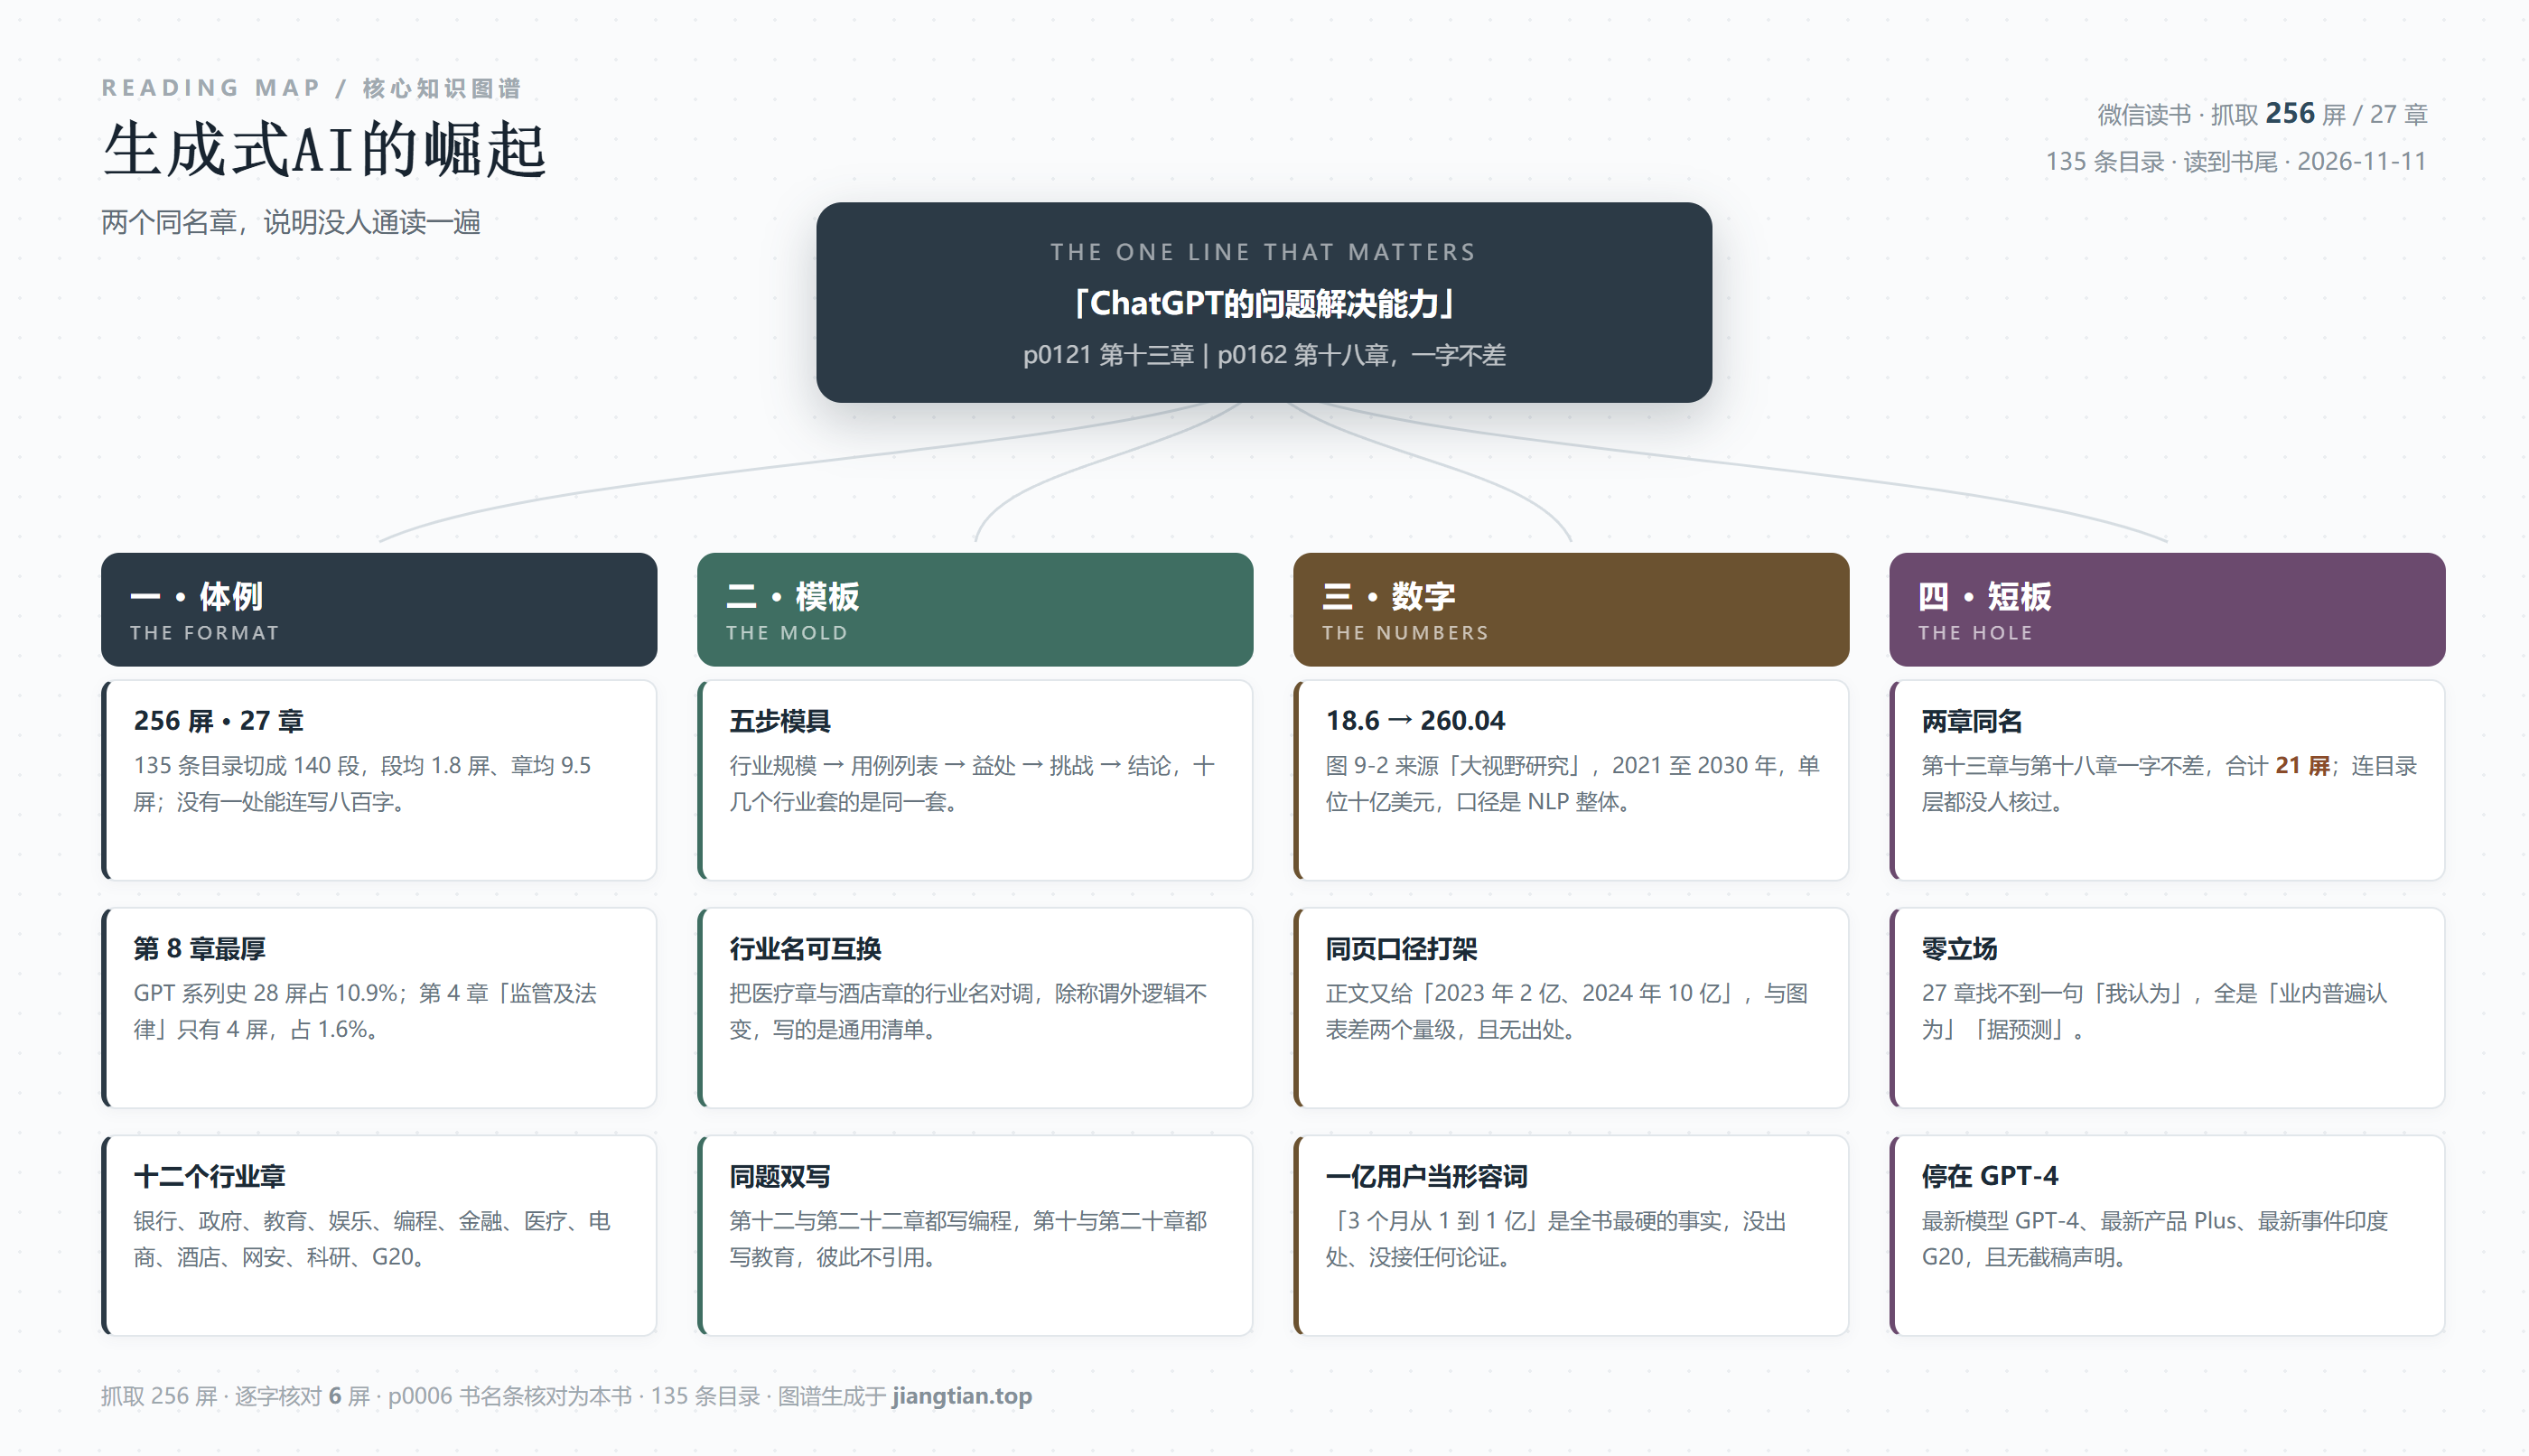
这本书读完,我最大的感受不是它写得差,是它不像一本书。二百五十六屏,二十七章,一百四十个段落,平均每个段落不到两屏——这个密度意味着全书没有一处地方能连续论证超过八百字。它更像一份被装订起来的行业剪报:每一段都是「某行业概况 + 市场数字 + 几个用例 + 益处与挑战 + 结论」的同一套模具,换一个行业名,再压一遍。
而它记录的世界,停在 2023 年上半年。书里最新的模型是 GPT-4,最新的产品是 ChatGPT Plus,最新的公共事件是印度 G20 峰会。书名里那个词——「崛起」——在 2026 年读起来像个过去时:它记录的不是趋势,是一个已经发生过的时间切片。
一、先算结构账:27 章,平均每章 9.5 屏
256 屏,27 章,135 条目录。把这个数摊开看:每章 9.5 屏,每章平均 5 个条目,每个条目不到 2 屏。
这个密度不是「简洁」,是「没法展开」。举个具体的:第四章「生成式AI的监管及法律问题」,全章 4 屏(p0021–p0024),其中「安全和保障」占 3 屏。生成式 AI 的监管在 2023 年是全球最热的政策议题之一——欧盟 AI 法案、美国各州立法、中国的生成式人工智能服务管理暂行办法——四屏能写什么?写一个「存在安全与保障问题,需要监管」的结论。
再看章节分布:第一章 ChatGPT 介绍 6 屏,第二章生成式AI模型的历史 4 屏,第三章银行业应用 5 屏,第四章监管 4 屏,第五章政府应用 5 屏,第六章内容真实性 7 屏,第七章技术概述 11 屏,第八章 GPT 系列历史 28 屏,第九章使用案例 13 屏,第十章教育及线上学习 7 屏,第十一章娱乐业 8 屏,第十二章编码 11 屏,第十三章问题解决能力 10 屏,第十四章金融业 8 屏,第十五章医疗 9 屏,第十六章电商 8 屏,第十七章酒店 6 屏,第十八章问题解决能力 11 屏,第十九章网络安全与科技政策 20 屏,第二十章教育科技 11 屏,第二十一章研究工作 12 屏,第二十二章编码工作 10 屏,第二十三章最新进展 6 屏,第二十四章当前市场 7 屏,第二十五章 G20 印度 6 屏,第二十六章 GPT-4 12 屏,第二十七章未来展望 5 屏。
换个角度看这 27 章:真正按时间写的只有第 8 章(GPT 系列史,28 屏)和第 26 章(GPT-4,12 屏),合计 40 屏、占 15.6%;剩下八成多全是按空间切的——按行业、按场景、按地区。按时间写能讲清因果,按空间切只能列清单。这本书选择了后者,所以它注定只能告诉你「AI 能干什么」,没法告诉你「事情为什么会走到这一步」。
这串数字里最值得注意的是两对:第十二章「编码」11 屏,第二十二章「编码及编程工作中的潜力」10 屏;第十章「教育及线上学习」7 屏,第二十章「教育科技」11 屏。同一个行业,被写了两遍,分居书的中间和后段,彼此不引用。
这不是巧合,是拼装出来的。一本书如果是先有提纲再写,不会把「编程」写两次;只有把若干篇现成的稿子按主题归堆,才会出现这种重复。
二、它其实只有一套模具,换了十几个行业名
我按它的章节顺序读,读到第五个行业章就摸清套路了。每一章都是这个顺序:
第一步,讲这个行业有多大、增长多快(配一句「据某机构预测」)。第二步,列三到五个「使用案例」,每个案例一两句,比如用 ChatGPT 写邮件、做客服问答、生成营销文案。第三步,列「益处」,通常是提效、降本、7×24 小时。第四步,列「挑战」,通常是准确性、隐私、偏见、监管。第五步,来一段「结论」,说这项技术潜力巨大但仍需谨慎。
这套模具本身没错,咨询报告就是这么写的。问题在于它被用了十几次,而每次的填充物几乎一样。第十五章医疗、第十六章电商、第十七章酒店,三章加起来 23 屏,讲的「案例」都是客服、内容生成、个性化推荐这三件事,只是把行业名换掉。
判断一本书是不是拼装,有个简单办法:把两章的行业名互换,看还读不读得通。我把第十五章(医疗)和第十七章(酒店)的行业名对调了一遍,除了几处「患者」「客人」的称呼,整段逻辑没有任何地方说不通。这说明它写的不是医疗,也不是酒店,写的是「AI 能做的事」的一个通用清单。
从标题就能看出这套模具的细度。第九章的用例小节是这么排的:「内容营销使用案例:介绍」「内容创作」「ChatGPT 在博客内容写作上的应用」「ChatGPT 在电子邮件营销中的应用」「其他与内容有关的使用案例」。五个小节,前两个是分类,第三个第四个是具体场景,最后一个是「其他」。「其他」出现在一个只有 13 屏的章节里,说明作者自己也知道这些场景列不完——但他没有选择收口,而是加了一个筐。
真正写行业的人不会这样。写医疗的人会讲病历结构化、会讲 HIPAA 与院内数据不出域、会讲模型说错一句剂量建议的后果;写酒店的人会讲 PMS 系统对接、多语种入住、旺季并发。这些「行业特有的约束」才是行业章的價值所在,而这本书里一条都没有。
「生成式AI可用于制造假新闻、假评论和其他形式的错误信息。这可能会为个人、企业及整个社会带来严重后果。错误信息可以通过社交媒体和其他在线平台迅速传播,导致产生混乱、恐慌甚至造成伤害。」—— p0032,「生成式AI生成内容的局限性与面临的挑战」之一条
这段话没有错,但它是零信息量的正确。它没有说清「假新闻」在生成式 AI 出现之前就存在、这一轮的不同在于单位成本下降了三个数量级;也没有给一个案例、一个数据、一条监管条文。它只是把常识重述了一遍,用「可能」「严重」「甚至」这些词加重量。
三、连章名都重复了:第十三章和第十八章,一字不差
这是我核对得最仔细的一处,因为我不太相信自己的眼睛。
p0121 的章标题是「第十三章 ChatGPT的问题解决能力」,下面第一节是「以定量方式解决问题的重要性日益增加」,正文讲定量方法、决策科学(Decision Science)、跨学科结合数学统计经济学心理学。
p0162 的章标题是「第十八章 ChatGPT的问题解决能力」——一模一样的七个字。下面第一节是「ChatGPT在各领域的问题解决潜力」,正文讲「ChatGPT 具有使用数学建模、神经网络及公式来解决基本问题的能力」,接着举例说明它处理的是「100 米等于多少毫米」之外的复杂问题。
两章相隔五章,同名,同主题,同样都在讲数学与推理。第十八章开头那句话尤其值得抄下来:
「ChatGPT具有使用数学建模、神经网络及公式来解决基本问题的能力。」—— p0162,第十八章 ChatGPT的问题解决能力,开篇第一句
这句话把「调用公式」和「理解公式」混成了一件事。模型能做的是把题面里的数代进一个它见过的解法模板,它不理解「为什么这个公式适用」。所以它在「100 米等于多少毫米」这类题上几乎不会错,在需要判断用哪个模型建模的题上会一本正经地胡说。这一点,第十三章讲了定量方法的重要性,第十八章讲了它「在各领域的潜力」,两章加起来 21 屏,恰恰没讲这个边界。
一本书出现两个同名章,通常只有一个原因:这本书没有经过一次通读式的编辑。有人负责第一章到第十三章,另一个人负责第十四章到第二十七章,两人各自觉得「问题解决能力」这个题目值得写,就都写了,然后合在一起,没人从头翻一遍。
对读者来说,这不只是浪费 21 屏(两章合计),而是信任问题:如果连目录层面的重复都没发现,正文里的数字和结论,凭什么相信被核过?
四、书里唯一的硬数字,是一张二手的市场预测
我在这本书里找到的最实的一处,是第九章开头的图 9-2「自然语言处理领域的增长预测(来源:大视野研究)」。柱状图纵轴到 320(单位十亿美元),横轴 2021 到 2030,柱上标着:2021 年 18.6、2022 年 25.86、2023 年 35.97、2024 年 50.01、2025 年 69.55、2026 年 96.71、2027 年 134.48、2028 年 187、2030 年 260.04。
这张图有两个问题。
第一个是口径。它标的是「自然语言处理领域」,不是 ChatGPT,也不是生成式 AI。NLP 是个老行业,包含语音识别、机器翻译、文本分析、情感计算,ChatGPT 只是它 2022 年底冒出来的一小块。用一张 NLP 整体市场的预测图,去给「ChatGPT 的使用案例」这一章开头做背书,是咨询报告里最常见的偷换——图的标题诚实,用法不诚实。
第二个是同一页正文紧接着又给了一组完全不同的数字:「预计到 2023 年,它将创造 2 亿美元的收入,到 2024 年则有 10 亿美元左右」。上一段图表说 2023 年整个 NLP 市场 359.7 亿美元,下一段正文说 2023 年「它」创造 2 亿美元。两个数字放在同一页,一个量级差 180 倍,读者根本不知道该看哪一个。而这两个数一个来自「大视野研究」,一个没写来源。
顺便说一个细节:这张图的横轴从 2021 到 2030,按年份该有十根柱,实际只标了九根——2028 之后直接跳到 2030,2029 那根不见了。柱子的高度是连续上升的,所以读者不会注意,但一个把预测图当论据的段落,连横轴都少了一年,说明它没有被复核过。
再往后还有一句:「只用了短短 3 个月,它就几乎实现了用户数从 1 到 1 亿的突破。」这句是全书最有价值的事实之一——它是 ChatGPT 现象的核心数据——但它被塞在段落中间,没有出处、没有时间点、没有和后面任何论证挂钩。一本讲「崛起」的书,把一个「两个月一亿用户」的事实当形容词用,这是对材料最大的浪费。
五、第 8 章那 28 屏,是全书唯一有连续叙事的地方
如果要给这本书找一处「像书」的地方,我选第 8 章「GPT系列的历史沿革及发展」。28 屏,占 10.9%,是全章最厚:GPT-1 三屏(p0048–p0050)、GPT-2 六屏(p0051–p0056)、GPT-3 六屏(p0057–p0062)、GPT-3.5 与 InstructGPT 三屏(p0063–p0065),然后是「GPT-3 模型中 API token 的成本缩减」五屏、API 定价模型一屏、ChatGPT 的技术局限性一屏。
这一段有真正的时间线,能看出模型能力是怎么一级一级跨上去的:从「能续写」到「能按指令做事」,中间的转折点是 InstructGPT 那一步——用人类偏好做强化学习,把「预测下一个词」的模型调成「按你要的方式回答」的助手。这是全书最该被讲透的技术转折。
但它只分到 3 屏,和 GPT-1 一样多。后面 6 屏给了 token 成本与 API 计价。一本讲「崛起」的书,给计价 6 屏、给对齐 3 屏,这个比例已经把作者的关注点写清楚了:他关心这门生意怎么算钱,不太关心它为什么突然会听话。
而且这一段还漏了三件本该有的东西:训练数据的来源与规模、一次训练的成本量级、「能力涌现」这件事到底有没有争议。第三件尤其可惜——2023 年之后学界对「涌现」有大量反例(换一个度量指标,很多「突然出现」的能力其实是平滑上升的),这本书写于争议开始之时,本来有机会把它记下来。
六、还有一屏,图和小节不在一个话题上
p0067 让我停了一下。这一屏的上半是图 8-8「通过训练课程进行文本处理的过程(来源:Whisper论文)」,下半是图 8-9 的编码器—解码器架构图,正文在讨论 Whisper 与 LibriSpeech 数据集的关系:「Whisper 的表现并不优于专门研究 LibriSpeech 性能的其他模型,因为它在一个广泛而多样的数据集上开展训练,并不针对任何特定的数据集。」
这段内容本身准确——Whisper 的卖点是泛化而不是在单一基准上刷分。但它所在的节标题是「GPT-3模型中API token的成本缩减」。一个讲语音识别模型训练数据的话,落在一个讲 API 计价的标题下面,两者之间没有任何过渡。
我不确定这是书本身的编排问题,还是抓取时章节标签对不齐——毕竟这本书的段落标签本身就很碎(140 段对 135 条目录)。所以我只把它记下来,不当作主要批评。但它确实反映了一种状态:这本书里图、文、标题三者之间的咬合度很松,读者必须自己判断「我现在看的这段到底属于哪个话题」。
七、它的短板
第一,没有作者立场。全书 27 章,我找不到一句「我认为」。所有判断都是转述式的:「业内普遍认为」「专家指出」「据预测」。这不是客观,这是没有观点。一本讲「崛起」的书,如果不敢说「哪一部分是真变化、哪一部分是泡沫」,它就只是把公开信息重排了一遍。
第二,时间戳太硬,且没有自我声明。书里最新的模型是 GPT-4(第二十六章 12 屏)、最新的产品是 ChatGPT Plus、最新的政策事件是印度 G20。它没有在前言里写清「本书截稿于 2023 年 X 月」,于是读者会默认它讲的是当下。这在 2023 年不算问题,在 2026 年是致命问题——因为「生成式 AI 的崛起」这件事,恰恰在这三年里才真正展开。
第三,数据几乎全是二手,且没有交叉验证。「大视野研究」的市场预测、各类「据预测」的增长率,这些是行业报告的原料,不是研究结论。把二手预测当论证,最大的风险是:预测本身就带商业目的(卖报告),而书把它们当客观事实引用。全书我没看到一处对同一指标给出两个来源的对照。
第四,行业章没有行业知识。前面说过,十几个行业章可以互换行业名而逻辑不变。这意味着它们提供的信息增量接近零——真正的行业读者看完会觉得自己什么都没学到,非行业读者看完会以为自己学到了。
第五,结构重复无人收口。两个同名章(第十三、十八章)、两组同题章(第十二/二十二章编码、第十/二十章教育),这四处至少浪费 40 屏。256 屏里 15.6% 是重复劳动。
八、那它还剩什么用
说句公道话,这本书有一个别人替代不了的功能:它是 2023 年上半年的一手切片。
如果你要写一份「生成式 AI 是怎么被谈论的」的材料——比如研究技术话语、研究行业 hype 的形成过程、或者给非技术同事做一次「当年大家是怎么想的」的分享——这本书很有用。它完整记录了那一年的语汇:iPhone 时刻、颠覆、赋能、新质生产力还没出现但「重塑」已经满天飞。它把那些话原样保存下来了,这本身就是史料。
具体说,这本书有三类材料是可以直接拿去用的。第一类是语汇:2023 年上半年大家怎么谈这件事,「iPhone 时刻」「重塑」「赋能」这些词在什么语境里被使用,它原样保留了。第二类是市场预测的样本:不是让你信这些数,是让你看到当年机构给出的曲线长什么样、口径怎么定、后来兑现了多少——这本身就是一份很好的「预测失灵」研究素材。第三类是用例清单:十二个行业、几十条「X 用在 Y 上」的短条目,做竞品调研或者给老板解释「同行都在干什么」时,可以直接当索引翻。
但它不能当技术书读。全书技术内容集中在第七、八、二十六章(技术概述 11 屏、GPT 系列 28 屏、GPT-4 12 屏),合计 51 屏,讲的是 GPT-1 到 GPT-4 的演进和 Transformer 架构,深度大致相当于一篇长一点的科普。真正想搞懂模型的人,这 51 屏不够,得去看论文。
它也不能当行业指南读。行业章没有行业约束,看完不知道明天上班该怎么用。
如果非要读,我给一个三小时的读法:先看第 8 章(GPT 系列史 28 屏),把模型演进的时间线建立起来;再看第 26 章(GPT-4,12 屏)补上终点;然后翻第 23、24 章(最新进展、当前市场,共 13 屏)看它怎么判断商业格局;最后挑一个你所在行业的那一章,看它写得多浅——这一遍下来你会得到一个准确的印象:这本书的信息密度约等于一份券商行业报告的摘要,而它最强的部分,是那些被原样保存下来的 2023 年语汇。
一句话:它是一本 2023 年的行业剪报,被装订成了书——史料价值真实,方法价值接近于零;同名章节出现两次这件事,比书里任何一个结论都更能说明它是怎么做出来的。
九、如果让我重编这本书
批评容易,重编难。但我还是想说说这本书本来可以怎么排,因为它的材料其实够——一百多屏的行业用例、二十多屏的模型史、几张真图表的二手数据,这些料凑得出一个像样的东西。
第一,把同题章合并。第十三与第十八章合成一章「ChatGPT 能算什么、不能算什么」,21 屏压到 12 屏,省下来的 9 屏用来写真正的边界:它在多步推理上会崩、在需要外部事实时会编、在数学上靠的是模式匹配而不是符号运算。这三条比「潜力巨大」有用一百倍。
第二,把行业章从十二个减到三个,但每个写深。选医疗、金融、教育——不是因为它们最重要,而是因为它们各有硬约束:医疗有合规与责任归属,金融有实时性与审计,教育有未成年人保护与教学法。把这三件事写透,读者自然能推到自己的行业;写十二个浅的,读者一个都推不过去。
第三,给数据加一张对照表。书里所有的市场预测都是单来源的。至少该做一张表:同一指标(比如 NLP 市场规模)列三家机构的预测,让读者看到分歧。分歧本身就是信息——它告诉你这个数不可靠。
第四,加一张术语与产品的年表。这本书里出现的模型、产品、政策事件全是散落的,GPT-1 到 GPT-4、ChatGPT Plus、G20、欧盟立法,读者得自己在脑子里排时间。一张四列年表(年份、模型或产品、关键能力、同期政策)就能把它们锚住,而且这张表在三年后依然有用——它是唯一不会随版本过期的东西。
这三条都不需要新素材,只需要一个从头读到尾的编辑。而这本书缺的,恰恰就是这个人。
说明:章屏数由 pages.jsonl 段落边界全量聚合(该书 256 屏被切成 140 段,段均 1.8 屏),第 8 章 28 屏最长(10.9%),第 19 章 20 屏(7.8%),第四章监管仅 4 屏(1.6%)。经目视核对,第十三章(p0121)与第十八章(p0162)章名完全一致;第十二章「编码及编程」与第二十二章「编码及编程工作中的潜力」、第十章「教育及线上学习」与第二十章「教育科技」为同题双写,四处合计约 40 屏 · 笔记与图谱生成于 2026-11-11
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。 看完整履历海报 → skills 实验室 →
发表评论: