
人工智能编程趣味启蒙:它教的是编程,不是人工智能
微信读书《人工智能编程趣味启蒙:Mind+图形化编程玩转AI》· 抓取 280 屏 / 11 章 / 74 条目录 · 读到书尾,用时 390.0 秒
逐字核对 9 屏 · p0006 为序二末页署名(王春秋,2021 年 9 月),页顶书名条核对为本书(目录名与真实书名一致,仅去掉了加号和全角括号里的「AI」)· 2026-11-11
抽样点位的选法:这是一本给 7–12 岁孩子用的图形化编程教材,骨架是「故事 → 科普 → 模块 → 动手 → 小结」的五段循环,十一章走十一遍。所以我不读步骤,只读它讲「知识」的那两段:先是序言(p0004 序一「写给大朋友们」,p0006 序二末页),因为一本教材的定位通常只在前言里说实话;再是每章唯一讲原理的「科技面对面」(p0054 百度翻译、p0126 语音识别模块、p0211 物体识别);然后是它唯一舍得给两个子节的第 8 章(p0183 KNN 原理、p0185 ML5 模块);最后取一屏纯操作(p0085 川剧变脸的目标实现)和一屏 AI 应用场景总述(p0019)。重点压在三个问题上:一是书名里「人工智能」这四个字,在正文里占多少;二是孩子跟着做一遍,学到的是原理还是接口;三是这种写法在 2026 年还能不能用。抽读 9 屏约占 3.2%;各部分屏数由 pages.jsonl 逐页章节标签做全量聚合。
先给结论:这是一本写得挺认真的图形化编程教材,但它不是一本讲人工智能的书。
这两个判断之间没有矛盾,只是书名把它们硬凑成了一句。《人工智能编程趣味启蒙》这个名字给人的承诺是:孩子读完会知道 AI 是怎么回事。而实际上,280 屏里真正讲 AI 的,是每一章中间那一节「科技面对面」,一共 18 屏,占 6.4%。
我数得很细。11 章,每章一节「科技面对面」,一共 11 节,占 18 屏——多数章 2 屏,最长的第 5 章人体姿态识别因为要分成「一起读一读」和「一起说一说」,给了 3 屏;最短的第 3 章百度翻译,只有 1 屏。
剩下的 262 屏是什么?「小麦的秘密武器」讲模块和指令,65 屏(23.2%);「目标实现」「功能实现秘籍」讲一步步怎么做,109 屏(38.9%)。这两块加起来 174 屏,占 62.1%,全是软件操作。再加前置 15 屏(5.4%)、章首页 11 屏(3.9%)、每章末尾的「小故事」8 屏(2.9%)、素材准备与其他小节 54 屏(19.3%),就凑满了 280 屏。
所以这本书的真实身份是:一本 Mind+ 的操作教程,外包了一层 AI 科普的引言。这个判断不是贬义,操作教程也是刚需,很多老师就缺一本能照着上课的手册。但它和封面上那六个字对不上。
一、先说它做对的事:十一个项目,没有一个在识别猫和狗
批评之前,得承认它在选题上花了心思,而且花在了正确的地方。
少儿 AI 教材最容易犯的错,是拿「识别猫狗」「识别手写数字」当项目。这两个题在英文教材里泛滥成灾,因为 MNIST 和 CIFAR 就在那儿摆着,拿来就能跑。但一个中国小学生做完「识别猫和狗」,除了记住「AI 很厉害」,什么也留不下——猫和狗跟他的生活没有关系。
这本书没有走这条路。它的十一个项目是:视频侦测、文字翻译、人脸追踪做川剧变脸、人体姿态识别做试衣镜、语音识别改造智能小家、手势识别做春节云拜年、KNN 分类做五禽戏、物体识别做垃圾分类、人脸对比判断「更像爸还是更像妈」,最后一章搭一个 AI 机器人硬件。
这份选题表里至少有四个是真动了脑子的。
川剧变脸这个设计尤其聪明。p0085 把整个玩法拆成三步:第一步,开启 AI 人脸追踪功能,点绿旗,用舞台显示摄像头画面,小麦会提示「按下空格键开启川剧变脸之旅吧」;第二步,按下空格键,小麦隐藏,同时播放背景音乐(比如歌曲《说唱脸谱》),摄像头识别到人脸后,脸谱出现在舞台上并跟着脸移动;第三步,当用手挡住脸再快速移开手,让脸部重新被摄像头识别到时,脸谱就会切换到下一个造型,实现变脸。
第三步是整个项目的心脏。它把「人脸检测」这件事变成了一个可玩的判定条件——不是「检测到人脸就显示脸谱」这么无聊,而是「人脸消失再出现」这个状态变化触发换脸。孩子为了玩这个游戏,会反复挡脸、松手,反复观察屏幕上的反应,这个反复的过程本身,就是他在理解「摄像头每一帧都在做一次检测」这件事。这比讲十遍「计算机视觉是逐帧处理图像」有用。
五禽戏也是同理。用 KNN 分类去认虎、鹿、熊、猿、鸟五种动作,题材是中医导引术,动作幅度大、区分度高,正好适合姿态识别;而且孩子做完会知道「原来我摆的姿势叫虎举」。这种把身体放进项目里的设计,是屏幕教学里最难得的东西——多数编程课是坐着的,这个项目必须站起来。
还有一个容易被忽略的优点:它真的零成本。p0185 讲 ML5 模块时说得很清楚:「KNN物体分类器是Mind+中『机器学习(ML5)』模块里的一个功能,在不需要网络的环境下,只需要一台计算机及一个普通的USB摄像头,即可完成机器学习的课程。」这对学校机房是硬需求——不是每所学校都能给学生配账号、开外网、装驱动。一个 USB 摄像头加一台装了 Mind+ 的电脑就能上课,这个门槛低到几乎不存在。
序二末页(p0006)也把这份心思说出来了:Mind+ 支持 IoT、机器学习、KNN 物体分类、PoseNet 姿态追踪、ASR 语音识别、文字处理以及百度 AI 服务器等多种功能,「而且 Mind+ 平台完全免费开放,是天然的图形化编程零基础、零成本学习平台。本书里的每一个项目,都无须复杂的编程技能,无须任何 AI 知识储备」。
这段话是实话,也是这本书最大的价值所在:它证明了一个孩子不懂矩阵、不懂梯度、不懂神经网络,也能做出一个「看起来像 AI」的作品。这件事本身有意义。它把 AI 从神坛上拽下来,变成孩子手里能捏的东西。
二、最典型的一屏:百度翻译,一段话加一张截图
现在说那 18 屏的问题。
p0054 是我在全书里看得最久的一屏,因为它是第 3 章唯一的「科技面对面」,整节就这一屏。
它的全部内容是:一张百度翻译网页的截图(左边输入「我在周日看了一本书」,右边输出「I read a book on Sunday」,中间是逐词对照的小卡片),加下面一段大约一百三十字的说明:
「百度翻译用到的是神经网络翻译系统技术。很久以前,机器翻译一门语言是逐字逐句地翻译,有些文字还有一词多义的情况,所以很难理解语言所要表达的准确意思。而神经网络翻译系统技术会先理解语句的意思,再用另外一种语言表达所识别的语句意思。在理解的过程中,系统会从海量的数据库中寻找匹配的语境、通过算法模型得出结论,最后形成我们所看到的翻译结果。」
这段话对不对?对。它准确指出了机器翻译从「逐词替换」到「先理解再表达」的转变,也提到了「一词多义」这个真问题。但它停在了「是什么」,一步都没往「为什么」走。
「系统会从海量的数据库中寻找匹配的语境」——这句话里的「数据库」是什么?它不是数据库,是模型参数。一个 2021 年出的书,用「数据库」来解释神经网络翻译,等于告诉孩子「翻译软件在查一本很大的词典」。这恰好是错的,而且错得很有害:如果孩子以为 AI 是在查表,他就永远理解不了为什么 AI 会编造。查表不会产生幻觉,生成才会。
「通过算法模型得出结论」——这句话等于没说。「算法模型」是一个筐,什么都能装。孩子读完这七个字,脑子里不会形成任何图像。
再看那张配图。它不是示意图,是百度翻译网页的产品截图。截图这个东西有个致命问题:它展示的是「结果」,不是「过程」。孩子看到「我在周日看了一本书」变成「I read a book on Sunday」,他学到的是「这个软件挺好用」,而不是「注意力机制在这里把『周日』和 on Sunday 对齐了」。
而这本书明明有能力画示意图。p0183 讲 KNN 的时候就画了:一张散点图,红的、蓝的、绿的各自成簇,中间一个新点,看它离哪一簇最近。那张图一句话就能看懂,而且看懂了就不会忘。同一个作者,在 KNN 那里会画示意图,在机器翻译这里只剩截图——这个落差不是能力问题,是篇幅问题。
一屏。整章关于 AI 的全部内容,一屏。而这一章的操作部分有多少屏?第 3 章一共 23 屏(8.2%),其中「科技面对面」1 屏,剩下的 22 屏是:素材准备、模块加载、积木怎么拼、文字翻译小助手怎么做完、最后还有一个「语言的数字」讲字符编码。
1 比 22。这个比例,就是这本书的价值观。
三、第 8 章是唯一的例外,也是最好的证明
如果这本书从头到尾都是 p0054 那个水平,我也不会写这么长。问题是它有一章写得完全不一样,而那一章恰好证明了「它能写好,只是没写」。
第 8 章讲 KNN 分类,做五禽戏。p0183 那一屏是全书密度最高的一屏:
「KNN(K Nearest Neighbor)意思是 K 个最近的邻居。KNN 是一种分类算法。在 Mind+ 中,它会记住所有训练的图片数据,记住数据后,当再次识别一张新的图片数据时,会在已经训练过的数据中去匹配最相近的结果,将其作为识别结果。在训练的过程中,数据量越大,最终识别的结果也就越好。」
然后配一张示意图:左边是三种颜色的点各自成簇,一个新样本落在红簇边上;右边是五禽戏的动作示意。下面接着一句:「KNN 分类的功能能够让我们感受到机器学习的过程,让我们了解到为什么计算机能够认识香蕉、苹果和西瓜。」
这一屏干了三件事,这三件事恰好是「AI 启蒙」应该干的三件事。
第一,它给了一个可以复述的定义。「K 个最近的邻居」——这五个字孩子能记住,而且记住了就能推:「那 K 是我自己定的数?」「那如果周围红点蓝点各一半怎么办?」这些问题都能从定义里自己长出来。
第二,它讲了机制,而且机制是可操作的。「记住所有训练数据,新数据来了去比最相近的」——这句话描述的是一个孩子能想象的过程,不需要矩阵,不需要梯度,甚至不需要「模型」这个词。
第三,也是最关键的一句:「数据量越大,最终识别的结果也就越好。」
这句话在整本书 280 屏里只出现了一次。但它是我认为全书最重要的一句话,因为它是唯一一句告诉孩子「模型的好坏取决于你喂它什么」的话。
为什么这句重要?因为一个孩子如果只知道「AI 很聪明」,他会把 AI 当魔法;如果他知道了「AI 的好坏取决于数据」,他就开始有了一个可以质疑的抓手——他会问:这个 AI 是用什么数据训的?那些数据里有没有我?这个问题一旦问出来,AI 素养这件事就开始了。全世界所有的 AI 伦理教育,根子都在这一句上。
而且这一章还不止于此。8.2 下面分了两个子节:8.2.1「一起读一读」讲定义和机制,8.2.2「一起说一说」讲类比——原文用「我们小时候是怎么认识身边的事物的呢?譬如我们是怎么认识飞机的?最开始可能是在书本或电视上看见了不同形状的飞机」来类比机器学习。全书 11 章,只有这一节舍得分两个子节。其他 10 章的「科技面对面」都是一屏到底,读完就翻页。
所以我的判断是:作者完全知道该怎么讲 AI,他只是在 10 章里选择了不讲。这不是能力问题,是取舍——而取舍的标准很清楚:讲原理的时间,要留给操作步骤。
四、序一其实把话说清楚了,问题是书名没说
写到这里我回头去读了序一,然后发现作者其实比我想的清醒。
p0004 是「序一 写给大朋友们」。它开头就把一个尖锐的问题摆出来了:「编程教学就是噱头,孩子们根本不需要从小学习编程。于是,许多人又陷入了这样的沉思——到底要不要让我的孩子学习编程?学编程到底又是为了什么?」
然后作者的回答是这样的:教育学理论指出,7–12 岁是孩子逻辑思维的最佳形成期;图形化编程是一种非常直接的训练逻辑思维方式的方式,「编程的过程也可以看作是一种让逻辑『可视化』的过程」;接着举了「楼道灯」的例子——想做出声控、光控、亮灯的效果,孩子需要自己决定判断条件的先后顺序,决定用「与」模块连接两个核心条件来实现同时判断,还要自己设计触发亮灯的条件和亮灯的持续时间,「每一步的设计,都是学生逻辑思维的展现」。
再往后:「图形化编程的迅速反馈以及程序的易读性,令学生无论是在任何一个阶段发现问题,都能够高效地回过头再分析、试错,直到最终成功。这样『编写-测试-调整-再测试』的周期是非常短的,因而在这个过程逐步建立起的还有试错思维,以及面对失败的正确心态。」最后落到:「作为一种培养思维能力的手段,笔者更愿意将图形化编程定位为一种素质教育。」
这段话说得非常漂亮,而且它说的是实话。它把这本书的定位讲清楚了:这是一本用图形化编程训练逻辑思维的书,不是一本讲 AI 技术的书。楼道灯那个例子,讲的是条件判断的顺序和「与」逻辑,跟 AI 一点关系都没有——但它确实是编程启蒙里最该讲的东西。
所以问题不在作者,在包装。
一本定位为「素质教育 / 逻辑思维训练」的书,被命名为《人工智能编程趣味启蒙:Mind+图形化编程玩转AI》。书名里「人工智能」四个字放在最前面,「Mind+」和「图形化编程」放在后面当定语。一个家长在书店看到这个书名,会以为买回去孩子就能懂 AI 了;一个老师看到这个书名,会以为可以拿它开一门 AI 课。而实际上,这本书的 AI 部分是 6.4%,逻辑思维训练部分是 62.1% 的操作加上 19.3% 的素材与小节。
这不是欺诈,是错位。而且这个错位有代价:一个冲着 AI 来的读者,会在第 3 章那一屏百度翻译之后感到失望,然后合上书;一个真正需要图形化编程教材的老师,可能因为书名里的「AI」以为它太浅或太专,反而错过。
更值得说的是:如果这本书就叫《Mind+ 图形化编程:十一个项目玩转 AI 模块》,它几乎无可指责。作为一本操作手册,它的五段式结构稳定、素材准备齐全、步骤编号清楚、每章还有小故事收尾,是一本老师能直接照着上课的书。它的问题只有一个——它承诺了一件它没打算做的事。
五、孩子跟着做一遍,学到的是接口,不是模型
这是我最想说的一节,也是最难说清的一节。
先看 p0126,第 6 章「小麦的秘密武器」。这一屏讲怎么加载语音识别和文字朗读模块:从「扩展」里找到「网络服务」,勾选「语音识别」和「文字朗读」,两个模块里的所有程序指令就都加载进来了。配一张 Mind+ 的扩展面板截图,用红圈标出两个模块。底下有一行小字注:「注:使用网络服务里的功能时,需要计算机连接互联网。」
这一屏是全书的标准形态:找到模块 → 勾选 → 出现积木 → 拖到脚本区。孩子照着做,会得到一个能听懂话、能说话的「智能小家」。整个过程不超过半小时,成就感很强,这是它的优点。
但请注意这半小时里发生了什么:孩子做的事情,是把一个已经训练好的语音识别服务,接到自己的程序里。他知道了「有一个模块叫语音识别」,知道了「勾选之后会多出几种积木」,知道了「要联网才能用」。他不知道的是:语音识别为什么能听懂话?它怎么把声波变成文字?为什么带口音会识别错?为什么安静环境下准、吵闹环境下不准?
这些「不知道」,恰恰是 AI 教育的核心。而这本书一个字都没讲。
p0211 是个反例,它讲了。这是第 9 章物体识别的「科技面对面」,也是少数几个有两屏的科普节。它先讲「机器之眼」:智能汽车不只是说「前方有障碍物,请减速停车」,而是「前方有小狗,请减速慢行」;智能手机在拍照时可以识别镜头前的人、物、景,自动进入相应的拍摄模式;遇见不认识的花时,拍个照,手机就会告诉我关于这朵花的故事。
然后 9.2.2「一起说一说」给了一个很具体的例子:
「例如『当我们看见一个人拎着一桶水在路上很吃力地走』,我们要让机器理解这个信息,该怎么判断这里面的信息呢?如通过物体识别可以看到画面中有『水桶』和『人』,并判断水桶和人的相对位置,通过人体的姿态和表情可以判断人走路的状态等。由此让机器看到此现象的时候,可以像我们人一样反馈出相应的信息。」
这一段写得很好,好在它把「一个判断」拆成了「多个识别的组合」。水桶识别 + 人识别 + 相对位置 + 姿态 + 表情,五个信号合起来才得出「他拎得吃力」。这就是多模态的本意,而且它用了一个孩子能想象的生活场景,没有用一个术语。
但即使在这一屏,它也只到「需要多个信号」为止。再往下那一步——这些信号怎么变成数字、怎么加权、怎么决定「吃力」还是「不吃力」——它没走。而这一步,才是「AI」和「传感器编程」的分界线。
所以整本书的认知层级停在了一个位置:AI 是一个个可以调用的能力,不是一个可以理解的东西。孩子学完十一章,会熟练地调用十种 AI 能力,会做十个漂亮的作品,会在同学面前演示川剧变脸和智能小家。但如果问他「这些能力是怎么来的」,他答不上来;问他「如果它认错了怎么办」,他也答不上来。
第二个问题更严重,因为全书 280 屏里,一次都没提过「认错了怎么办」。
没有准确率,没有混淆矩阵,没有「训练集和测试集」,没有「数据偏差」。p0183 讲了「数据量越大结果越好」,这是全部。但数据量大不等于数据好——如果一个人只用自己家的猫的照片训练,那这个模型见到别人家的猫就废了;如果一个班的孩子都是同一个姿势做五禽戏,那换个姿势就认不出。这些是 KNN 最容易讲、也最该讲的东西,因为 KNN 没有「隐藏层」可以躲,它的缺陷是肉眼可见的。作者手里握着一个最好的教学机会,只用了一半。
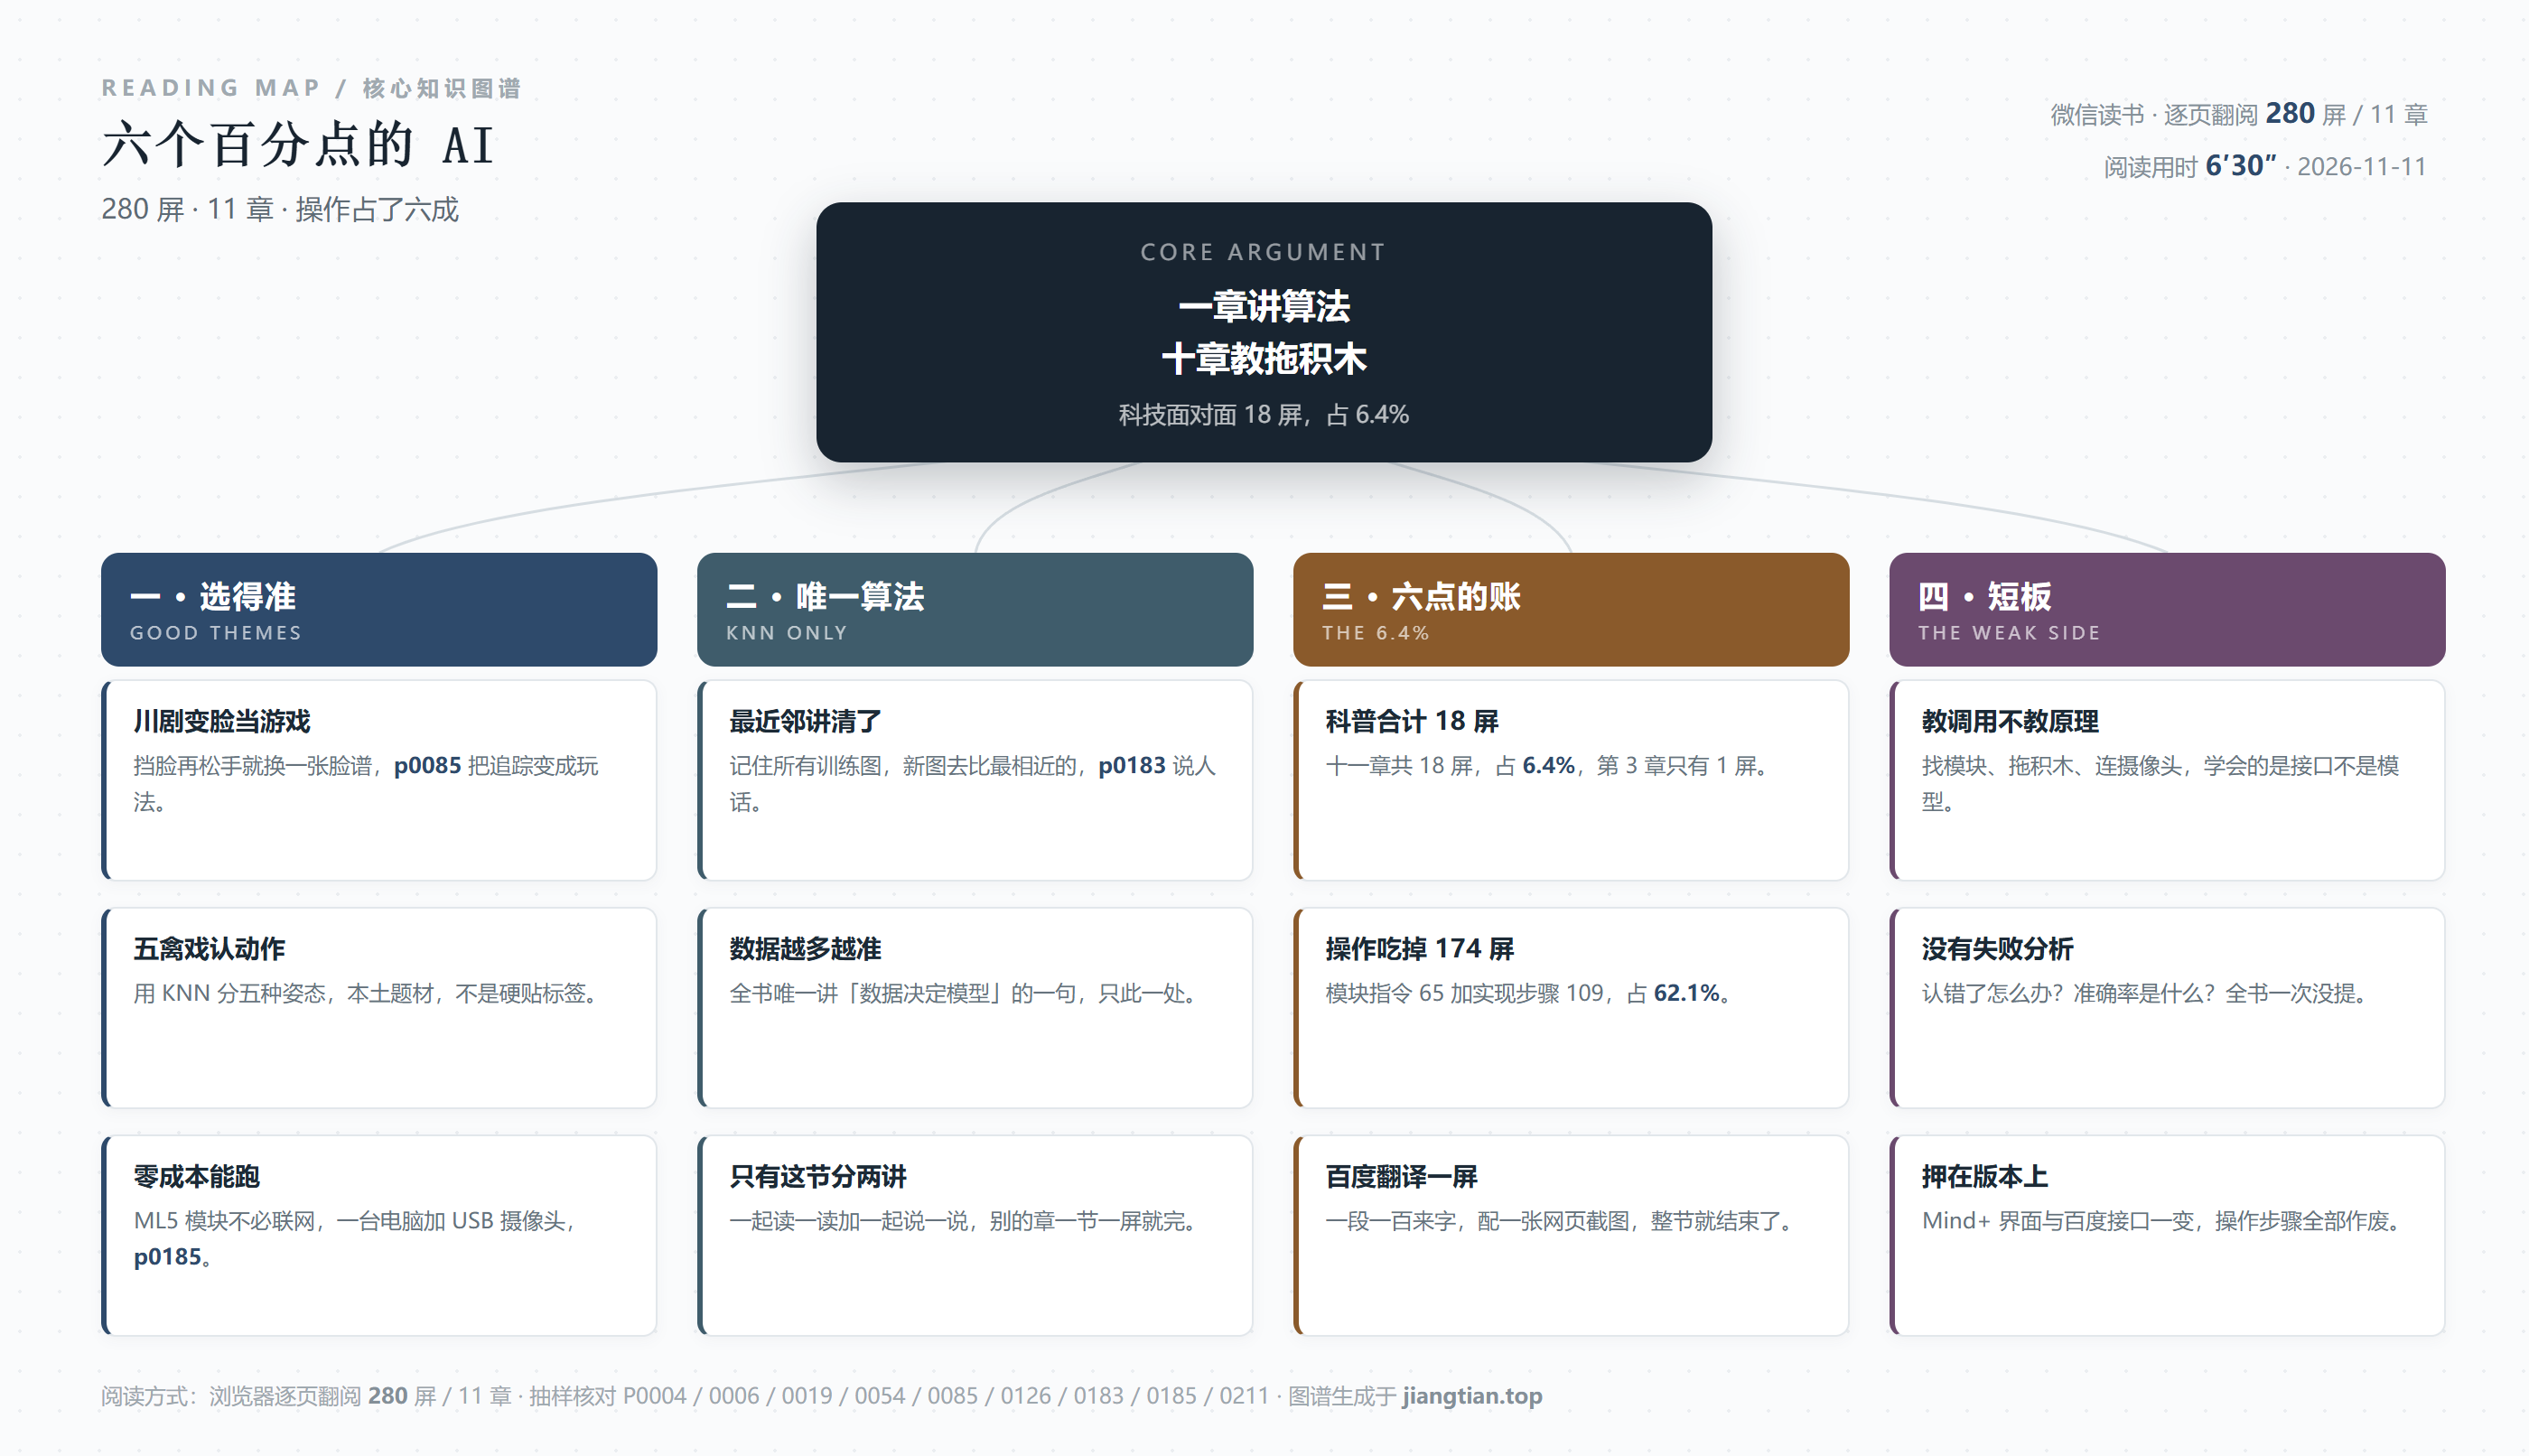
六、它的短板
五条,按严重程度排。
第一,书名承诺与内容配比严重错位。「人工智能」四个字在封面最前面,正文里对应的内容是 18 屏、6.4%。11 章里 10 章的 AI 科普只有一到两屏,第 3 章更是只有一屏。一本叫「人工智能启蒙」的书,AI 部分的篇幅还不如它的「素材准备」多。这个错位会让两类读者都吃亏:冲着 AI 来的读不到东西,需要编程教材的被书名劝退。
第二,62.1% 的篇幅是软件操作,这让全书押在了具体版本上。109 屏是实现步骤,65 屏是模块与指令说明,加起来 174 屏。这些内容有一个共同点:它们全都依赖于当时的 Mind+ 界面、当时的扩展面板、当时的百度 AI 接口。软件改一次版,按钮挪一个位置,截图就作废;接口调一次,语音识别那块积木就点不动。这不是这本书独有的问题,是所有操作类教材的通病——但当一本书 62% 的内容都是操作,这个风险就不再是「通病」,而是「主要风险」。p0126 那行「注:使用网络服务里的功能时,需要计算机连接互联网」,看着是提醒,其实也是一句保质期声明。
第三,只有调用,没有机理,孩子形成的是「魔法认知」。十种 AI 能力,全部以「勾选模块 → 拖积木」的方式交付。孩子学会了用,但不知道为什么要联网、不知道为什么要训练、不知道模型和人脑的区别。更进一步,全书没有区分「本地跑的模型」(ML5 的 KNN、PoseNet、mobileNet)和「云端服务」(百度翻译、语音识别、文字朗读)——这两类东西的成本结构、隐私含义、失效方式完全不同,而这本书把它们摆在同一个「扩展」面板里,长得一模一样。一个孩子会以为它们是一回事。
第四,没有评估,没有失败分析,没有数据伦理。这是最伤的一条。整本书教的是「怎么让它成功跑起来」,从来没教「它为什么会不成功」。没有准确率,没有测试集,没有「换个环境试试」,没有「你的训练数据里少了谁」。唯一接近的是 p0183 那句「数据量越大结果越好」,但它只讲了「多」,没讲「偏」。一个从小只学「怎么让 AI 工作」、不学「AI 什么时候会错」的孩子,长大之后会是 AI 最好的用户,也会是最容易被 AI 骗的人。
第五,最后一章依赖硬件,多数课堂用不上。第 11 章 17 屏讲「AI 硬件智造——小麦 AI 机器人」,从解锁新模式、认识机器人、硬件设备、功能实现一路讲到「小麦说」。这一章本身写得没问题,但它需要一整套硬件。对一间只有电脑和摄像头的机房来说,这 17 屏是读得懂、做不了的。而它被放在全书最后,作为「升级」,实际上把这本书的完整路径截断在了第 10 章。
那这本书该给谁用?我的判断是:
给要开一门「图形化编程」课的小学老师和要带孩子做项目的家长用,不给想让孩子「懂 AI」的人用。
如果你是前者,这本书是能用的。十一个项目选题本土、难度递进、素材齐全、每章结构一致,你照着排一学期没问题。孩子做完川剧变脸和五禽戏,会真的高兴,会真的记住「原来我摆的姿势可以被电脑认出来」。这个体验是珍贵的,而且不需要你懂 AI。
如果你是后者,这本书会让你误判。你买回去以为孩子在学 AI,其实他在学 Mind+。他不算被骗——他学到了别的东西,而且学得不错——但你想给的那件东西,他没拿到。
如果一定要用这本书做 AI 启蒙,我有一个建议:把每章那 1–2 屏「科技面对面」单独拎出来当课文讲,讲完再合上书,问孩子三个问题——这个东西它凭什么能认出来?它会在什么情况下认错?如果我把它认错的那一次记下来,能发现什么?这三个问题,书里一个都没有,但它们才是这本书应该有的部分。
一句话:它把 AI 拆成了十个能玩的玩具,玩得很好;但它没告诉孩子,玩具里面装着什么,也没告诉孩子,玩具什么时候会骗人。
说明:各部分屏数由 pages.jsonl 逐页章节标签全量聚合(前置 15 屏 5.4%、章首页 11 屏 3.9%、科技面对面 18 屏 6.4%、小麦的秘密武器 65 屏 23.2%、目标实现/功能实现秘籍 109 屏 38.9%、小故事 8 屏 2.9%、其他小节含素材准备 54 屏 19.3%,合计 280 屏);「操作占 62.1%」= 65+109;「科技面对面 18 屏」按 11 节逐条数出,第 3 章仅 1 屏、第 5 章 3 屏、其余各 2 屏;「抽读 9 屏约占 3.2%」按 9/280 计算 · 笔记与图谱生成于 2026-11-11
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。 看完整履历海报 → skills 实验室 →
发表评论: