
Generative AI with LangChain:它敢挑AI写的代码,没人挑它的译文
微信读书《Generative AI with LangChain》(Ben Auffarth,Packt)· 抓取 1040 屏,其中正文 988 屏、附录 52 屏
逐字核对 8 屏 · 2026-11-11 首次发布 · 分两段抓取:第 1–7 章 713 屏,第 8–10 章 327 屏(首轮在第 7 章末尾被回环守卫误判截断,已用目录跳转补抓)
抽样点位的选法:这是一本英文原版书,骨架是「概念 → 框架 → 环境 → 助手 → 聊天机器人 → 代码 → 数据科学 → 微调 → 上线 → 未来」十级台阶。我按三条线抽:一是它的开场态度(p0150,第 2 章讲大模型的局限,看它是吹还是泼冷水);二是它的技术内核(p0600,第 6 章审查自己生成的代码,全书最见功力处);三是它的末端(p0700,第 7 章 agent 跑数据科学,看它敢不敢把过程摊开)。另补看 p0060、p0100、p0190、p0250、p0400、p0520、p0640,覆盖概念、演进、agent 循环、环境搭建、混合推理、RAG 加载器、代码安全。抽读 8 屏约占 0.8%,十章屏数按 pages 索引全量切分。
先给结论:这本书的骨架是我读过的 AI 工程书里最匀的一本,十章没有一章潦草;但它把一半版面交给了一份机翻,而那份机翻连 LLMs 都不认识。
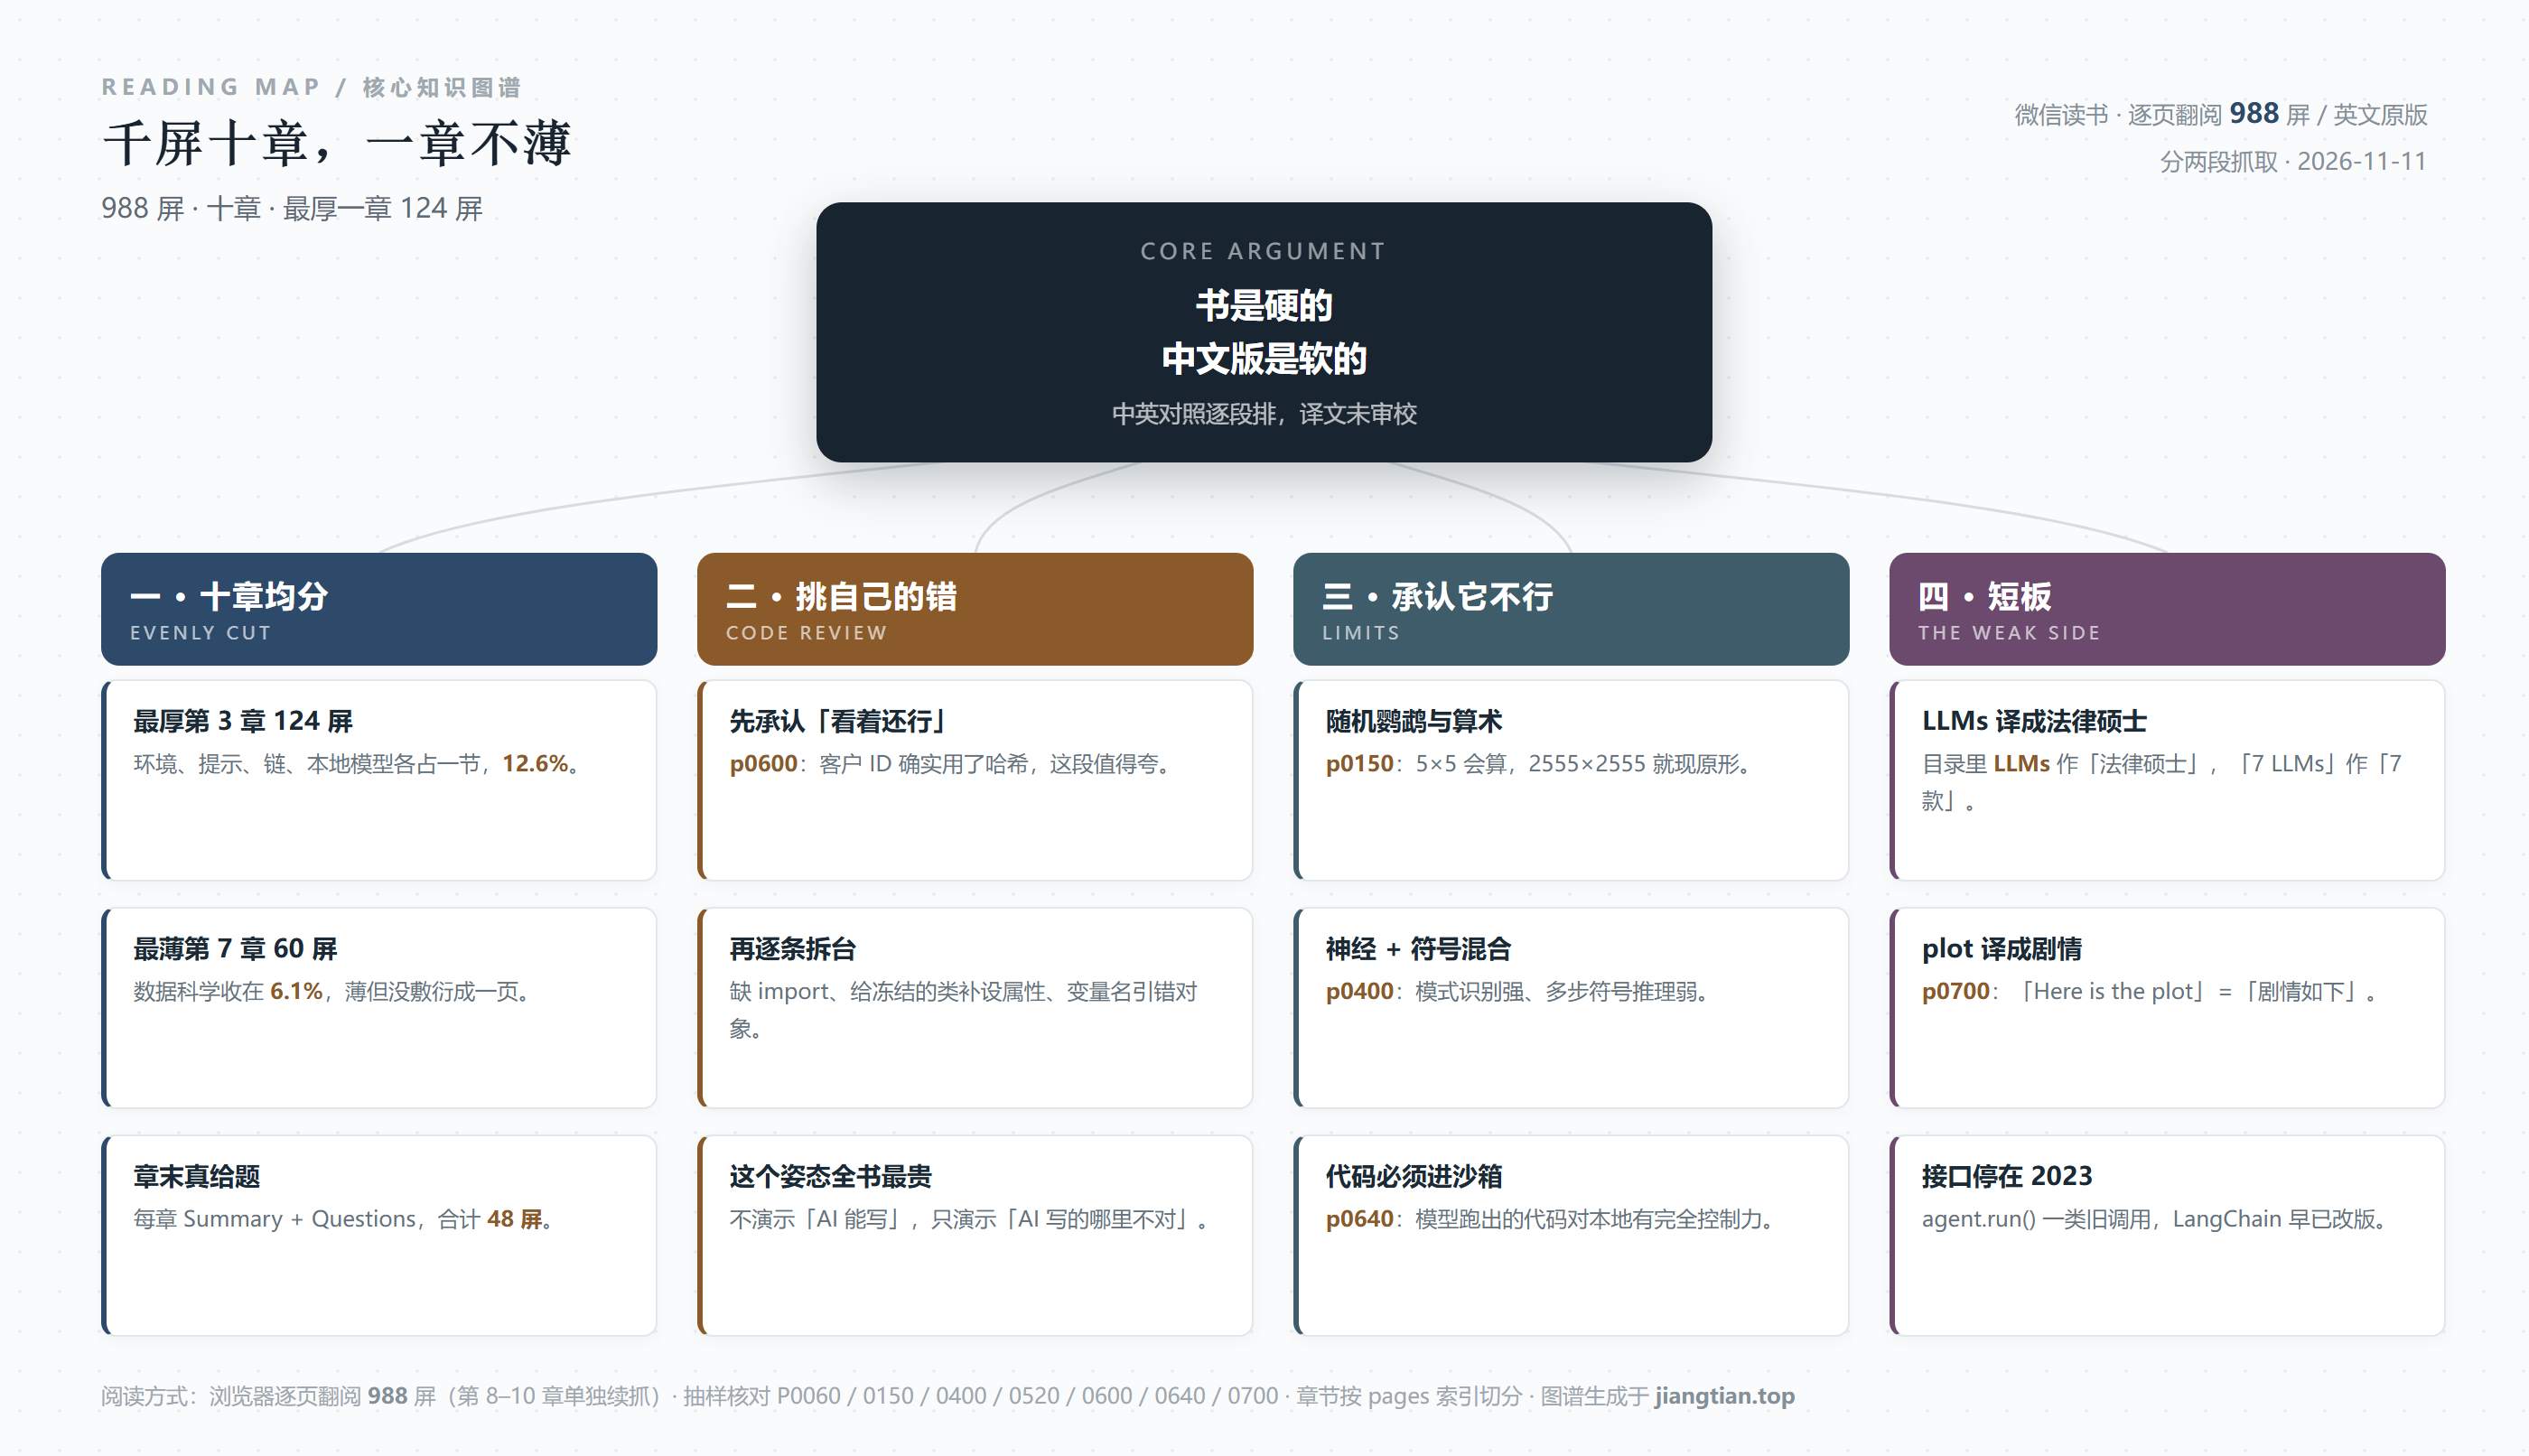
988 屏,十章,屏数分布是这样的:第 1 章 112 屏(11.3%)、第 2 章 93 屏(9.4%)、第 3 章 124 屏(12.6%)、第 4 章 85 屏(8.6%)、第 5 章 118 屏(11.9%)、第 6 章 89 屏(9.0%)、第 7 章 60 屏(6.1%)、第 8 章 89 屏(9.0%)、第 9 章 116 屏(11.7%)、第 10 章 70 屏(7.1%)。
最厚的一章 124 屏,最薄的 60 屏,差 2.07 倍。这个倍数,在一本十章的技术书里,几乎就是「刻意平均」的结果。对比我读过的那些中文 AI 书——某本把设计基础压到 31 屏、把提示词词典铺到 223 屏;某本把建筑效果图给 83 屏、把产品设计给 5 屏——你会明白这个 2.07 倍有多难得。
但也是从这个 2.07 倍开始,问题露头了:它匀得太整齐,整齐到每一章都像「刚好填满配额」。这件事我放到第六条短板里说。
一、十章,一条不偏:它把「能力」当章名,而不是把「知识」当章名
把十章的名字读一遍,你会发现一件事:它们大多不是名词,是动词短语。
1 什么是生成式 AI;2 用于 LLM 应用的 LangChain;3 开始使用 LangChain;4 构建能力型助手;5 构建一个像 ChatGPT 的聊天机器人;6 用生成式 AI 开发软件;7 用于数据科学的 LLM;8 定制 LLM 及其输出;9 生产环境中的生成式 AI;10 生成模型的未来。
第 4 章「构建能力型助手」、第 5 章「构建一个像 ChatGPT 的聊天机器人」、第 6 章「用生成式 AI 开发软件」——这三章是三个可交付的东西,不是三个知识点。你读完一章,手上该有一个能跑的东西:一个会调工具的助手、一个能聊你自己文档的机器人、一个会写代码还会被你审查的开发者。
这是「工程书」和「教材」的分界线。教材按知识分类(第二章讲词向量、第三章讲注意力),工程书按能力分类(这一章结束你能做出什么)。这本书选了后者,代价是它不好当参考书查,好处是你不会读完十种算法却做不出一个东西。
第 3 章 124 屏是最厚的一章,也最能说明这本书的性格。章名平平无奇,叫「开始使用 LangChain」,里面塞了:依赖安装、云集成、API 密钥、LLM 与聊天模型、提示、链、LCEL(LangChain 表达式语言)、文生图、图像理解、本地模型(Hugging Face Transformers / llama.cpp / GPT4All),最后是一个客服原型(情感分析、文本分类、文档摘要、map-reduce、token 用量监控)。
p0250 是这一章里最不性感的一屏:pip、venv、requirements.txt 三条命令,配着中英对照的解释。一本英文技术书愿意给「装环境」留出整整一节(17 屏「环境设置与 API 密钥」+ 13 屏「如何设置依赖」),说明作者知道读者会死在哪里。这点值得夸——大多数书默认你有干净的 Python 环境,然后你在第三天放弃了。
但夸完要记账:30 屏装环境,加 32 屏版权与贡献者介绍,加 48 屏章末的 Summary 与 Questions,一共 110 屏,占正文 11.1%。真正讲技术的,是 878 屏。
二、它开篇就泼冷水:随机鹦鹉,与 2555×2555
很多 AI 书的第一章是「AI 多厉害」。这本书第 2 章一上来就叫「超越单纯的机械模仿」(Going beyond stochastic parrots)——这个标题本身就带态度。
p0150 是这一节的正文。我把原文抄在这里,它值得完整看一遍:
「研究人员艾米丽·本德、蒂姆尼特·格布鲁、玛格丽特·米切尔和安杰丽娜·麦克米伦-梅杰提出了『随机鹦鹉』这一术语来描述这一现象(《随机鹦鹉的危害》;2021 年)。大语言模型能够以惊人的精确度模仿语言模式,但它们无法理解语言背后的真正含义或上下文。想象这样一种鹦鹉:它能完美地重复人类的对话,但却不明白自己所说的话的含义。这种缺乏理解的能力会导致模型产生的输出内容不准确、无关紧要,甚至是不道德的。」
接下来的做法很狠:作者不解释,他演示。屏幕上给了一段真实对话截图——
问:What is 5*5?
答:The product of 5 multiplied by 5 is 25.
问:What is 2555 * 2555?
第二问答不出来。5×5 会算,2555×2555 就现原形——这一屏的说服力,顶得上一整章「大模型的局限性」。因为它把「随机鹦鹉」这个抽象判断,变成了你亲眼看到的一次卡壳。
我要在这里停一下,说个判断:这本书的作者懂「怎么证明一件事」。他不满足于引用论文,他要给你看证据;他不满足于说「模型不会推理」,他要给你看它在哪道题上卡住。这个习惯在后面几章反复出现,也是这本书真正值钱的地方。
同一条思路在 p0400 又出现一次。第 4 章讲「探索代理架构」,原文是:
「LLMs excel at pattern recognition in data but struggle with the symbolic reasoning required for complex multi-step problems. ... Hybrid systems that combine neural pattern completion with deliberate symbolic manipulation can master skills such as these.」
(大语言模型在数据的模式识别上很出色,但在复杂多步骤问题所需的符号推理上挣扎。把神经网络的模式补全与刻意的符号操作结合起来,这样的混合系统才能掌握这类技能。)
「混合系统」这四个字,是这本书全部技术方案的底层逻辑。为什么要有工具?因为模型自己算不准,得让它去调计算器。为什么要有 agent?因为一步算不完,得让它循环。为什么要有 RAG?因为答案不在参数里,得让它去查。为什么代码要进沙箱(p0640)?因为模型生成的代码有「对本地系统的极大控制力」,不能让它裸奔。
你会发现,后面八章的所有设计都能回溯到这一句:模型不擅长符号推理,所以要给它外挂。这个视角比「LangChain 有几个组件」高一个层级——组件会变,这个判断不会。
三、它把「工具」讲成了「循环」,而不是「清单」
讲 agent 的书,八成会给你一张清单:有哪些工具、怎么注册、description 怎么写。这本书也讲了这些,但它在 p0190 给了一句更本质的话。
原文这样区分链和代理:链是「由较低级别的模块组合而成」,按特定顺序排列以实现逻辑复用;代理则「借助链来执行以目标为导向的动作,观察环境、根据观察结果决定执行哪条链、执行该链指定的动作,然后重复这一过程」。
然后是我认为全书最精确的一段定义:
「代理执行器运行时负责协调查询代理、执行工具操作以及将观测结果反馈回系统的整个流程。它同时处理诸如错误处理、日志记录及数据解析等底层复杂任务。」
「查询 → 执行 → 观测 → 再查询」这个循环,才是 agent 的定义。不是「能调工具」,是「能根据工具的返回结果决定下一步」。前者是函数调用,后者才是代理。
这句话为什么重要?因为它顺手把「agent 为什么难做」也答了:难的不是接工具,是「观测结果反馈回系统」那一环——工具返回的是字符串、是 JSON、是报错、是空,模型得看懂它,再决定下一步。所有 agent 的失败,八成发生在这里,而不是在「选哪个工具」上。
作者在 p0190 也提到「错误处理、日志记录及数据解析」,但只是一句带过。这是这本书的通病:它总能一句话点到要害,然后转身走开。
四、全书最值钱的一段:他挑自己代码的错
如果这本书只能留一页,我留 p0600。
第 6 章讲「用生成式 AI 开发软件」,有一节叫「实现一个反馈循环」——作者让模型生成一个 Customer 类,然后自己审查它。p0600 就是审查现场。原话(中文译文)是:
「很高兴看到客户 ID 确实是按照预期使用哈希值生成的。代码中有一些用于比较两个不同客户对象的通用代码段。不过,依然存在之前提到的问题。首先,代码中缺少导入语句,这让我很困惑——因为根据提示,这些导入语句应该位于文件开头的模块文档字符串中。其次,代码试图在类初始化之后设置某个属性,而实际上这类属性应该是被冻结的;这说明开发者对『被冻结的属性』这一概念缺乏理解。」
这段要拆开看,它包含三个动作,每个都值得学。
第一个动作:先给一句肯定。「很高兴看到客户 ID 确实是按照预期使用哈希值生成的。」——这不是客套。审查代码时先说对的部分,是为了让被审查的一方(这里是模型,但更多时候是你自己)知道「哪里不用改」,从而把注意力集中到真正的问题上。
第二个动作:指出「该有却没有」的东西。「代码中缺少导入语句,这让我很困惑——因为根据提示,这些导入语句应该位于文件开头的模块文档字符串中。」注意这里的逻辑:他不是说「你漏了 import」,他说「我让你写在文档字符串里,你写了文档字符串却没写 import」——他是在对照自己的提示词验收,而不是凭感觉挑刺。
第三个动作:从错误反推认知。「代码试图在类初始化之后设置某个属性,而实际上这类属性应该是被冻结的;这说明开发者对『被冻结的属性』这一概念缺乏理解。」这一句最狠:他不说「这行写错了」,他说「写这行的人不懂 frozen」。然后下一步顺理成章:给模型补这个概念,再让它重写。
这就是「反馈循环」的真正含义——不是「再生成一次」,是「定位错误 → 归因到认知 → 补上认知 → 重新生成」。四步,缺一步就变成抽卡。
而作者也没停在「模型不行」。他继续修,继续审,还有第三个问题:「客户 ID 引用了一个错误的变量名」。一个问题接一个问题地拆,直到这段代码真能用——这个过程的记录,比任何「AI 帮我写了 500 行」的演示都有价值。
顺带说 p0640。同一章讲代码安全,作者写:「从本质上来讲,任何由大语言模型执行的代码都对本地系统拥有极大的控制能力。与在笔记本或沙箱等隔离环境中运行代码相比,这就使得安全性成为一个极其重要的问题。」然后给了四个方案:RestrictedPython、pycropt、setuptools 的 DirectorySandbox、Codebox API。
「任何由大语言模型执行的代码都对本地系统拥有极大的控制能力」——这句话该印在所有「AI 编程」书的扉页上。因为绝大多数书在教你「怎么让它写」,只有极少数会提醒你「它写的东西要在哪里跑」。
五、第 8 到 10 章:它没砍掉中文书最爱砍的三块
这本书最让我意外的地方,不是它讲得多好,是它没砍。
第 8 章「定制 LLM 及其输出」89 屏,讲条件化(conditioning)、RLHF、LoRA、推理时条件化、微调环境准备、开源模型与商用模型。这一章没法截图——微调的过程没有漂亮界面,只有 loss 曲线和参数;LoRA 连曲线都不好看。所以中文技术书经常把微调压成一节,或者干脆删掉。
第 9 章「生产环境中的生成式 AI」116 屏,是全书第三厚的一章。它讲三件事:让应用「准备好上线」、怎么评估(比较两个输出、对照标准比较、字符串与语义比较、跑数据集评测)、怎么部署(FastAPI、Ray),最后是 21 屏讲可观测性(LangSmith、PromptWatch)。
请把这三件事的顺序记住:先准备好,再能评估,最后才部署。这个顺序和大多数教程相反——大多数教程先教你部署,因为部署有成就感:一个网址,能点。而这本书把「评估」放在「部署」之前,还给了 7 屏专讲「怎么评估 LLM 应用」。这是一个工程判断:不能评估的系统,上线就是赌博。它不解释这个判断,但用章节顺序投票了。
第 10 章「生成模型的未来」70 屏,讲现状、挑战、模型发展趋势、大厂与中小企业、经济后果(创意产业、教育、法律、制造、医学、军事)、社会影响(虚假信息与网络安全)、监管与落地挑战、前路。
这一章是全书的「免责声明」,也是最容易写虚的一章。但它有个有意思的分配:经济后果占 19 屏,其中创意产业 3、教育 2、法律 1、制造 1、医学 2、军事 2,另加社会影响 4、虚假信息与网络安全 2;监管 7 屏。「法律 1 屏、制造 1 屏」——这种给法很诚实:它承认自己不懂,所以不多写。
三章加起来 275 屏,占正文 27.8%。这个比例说明一件事:这本书认为「微调、评估部署、社会影响」占了生成式 AI 工程的三成。你可以不同意这个配比,但它至少给了一个配比,而不是把力气全花在「怎么调 prompt」上。
六、它的短板
这一节写六条,前两条是硬伤,后四条是遗憾。
第一,也是最要命的一条:中文是机翻,而且没人校对。
这本书是逐段中英对照排的:一段英文,紧跟一段中文,再一段英文。这意味着你花钱买的 988 屏里,有将近一半版面是译文。而这份译文的水平,用目录就能证明——
目录里第 3 章有一个小节,英文是「LLMs」,中文译成「法律硕士」。因为在词典里 LLM 的第一释义是 Master of Laws(法学硕士)。它不知道在这本书里,LLM 是大语言模型。
同一份目录里,第 7 章的标题「7 LLMs for Data Science」,译成「7款用于数据科学的大语言模型」——章号 7 被当成了数量「7 款」。
还有:「Prompts」译成「提示信息」(应为提示词)、「Chains」译成「链条」(应为链)、「Summary」译成「摘要」(应为小结)、「Questions」译成「问题」(应为习题)、「Applying map-reduce」译成「应用映射Reduce算法」。
正文里也一样。p0700,agent 跑完 iris 数据集的分析,英文是「Here is the plot:」,中文译成「剧情如下:」——plot 被当成小说情节了。
这几条错误有个共同点:它们都发生在一个「懂英文的人不会错、懂技术的人也不会错」的位置上。也就是说,这份译文既没有技术审校,也没有人工通读。它是一次机器翻译的直接产物,套了个双语排版的外壳。
我为什么把这条排第一?因为它直接决定这本书能不能用。英文够好的读者会直接跳过中文,那这本书的可读屏数立刻腰斩,只剩 494 屏当量;英文不够好的读者会把「法律硕士」当术语记下来,然后在面试里说错。两头都不讨好,而定价是按 988 屏收的。
第二,接口停在了 2023 年,而且没有一页告诉你这件事。
p0700 里那段调用是 agent.run(prompt.format(query="what's this dataset about?"))。这种写法在 LangChain 0.1 之后大改,agent 的构造、执行、回调全换了。p0520 的 document loaders 也是同一批老类名。书里用到的模型——GPT-3.5/GPT-4、StarCoder、StarChat、Llama 2——全是 2023 年的版本。
这不是作者的错,是选题的宿命。但书里缺一件东西:一张「哪些代码已经不能跑」的对照表。任何写框架的书,出版半年后都该配这么一张表,或者一个在线勘误页。这本书的版权页只给了 Packt 的通用勘误入口(p0030:提交勘误、举报盗版、申请成为作者三个邮箱),没有一处针对版本失效的说明。
第三,例子太小,而它没承认这一点。
第 7 章那 60 屏,用 agent 跑数据科学,数据集是 iris——150 行、4 个特征、3 个类别。p0700 的回答是「这个数据集是关于某种花卉的测量数据的,这一点是正确的」。「这一点是正确的」这个自我确认的语气,恰好暴露了 toy 例子的局限:它太容易对了。
真实的数据科学不是 150 行。是 17 个来源、9 种格式、300 个缺失值、一堆同名不同义的字段。这本书从第 3 章的客服原型到第 7 章的 iris,一路都是干净的玩具数据。它教会你「流程长什么样」,没教你「脏数据怎么活」。
第四,缺一本成本账。
书里讲了怎么调模型、怎么部署(FastAPI、Ray)、怎么观测(LangSmith、PromptWatch),但从头到尾没算过钱。一次 RAG 查询,嵌入 + 向量检索 + 大模型生成,各花多少?100 万条文档的向量库要多少内存?一个每天一万次请求的客服机器人,一个月账单是多少?
这些问题不上书,读者就会在第一个月账单出来时懵掉。而这本书恰恰是讲「生产环境」的——讲生产不讲成本,等于讲开车不讲油。
第五,它能一句话点到要害,然后转身走开。
前面夸过 p0190 那句「代理执行器负责协调查询、执行、观测反馈,同时处理错误处理、日志记录及数据解析」。这句话点到了 agent 最难的地方,但接下来没有一节展开它。错误处理具体怎么写?工具返回格式不对怎么办?重试几次?超时怎么设?
同样的还有 p0150 的「随机鹦鹉」——提出问题了(模型不理解含义),给了例子(2555×2555),然后就转去讲怎么用工具绕过了。「绕过去」是对的工程选择,但它没明说这是「绕过」,读者容易误以为「加了工具,理解问题就解决了」。
第六,十章均分,匀到有点可疑。
回到开头那个 2.07 倍。均匀是好事,但均匀到每章都卡在 60–124 屏,说明它可能不是按「这章要讲多少」分配,而是按「每章配额」分配。
证据是第 7 章只有 60 屏。按这本书自己的标准(第 3 章给客服原型四十多屏、第 5 章给 RAG 118 屏),「数据科学」这个题目至少该给 100 屏。它给了 60 屏,还塞了 5 屏 Summary 和 5 屏 Questions,真正讲内容的不到 50 屏。
「十章一样厚」有时候不是公平,是偷懒。真正该厚的(比如第 9 章评估与可观测,116 屏讲三件大事),和真正该薄的(第 7 章可以更薄,或者干脆扩成两章),都没按内容本身的需要切。这个判断我只有配比作证据——但配比本身就是证据。
七、如果一定要读,我建议这么读
988 屏全读要十几小时,其中一半是机翻。所以我建议你把它当「英文原版 + 中文对照参考」来读,别当「中文书」读。具体五步。
第一步,先读目录,把中文全遮住。不是开玩笑。先把 11 条章级条目的英文读一遍,建立自己的框架,再回头看中文——这时候你一眼就能看出哪些译文是错的(比如「7 款」)。这一步花 10 分钟,能救你后面十几小时。
第二步,第 1 章 112 屏,只读三节:「Understanding LLMs」「How do GPT models work?」「How have GPT models evolved?」。p0100 那一屏有几个硬数字值得记:GPT-3 是 3000 亿 token 训练、1750 亿参数;GPT-4 参数未公开,估计在 2000 亿到 5000 亿之间;Sam Altman 说训练成本超过 1 亿美元;ChatGPT 2022 年 11 月发布,靠 RLHF 做对齐。这四个数字是全书讨论的地基。其余小节(什么是生成模型、为什么是现在、文生图)可以快翻。
第三步,第 6 章必须精读,尤其 p0600 前后。这是全书唯一一处「作者跟模型较劲」的现场记录。读的时候带一个问题:他凭什么说「这个属性应该是 frozen 的」?答案在提示词里——他自己指定的。这就是「对照自己的提示词验收」,也是「反馈循环」和「抽卡」的分界。
第四步,第 9 章当操作手册,但要改一处顺序。书里是先「准备好上线」、再「评估」、再「部署」。我建议你反过来:先看「怎么评估」那 7 屏,再回头看部署。因为评估决定了你能接受什么样的部署——没有评估标准,你部署上去的东西只能靠用户投诉来发现问题。
第五步,第 8 章和第 10 章,按需读。第 8 章讲微调,如果不做微调,只需记住一句话:LoRA 之所以重要,是因为它把「改模型」变成了「挂一个小零件」——成本从「重训」降到「加载」。第 10 章讲未来,当作者的个人观点读,不必当结论。
最后一条提醒:这本书的所有代码,都要按「不可运行」对待,逐行核对再跑。不是因为它写错了,是因为它写的时候是 2023 年。你在 2026 年跑 2023 年的 LangChain 代码,报错是常态,能跑是运气。而这件事恰恰是这本书最好的练习:它教你审查 AI 生成的代码(p0600),你正好拿它自己的代码练手。
八、它到底该给谁
给三种人。
给英文能读、想系统过一遍 LangChain 工程的开发者。这本书的十章结构是现成的学习路径,比官方文档有次序,比博客有纵深。你可以只读英文,把中文当噪声跳过。
给正在带团队做 AI 应用、需要一套检查表的技术负责人。第 9 章那 116 屏(准备好、评估、部署、可观测),可以直接拆成团队的 review 清单。尤其「先评估后部署」这个顺序,值得抄进你们的流程。
给想学「怎么审查 AI 输出」的人。p0600 那一段的四个动作(先肯定、对提示词验收、从错误归因到认知、补认知再重写),是这本书最可迁移的方法。它跟 LangChain 无关,跟哪个模型无关,五年后还能用。
不给两种人:英文读不动、又指望中文版顶上的人(译文会让你记错术语);想找「2026 年最新实践」的人(接口和模型都过期了)。
回到最初那个判断。这本书的骨架值四星;中文版值不值,取决于你读不读那半页英文。它敢在 p0600 挑自己生成代码的错,一条一条拆到能跑;它却没人挑译文的错,让「LLMs=法律硕士」躺在目录里。这种不对称,比任何一处技术疏漏都更值得记住——技术疏漏会随版本更新被修掉,而「没人校对」这件事,是一本书的良心问题。
一句话:它教你怎么审查 AI 写的东西,却没人审查它自己写的中文——这本书最大的讽刺,就印在目录第 3 章。
说明:十章屏数按 pages 索引全量切分——第 1 章 112(11.3%)、第 2 章 93(9.4%)、第 3 章 124(12.6%)、第 4 章 85(8.6%)、第 5 章 118(11.9%)、第 6 章 89(9.0%)、第 7 章 60(6.1%)、第 8 章 89(9.0%)、第 9 章 116(11.7%)、第 10 章 70(7.1%),另前置 32 屏,合计 988 屏;「章末 Summary + Questions 48 屏」「前置与装环境类约 110 屏」按同一索引统计。目录译文问题取自书内目录页,正文译文问题取自 p0700 截图。本篇为首次发布 · 笔记与图谱生成于 2026-11-11
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。 看完整履历海报 → skills 实验室 →
发表评论: