
Agent智造营:它给AI装上了手脚,却没给手脚装上边界
微信读书《Agent智造营:人人都能搭建AI数字员工(套装共9册)》· 本次抓取 257 屏,读到套装第一册《OpenClaw实战指南:零基础打造会干活的AI数字员工》的第 5 章中途(抓取被另一路并发任务抢占浏览器后中断,非书本身问题)
逐字核对 8 屏 · 2026-11-11
抽样点位的选法:这是一个九册套装,第一册的结构是「认知—部署—三个办公场景」,所以我按四条线抽——一是它的立论(p0013 第 1 章开头,看它凭什么说你需要它);二是它的承诺(p0006 前言列的五项收获);三是它的操作细节(p0033 硬件配置表与安装步骤、p0045 模型 API 配置、p0090 会议纪要转飞书任务的代码、p0230 自动排版的命令行);四是它的填充物(p0065 邮件分类动作、p0070 邮件模板、p0155 数据分析的业务维度、p0175 PPT 大纲提示词)。另外补了 p0020(OpenClaw 四大核心能力)和 p0125、p0201 两处章节开场。八屏抽样约占 3.1%,但章屏数是全量:五章屏数由 pages.jsonl 的章节标签逐页切分,一屏不漏。
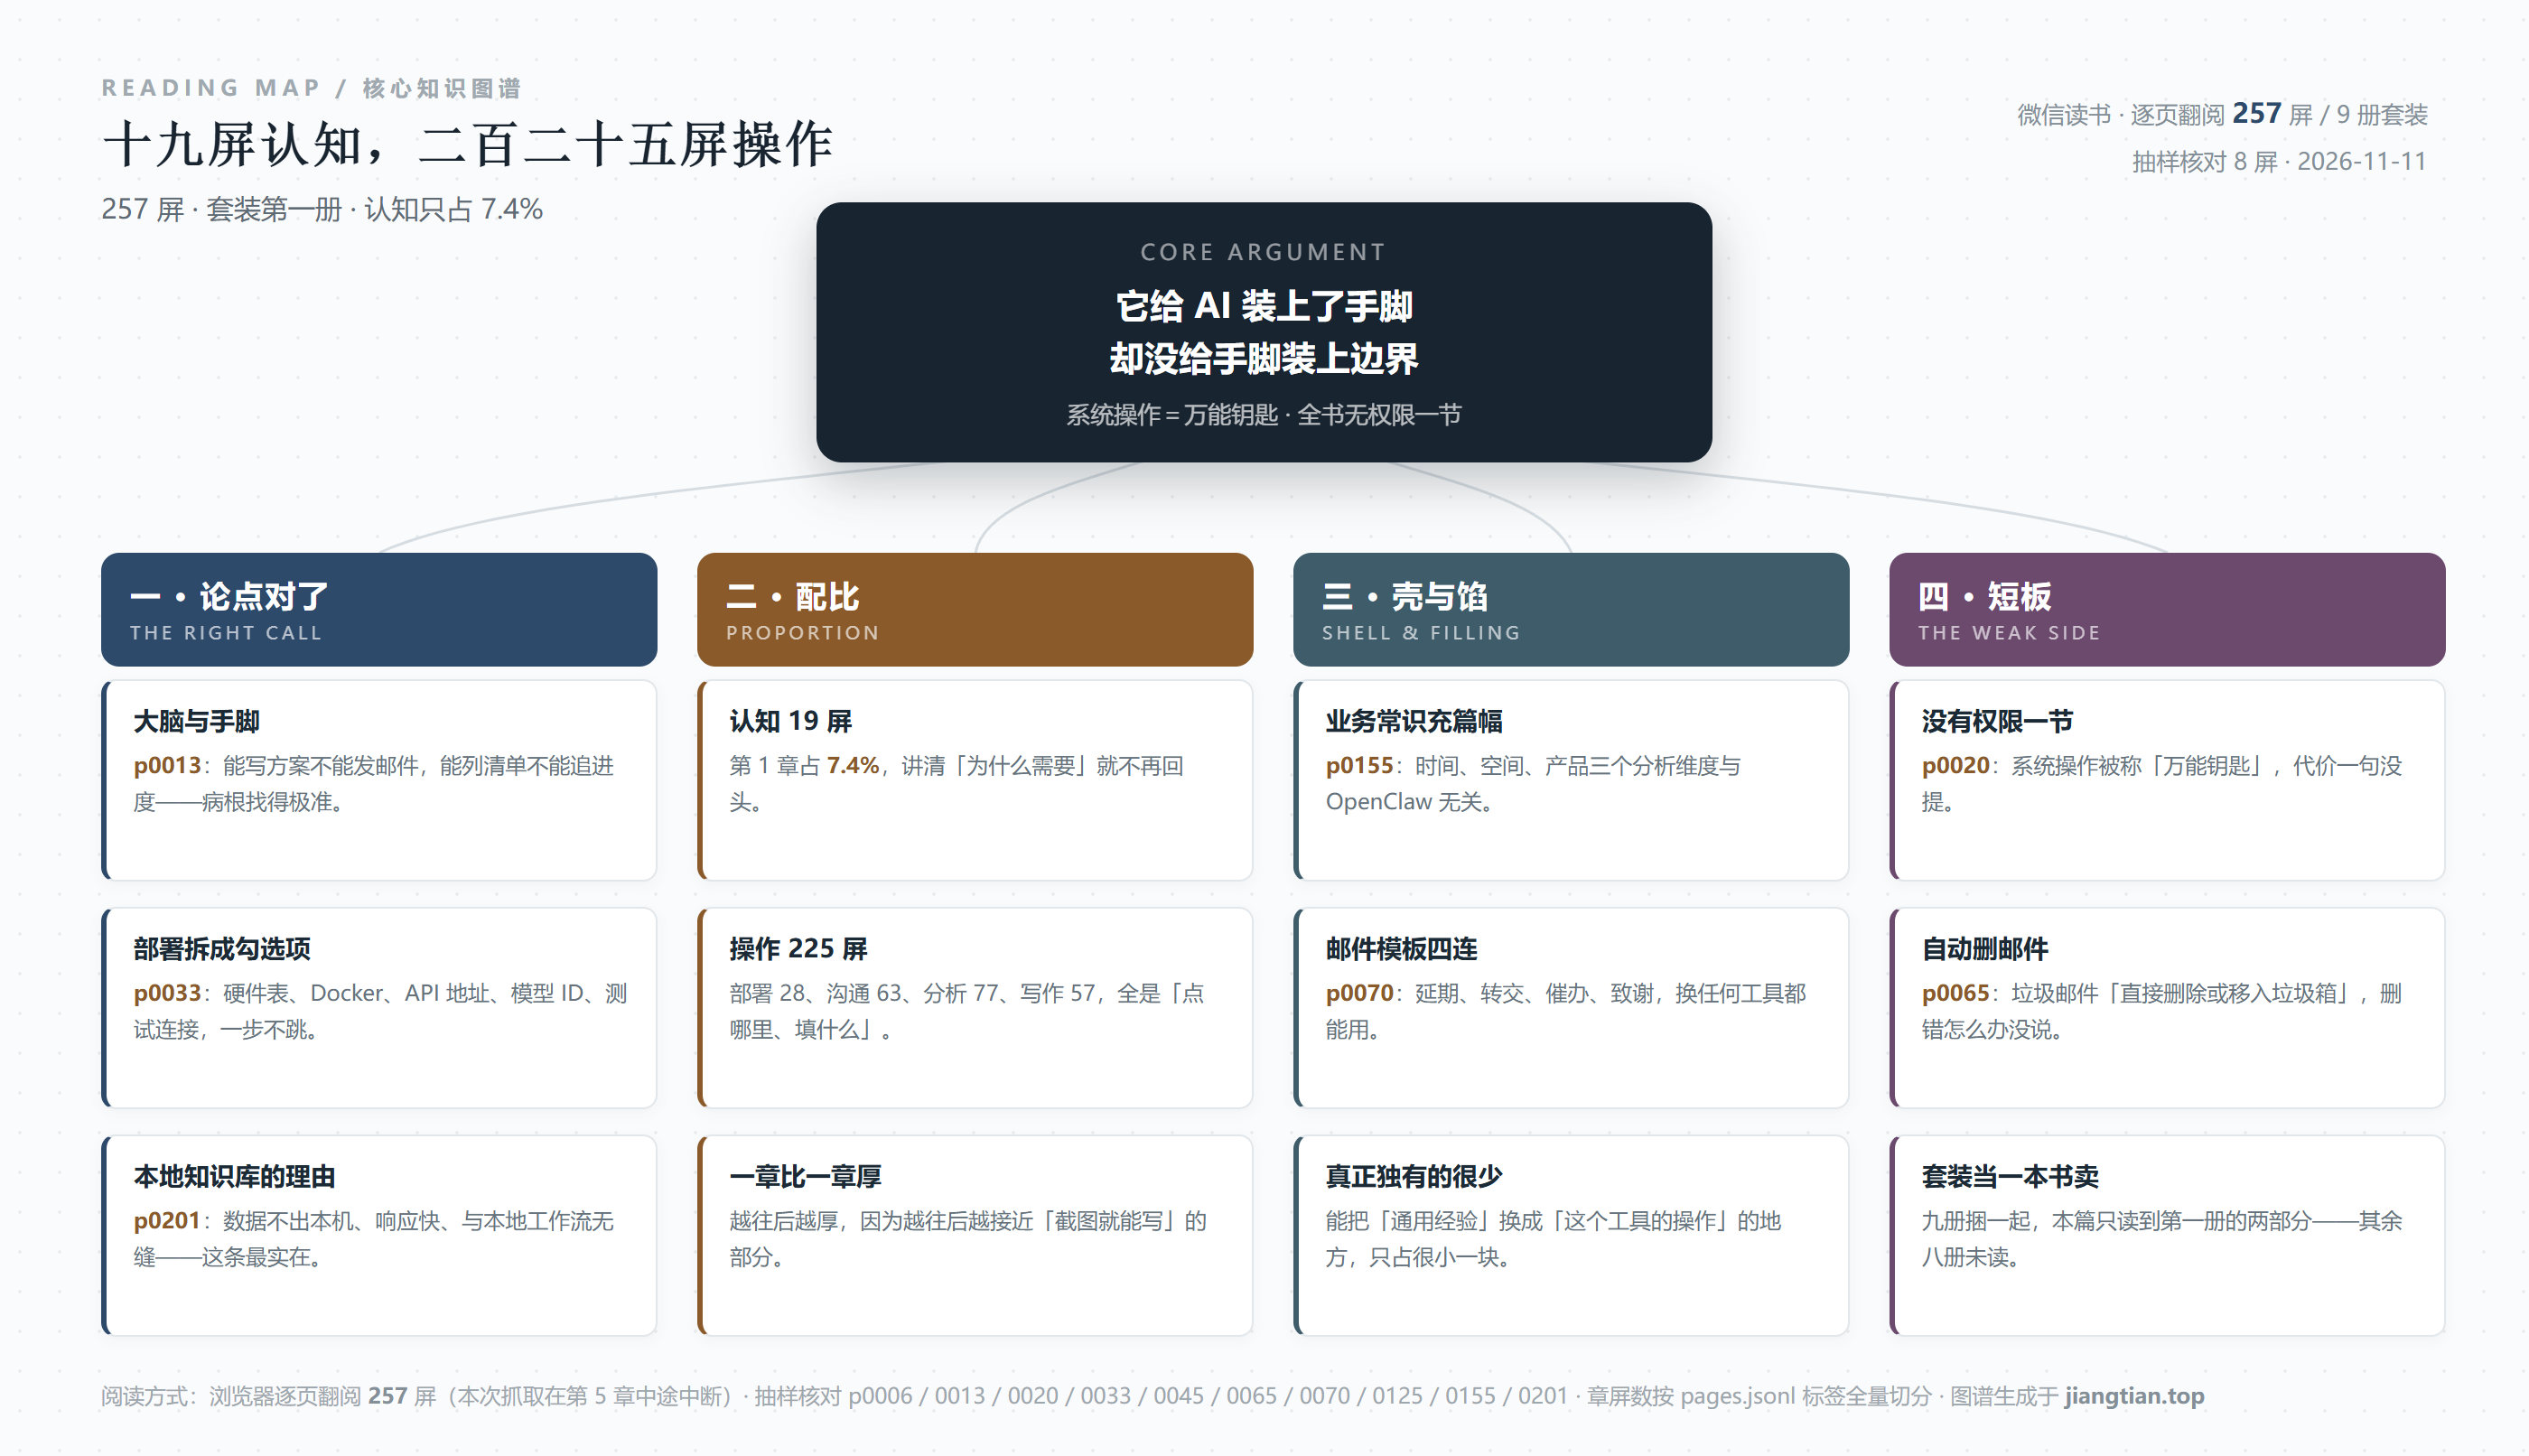
先给结论:这本书的诊断是准的,药方是实的,问题出在它只治了「能不能动」,没治「该不该动」——它教你把活交出去,却没教你怎么把活收回来。
257 屏,读完第一册的前两部分:第一部分讲认知与部署(第 1、2 章,47 屏),第二部分讲高效办公(第 3、4、5 章,197 屏)。九册套装里的另外八册,这次没读到,本篇只对读到的部分负责。
先说它好在哪,因为它确实有好的地方——不是那种「翻两页就想合上」的书。
一、它的诊断是对的:大模型有大脑,没有手脚
第 1 章开头就是这一句:
「2025年1月,DeepSeek-R1 横空出世,以极低的训练成本和API价格震惊业界。然而热闹过后,许多人发现:AI 能写方案,却无法帮你发送邮件;能生成客户名单,却无法自动跟进;能整理会议纪要,却无法追踪执行进度。
问题出在哪?大模型有『大脑』,但没有『手脚』。它能思考,但不能行动。」
这段话说得比很多讲 Agent 的文章都准。它没有停在「AI 很强大」的层面,而是一句话点出了所有企业落地 AI 时撞上的那堵墙:生成和理解是两件事,理解和执行又是两件事。模型能给你一份完美的客户跟进方案,但它不知道你邮箱里那封三天没回的邮件,也不会替你把附件塞进正文。
接着它给了三个「真实故事」,第一个是新媒体运营小李:用 DeepSeek 写文案,效率确实上去了,但「收尾工作」反而更累了——登录小红书后台、复制粘贴文案、上传配图、设置发布时间、回复评论。小李的原话是:「AI 帮我省下的时间,全花在手动操作上了。」
这个故事的杀伤力在于它反常识。所有人都在讲 AI 提效,这本书偏要讲「提效之后你更累了」——因为产出变快,而把产出搬到位的那一段没变,于是那一段成了瓶颈。这就是「有大脑没手脚」的具体样子,不是抽象比喻,是一个运营每天多做的五步操作。
第 1 章在 p0020 把「手脚」拆成了四大核心能力:文件读写(自动打开 Excel、读数据、分析、生成 Word)、系统操作(运行命令、执行脚本、管理文件)、浏览器操作(打开网页、单击按钮、填写表单、抓取数据、自动发布)、以及第四项我没读到的部分。原文对系统操作的描述里有一句很有意思的话:
「系统操作——这就像是给AI配了一把『万能钥匙』。它能运行各种命令、执行脚本、管理文件。对于懂技术的用户,这打开了无限可能,如数据备份、批量处理、系统监控等。」
「万能钥匙」这个词用得诚实,也埋下了整本书最大的问题。这句我留到第六节再说。
二、19 屏讲认知,225 屏讲操作:这是一本执行书,不是判断书
我把五章的屏数按标签全量切了一遍,结果比任何书评都直白:
前置内容(版权、内容简介、前言)12 屏;第 1 章「认知重塑」19 屏,占 7.4%;第 2 章「极简部署」28 屏;第 3 章「高效沟通与协作」63 屏,占 24.5%;第 4 章「分析与展示」77 屏,占 30.0%;第 5 章「写作与整理」读到 57 屏时中断。
也就是说:讲「为什么需要它」只用了 19 屏,讲「怎么点、怎么填、怎么配」用了 225 屏。比例接近一比十二。
这个配比不是失误,是定位。它告诉你这是一本什么书:一本执行书。它的目标读者不是「要判断要不要上 AI」的人,而是「已经决定要上、现在卡在装不上」的人。对后者,这个配比甚至是对的——你不需要再被说服一次,你需要的是那个 Docker 命令。
但配比也暴露了它的天花板。第 1 章那 19 屏里,提了三个核心问题:什么是陪聊 AI 与干活 Agent?为什么飞书是数字员工最好的办公室?雇一个数字员工要花多少钱?第一个问题它答了(大脑与手脚),第三个问题——「要花多少钱」——正文里我没读到一笔账。而这恰恰是所有人决定要不要上之前最想知道的那个数。
再往下看就更清楚了:第 3 章 63 屏、第 4 章 77 屏、第 5 章还在加厚。一章比一章厚,因为越往后越接近「截图就能写」的部分——邮件分类的截图、Excel 处理的截图、PPT 大纲的截图,一屏一屏贴过去,页数自然就上来了。而越往前越薄,因为「为什么」讲不了几页就得收,讲多了读者会翻页。
这是所有「实战指南」的共同形状:书的厚度不是由重要性决定的,是由可截图程度决定的。
把前言和这 19 屏对着看,落差更明显。p0006 列了五项收获:三十分钟「雇用」第一位数字员工;邮件、会议、日程、报表、PPT 全自动;结合 Seedance 2.0 做流量获客;融合 Kimi2.5 与智谱 GLM-5 等模型;老板思维重塑。五项承诺里,只有第一项被这 19 屏认知加 28 屏部署撑住了,其余四项都推给了后面的册子。这不算欺骗,这是产品结构——但读者翻开第一册时,看到的是一张覆盖九本书的菜单,而手里只有第一道菜。
三、第二章值得单独表扬:它把「跑不起来」拆成了勾选项
如果这本书只有一章值得留着,我留第 2 章。28 屏,讲怎么在半小时内把它装起来。
p0033 是一张硬件配置表(表 2-1),四列:配置项、最低配置、推荐配置、说明。CPU 最低 2 核、推荐 4 核及以上;内存最低 4GB、推荐 8GB 及以上,说明栏写「内存越大,并发处理能力越强」;硬盘最低 20GB、推荐 50GB SSD,「用于存储数据和日志」;网络要求稳定宽带,推荐固定 IP,「飞书 Webhook 需要公网访问」;系统支持 Windows 10/11 与 Ubuntu 22.04,并注明「Linux 系统更稳定」。
这张表的价值不在信息量,在于它把一件含糊的事变成了可勾选的清单。绝大多数 AI 工具书在这一步是含糊的:「建议配置较高」——什么叫较高?读者装到一半发现内存不够,就弃了。这本书直接给了数字,还给了推荐值,还给每一行写了理由。
后面是安装步骤:装 Docker,Windows 用户去 docker.com 下载 Docker Desktop,双击安装、按向导完成、重启、打开确认运行。然后是模型配置(p0045),一步一步写清楚:复制 API Key(只显示一次,务必保存);登录 OpenClaw 管理后台(http://服务器IP地址:3000/admin);依次单击「模型配置」→「添加模型」,填模型名称 DeepSeek-R1、API 类型「OpenAI 兼容」、API 地址 https://api.deepseek.com/v1、模型 ID deepseek-chat、温度 0.7、最大上下文 64000;单击「测试连接」,显示「连接成功」后保存。接着是 GLM-5 的配置,去 open.bigmodel.cn 注册、右上角头像→「API Keys」→「添加新的API Key」。
看这一段的时候我在想一个问题:为什么这种「啰嗦」反而是价值?
因为它的读者是真的会卡住的。一个不懂技术的运营,看到「OpenAI 兼容」「API 地址」「模型 ID」这三个词,根本不知道哪个该填哪个。而这段文字把「哪个格子填什么」写死了,连「只显示一次,务必保存」这种踩过坑才会写的提醒都给了。这一屏的信息密度不高,但它消灭的是一个具体的死锁。
这也是我说它是「执行书」的原因:执行书的价值不在讲得多深,而在不让读者在半路掉队。第 2 章做到了。
四、从第三章开始,书变成了「模板库 + 截图集」
第 3 章 63 屏讲沟通与协作:邮件、会议、日程。第 4 章 77 屏讲分析与展示:Excel/WPS、数据分析、PPT。第 5 章讲写作与整理:知识库、公文、排版。
这里面有真东西。p0090 是第 3 章会议纪要那一节,它给了 Python 代码:从待办文本里按「事项|负责人|截止日期」的格式拆出三元组,用 assignee_mapping 把负责人姓名映射成飞书 UserID,再调用 create_feishu_task 建任务,带上 summary、assignee、due_date。这是全书少见的、把「AI 输出」接到「真实系统」上的代码——不是截图,是能跑的胶水。
这一节的完整链路值得一提:会议录音转文字 → 按「事项|负责人|截止日期」拆成结构化的待办 → 映射到飞书的 UserID → 建任务并带上截止时间。它跨了三层:模型的非结构化输出、代码的解析与映射、外部系统的 API。3.2.3「格式规范」还跟了一句「会议纪要不仅要内容完整,格式也要规范统一,这样方便阅读、存档、后续检索」——这句话说明作者知道「能读」和「能检索」是两件事,格式不规范,半年后没人找得到那次会的决定。这是第 3 章最像工程的一屏,可惜只有一屏。
但更多的地方是另一种东西。p0155 是第 4 章讲数据分析维度的一屏,内容是这样的:时间维度、空间维度(全国性业务用「大区」或「省份」,区域性业务用「城市」或「门店」,多渠道业务用「渠道」)、产品维度(品类做大类对比、品牌做品牌对比、SKU 做单品分析、价格带按区间分组、新品老品做生命周期分析)。
这些内容对不对?对。有没有用?对没做过分析的人有用。但它跟 OpenClaw 一点关系都没有。你把这套维度讲给一个用 Excel 透视表的人听,同样成立;讲给一个用 BI 工具的人听,同样成立;讲给一个用 ChatGPT 的人听,同样成立。
p0070 更典型:四个邮件模板——延期回复、转交他人、催办、致谢。模板写得挺规矩,「[对方称呼]您好,感谢您的邮件。由于[原因],我需要将回复/交付时间延后至[新时间]。给您带来的不便深表歉意」。但这也是跟工具无关的东西。它属于「职场写作」这个品类,不属于「AI 数字员工」这个题目。
我不认为这是注水。我认为这是「一本书必须够厚」的压力下的自然选择:九册套装,每册要撑起一本书的分量,而真正属于 OpenClaw 的独有知识——它怎么调工具、怎么配权限、怎么处理失败——没有那么多可写。于是用通用经验补齐。
问题是,通用经验补齐的部分,读者分不清哪些是「这个工具的做法」,哪些是「任何工具都成立的做法」。学着学着,他会以为自己在学 OpenClaw,其实在学职场常识。
五、全书最像「工程」的地方:一条命令和一份 YAML
第 5 章有三样东西值得留:一个理由、一条命令、一份配置。
理由是 p0201。这一屏讲「为什么本地知识库更适合敏感文档」,给了三条:数据不出本机——你的文档始终保存在自己的计算机上,不会被上传到任何云端服务器;响应速度更快——本地读取避免了网络延迟,即使是几百页的 PDF,也能在几秒内完成解析和索引;与本地工作流无缝衔接——文档本来就在电脑上,不需要额外的上传、同步步骤,直接被 AI 读取和引用。
这三条站得住,尤其是第一条。对合同、客户信息、未公开的方案来说,「不出本机」不是性能优化,是合规底线。市面上讲知识库的书,多数只讲怎么切分、怎么召回,很少讲「数据放在哪」——而这一条恰恰是企业采购时第一个被问到的问题。这是全书最实在的一处承诺。
第 5 章 p0230 有一屏,我看了两遍。它讲自动排版,给的是命令行:
openclaw format apply \

  --input "待排版文档.docx" \

  --rules format_rules.yaml \

  --output "已排版文档.docx"
上面还给了一份 YAML 的片段,写着 heading1_size: 16pt、paragraph 之类的样式规则。
为什么这一屏重要?因为它把「AI 排版」这件很虚的事,变成了一份可版本化的配置文件。样式规则写进 YAML,就意味着:可以存进 Git,可以评审,可以回滚,可以让十个人排出一样的版式。这是全书唯一一处体现「工程思维」而不只是「操作技巧」的地方。
对比一下前面那些「打开对话框,输入提示词,让它生成大纲」的段落,差别就出来了:提示词是一次性的,写完就散;YAML 是可复用的,写一次管很久。一个团队要用 AI,靠的不是谁的提示词写得好,靠的是把要求固化成文件。这本书在第 5 章末端摸到了这句话,但没有往下讲——它没有告诉你这份 YAML 该怎么组织、怎么和团队共享、改了规则怎么验证。
p0175 讲 PPT 生成,给的是一个提示词模板:请帮我生成一份工作汇报 PPT 的大纲,然后列背景信息——汇报人「市场部张三」、汇报对象「公司CEO和各部门总监」、汇报时间「30 分钟」、汇报周期「2024年第三季度」。模板本身写得不错,说明作者知道「给模型的上下文越具体,输出越可用」。书里也说了「DeepSeek 不会读心术,你的输入越具体,输出就越符合你的需求」。
但这仍然停在「提示词技巧」的层面。技巧的天花板是个人效率,配置的天花板是组织能力。这本书两样都碰了,只是前者给了 200 屏,后者给了一屏。
六、「数字员工」这个词,它没有定义
书名里最重的四个字是「数字员工」。但这本书从头到尾没有给这个词下一个能拿去做判断的定义。
它给的是能力清单:文件读写、系统操作、浏览器操作。它给的是效果承诺:不用你盯着,会自行在你的计算机上查资料、整理文件、做表格、生成报告,甚至打电话。它还给了一句很有煽动性的话:「它不是模拟人类对话,而是在模拟人类工作。」
问题是——能自动执行 = 员工吗?
员工之所以是员工,不在于他会动手,而在于三件事:他知道什么不该做;他做错了会告诉你;出了问题有人负责。这三件事,恰好是「给它一把万能钥匙」之后最先崩掉的三件事。
p0065 讲邮件自动分类,动作配置是这样的:类型为「紧急」或「重要」→ 移动到「重要邮件」文件夹,发飞书/钉钉提醒;类型为「普通」→ 移动到「待处理」;类型为「低优先级」→ 移动到「稍后阅读」;类型为「垃圾邮件」→ 直接删除或移动到垃圾箱。
最后这一条,我盯着看了很久。让一个语言模型判断「这封是不是垃圾邮件」,然后直接删掉——判错的成本是什么?一封客户合同被当成广告删了,谁负责?书里没有一句提醒。它甚至没有说「建议先只移动不删除,观察一周再放开」。
这不是苛责细节。这是这一类书共同的结构性缺口:它们把「AI 能不能做到」当成全部问题,把「AI 做错了怎么办」当成不需要回答的问题。而带着系统命令、文件管理、浏览器操作权限的智能体,做错一次的代价,跟聊天框里说错一句话完全不是一个量级。
我在已读的 257 屏里,没有找到一节讲权限边界、操作确认、失败回滚、日志审计。这不是「写得浅」,这是「没写」。第 1 章把系统操作称作「万能钥匙」,然后就再没提过这把钥匙该不该上锁。
七、它的短板
四条,按分量排。
第一,安全与边界整块缺席。一个能运行命令、管理文件、操作浏览器的东西,本质上是给了 AI 一份你电脑的写权限。这类系统真正的风险不是「答得不好」,是「做得太狠」:误删文件、误发邮件、把敏感文档传出去、被网页里的恶意指令牵着走(提示词注入)。这些在已读的 257 屏里一条没有。一本教人把权限交出去的书,最该写的就是「交到什么程度为止」。这一节的缺失,比任何一章写得浅都严重。
第二,没有失败样本,也没有成本账。全书都是「保存 Workflow 后,单击『测试运行』,OpenClaw 会处理你邮箱中的 5 封最新邮件,显示分类结果。确认无误后,启用自动运行」。这句话里「确认无误」四个字,是全书唯一一次提到验证——但那是在测试环境里,真实环境跑起来之后呢?跑一个月,错分了三十封,你怎么发现?书里没有答案。成本也是:模型调用多少钱一个月、跑一次 PPT 多少 token,一笔没有。第 1 章明明把「雇一个数字员工要花多少钱」列为三个核心问题之一。
第三,通用经验冒充专属知识。数据分析的三个维度、四封邮件模板、PPT 大纲的写法——这些放在任何一本职场书里都成立,放在这本书里就成了「OpenClaw 能做的事」。读者学完会有一种错觉:我学会了这个工具。实际上他学到的是「怎么让 AI 帮我写邮件」,而这个技能跟工具无关。
第四,九册套装是个商业包装。一个套装捆九本,读者买到的是九个「主题」,不是一个「体系」。第一册讲 OpenClaw 入门与办公,后面的册子按前言里的五项收获推测,会讲到流量获客、模型融合、老板思维。这些主题之间没有递进关系,只是一个产品线被打包成了一个 SKU。对读者来说,这意味着你必须自己判断哪一册跟你有关——而书本身不会告诉你。
八、如果一定要读,我是这么读的
先明确你要什么。这本书不能帮你判断「该不该上数字员工」,只能帮你「把它装起来」。如果你的问题还在「要不要」,这一本先放回去。
第 1 章,读那 19 屏。不为学知识,为拿一句话去说服你的老板或者你自己:「大模型有大脑,没有手脚」。这句话值 19 屏。剩下的三个核心问题,读完你会发现只答了一个半,心里有个数就行。
第 2 章,一屏一屏照着做。这是全书最值钱的 28 屏。硬件表、Docker、API 配置、测试连接,每一步都别跳。这一步过了,你才有资格判断后面那些场景对你有没有用;这一步过不去,后面 200 屏全是纸上谈兵。
第 3、4、5 章,当模板库,不要通读。你要处理邮件就翻第 3 章,要做报表就翻第 4 章,要写周报公文就翻第 5 章。但翻的时候带一个筛子:凡是「换成任何 AI 工具都成立」的段落,跳过;凡是「只有这个工具才这么干」的段落,认真看。筛完你会发现剩下的不多,但那些才是这本书真正独有的东西。
动手之前,先给自己立三条规矩。这是我读完之后最想补上去的一节:第一,所有「删除」类动作,先改成「移动」,跑两周再考虑放开;第二,所有「对外发送」类动作(邮件、消息、发布),保留人工确认;第三,给它单独的工作目录和一个不常用的账号,别让它碰你的主账号和全部文件。书里没写这三条,但你必须有。
一句话:它把「怎么让它动起来」写得很到位,把「动错了怎么办」留成了空白——而后者,才是你真正会付学费的地方。
说明:五章屏数由 pages.jsonl 章节标签逐页切分(前置 12、第 1 章 19、第 2 章 28、第 3 章 63、第 4 章 77、第 5 章 57,合计 257);「认知 7.4%」按 19/257 计算;「操作 225 屏」为第 2 至 5 章合计;套装其余八册未纳入本篇,相关推断(第 1 章前言所列后续主题)已标注为「推测」· 笔记与图谱生成于 2026-11-11
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。 看完整履历海报 → skills 实验室 →
发表评论: