
AI 到底会不会做数学?OpenAI 把 721 篇 AI 写的论文全公开了,还带 Lean 证明(1.7 万星)
github监控器 · 2026-11-10 · 约 4335 字 · openai/math
每次有人问"AI 真能做数学研究吗",争论都会落到同一处:没有可查的证据。
OpenAI 这次直接把证据摊开了:721 篇手稿、373 个家族、约 42% 带 Lean 形式化证明,全部公开。不是演示视频,是可以逐篇读、逐个编译的原始材料。
1.7 万星,10 月 6 日建仓,一个月涨了近 500 星一天。但这篇不是吹它——README 自己就写了三个坑,我一条条摆出来。
一、先说结论:这是一份"原始研究数据",不是成品论文
很多人第一反应是"AI 发论文了"。不是。
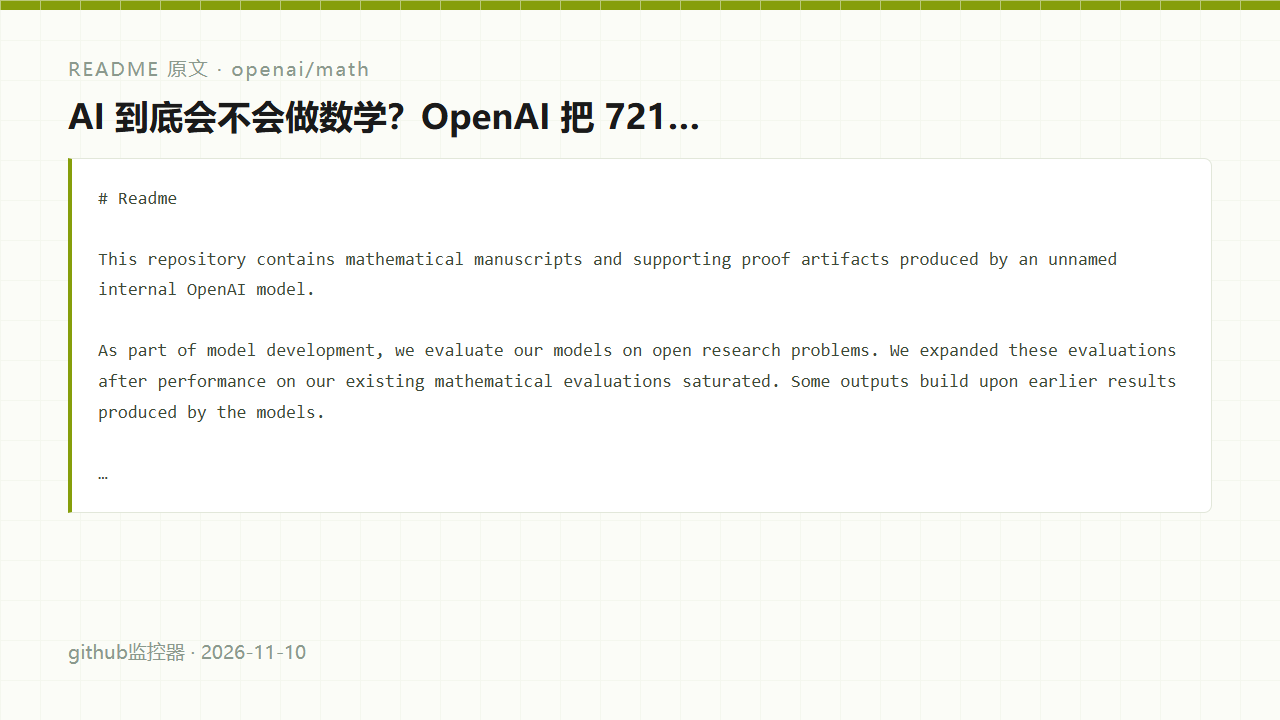
README 里有一句定性,非常关键,值得原样照抄:
"In our view, these manuscripts are best understood as a form of raw research data, rather than polished academic papers."
翻成人话:当成实验记录看,别当成期刊论文看。
这个定位决定了你怎么用它——你要做的是"翻一翻里面有什么",而不是"引用它证明某个定理"。
README 还接着说了第二句,态度比第一句更软:
"We defer to the math community completely on matters of credit, precedence, and concurrent work."
优先权、署名、同期工作,全部交给数学界判定。这是个很克制的表态,也说明他们自己清楚这些东西的效力边界在哪。
二、它到底是什么:三个数字读完
先把规模摆清楚,这决定了它值不值得你花时间:
"家族"这个概念要理解一下,它不是一个文件夹那么简单。
README 的定义是:一个家族把相关论文归在一起,可能包含 主结果(principal result)、配套论证(companion arguments)、推论(consequences)、以及替代证明(alternative proofs)。
这个结构说明什么?说明它不是"721 个孤立结论",而是有推导链的研究群。这一点比数字本身重要。
三、为什么是 Lean:这是它最硬的地方
数学论文最难验证的不是"读不懂",是"读懂了也可能是错的"。一个引理用错,整条链就塌了,而审稿人未必看得出来。
Lean 是交互式定理证明器。它的编译器只认两件事:类型对不对、证明是否闭合。
所以一篇论文配了 Lean 形式化,意味着:
- 命题被精确写成了形式语言,没有含糊空间;
- 每一步推导都被机器检查过;
- 任何人 clone 下来跑一遍,能独立复现"这个证明成立"。
这就是为什么 README 要专门标出"42% 有形式化"——这 42% 的可信度和另外 58% 不是一个量级。
反过来说,剩下 58% 只能靠人读。README 自己承认了这点,见下一节。
四、README 自己写的三个坑(别跳过)
这部分是我最想让你看的,因为它决定了你该怎么用这批材料。
坑一:不是所有结果都有 Lean 证明。
"Not all have accompanying Lean formalizations. We will continue to update this repository with Lean formalizations as we obtain them."
也就是说,仓库在持续补形式化。你今天看到的比例,过几个月会变。
坑二:没形式化的部分可能有问题。
"Some of the unformalized results could have issues. We will endeavor to fix any such issues quickly."
这句是官方原话,说得很直白。"could have issues"——可能是笔误,可能是论证漏洞,也可能结论本身站不住。
坑三:未形式化结果的效力,只能由人来判。
把三条连起来看,用法就清楚了:
五、怎么开始读:三步,别从第一篇读起
721 篇直接翻会崩。README 给了明确的导航路径,按这个顺序:
第一步:先看 overview。
# 仓库根目录
overview.pdf它包含所有家族的描述。先扫一遍这 373 个家族各自讲什么,挑出和你方向相关的三五组。这一步只花二十分钟,能省你三天。
第二步:查 manuscript map。
CONTENTS.md这是全量索引,能定位到具体某篇论文和它的支撑材料。
第三步:进 preprints 目录取原文。
preprints/每个目录里有 PDF、源文件、以及这篇专属的引用信息和构建说明。
注意"构建说明"这四个字——说明这些 PDF 是可以自己重新编译的,源文件是完整的,不是只丢了个成品出来。
六、Lean 库怎么跑起来
README 指向三处:lean/README.md(库说明)、lean/formalization.yaml(形式化目录)、以及 lean/ComparatorChallenges/README.md(额外的检查方式)。
formalization.yaml 是关键——它是一张对照表:哪个证明对应哪篇论文、用什么配置验证。
标准流程大致是:
# 1. 装 Lean 工具链(按 lean/README.md 的版本要求)
curl https://elan.lean-lang.org/elan-init.sh -sSf | sh

# 2. clone 仓库
git clone https://github.com/openai/math.git
cd math

# 3. 进 lean 目录,按 formalization.yaml 里指定的配置逐项检查
cd lean
lake build
lake build 是 Lean 的构建命令。跑起来会很久,因为形式化证明的编译开销比普通代码大一个量级。
建议:别一上来全量 build。 先按 formalization.yaml 挑一个你关心的条目单独验,确认环境通了再扩。
Comparator 那套是额外的交叉检查机制,适合你要独立确认某条结论的场景,不适合入门。
七、推理摘要:10 篇可以看"它怎么想的"
这是我认为整份材料里最有信息量的部分——它公开了模型的推理过程摘要。
覆盖的家族和主题如下:
这十个题的份量不用我解释——Mahler 猜想、Mézard–Parisi 公式、自由群因子同构,都是各自领域里被长期盯着的东西。
但重点不是"它做了难题",而是 reasoning_traces 目录里的 PDF 能让你看到路径:它先试了什么、在哪拐弯、哪个想法被放弃了。
对做研究的人来说,这部分比结论更有参考价值。
八、它们是怎么被做出来的(这段很关键)
README 里有一段方法说明,几乎所有人都该读一遍:
"On average, each result used three hours of ChatGPT Pro thinking compute with that model. Over the course of the evaluation, the model was posed approximately 4,000 problems."
三个数字:
算一下比例:4000 题 → 721 篇手稿。命中率不到两成。
这个数字必须说清楚,因为很多人以为"AI 每题都能做"。不是。它是在大量尝试里筛出来的。
README 也明说了筛选标准:把输出聚合成家族和手稿,并且要求达到一定显著度才入册。
九、两个例外:这两项不是标准流程做的
README 特意标了例外,说明这两项的处理方式和其它不同:
- Riemann zeta 函数无零点区域的工作;
- CM 阿贝尔簇上 Hodge 猜想的证明;
- 另外,Re(s) > 11/12 无零点区域那篇的写作经过人工编辑(为了可读性)。
第三条最值得注意:有一篇是人改过文字的。
改的只是表达,不是数学内容——但你在读那篇的时候应该知道这件事,别把"文笔流畅"当成模型的功劳。
前两条被单列为例外,通常意味着流程上有特殊处理或者额外投入。README 没细说,那就别替它脑补。
十、引用和版本:怎么引才不出错
README 给了明确规则,照做就行:
引用单篇:用它自己目录下的 BibTeX 块。不要自己拼引用格式。
版本:公开的发布历史会被保留,修正和修订都记为新版本,旧版本仍然可访问。
这条对做研究的人很重要——你引的那一版永远拿得回来,不会出现"我引的时候是这样,现在变了"的情况。
所以引用时记得带上版本号或 commit,别只写仓库地址。
十一、谁该看,怎么判断真假
分几类人说:
给一个务实的判断方法:
- 先看有没有 Lean。 有,可信度直接上一档;
- 没有 Lean 的,看它引用了哪些已知结果。 引用错已知定理的,基本可以放弃;
- 看结论是不是"太漂亮"。 真正的研究结果通常带条件、带边界,无条件的大结论反而要警惕。
十二、版本与地址
形态: 数学手稿 + Lean 形式化证明
许可: Apache-2.0
入口: overview.pdf -> CONTENTS.md -> preprints/
Lean: lean/formalization.yaml + lake build
可信度: 42% 机器验证,58% 待人判
注意: README 自述"未形式化结果可能有问题"
最后一句:这份仓库真正的价值不在"AI 会做数学了"这个结论,而在于它把证据、方法、以及证据的边界一起摊在了桌上。愿意把"可能有问题"写进 README 的团队,做的事才经得起查。
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。 看完整履历海报 → skills 实验室 →
发表评论: