
生成式人工智能:文本生成只给一屏,客户服务给了七屏
微信读书《生成式人工智能》· 抓取 93 屏 / 25 条目录 / 读到最后一页(reached_end=true、complete=true),用时 224.5 秒
逐字核对 8 屏 · 2026-11-11
抽样点位的选法:这本薄,所以按「结构—内容—短板」三条线抽。结构看目录与屏数(p0006 核书名,p0016 看第二章怎么开场);内容抽三处——p0017(深度学习前世今生,看它讲不讲得清)、p0025(Diffusion,看它怎么解释原理)、p0059(生产制造,看它拿什么当证据);短板抽两处——p0081 与 p0084(第五章「优势与瓶颈」,看它敢不敢写风险),再补 p0010(核心价值里的认知论金字塔)与 p0087(工作机会与 GPT-4 考试成绩表)。八屏约占 8.6%。必须说明一件事:全书最该被核对的两屏——p0024「Transformer和ChatGPT模型」与 p0032「生成文字」——抓到的都是 15KB 的空白帧(页面没渲染完),我无法核对它们的文字内容,只能核对它们的篇幅。
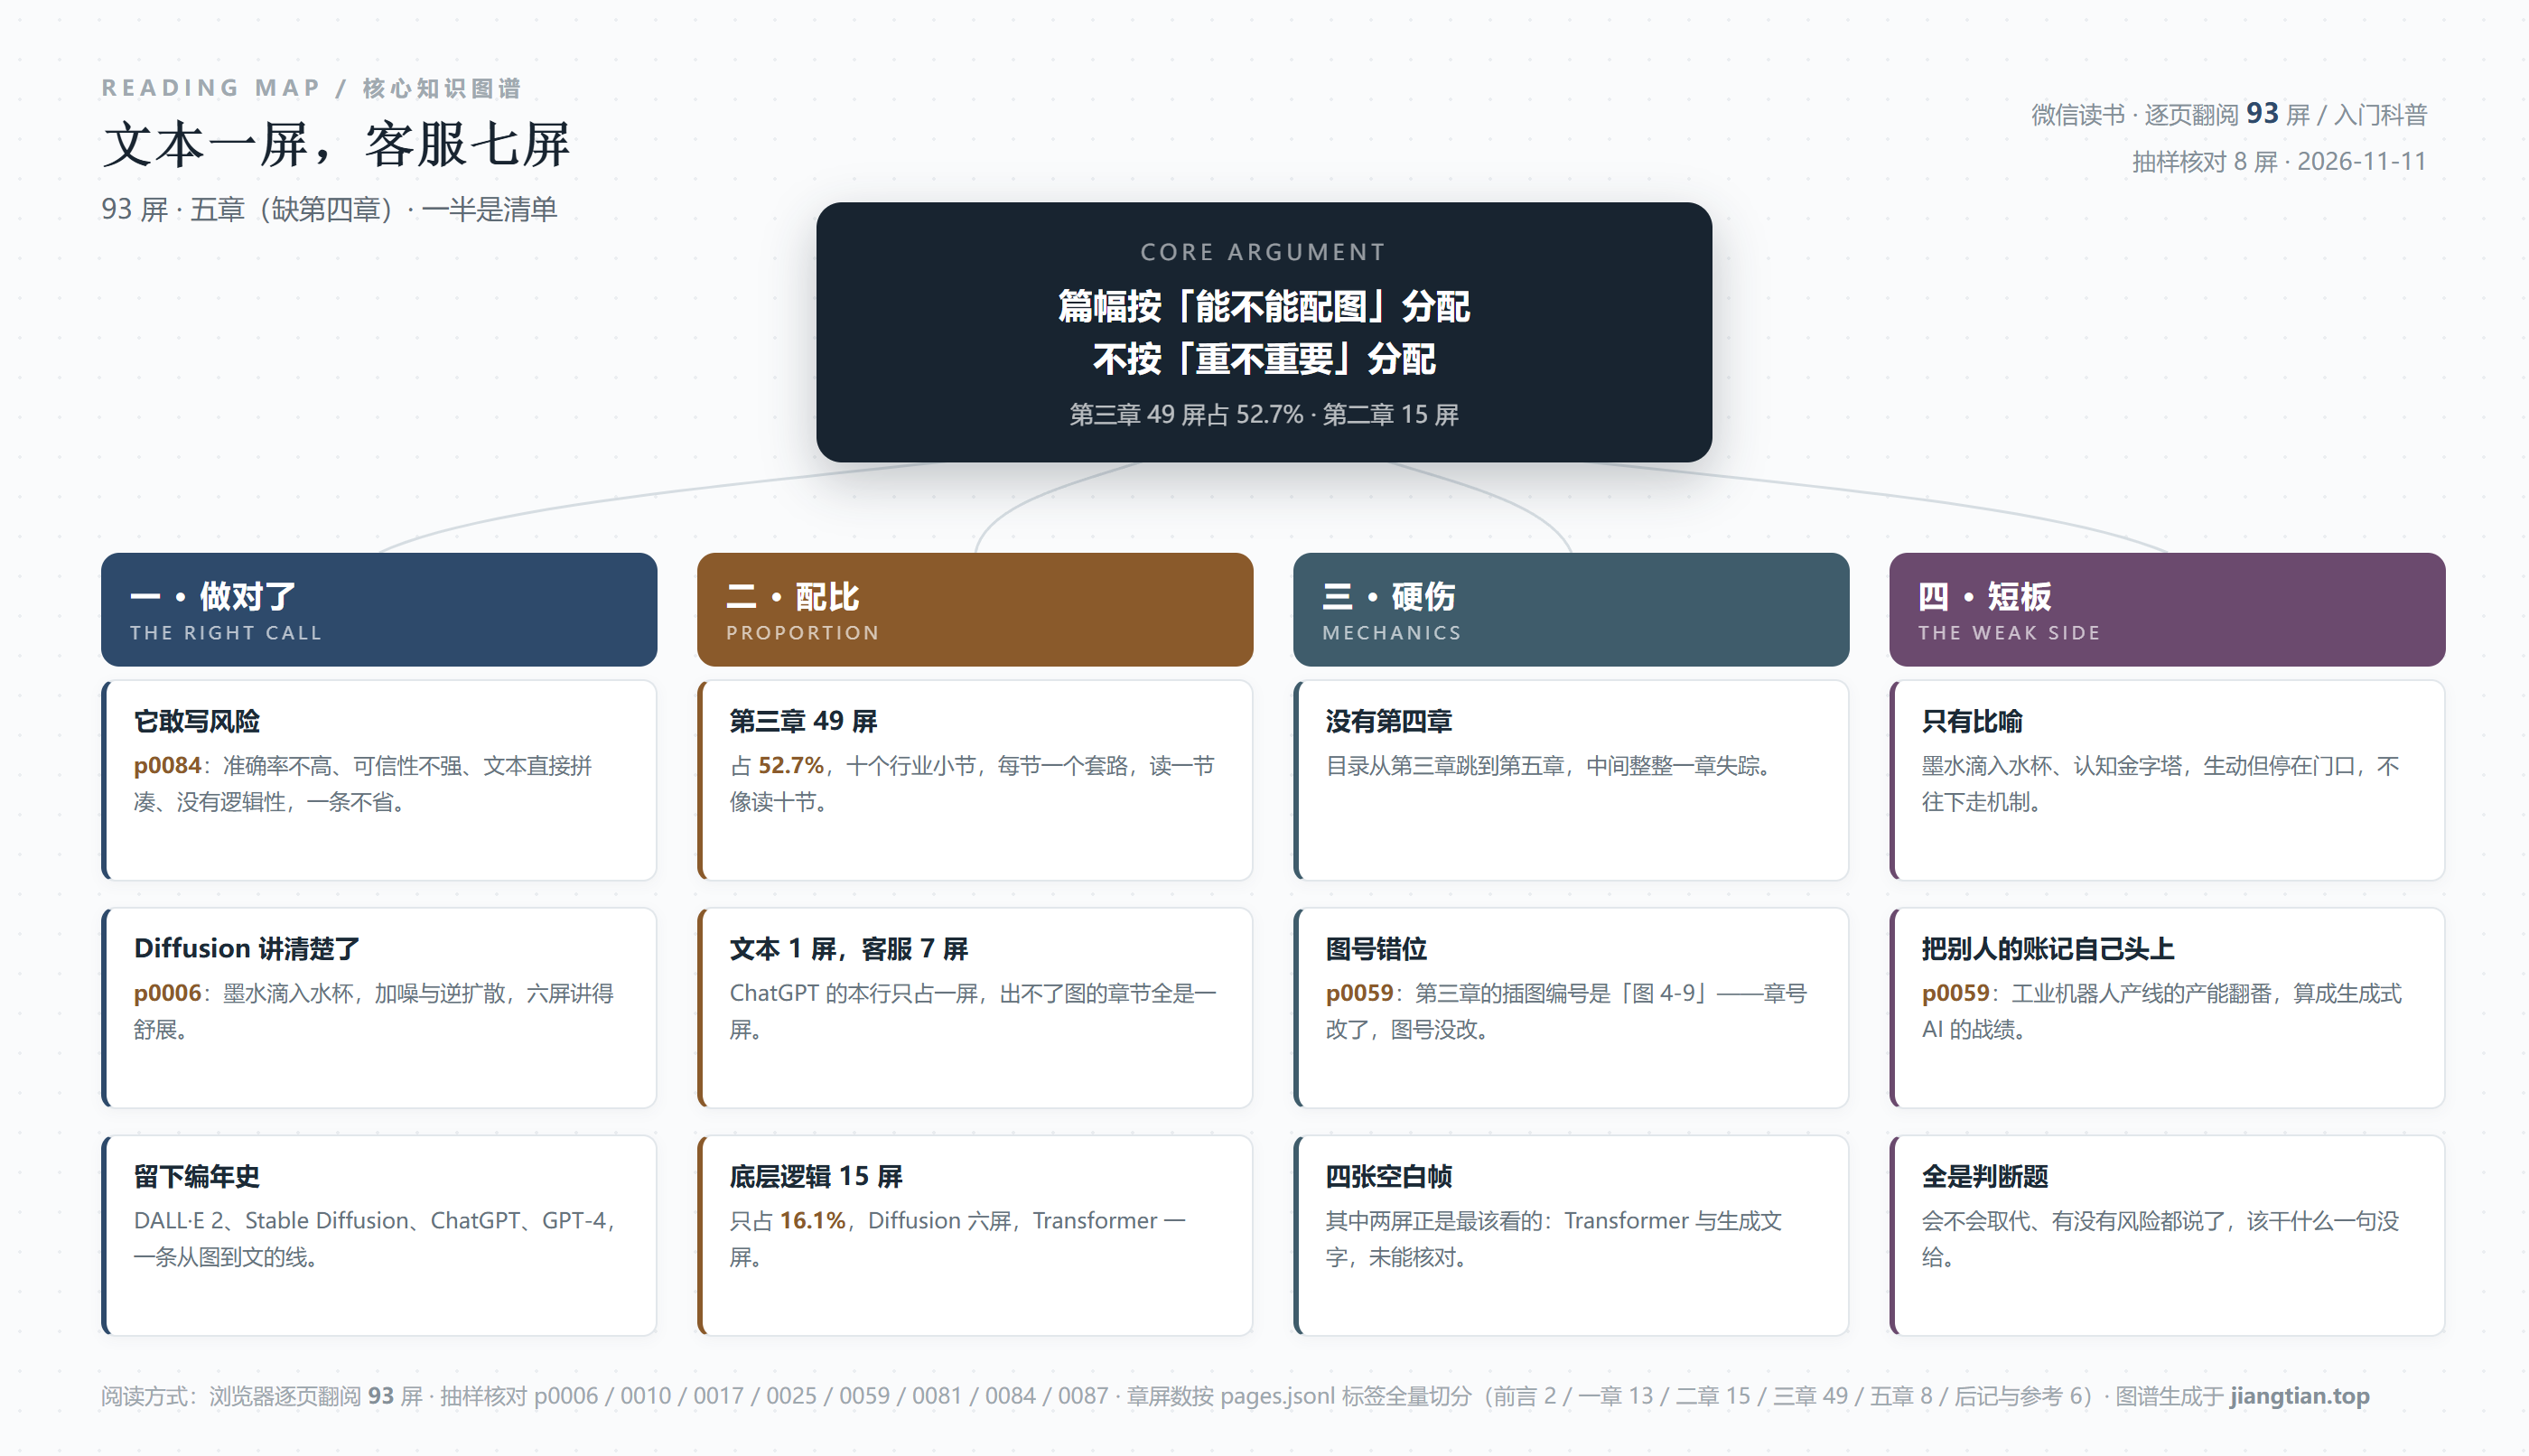
先给结论:这本薄书做对了一件事——它敢在最后一章写「AIGC 不可信」;也做错了一件更基本的事——它把一本讲技术的书,写成了行业应用清单。
93 屏,五章。听起来少,但切开来很有意思:前言 2 屏,第一章「初识」13 屏,第二章「底层逻辑」15 屏,第三章「功能分析」49 屏,第五章「主动还是被动」8 屏,后记 2 屏,参考资料 4 屏。
先记住两个数:第三章占了全书 52.7%,第二章只占 16.1%。这两个比例决定了这本书的性质——它更愿意告诉你「能生成什么」,不太愿意告诉你「为什么能生成」。
一、先说它做对的一件事:它没有回避风险
这类讲 AIGC 的入门书,最常见的写法是通篇「赋能」「重塑」「颠覆」,风险留给读者自己去悟。这本不是。
第五章只有 8 屏,其中 6 屏讲「智能并非万能:AIGC 的优势与瓶颈」。p0081 开头就很老实:
「就像一枚硬币总有兩面,我们在看到ChatGPT在人工智能的赛道上高歌猛进时,同样也要意识到AIGC带来的风险和挑战。AIGC发展迅猛,相关法律法规尚未完善,其发展面临诸如数据安全与隐私保护、著作权争议等问题。」
翻到 p0084,它把瓶颈一条一条列了出来,这一段值得完整抄:
「AIGC虽然发展迅速,却一直面临准确度的挑战,经常被人诟病生成的内容准确率不高、可信性不强、文本直接拼凑、没有逻辑性等,时常出现一些令人哭笑不得的错误。除了技术本身的发展限制,引入技术的成本短期内也会大幅增加,算力和维护成本也是要面对的问题……此外,AIGC的发展和应用也可能会造成人员失业问题,取代部分蓝领和白领的工作,由此带来社会大范围的焦虑和恐慌。数据安全与隐私保护、著作权争议等问题也是AIGC进一步发展的瓶颈。」
「准确率不高、可信性不强、文本直接拼凑、没有逻辑性」——四个短句,说的是大模型最真实的毛病。后面接着讲数据来源的侵权风险(著作权、肖像权、名誉权、个人信息),讲 ChatGPT 把对话内容传到服务器、可能被用于训练,讲「数据是新一轮技术革命的石油,它既是最重要的资源,也是最大的隐患」。
这本出版时间应该不早的书,能把「石油」和「隐患」放在同一句里,比很多厚书清醒。这是我在这一本里唯一想给它鼓掌的地方:它没有把风险写在致谢里,而是写在正文里。
但也要说清楚,它写的是「有风险」,不是「风险怎么防」。数据怎么脱敏、著作权怎么界定、企业用 AIGC 该立什么规矩——一条都没有。这是「知道」和「会处理」的差别,也是科普书与实务书的分界线。
第一章那 13 屏里,它也做了一件不讨巧的事:先把「生成式 AI」和「决策式 AI」分开讲清楚。p0010 是这么分的——决策式 AI 擅长对新的场景进行分析、判断和预测,主要用在人脸识别、推荐系统、风控、精准营销、机器人、自动驾驶;生成式 AI 擅长自动生成的全新内容,主流的内容形式它基本都能生成,包括文本、图片、音频和视频。
这个二分法放在 2023 年是对的,放在今天开始有点不够用了(今天的模型既能决策也能生成),但作为入门的第一刀,它切得准。很多同类书一上来就讲「AI 能干什么」,把判别模型和生成模型混在一锅,读者学完分不清人脸识别和文生图的区别。这本书没混。
然后它拐了个弯。同一个 p0010,接下来讲的是「认识论」——人的认识过程是金字塔结构,从数据到信息、到知识、到逻辑、再到形而上的哲学与信仰,认为生成式 AI 和决策式 AI 聚焦的认知层面不同。这个说法不是错的,但它是哲学系的说法,不是工程的说法。一个想搞懂 ChatGPT 的人读到这儿,会得到一个漂亮但没用的框架:知道 AI 在金字塔的哪一层,跟知道它下一句会接什么,是两件事。
这就是这本书的一贯风格:每个地方都摸到了门口,然后选了最省力的那扇门进去。
二、目录从第三章直接跳到第五章,而那一章的插图编号是「图4-9」
翻目录的时候我愣了一下:第一章、第二章、第三章,然后直接是第五章。中间没有第四章。
一开始我以为是目录漏了。后来在 p0059 找到线索:那一屏是第三章「生产制造」里的插图,图注写的是「图 4-9 上汽大众新能源汽车工厂」,图片来源还给了网址。第三章的插图编号是 4 打头,不是 3 打头。再回头看 p0025 的图注「图 2-13 DALL·E 2 模型输出效果示例」——第二章的图是 2 打头,对得上。
所以真相大概是这样:这一章在原始稿子里是第四章,成书时章号改成了第三章,插图的编号没跟着改。改了一半的编号,比不改更麻烦——读者看到「图 4-9」会以为漏了一整章,翻回去找,找不到。
这个细节本身不重要,但它透露了一件事:这本书的编校是松的。一本 93 屏的小书,从头到尾只有 25 个目录条目、二十几张图,居然能让章号和图号错开一位。连「第几章」都没对齐,你很难指望它对齐别的。
三、配比:文本生成 1 屏,客户服务 7 屏
第三章 49 屏,标题叫「功能分析:AIGC 能生成什么内容?」,里面按行业分了十个小节。我把每节的屏数数出来了:
生成文字 1 屏,描绘图像 9 屏,音频制作 4 屏,影视创作 5 屏,互动娱乐 7 屏,研发设计 1 屏,生产制造 7 屏,供应链管理 1 屏,市场营销 6 屏,客户服务 7 屏。
看这串数字的第一眼,我以为自己数错了。因为这本书的主角是 ChatGPT,而 ChatGPT 干的事就是「生成文字」——这一节只有 1 屏。相比之下,「客户服务」7 屏,「互动娱乐」7 屏,「生产制造」7 屏。
我不觉得这是作者偏心图像。我觉得这是素材可得性在决定篇幅:「生成文字」这种能力,你没法用一张图证明它厉害——它生成的字就是字,跟人写的没区别,截图拍下来读者也看不出什么。而图像不一样,一张「牛仔在滑雪、油画风格」的图(p0025 的图 2-13,配文是 cowboy skiing, oil painting)往那一放,冲击力立刻就有了。
所以这本书的篇幅分配,实际上是被「能不能配图」牵着走的。能出图的章节给 7 到 9 屏,出不了图的章节给 1 屏。这不是一本按重要性排序的书,是一本按视觉冲击力排序的书。
更值得说的是那 49 屏的整体形状。十个行业小节,每节的结构几乎一样:先说这个行业原来怎么干,再说 AIGC 来了能怎么干,再举一两个产品名(Khroma、Colormind、DALL·E 2、Stable Diffusion、Midjourney),最后一句展望。读一节像读十节,读十节像读一节。这不是「功能分析」,这是「场景清单」。
清单有清单的用处——它能帮一个完全不懂的人快速知道「哦,原来这玩意儿还能干这个」。但清单也给不了一样东西:判断。十个行业都「能用」,等于没告诉你哪个行业现在真的能用、哪个还得等两年。
「描绘图像」那 9 屏是全章最具体的一节,小标题就写「分辨率、清晰度、真实性与艺术性」——这四个词恰好是评价一张生成图的标准,说明作者在这里是有专业判断的。它讲了 Diffusion 的扩散与逆扩散,讲了 Stability AI 的「一秒出图」,讲了 DALL·E 2 生成的「牛仔在滑雪、油画风格」四张图(p0025 图 2-13),还讲了提示词对结果的影响。
这一段读起来是舒服的,因为它在讲「怎么判断一张图好不好」。而其余九节讲的是「这个东西能用在哪些行业」——前者是手艺,后者是名单。一本书里同时存在这两样东西,说明作者不是不会写,是没时间(或者没打算)在每一节都写到手艺那一层。
四、底层逻辑 15 屏:Diffusion 给 6 屏,Transformer 给 1 屏
第二章叫「AIGC 的底层逻辑」,15 屏,三个小节:生成式模型基础 7 屏,Transformer 和 ChatGPT 模型 1 屏,Diffusion 模型 6 屏。
又是同一个形状:讲图的那节 6 屏,讲语言模型的那节 1 屏。
「生成式模型基础」那 7 屏写得还算认真。p0017 从深度学习讲起,提到 2006 年 Hinton 提出「深度信念网络」,用「预训练 + 微调」的分阶段训练把训练时间大幅压下来,然后说 GPT、ChatGPT、Diffusion 都属于深度学习模型。这个脉络是对的,也解释了为什么 2012 年之后深度学习突然能用了——算力、数据、方法三件事凑齐了。
但它停在「深度学习是什么」这一层,没有继续往下走到「语言模型是怎么做出来的」。从 2006 年的深度信念网络,到 2017 年的 Transformer,中间隔着 RNN、LSTM、注意力、编码器-解码器这一整串演进,这本书一屏都没给。结果是读者知道了「GPT 属于深度学习」,但不知道「GPT 为什么比之前的模型强」——而后者才是「底层逻辑」这四个字该兑现的东西。
但再往下就断了。「Transformer 和 ChatGPT 模型」这一节,篇幅是 1 屏。而这一屏,我抓到的是一张空白帧(15KB,页面没渲染出来),所以它的具体文字我无法核对。我只能说篇幅:一个撑起整个大语言模型时代的架构,在这本书里占 1 屏,占全书 1.1%。
反过来,Diffusion 那 6 屏讲得挺舒展。p0006 用「墨水滴入水杯」的扩散来类比:对图片不断加入噪声,得到一张模糊的图像,这个过程类似墨水扩散;再通过深度神经网络学习「逆扩散」,把图像还原出来。这个类比是对的,也是讲 Diffusion 最省力的入口。p0025 接着上 DALL·E 2 的例子,说它「既是内容创作领域的革命性工具,同时也成为图像生成和处理技术领域的新标杆」。
问题在于:一本叫《生成式人工智能》的书,把「语言模型」压到 1 屏,把「图像模型」给了 6 屏,这个配比和它自己的书名是打架的。2023 年之后,所有人说「生成式 AI」时脑子里想的是 ChatGPT,不是 Midjourney。书里明明也承认这一点——第一章专门用一节讲「里程碑式的存在——ChatGPT」——但到了讲原理的时候,重心又滑回图像去了。
我猜原因还是那个:Diffusion 好画图。加噪、去噪、逆过程,三步就能画成一张示意图;Transformer 的自注意力、多头、位置编码,画出来读者也未必看得懂。于是「不好画」的那部分,就被「不重要」处理了。
五、它引用了数据,但只引用了别人的数据
全书唯一一处带数字的论证,在 p0087。那一节标题是「我们的工作机会还在吗?」,先引李开复 2016 年在 WISE 大会上的预测——未来十年世界上 50% 的工作会被人工智能取代,包括翻译、记者、助理、司机、销售、客服、交易员、会计。然后讲 2023 年 3 月 15 日 GPT-4 发布,给了一张表(表 5-4),对比 GPT-4 与 GPT-3.5 在统一律师考试、LSAT、GRE 写作、GRE 数学、生物奥赛等考试上的百分位,并写「它通过了模拟律师考试,且分数排在应试者的前 10% 左右」。
这张表是全书最硬的一屏,因为它有可比的对象、有具体的分数、有明确的来源。但它也暴露了这本书的方法:它所有的「证据」,都是转述别人的证据。
p0059 讲生产制造,举上汽大众新能源汽车工厂的例子,写「产能翻一番,交付周期从行业平均的 120 天缩短至 35 天」,配一张工厂照片,来源标注是新闻网站。这段话没毛病,但它证明的是「智能制造」的成效,不是「生成式 AI」的成效——一条产线上的工业机器人,跟大模型生成内容,是两件事。书里把「制造业自动化」的战绩,记在了「生成式 AI」的账上。
这类「借账」在这本书里不止一处。研发设计那一节(1 屏)提 Khroma、Colormind 这类配色工具;市场营销那节(6 屏)提文案生成;客户服务那节(7 屏)提智能客服。每一处都对,每一处都不深。你读完会知道「哦这个东西能用在客服」,但你说不出「它比上一代智能客服强在哪」。
六、最后一章 8 屏:它问了最好的问题,给了最弱的答案
整本书我最想记住的是第五章的标题:「主动还是被动?决胜 AIGC」。这个标题问的是「你打算做用它的人,还是被它用的人」——比「AIGC 是什么」狠得多。
但这一章只有 8 屏。6 屏讲优势与瓶颈,1 屏讲「我们的工作机会还在吗」,加起来 7 屏,就把这个最狠的问题收掉了。
p0087 那一屏,它先引了李开复 2016 年在 WISE 大会上的预测:「未来十年,世界上 50% 的工作都会被人工智能取代,包括翻译、记者、助理、司机、销售、客服、交易员、会计等」。然后立刻跳到 2023 年 3 月 15 日 GPT-4 发布,给了一张考试成绩对比表。
问题就在这里。「考试成绩」证明的是「能力」,不是「岗位」。一个模型在模拟律师考试里排进前 10%,不等于律所会因此少雇一个律师——法律行业的大部分工作是找证据、见客户、谈判、写文书、背责任,考试只是其中很小一块。书里把这张表放在「工作机会还在吗」的标题下面,等于用一个能力指标暗示了一个就业结论。
更可惜的是它没做对照。2016 年的「50% 十年内被取代」,到这本书写作时已经过去七年,正好可以拿现实对一对:哪些岗位真的少了,哪些岗位反而多了(提示词工程师、数据标注、AI 产品经理),哪些岗位的形状变了(同样是客服,从接电话变成审机器人的回复)。这本小书有位置做这件事,因为这一节只需要一屏;但它把这一屏用来贴表了。
我把这一节和前面 6 屏连起来读,读出一个模式:这本书擅长提问,不擅长回答。「决胜 AIGC」是好问题,「工作机会还在吗」是好问题,「智能并非万能」也是好问题——三个问题都在最后一章,加起来 8 屏。它用 8 屏把三个大问题摆到台面上,然后用 49 屏的行业清单告诉你「别担心,能干的事很多」。这个顺序是反的:该用 49 屏去回答 8 屏提出的问题,不是反过来。
七、它的短板
四条,按分量排。
第一,配比与书名打架。叫《生成式人工智能》,却把 52.7% 的篇幅给了行业场景清单,把最核心的语言模型压到 1 屏。读者买这本书,八成是想搞懂 ChatGPT 是怎么回事;读完他会知道 AIGC 能画画、能做客服、能编游戏,但他说不清「为什么它下一句能接上上一句」。这不是深浅问题,是重心问题。
第二,全书的「原理」只到比喻为止。「墨水滴入水杯」讲 Diffusion,「金字塔」讲认知(p0010 用数据、信息、知识、逻辑、哲学五层讲人类的认知结构,用来区分生成式与决策式 AI),「大脑与手脚」讲智能体——比喻都很生动,但没有一处往下走到机制。比喻的好处是让人立刻懂,坏处是让人以为懂了。而技术书的任务,恰恰是在「以为懂了」之后再往前推一步。
第三,编校松懈。章号从三跳到五,第三章的插图编号是 4 打头,这种错在 93 屏的书里出现,说明它没有经过认真校对。另外,我对全书抽样时遇到的空白帧有 4 张(p0024、p0032、p0058、p0080),其中 p0024 与 p0032 恰好是全书最该看的两节——这可能是抓取时的渲染问题,也可能原书那两页本来就短,但无论如何,这两节的内容我核不到,只能核篇幅。
第四,没有一个可执行的建议。第五章问「我们的工作机会还在吗」,答案是「会取代部分蓝领和白领的工作」;问「AIGC 有什么瓶颈」,答案是「准确率不高、成本高、有法律风险」。全是判断题,没有一道是选择题。读者合上书,知道自己该紧张,但不知道该干什么。而这恰恰是 2023 年之后所有人最想知道的那件事。
八、如果一定要读,我是这么读的
这本书现在读,价值不在于「学知识」——它讲的东西,2023 年之后的文章都讲得比它新。它的价值在另外两处。
第一处,当「AIGC 编年史」读。它保留了那个时间点的兴奋感:2022 年 4 月 DALL·E 2 发布,2022 年 8 月 Stable Diffusion 开源,2022 年 11 月 ChatGPT 上线,2023 年 3 月 GPT-4 发布。这些节点串起来,就是一条从「图」到「文」的路线。你要理解今天为什么所有公司都在做大模型,得先知道那一年发生了什么。
第二处,当「行业清单」翻。十个行业小节,每节几屏,你要做哪个行业的方案,就翻那一节,看它举了什么产品、说了什么场景。不要指望它给你判断,把清单当起点,判断自己补。
跳过第二章的 Transformer 一节,去别处补。不是因为它写得差(我根本没读到),是因为一屏的篇幅,无论如何装不下注意力机制、多头、位置编码这三件事。补完再回来,你会发现全书都在讲「能做什么」,只有你没读到的那一屏,本该讲「为什么能做到」。
第五章那 6 屏,反而是全书最值得读的。它列的四条瓶颈——准确率、成本、就业、法律——四年过去一条都没消失,只是换了说法。今天你听到的「幻觉」「推理成本」「岗位替代」「训练数据侵权」,说的都是这四件事。一本入门书能提前把四个真问题摆出来,已经算合格。
一句话:它把「生成式 AI 能干什么」列成了一张清单,却没回答「为什么它能干」——而后者,才是这一轮技术真正让人睡不着的地方。
说明:五章屏数由 pages.jsonl 章节标签逐页切分(前言 2、第一章 13、第二章 15、第三章 49、第五章 8、后记与参考资料 6,合计 93);「第三章占 52.7%」「第二章占 16.1%」按 49/93、15/93 计算;第三章十个小节屏数为 1/9/4/5/7/1/7/1/6/7;第二章三节为 7/1/6;目录无第四章,而第三章插图编号为「图 4-9」(p0059),据此判断该章原为第四章;p0024、p0032、p0058、p0080 四屏抓取为空白帧(约 15KB),其中 p0024「Transformer和ChatGPT模型」与 p0032「生成文字」恰为全书最该核对的两节,故其内容未纳入引用,仅以篇幅入论 · 笔记与图谱生成于 2026-11-11
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。 看完整履历海报 → skills 实验室 →
发表评论: