
GPT图解 大模型是怎样构建的:443 屏手搓一个模型,最后 11 屏劝你去调 API
微信读书《GPT图解 大模型是怎样构建的》(黄佳)· 逐页翻阅 443 屏 · 抓取标记 reached_end=True(end_reason=last_page,书尾落点在后记 p0440)· 全书九课 + 序章 + 后记,阅读器共记录 86 个章块
抽样说明:这是一本需要跟着敲代码的书,所以我按「结构 + 关键实现」两条线抽读——书名与序言(p0006)、第 2 课词向量入口(p0080)、第 5 课缩放点积注意力(p0200)、注意力类型罗列(p0230)、第 6 课位置前馈网络(p0275)、解码器层实现(p0300)、第 7 课自回归与贪婪搜索(p0350)、WikiText2 训练与验证集(p0365)、第 8 课微调数据格式(p0398)、集束搜索实测输出(p0405)、第 9 课 GPT-4 API(p0433)、后记(p0440)。
章屏数按阅读器顶部章标签切分,标签存在滞后(约 ±2 屏)。本篇所有判断只依据上述页面以及 443 屏的章块统计数据,没有引用任何书外材料。
先说结论,省得你看到一半才发现我们在聊的不是同一本书。
这本书的名字叫《GPT 图解 大模型是怎样构建的》,但它教你构建的最大的模型,是一个跑在 WikiText2 上、用 GPT-2 词表、输出「app app app app」的小东西。全书 443 屏,讲到真正的「大模型」——千亿参数、张量并行、数据清洗流水线、显存账本——的篇幅是零。而它自己在最后一课开门见山地写:「说老实话,这可比我们开发自己的 GPT 和 ChatGPT 模型简单多了!」(p0433)然后给了你一行 pip install openai。
这句话我读了三遍。一本教你「怎样构建」的书,在第 433 页告诉你其实不用构建同一个东西,这到底算诚实,还是算把书名借出去用了?这篇文章就想把这个问题掰开:它的诚实值多少钱,它的书名欠了多少钱。
一、先把账摊开:443 屏里,「构建」只占两成
我不喜欢凭印象评价篇幅,所以把 443 屏按阅读器顶部的章标签切了一遍。结果比我预想的更刺眼:
第 1 课到第 4 课(N-Gram 与词袋、Word2Vec、NPLM 与 RNN、Seq2Seq)合计 125 屏,占 28.2%。第 5 课到第 6 课(注意力机制、Transformer)合计 136 屏,占 30.7%,是全书最厚的部分。第 7 课到第 8 课(搭一个简版 GPT、搭一个简版 ChatGPT)合计 100 屏,占 22.6%——这才是字面意义上的「构建」。第 9 课(GPT-4 API)11 屏,占 2.5%。序章与前言区另有 67 屏,占 15.1%。
翻译一下:前六课共 261 屏、58.9%,全部是在铺路;真正动手搭模型的两课,加起来不到四分之一;而真实的工程答案,只给了 11 屏。
这个结构本身不能算错。任何「从零构建」的书都得先讲清注意力,否则后面全是黑箱。但它决定了这本书的真实身份:它是一本「Transformer 与自回归语言模型的结构解剖课」,附赠一个能跑通的小 GPT。书名把「大模型」三个字放在最前面,读者带着「我想知道 GPT-4 是怎么造出来的」进来,最后拿到的是「我知道了 DecoderLayer 里那四个参数各管什么」。
这两件事的价值差得很远。后者稀缺,前者几乎不存在——市面上没有一个公开文档能告诉你 GPT-4 的并行策略、数据配比和算力账本。也就是说,书名承诺的那部分内容,不是作者不肯写,是这世上没人能写。出版社知道,作者大概也知道,但封面上的字还是那么印了。
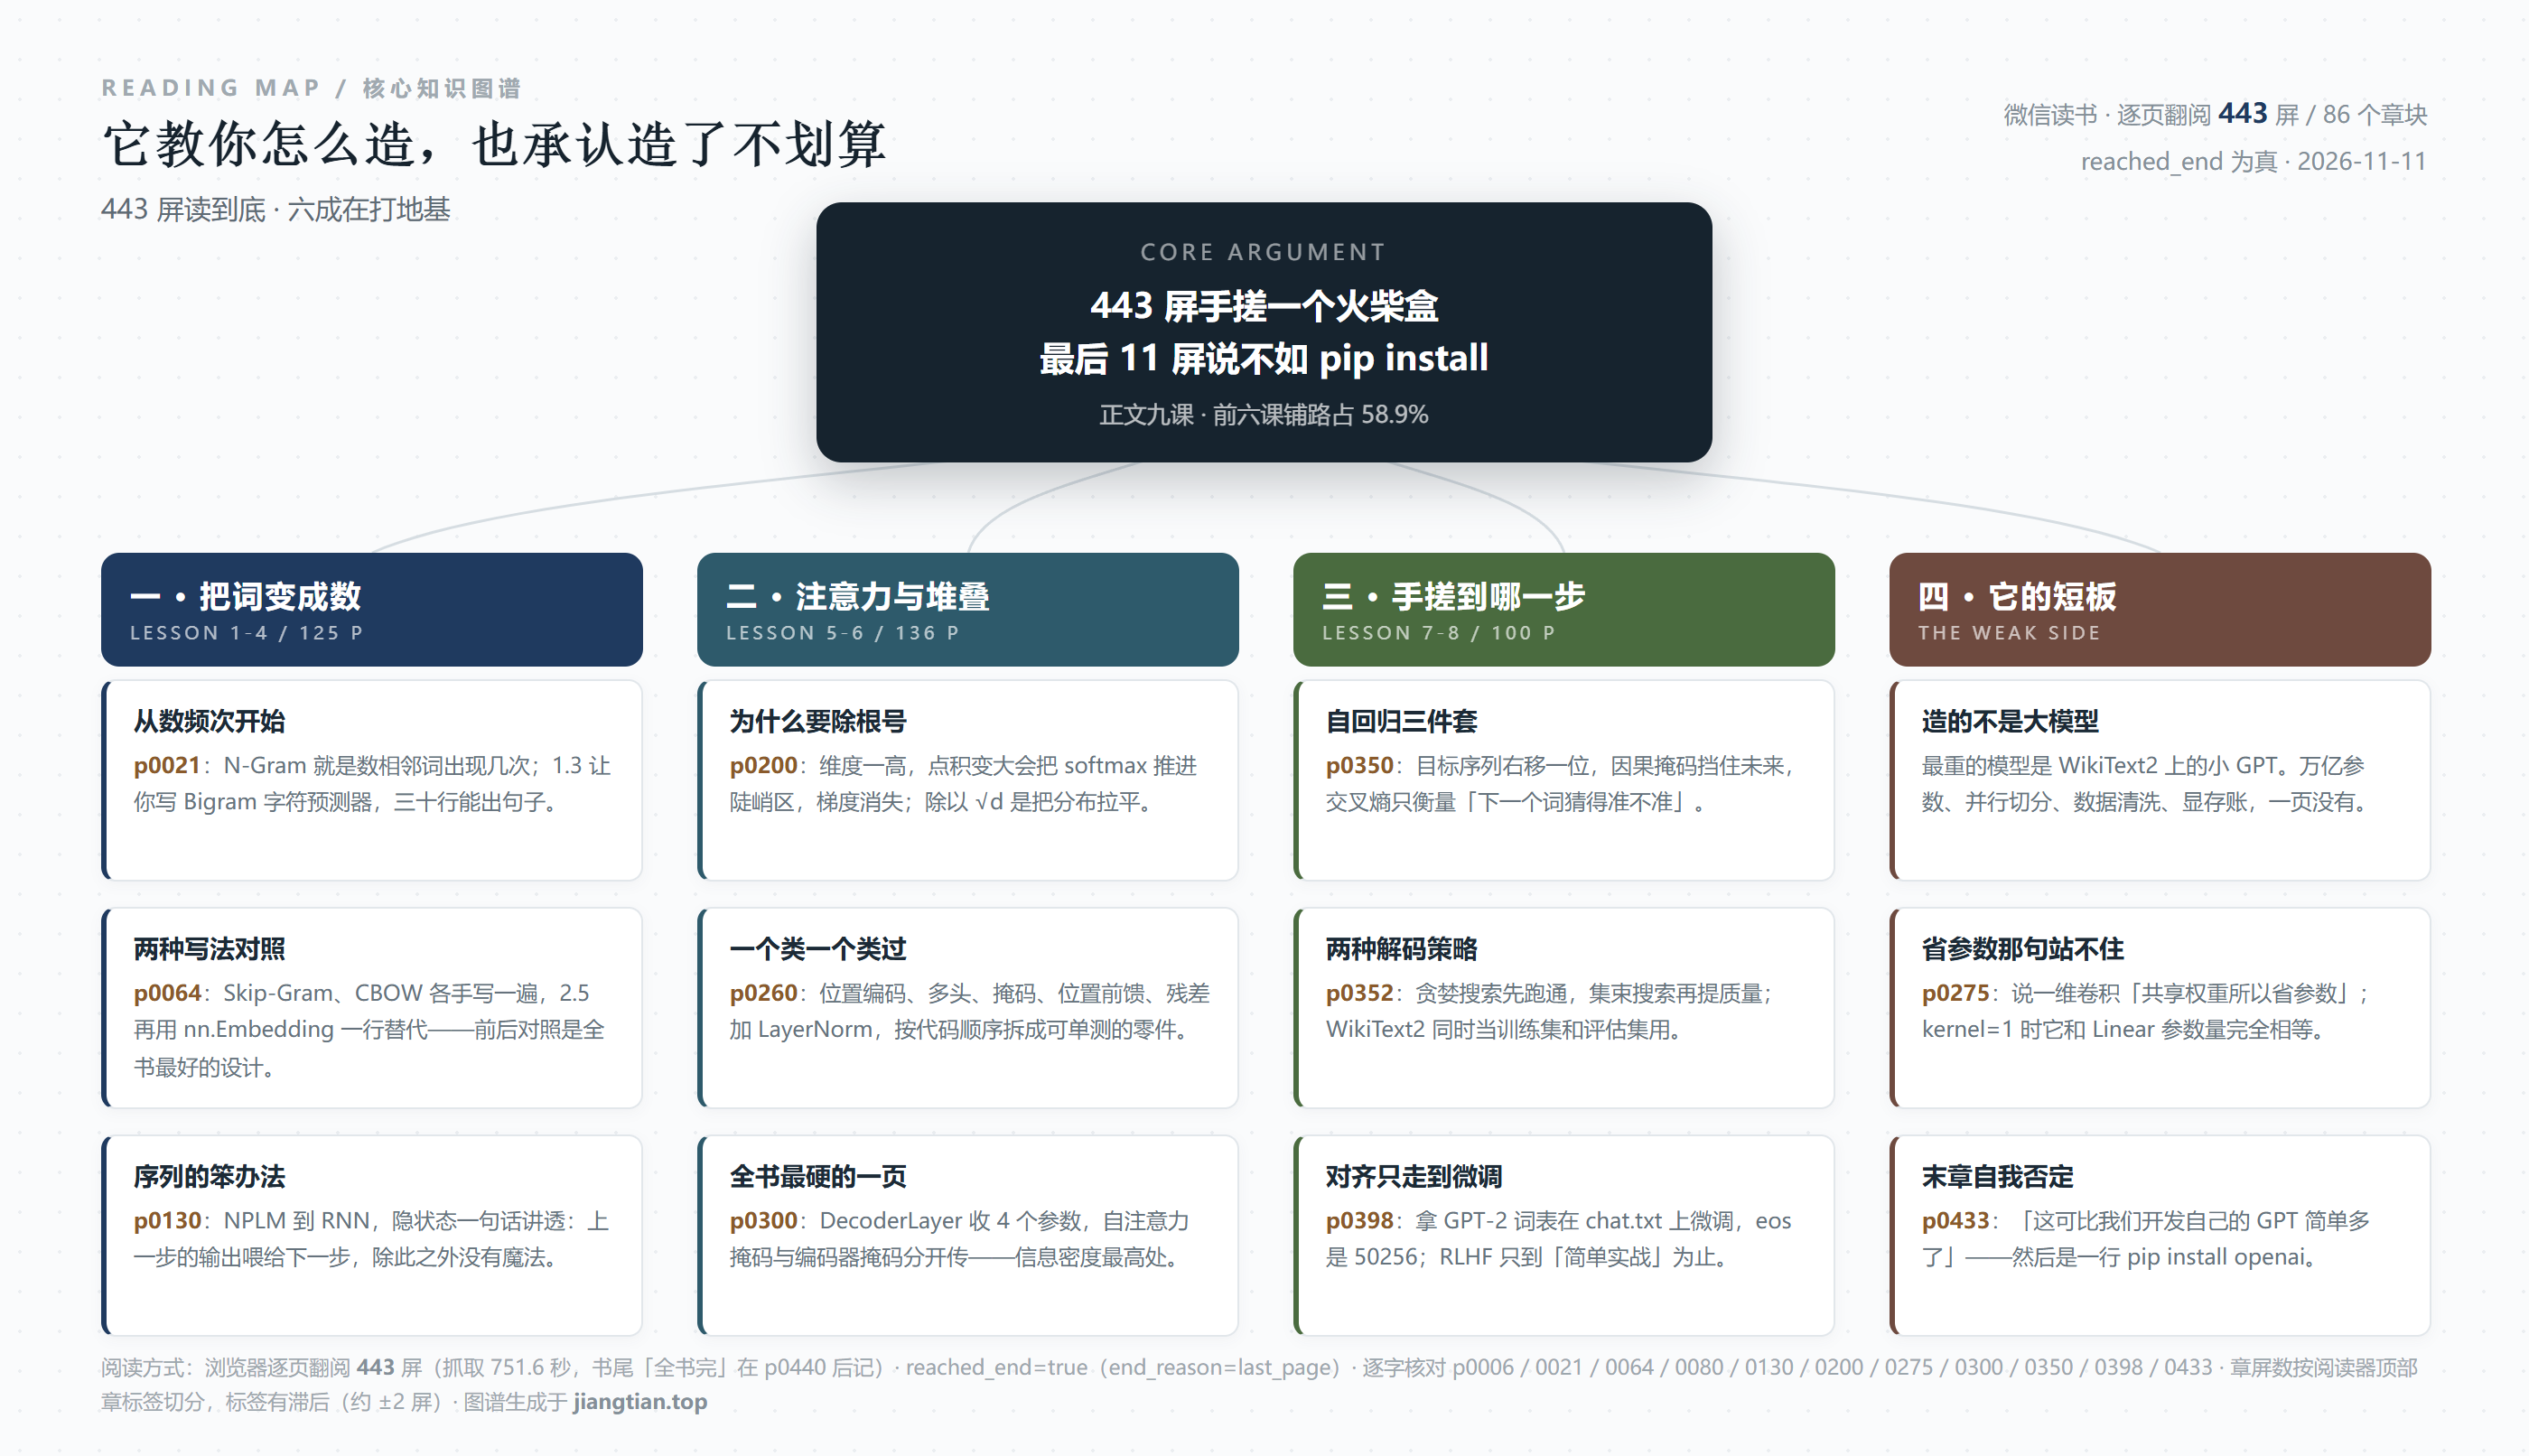
二、它做对的第一件事:让「词」变成「数」这一步不再玄学
第 1 课从 N-Gram 开始,这个起点选得比我见过的多数教材都低。低不是缺点——它把「语言模型」还原成一个你手算得出来的东西:数相邻的词一起出现了几次。1.3 节让你写一个 Bigram 字符预测器,几十行代码,喂进去一段文本,它就能吐出像模像样的句子。你不需要 GPU,不需要框架,甚至不需要理解梯度。
我特别欣赏这个安排的理由:它让你在没有任何数学负担的情况下,亲眼看见「概率」是怎么变成「文本」的。等到后面第 7 课讲自回归、讲每一个 token 都是从概率分布里采样出来的,你脑子里已经有画面了。先给直觉,再给公式,这个顺序在技术书里经常被反过来。
第 2 课的处理更狠一步。它先手写 Skip-Gram,再手写 CBOW,把负采样、上下文窗口这些概念都揉进代码里;然后在 2.5 节,用 nn.Embedding 一行把前面几十行替掉。
这个「先苦后甜」的对照,是全书最好的教学设计。因为大多数人学 embedding 的困惑不是「它是什么」,而是「我为什么要相信一个随机初始化的矩阵能表示语义」。你亲手写过一遍梯度下降之后,再看到那一行 nn.Embedding(vocab_size, dim),你会知道那个矩阵里每个数字都是被训练出来的,而不是被赋予的。这个认知差,值几十屏。
第 2 课的入口也值得一提。p0080 用「小冰」和「咖哥」的对话开场:咖哥把小冰看成小雪,理由是「性别相同、年龄相似、而且还挺可爱」,小冰反问「你是男的我是女的,怎么可能认错」,咖哥答「这就说明你们俩在某些维度上的特征有相似之处」。然后一句话拐进正题:「词向量,通常也叫词嵌入,是一种寻找词和词之间相似性的 NLP 技术,它把词汇各个维度上的特征用数值向量进行表示。」
用「认错人」解释「向量相似度」,这个类比是准确的,而且比「国王减男人加女人等于女王」那种经典例子更贴近中文读者的直觉。这种地方能看出作者是认真想过怎么讲的。
第 3 课和第 4 课加起来只有 56 屏(31 + 25),是全书最紧凑的两段,但它们是整本书的转折点,而且这个转折是靠一个数字完成的。
p0168 是第 4 课的 Seq2Seq 实现:编码器类和解码器类各一个,里面各塞一个 nn.RNN(hidden_size, hidden_size, batch_first=True),词表分中文和英文两套,而 n_hidden = 128。
请你盯住这个 128。它的意思是:一整个中文句子的意思,要先被压进一个 128 维的向量,然后解码器只能从这个向量里,把整句英文一点点挤出来。句子越长,压进去的信息越多,这 128 个数字就越不够用——这就是 RNN 架构的死结,也是注意力机制被发明出来的直接原因。
我之所以觉得这两课值得单独夸一句,是因为它没有把注意力当成天上掉下来的东西讲。它先让你亲手搭一个「必须把整句塞进定长向量」的模型,让你自己感觉到那个瓶颈在哪,然后再告诉你:有一种办法可以不压缩,让解码器每一步都回头去看编码器的全部输出。先造出病,再给药方,这个顺序让注意力从「论文里的技巧」变成了「我需要的解法」。这比直接画一张 QKV 图有效得多,也比任何「注意力机制解决了长距离依赖问题」的定义句有效得多。
三、全书真正的脊椎:第 5、6 课那 136 屏
如果你只有时间读一本书的三分之一,读第 5 课和第 6 课。这 136 屏是全书唯一不可替代的部分。
原因很实在:讲 Transformer 的文章多得是,但大多数停在「注意力就是 Q 乘 K 转置再 softmax」这一句,然后直接跳到 nn.Transformer。中间那一大段——缩放因子为什么要除、多头到底怎么切、掩码为什么要有两种、位置前馈为什么用卷积写——基本靠读者自己去论文里刨。这本书把这些全拆开了。
举个具体的。p0200 讲缩放点积注意力,它没有停在「除以根号 d 是为了数值稳定」这种正确的废话上,而是把因果关系走完:点积的值会随特征维度变大而变大,值一大,softmax 就会在一个非常陡峭的区域内运行,于是梯度变得非常小、甚至消失;除以缩放因子是为了让 softmax 工作在较平缓的区域。紧接着给了一张五步流程图——创建两个张量、计算点积得原始权重、除以缩放因子、归一化、加权求和——每一步一个方框。
这就是「图解」两个字唯一名副其实的地方:它把公式翻译成了操作顺序。公式告诉你结果是什么,操作顺序告诉你代码怎么写。中间这一层,是初学者真正卡住的地方。
第 6 课更硬。p0300 那一页在讲 DecoderLayer 的 forward 方法,它收了四个参数:解码器输入、编码器输出、自注意力掩码、编码器-解码器注意力掩码。一页里同时出现了两个掩码,而且明确分开传——这是全书信息密度最高的一处,也是最容易被别的书糊弄过去的一处。多数教程讲到「掩码」就一个 mask,读者永远搞不清为什么解码器要两个。
多头那部分(5.6)也是同样的做法:先把维度切开的动作写出来,再解释为什么。这里我想补一句自己的理解,因为书里讲得偏操作、没把代价说透:多头不是「多算几遍注意力再平均」,而是把 d_model 切成 h 份低维子空间,让每个头在自己那片子空间里学一种关系——有的头盯相邻词,有的头盯句法搭配,有的头盯指代。代价是每个头只有 d_model / h 维,表达能力被摊薄了。所以「头越多越强」是个误解,头数是在「关系种类」和「每种的精度」之间做交换。理解了这一层,你再看那些「把 head 数从 12 调到 16」的调参记录,就知道自己在动的是什么旋钮。
然后是一个我没想到的细节。p0275 讲 PoswiseFeedForwardNet,代码里用 nn.Conv1d 而不是 nn.Linear 来实现位置前馈网络。小冰问:「这里的 nn.Conv1d,也就是 PyTorch 的一维卷积层?为什么这个层可以实现逐位置前馈机制呢?」——这个问题问得很好,因为它正是我当年读论文时的疑问。
作者的代码是对的,这是标准做法(1×1 卷积等价于逐位置的线性变换,但内存布局和算子效率更好)。但他给的解释是错的,我留到第七节专门说,因为那一句话恰好暴露了这本书的方法论短板。
四、自回归那三件套,它讲清楚了——这是很多书没做到的
第 7 课是我认为全书第二值钱的部分,因为它回答了「GPT 到底在学什么」这个看似简单、其实一大半人答不上来的问题。
p0350 一口气给了三件事。第一,目标序列怎么来:把输入序列向右移动一个位置。第二,未来怎么挡住:靠后续注意力掩码,让模型在算当前位置的注意力时看不到后面的词。第三,损失怎么算:拿输出序列和目标序列比,每个位置对应一个「预测下一个词」的预测,用交叉熵衡量预测分布和实际分布的差异。
然后它补了一句我认为是全书最准确的技术判断:「基于 Transformer 架构的并行处理能力,虽然在训练阶段没有显式地将自回归过程建模,但自回归过程通过后续注意力掩码实现;在推理阶段(即生成新文本时),模型会根据先前生成的单词来生成下一个单词,从而体现出自回归特性。」
这句话点破了训练与推理的不对称:训练时是一次并行算完整条序列(靠掩码伪装成因果),推理时是一个词一个词地挤。理解了这一点,你才能理解为什么训练能塞满 GPU 而推理延迟下不来,为什么 KV Cache 是必需品,为什么「吞吐」和「首字延迟」是两个互相拉扯的指标。这本书没有展开这些工程后果,但它把机制说对了,读者可以自己往下推。
紧接着是两种解码策略:贪婪搜索先跑通(7.3.4),集束搜索再提质量(7.4.4)。训练数据用 WikiText2,评估也用它——p0365 显示作者建了 valid_iter = WikiText2(split='valid'),然后在训练循环里跟踪最低验证损失、把最好的模型存成 best_model.pth。保存最优检查点这个动作虽小,但它是「工程习惯」而不是「教学演示」的标志。很多教程跑完就把最后一个 epoch 存下来,那是在教坏习惯。
五、443 屏之后,模型说「app app app app」
现在说到这本书里我最想给你看的一页:p0405。
那是第 8 课集束搜索的实测输出。作者喂了两个问题:
测试 1:User: what is the weather like today? AI: you need an current time for now app with app app app app
测试 2:User: can you recommend a good book? AI: ockingbird Lee Harper Harper Taylor(p0405)
作者没有藏,他接着写:「模型的回答虽然称不上完美,但是,我们至少能够看出,微调数据集中的信息起到了一定的作用。」然后他老老实实解释:第一个问题问天气,模型敏锐地指向了「app」(应用),因为这词在训练语料里出现过;第二个问题它给出了语料库推荐图书的作者名「Lee Harper」,而书名「To kill a Mockingbird」里的 mockingbird 是个未知 token,被拆成了三个 token。
这一页是全书最有价值的一页,价值远超任何一段讲得漂亮的注意力公式。理由是:技术书最缺的从来不是成功案例,是失败样本。而这一页用一个几乎滑稽的输出,把「能跑」和「能用」之间的距离量出来了——那个距离不是代码行数,是数据量和算力。
你可以顺着这一页往下推很多事。为什么语料只有一本书的模型会答出「app app app app」?因为它的世界只有那么大,概率分布几乎是平的,集束搜索只能在几个高频碎片之间来回挑。为什么真实的对话模型需要几万亿 token?因为你要让它见过足够多的上下文,才能让「what is the weather like today」后面接上「you need a weather app」而不是「app app app app」。这一页讲的东西,比前面 400 页加起来更接近「大模型是怎样构建的」这个书名——虽然它是用反面方式讲的。
我甚至认为,如果作者把这一页的失败拆成一整章——为什么数据规模决定输出质量、为什么 tokenization 的边界会吃掉答案、为什么小模型的困惑度降不下去——这本书会好得多,也才对得起书名里的「大」。
顺着这一页我再补一刀,这一刀砍在「评估」上。这本书教你保存最优检查点,却没给你一把量「好不好」的尺子。读到最后一页,我说不出那个训练好的模型困惑度是多少,也说不出它和 GPT-2 差几个数量级、和「能用」差几个数量级。而这两个数字恰恰是把「我做了个模型」变成「我知道我做到了哪一步」的唯一桥梁。
这不是苛求。一本工程向的书,只要多给一张表——模型参数量、训练集词数、困惑度、能生成的最长合理句子——读者就能自己判断「再往上堆十倍算力,大概能到什么水平」。没有这张表,443 屏读完之后,你手里只有一个「跑通了」的结论,没有一把能对外比较的尺子。而「跑通」和「理解自己在什么位置」,是两件事。
六、最后 11 屏:作者自己把台子拆了
第 9 课只有 11 屏,占 2.5%。这个比例本身就是一种表态。
p0433 的对话是这样的:小冰说「你说了这么半天,开发几个基于 GPT-4 API 的应用,让我们见识见识呗」,咖哥答——请允许我完整引用,因为这句子是全书的判词:
「说老实话,这可比我们开发自己的 GPT 和 ChatGPT 模型简单多了!只要完成下面几个步骤,我们就能创建出非常强大的聊天机器人了。」(p0433)
后面是一行 pip install openai,一行 openai.api_key = "替换成你的 Key",然后设置对话消息。
我第一反应是:这 400 多屏是不是白读了?冷静下来想,不是。因为「知道它怎么造」和「要不要自己造」是两个问题,前者是理解,后者是决策。这本书给了前者,然后在最后 11 屏诚实地回答了后者:别造,除非你要学。
但这里有一个我必须点出来的错位:这份诚实来得太晚,而且没有出现在最该出现的地方。它出现在第 433 页的对话里,而不是封面上、不是序言里、不是第一章开头。一个买了这本书、打算「构建自己的大模型」的读者,要读完 433 屏才会被告知「其实调 API 更简单」。这 433 屏的时间成本,本可以在第 10 屏就被省下来。
更值得说的是:作者在 p0433 承认「简单多了」的时候,其实是在承认一件事——「构建」和「使用」之间的能力落差,已经大到用 API 和使用手搓模型是两种完全不同的职业。手搓让你理解机制,API 让你交付产品。这两件事都需要,但一本叫「怎样构建」的书,只该承诺前者,然后把后者作为对照写清楚。它做到了对照,没做到在书名里守约。
七、它的短板(这一节我不打算客气)
第一,书名欠账。前面算过了:「大模型」的构建(分布式训练、数据工程、对齐流程的工业版本、推理优化、成本控制)在这本书里是零页。第 9 课那 11 屏讲的是「调用」,不是「构建」。这不是疏漏,是这本书根本的定位问题——它其实是一本《图解 Transformer 与小型 GPT 实现》,那个名字不好卖,所以换了现在这个。
第二,p0275 那句关于「省参数」的解释,是错的。原文说:「其原因是全连接层不共享权重,而一维卷积层在各个位置上共享权重,所以能够减少网络参数的数量。」
这句话经不起算。nn.Conv1d(d_model, d_ff, kernel_size=1) 的参数量是 d_model × d_ff + d_ff,nn.Linear(d_model, d_ff) 的参数量也是 d_model × d_ff + d_ff。两者完全相等。因为 1×1 卷积和逐位置的线性层本来就是同一个线性映射的两种写法,权重在两种实现里的「共享范围」是一模一样的。
那什么情况下卷积真的省参数?只有当卷积核大到覆盖整条序列、所有位置共用同一组覆盖全局的权重时,参数量才会少于逐位置的全连接。而如果卷积核大于 1 但小于序列长度,参数量反而会变成 d_model × d_ff × k + d_ff,比 Linear 更多。所以「共享权重所以减少参数」这个因果链,在两个方向上都不成立。
这件事小的层面是一个知识点写错了,大的层面是方法论问题:这本书对身体力行的部分(代码)非常可靠,对「解释为什么」的部分经常靠语感编。代码能跑,所以错误不会被运行结果揭穿;解释错了,读者也发现不了,只能带着一个错的理解继续往下走。技术书最危险的不是写错代码,是写错解释——代码错了会报错,解释错了会跟着人很多年。
第三,概念罗列段落缺可执行内容。p0230 一口气列了局部注意力、自适应注意力、分层注意力、因果注意力四种。文字都对,定义都准,但你读完之后不能写出其中任何一种。这一页的功能是「让你知道有这些东西」,不是「让你会用」。放在一本以「图解」和「手搓」为卖点的书里,这种纯词条式的段落显得格格不入——它把最容易查到的部分写长了,把最难查到的部分(这些机制在什么场景下值得用、代价是多少)留白了。
第四,对话体稀释了密度。小冰和咖哥这条线,在解释概念时是好用的(认错人那个例子就是证明),但在 443 屏的尺度上,它带来了大量不承载信息的往返:提问、惊讶、打趣、再提问。我抽读的页面里,p0080 那段「小冰:……」「咖哥:和你开个玩笑」就占了小半屏。443 屏里如果有 15% 是这种内容,那就相当于 60 多屏的篇幅被用来维持语气。对一个想快速查某个实现细节的读者,这是纯成本。
第五,没有成本账,也没有失败复盘。全书没有一页告诉你:训练这个小 GPT 需要什么显卡、跑多久、显存占用多少。也没有一页复盘「如果模型训崩了怎么排查」。p0405 那个「app app app app」是绝好的失败样本,但它被当成一个「有点好笑但能理解」的插曲带过了,没有被拆解。一本讲构建的书,最该教的是「构建失败时你看到什么、该改什么」,这一块是空的。
八、所以,谁该读它
我不想把这本书说成一无是处,因为它确实有不可替代的部分。给你三条具体的判断标准:
如果你想知道 Transformer 内部到底怎么转的——读第 5、6 课,136 屏,值得。这两个课的价值在于它们敢把 DecoderLayer 的两个掩码分开讲、敢把缩放因子的因果链走完、敢用 nn.Conv1d 写位置前馈并解释(虽然解释错了)为什么这么写。这部分内容你很难在别处一次看全。
如果你想「构建自己的大模型」——别买。这本书会让你搭出一个能跑的小 GPT,然后你会误以为自己理解了 GPT-4。真正的差距在数据、算力、并行和工程流水线,这四样书里一个字都没有。
如果你只想尽快做出一个能用的对话应用——直接看第 9 课那 11 屏,然后去读官方的 API 文档。前面 432 屏对你来说是背景知识,可以留着以后补,但不是今晚的必需品。
回到最开始那个问题:它诚实吗?诚实的,但诚实在错误的位置。一个作者愿意在第 405 页贴出「app app app app」,愿意在第 433 页说「这比我们自己造简单多了」,这已经比大多数技术书有骨气——大部分人会把难看的输出删掉,把 API 那一章写成「进阶应用」来撑篇幅。
可书名不是他一个人定的。而这本 443 屏的书,最终教给我的不是「大模型是怎样构建的」,是另一件事:把机制拆开讲清楚,和把一个系统造出来,是两种完全不同的能力;这本书把前一种做到了八十分,然后用书名冒充了后一种。
读懂它需要 443 屏,看穿它只要第 433 页那一句「这可比我们自己造简单多了」。
阅读记录 《GPT图解 大模型是怎样构建的》,黄佳著,微信读书 · 逐页翻阅 443 屏 / 86 个章块 / 抓取耗时 751.6 秒 · reached_end=true(end_reason=last_page,后记 p0440 为书尾)· 逐字核对页码:p0006、p0080、p0200、p0230、p0275、p0300、p0350、p0365、p0398、p0405、p0433、p0440 · 章屏数按阅读器顶部章标签切分,标签滞后约 ±2 屏,故百分比有 0.5 个百分点内的误差 · 文中所有引用均来自上述页面,未使用书外材料 · 图谱见文内插图(jiangtian.top)
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: