
大模型RAG实战:110 个零件拆得干净,装配图只给一页
微信读书《大模型RAG实战:RAG原理、应用与系统构建》· 逐页翻阅 324 屏 · 抓取标记 reached_end=True(end_reason=last_page,书尾落在 p0324 第 8 章小结)· 阅读器共记录 110 个章块,分三部分八章
抽样说明:这本书的结构本身就是论点,所以我两条线一起抽——目录与前言(p0006)、RAG 的缺点(p0029)、伸缩法则与知识库大小的关系(p0033)、相似度搜索与复杂推理(p0036)、CoSENT 排序损失(p0113)、深度学习切块(p0146)、向量数据库横向对比(p0157)、召回评估指标(p0180)、模型回答评估(p0183)、TRIME 批近似(p0243)、模型选型(p0266)、微调数据构造(p0290)、推理封装代码(p0318)。
章屏数按阅读器顶部章标签切分,标签存在滞后(约 ±2 屏)。有一处副作用要说明:正文 4.3.3 节讲 Weaviate,章标签没捕获到,所以统计里 4.3.2 直接跳 4.3.4——这是抓取的锅,不是书的错。本篇所有判断只依据上述页面和 324 屏的章块统计,没有引用任何书外材料。
先说一句可能让你不太舒服的话:如果你买这本书是为了「照着做一个能上线的 RAG 系统」,它给你的东西不够;但如果你已经做过一个,正在某个地方卡住,它能救你。
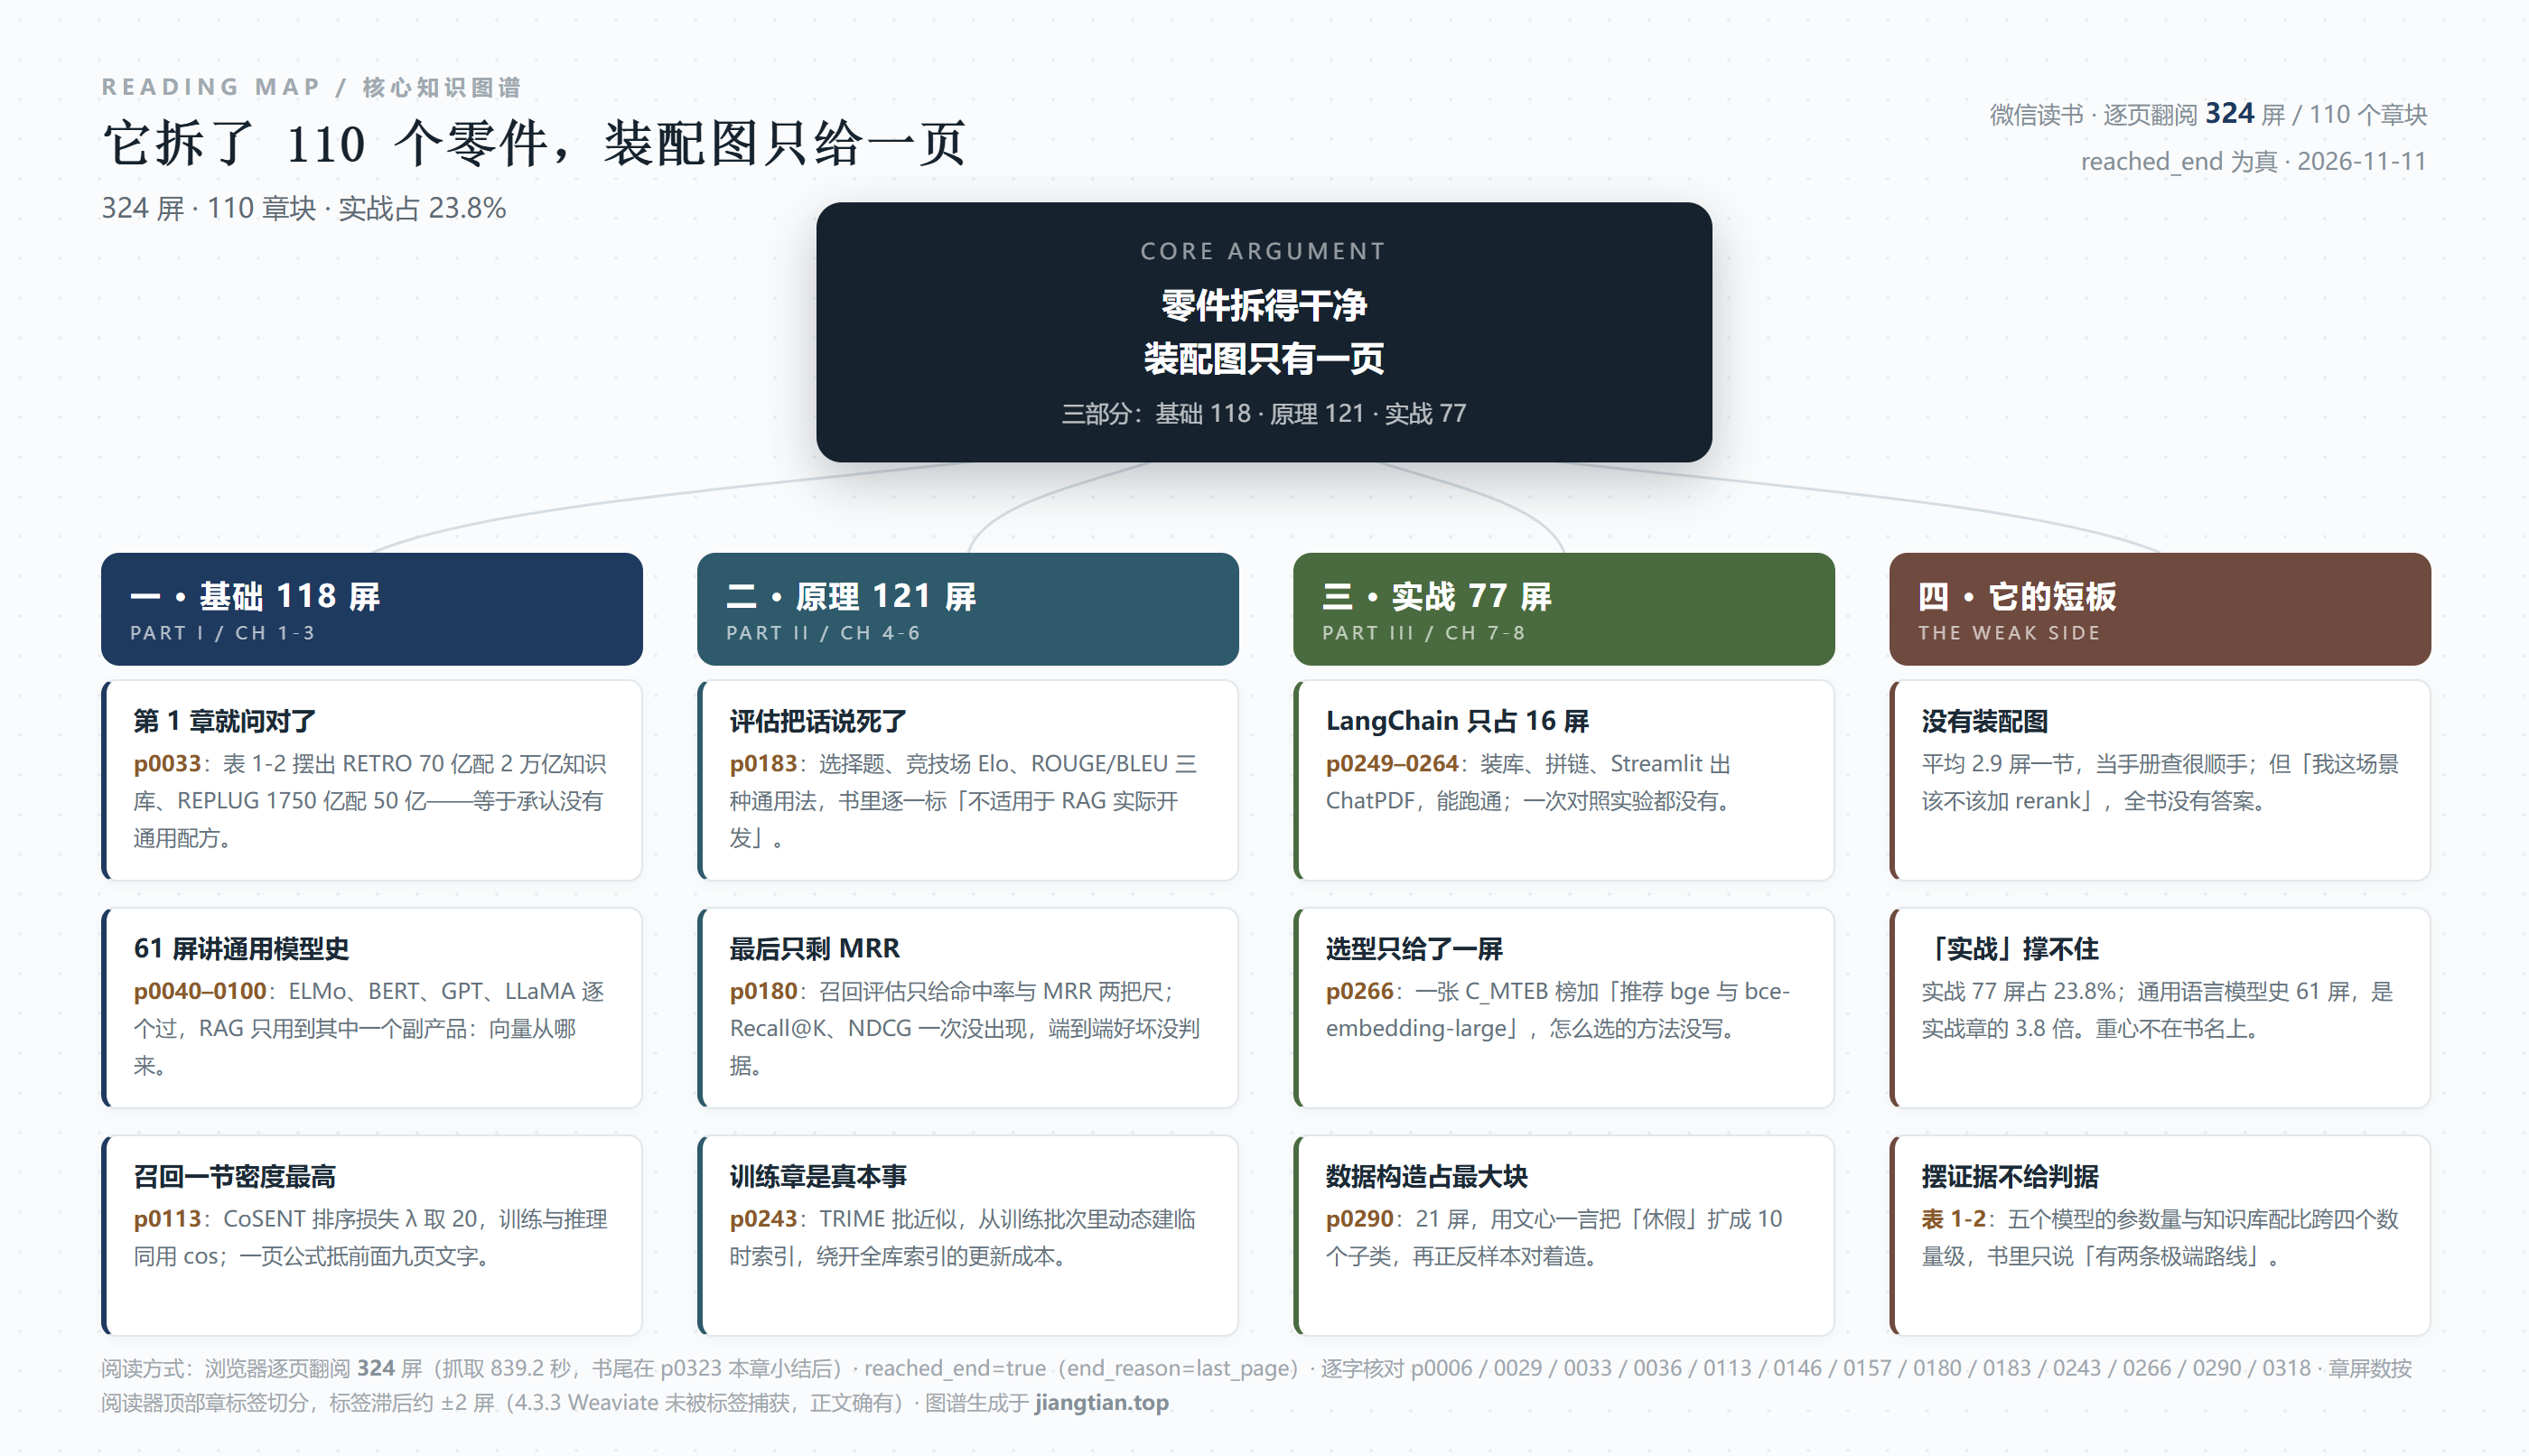
这两件事的差别,藏在它的结构里。324 屏,三部分——基础 118 屏,原理 121 屏,实战 77 屏。书名把「实战」两个字放在最后,结果它也是最后一名,占 23.8%。而「基础」那 118 屏里,有 61 屏在讲 ELMo、BERT、GPT、LLaMA 这些通用语言模型史。
我不是说讲这些没用。我是说,一本 324 屏的书,用 18.8% 的篇幅去讲一个「RAG 只要用到它副产品」的领域,这个比例说明了作者心里的读者是谁——他假设你连 Transformer 都没系统学过。这个假设在 2023 年成立,在 2026 年就未必了。
那这本书还值不值得读?值得,但不是因为它叫「实战」。是因为两处别人不写的东西:一处是它敢在第一章就问「上下文窗口都这么长了,RAG 还有必要吗」;另一处是第六章那 23 屏训练细节。这两块,市面上的 RAG 内容基本绕着走。下面挨个说。
一、先把账摊开:61 屏讲通用模型史,实战只有 77 屏
我把 324 屏按阅读器顶部的章标签完整切了一遍,这样比任何主观印象都可靠:
第一部分「基础」,p0009 到 p0126,共 118 屏,占 36.4%。其中第 1 章讲 RAG 是什么(30 屏)、第 2 章讲语言模型基础(61 屏,占全书 18.8%)、第 3 章讲文本召回模型(26 屏)。
第二部分「原理」,p0127 到 p0247,共 121 屏,占 37.3%。第 4 章是全书最厚的一章(74 屏,22.8%),装下了提示词、切块、向量数据库、召回优化、评估、LLM 能力优化六件事;第 5 章讲范式演变(23 屏);第 6 章讲系统训练(23 屏)。
第三部分「实战」,p0248 到 p0324,共 77 屏,占 23.8%。第 7 章用 LangChain 拼一个 RAG 加 Streamlit 界面(16 屏,4.9%);第 8 章讲构建与微调(60 屏,18.5%),而这一章里最长的一节是「微调数据构造」,21 屏,是全书单个小节里最大的一块。
把这几组数字放在一起,两件事立刻浮出来。
第一,第 2 章的语言模型史(61 屏)是第 7 章 LangChain 实战(16 屏)的 3.8 倍。一本叫「实战」的书,讲怎么把系统拼起来的篇幅,不到讲 BERT 和 LLaMA 谁的注意力怎么改的零头。
第二,全书 110 个章块塞进 324 屏,平均每个 2.9 屏。这个数字你细想一下就知道它的形态:这不是「章节」,这是「词条」。2.9 屏能装什么?装一个定义、一段动机、一个公式或者一段代码、一句小结,然后就翻页了。它更像一本可以查的手册,而不是一本可以顺着读下来的书。
手册不是贬义。工程上真遇到「Qdrant 和 Chroma 到底差在哪」这种问题,翻手册比读论文快。但手册有个天然缺陷:它只告诉你每个零件是什么,不告诉你这台机器该怎么装。而 RAG 恰恰是一个「零件都懂、装起来就崩」的领域——你切块切得再讲究,召回指标再漂亮,最后答非所问的概率该多高还是多高。
二、第 1 章就问对了问题:上下文学会把 RAG 吃掉吗
全书我认为最有价值的一段,在 p0006 的前言里,而且只用了一段话。
作者自陈在金山办公任职,2023 年初开始试大模型落地,最先落地的应用就是基于金山知识库的 RAG,后来又推出基于云文档的 ChatFile 和基于金山协作的搜索助手。然后他正面回应了那个所有人都想问、但写书的人通常躲着的问题:现在闭源模型的上下文窗口已经能装下大部分书籍资料,RAG 是不是要没用了?
他的回答不是「不会的,RAG 很重要」,而是给了两个具体的物理约束。第一个是企业知识库的量级——「即使是一个小型企业,企业内的知识库文档量也是非常庞大的,我们不可能全部都放入大模型的提示词中」。第二个是显存——大模型做无损推理时要缓存每个时间步的 KV,「随着长度的增加,显存消耗是非常庞大的,所以单张推理卡的推理长度有限」。
我读到这里的时候停了一下。这是工程师的回答方式:不谈愿景,谈卡和内存。市面上关于「RAG 已死」的争论,多半停在「模型能力」这一层——上下文变长了,检索就没必要了。而作者直接跳到「那张卡装不下」,把讨论从抽象拉回物理。这个视角比结论本身更值钱,因为结论会过期,而「先算显存再谈架构」这个习惯不会。
顺着这个思路,1.6.1 节给了一张表(表 1-2),把 RAG 的五个经典模型的参数量与知识库大小并排放:KNN-LM 2.5 亿参数配不超过 30 亿的知识库;NPM 3.5 亿配 10 亿;Atlas 110 亿配约 300 亿;RETRO 70 亿配 2 万亿;REPLUG 不超过 1750 亿配约 50 亿。
这张表是全书信息密度最高的地方之一,因为它一眼就能看出:这个领域根本没有一条「小模型配大库等于大模型」的稳定公式。RETRO 用 70 亿参数撑 2 万亿的知识库,REPLUG 反过来用 1750 亿参数只配 50 亿——参数量差了 25 倍,知识库规模差了 400 倍,走的是两个完全相反的方向。
但这也是全书最典型的毛病:他把证据摆出来了,然后把判断收走了。表下面只有一句「有两个极端的模型」,接着就转去讲 Scaling Law 的定义。读者最想知道的那个问题——「我的知识库到了多大规模,才该考虑加检索」——一个字都没有。你手里有了五个数据点,却拿不到一条决策线。
更能说明作者水准的是紧跟着的 p0036。他引了 2022 年的论文《Can Retriever-Augmented Language Models Reason? The Blame Game Between the Retriever and the Language Model》,并老老实实写下结论:检索器用的相似性度量通常不足以应对推理任务,检索增强模型里的语言模型也没充分考虑语句间的复杂关系,即使换成更大的模型,推理性能依然较差;多跳检索带来的改进「是微小的」。
这段话对一个正在做 RAG 的人是当头一棒,而且是有用的那种棒。它等于说:你花力气优化召回率,能解决的是「找不找得到」,解决不了「想不想得明白」。而绝大多数 RAG 项目上线后收到的差评,恰恰是后者。这本书在第一部分就把这个坏消息告诉你,比放在最后一章当免责声明要诚实得多。
「对于RAG系统而言,推理仍然是一个非常具有挑战性的课题。」(p0036)
——这句话出现在全书第 36 屏,不是结尾。作者没有把它包装成一个「未来展望」。
账摊到这儿,最该被追问的就是那 61 屏——它是全书最厚的一章,也是离 RAG 最远的一章。
第 2 章 61 屏,内容从 Transformer 的编码器解码器结构,一路讲到 ELMo、BERT、GPT、LLaMA。写得清楚,图也画得规整,p0050 那页 CBOW 的窗口函数连代码带图一起给,context = [raw_text[i - window_size], ...] 这种细节都没省。
问题在于:对一个要做 RAG 的人来说,这一章的可操作信息接近于零。
不是说它错。RAG 里所有向量都来自这类模型,不懂 BERT 和 GPT 的区别,你确实说不清为什么「BERT 类模型适合做召回、GPT 类模型适合做生成」。这本书也确实在某处把这句话讲到了。但 61 屏讲完,落到 RAG 上的收益,是一句话。
对比一下第 3 章。第 3 章只有 26 屏,讲的是文本召回模型——SimCSE、SBERT、CoSENT、WhiteBERT、SGPT 五个稠密检索模型,朴素词袋、TF-IDF、BM25 三个稀疏方案,最后加一节重排序。这 26 屏才是「RAG 的召回到底怎么回事」的正解。
61 屏的通用知识,26 屏的领域知识。这个配比,在任何一本以应用为主题的书里都说不通。它唯一合理的解释是:作者把读者设定成「完全没接触过 NLP 的人」,于是从最底层开始铺。这在 2023 年是对的——那会儿大部分读者确实需要这一段。但书是给别人用的,读者的时间是有成本的。如果一个做后端的工程师拿起这本书,他得先游过 61 屏语言模型史,才能到第 3 章看到真正能用的东西。
真正让我在意的是另一层:这 61 屏占掉的篇幅,本来可以装什么?后面会说到,全书没有一节讲权限隔离,没有一节讲多租户,没有一节讲线上监控。61 屏换来的是一段可以随便找到替代品的内容,代价是三块找不到替代品的空白。这笔账,作者没算。
三、密度最高的两处:CoSENT 的一个公式,切块的一页综述
说完批评,得说它真正硬的地方。这本书有两页,我读完之后专门回头又看了一遍。
第一页是 p0113,CoSENT。全书讲召回模型的那些节里,大部分是一屏一个模型的「综述式」写法:这个模型干嘛的、谁提出的、大概什么思路。但 CoSENT 这一节给了一个完整公式:
loss = log ( 1 + Σ eλ(cos(vk,vi) − cos(vi,vj)) )
然后他做了三件事,一件比一件具体。第一,把符号落地:正样本对是 (i, j),负样本对是 (k, l),如果两段文本语义匹配——同义句、同一问答对——它们就是正样本对。第二,给超参:λ 是大于 0 的常数,默认为 20。第三,给出「为什么它比 SBERT 好」的机制解释:CoSENT 在训练和推理过程中都用 cos 相似度,计算逻辑一致,所以训练出来的模型效果优于 SBERT。
这三步的价值在于,它把一个「论文里才有的方法」变成了「你能自己改的东西」。「训练和推理用同一个度量」这句话,是全书唯一一处把「工程一致性」讲成了原理。你如果做过向量检索,会知道这句话有多重——训练时用点积、推理时用余弦、结果分数不可比,这种错在真实项目里天天发生,而多数书根本不提。
第二页是 p0146,深度学习切块。切块这件事,几乎所有 RAG 教程都用一句话带过:「按 500 token 切,加一点重叠」。这本书给了两代方法:Cross-Segment 模型先把每个句子独立向量化,再把连续多个句子的向量一起送进另一个 BERT 或 LSTM,一次性预测每个句子是不是段落边界;SeqModel 进一步改用 BERT 同时对多个句子编码,建模更长的上下文依赖后再算句向量,还加了自适应滑动窗口,在「不牺牲准确性」的前提下加速。
这段写得克制,但它其实回答了一个很实际的问题:固定长度切块为什么会把语义切断?因为切块本质上是「文本分段」这个老任务,而分段这件事,NLP 领域早就有人在做了。一个做 RAG 的人如果知道这条路存在,就不会满足于 chunk_size=500, overlap=50 了。这才是「原理」两个字该起的作用:不是解释现象,是打开选项。
向量数据库那一节(p0150 到 p0159,共 10 屏)也值得一提,但评价要低一档。Faiss 给了 7 屏,包括索引类型和代码;Milvus 给了 1 屏,用七条优点列表——可靠性靠数据复制与故障恢复、可扩展性靠组件级自动扩缩容、多种检索方式支持标量与向量混合过滤、流批结合、社区活跃到「1000 多个企业用户、200 多个开源项目共享者」。然后 Weaviate 一屏、Chroma 一屏、Qdrant 一屏。
这就是典型的「选型页」写法:每个产品一段定性描述,没有一个统一的比较维度。你想知道「百万级向量、单机、要求 50ms 内返回,该选谁」,这十屏给不出答案——因为它压根没在同一把尺子上量过。倒是有个细节挺诚实:Weaviate 那段末尾自己承认「目前只成熟地支持了分层可导航小世界(HNSW)这一种快速检索算法」。这种「自曝短板」的句子,比前面七条优点加起来更可信。
四、评估那 12 屏:把三种通用方法全否了,然后只剩一个 MRR
如果只允许我推荐这本书的一章给同行,我推荐 4.5 节「效果评估」,12 屏。推荐的理由不是它讲得好,而是它把一件很多人不愿意承认的事说出来了:通用的 LLM 评估方法,对 RAG 基本没用。
p0183 一口气列了四种方法,然后挨个否掉。
选择题评估法——造选择题数据集让模型做,能比较准地评估 LLM 能力,但「构建高质量且全面的数据集成本较高,并且很难完全避免 LLM 对测试集数据的有针对性训练和榜单刷分问题」,代表是 OpenCompass、C-eval,然后一句断语:「该方法不太适用于大模型RAG实际开发。」
竞技场评估法——两个匿名模型各答一题,用户投票,算 Elo 排名。「该方法评估最为客观,但是需要大量用户参与,难度大,也不太适用于大模型RAG实际开发。」
传统 NLP 指标——ROUGE、BLEU,需要参考答案,「主要考查句子之间词的重合度,无法考虑语义信息,评估效果不太准确」。
第四种是向量化模型评估法。
三段「不太适用」连着出现,这是全书最干脆的地方。它等于告诉读者:你在别处学到的评估套路,搬到这里会失效。为什么失效?因为 RAG 的失败模式不是「答得不好」,而是「答得很流畅,但答的是另一份文档里的事」。ROUGE 量不出这个,选择题量不出这个,Elo 也量不出这个——除非你把「引用来源对不对」单独拎出来当指标。
那它给了什么?p0180,召回环节评估,两个指标:命中率(召回文本里有没有包含答案的片段,只有命中/未命中两种状态)和 平均倒数排名 MRR,公式是 MRR 等于「每个问题对应答案片段在召回列表里排名的倒数」求平均。
然后就卡住了。书里自己承认:「在实际场景中,通常没有现成的『问题-包含答案的文本片段』测试数据二元组」,只能拿 LlamaIndex 之类的工具去构造。
这就是全书最大的结构性缺口。324 屏里,评估只给了 12 屏,指标只给了两个(MRR 和命中率,本质是同一件事的两种粒度),而 RAG 工程里真正天天用的那些——Recall@K、NDCG、上下文精度、答案忠实度——一次都没出现。换句话说:它教你怎么把系统搭起来,却没教你怎么判断搭起来的是不是个废品。
我理解为什么难写。RAG 的端到端评估到现在也没有公认方案,写细了容易过时。但一本 324 屏的书,用 21 屏讲「怎么用大模型扩子类造训练数据」,用 12 屏讲「怎么判断系统好不好」,这个配比本身就暴露了作者的重心:他更擅长造,不太愿意谈验收。
五、第 6 章那 23 屏:同类书基本不写的东西
现在说这本书真正的护城河。第 6 章「RAG 系统训练」,23 屏,讲的是怎么把召回模块和生成模块放在一起训。这块内容,我在其他 RAG 相关的书里基本没见过——大部分书停在「检索 + 拼进 prompt + 生成」,再往下的梯度怎么流,就不说了。
作者先讲清楚难点:普通 RAG 里,向量模型一更新,索引就得跟着更新,训练成本因此大幅增加。这个观察很实在,做过的人都懂——你换了 embedding 模型,全库几十万条向量要重算、重建索引,一晚上的事。
然后是 p0243 的 TRIME。这一页给了两个公式,而且是我在全书中看到的最「学术」的一页。先是标准的 token 级预测:P(y|x) ∝ exp(ETf(x)),其中 E 是解码器的特征、f(x) 是输入序列的向量表示。然后是与标准语言模型训练相比多出来的那一项,训练目标变成:
P(y|x) ∝ exp(ETf(x)) + Σ(k,v)∈D I[v=y] exp(−d(Enc(k), Enc(x)))
文字解释给得很到位:前半部分与标准的语言模型训练一致,后半部分是检索增强的损失。机制上,TRIME 的做法是「放弃传统的对全量知识库建立索引,而选择实时从训练批次中动态构建临时索引」——这样就不必为整个大规模知识库付索引成本。
这一页为什么值钱?因为它回答了一个从没人正面回答的问题:RAG 里的「检索」能不能被训练进参数里,而不是每次推理都去查库。答案是能,代价是你得接受「索引只在一批数据内有效」这个近似。这个近似的名字就叫批近似,它把这件原本不可能的事(全库索引跟着梯度更新)变成了一件可能的事(批内临时索引)。
我得说句公道话:这 23 屏是全书唯一让我觉得「作者真的在一线做过这件事」的地方。前面那些章节,只要读得够多,谁都能写;但一个人愿意花 23 屏去讲异步更新索引、冻结召回、冻结生成、联合训练、批近似,说明他至少踩过这些坑。
可惜的是,这 23 屏没有一行代码。第 8 章倒是有代码(p0318 那个 HFInference 类,LlamaTokenizer 加 device_map="auto"、use_flash_attention_2=True、bfloat16,写得挺规矩,连 temperature 传 0 时兜底成 0.001 这种防除零的细节都留了),但训练章和代码章是断开的:你知道了批近似的公式,却不知道从哪一行开始改。这是「原理」与「实战」两个部分之间最明显的一处脱节。
六、实战 77 屏:能跑起来,但跑不出结论
最后说「实战」。第 7 章 16 屏,第 8 章 60 屏,合计 77 屏。
第 7 章很标准:LangChain 的基础模块(7 屏)、用 LangChain 实现 RAG(3 屏)、用 Streamlit 搭一个 ChatPDF(5 屏)。5 屏做一个能上传 PDF、能问答的界面,这个效率是值得肯定的——很多书用 20 屏讲 Streamlit 的布局,那是浪费读者的时间。这本书的选择是:界面能跑就行,把篇幅留给别处。
问题在于「留给别处」的地方,也没留对。
第 8 章 8.1.1「模型选型」,只有一屏(p0266)。内容是一张 C_MTEB 排行榜截图,加一段话:「每个类别下排行榜的差异较为明显。根据经验,排行榜上得分高的模型并不一定可靠。如果你能拥有一个私有的测试集,那将有助于更客观地找到一个最适合自己场景的模型。如果没有,那么在 RAG 场景下,笔者较推荐 bge 系列和 bce-embedding-large 模型。」
我得说,这段话里的判断是对的——「排行榜上得分高的模型并不一定可靠」这句话,是这本书里我最认同的判断之一,因为榜单和你的场景之间隔着一整个数据分布。他后面还补了一句:现有的 RAG 业务用的向量模型也是基于 bce 得到的。这是把自己公司的实践拿出来了,有分量。
但是。把一个 RAG 系统里最关键、最容易被搞错的选择,压缩成一屏「榜单 + 我的推荐」,等于把方法换成了结论。读者真正需要的是:我手上 3000 份合同、200 个真实问句,怎么在五个候选模型里选一个?答案是建一个 200 条的私有测试集,算 Recall@10,看哪个模型在你的领域词上不掉链子。这套流程,写出来最多两屏。他没写。他给了一个可以用、但你不知道为什么能用的答案。
相比之下,8.3.1「微调数据构造」给了 21 屏,是全书最大的单节,方法也讲得具体:
先用提示词调文心一言的 API 做实体扩展。给「休假」这个类别,让模型生成子类别列表,得到「年假、病假、事假、探亲假、婚假、产假、丧假、调休假、工伤假、带薪休假」;给「报纸」,得到「国际报、政治报、经济报、体育报、娱乐报、科技报、教育报、社会报、文化报、艺术报、青少年报、老年报、女性报」。作者的解释是:经过 API 扩展后,实体会被扩展成更小粒度的实体,这有利于提升构造数据的多样性。
然后数据构造分三步:多实体单属性(比如「年假比病假时间长几天」)、单实体多属性(比如「病假有多少天,工资怎么算」)、否定样本生成(构造知识片段不包含问题答案的情况)。
这三步是整本书里最像「一线经验」的一段。尤其是第三步——否定样本。绝大多数教程教你怎么让模型答对,很少有人教你怎么造「库里没有答案」的样本。而这恰恰是 RAG 上线后最难处理的场景:用户问的东西你的知识库里根本没有,模型不该编,但模型天生会编。作者知道要专门造这批数据,说明他真的被这个问题坑过。
所以第 8 章给我的印象是:它是一部「问题清单」,而不是一本「实施手册」。每一节都在告诉你「这里有个坑」,但很少告诉你「坑有多深、怎么填」。21 屏讲造数据,1 屏讲选模型,这个比例本身就是一种判断——他认为数据比选型重要。这个判断我同意一半:数据决定上限,选型决定下限,而 RAG 项目死在规模上的,往往是下限。
七、它的短板
现在把批评集中说一下,四条,都对着具体页码。
第一,全书 110 节没有一节讲权限。我把八章 110 个章块从头到尾看了一遍,涉及安全只有 1.2.3「大模型的数据泄露问题」——讲的是大模型本身泄露训练数据,不是 RAG 系统的权限隔离。而作者自己在前言里说,他在金山办公做的是基于金山知识库的 RAG。任何一个企业知识库,第一道坎都是「这份文档该不该让这个人检索到」。向量检索天生不区分租户:你把全公司的文档塞进一个索引,任何人问一句都能召回别人的薪酬表。这个问题在 324 屏里是零。不是讲得浅,是没提。
第二,评估只给两个指标,且都是召回侧的。见第五节。MRR 和命中率能告诉你「找得准不准」,不能告诉你「答得对不对」。RAG 上线后最要命的失败是「检索到了正确文档,但生成时引用错了段落」,这个失败模式在书里没有对应的指标。12 屏评估,撑不起一个要上线的系统。
第三,摆证据不给判据,这是全书最稳定的一个习惯。表 1-2 摆五个模型的参数量与知识库配比,跨四个数量级,结论只有「有两个极端」;向量数据库 10 屏摆五个产品,没有统一比较维度;模型选型一屏摆一张榜单,结论是「推荐 bge 和 bce」。三次都是同一个动作:把数据放在你面前,然后替你把判断做掉,但不告诉你判断的依据。读起来很顺,用起来很虚——因为换个场景,你还是不知道该怎么选。
第四,前言自己下的定义,全书没兑现。p0006 有一句话我划了重点:「RAG 可以拆解成多个模块,如果每个模块理解成一个小工具,那么 RAG 实际上是一个特定任务的 Agent。」这个定义很准,而且是 2023 年就写下的,眼光是有的。但翻遍 110 节,没有一节讲「Agent 化的 RAG」——没有工具调用、没有多轮规划、没有「检索失败后换个查询重试」的循环。第 5 章 5.3「大模型主导的 RAG 系统」只有 6 屏,是离这个定义最近的地方,但也没接上前言那句话。
这四条里,前三条是「写少了」,第四条是「说到了没做到」。第四条其实最可惜——因为 2023 年就意识到「RAG 本质是个 Agent」的人不多,如果顺着这个定义写一章「检索失败时系统该怎么办」,这本书的分量会完全不同。它现在停在「RAG 是一堆模块」,而不是「RAG 是一个会做决定的东西」。
最后补一句公道话:这本书的短板,大部分不是作者能力的问题,是「应用类技术书」这个体裁的通病。写深了读者跟不上,写浅了对不起书名;写具体了第二年就过时,写抽象了当年就没用。作者选了「宽而浅」这一侧,代价是每一节都只到你刚想追问就翻页的地方。这个选择可以理解,但不能不算账。
八、谁该读它,怎么读
如果非要给个结论:这本书适合已经做过一个 RAG demo、正卡在「召回不准、答非所问」的人,不适合零基础想照着做一个系统的人。
前者能从里面拿到三样东西:第 3 章那 26 屏召回模型的横向对比(尤其 CoSENT 那一页的公式和「训练推理同度量」的解释)、4.4 节那七种召回优化手法(短文本全局信息增强、上下文扩充、多向量表示、查询优化、重排序、多检索器融合、结合元数据)、以及第 6 章的训练思路。这三样,别处不容易一次凑齐。
后者会被它的节奏带偏——110 个零件,每个 2.9 屏,读完的感觉是「我知道了很多名词」,而不是「我会做一件事」。这不是读者的错,是书的结构决定的。
至于读法,我的建议是倒着读:先看 4.5 评估那 12 屏,搞清楚「怎么算做好了」;再看 3.4 重排序和 4.4 召回优化,那是性价比最高的两个改动点;最后回头补第 1 章和第 2 章。评估优先于方法,方法优先于原理——这个顺序,恰好和这本书的编排相反。
一本书真正的价值,不在它讲了多少,而在它敢在哪儿停下来承认「这个我也说不准」。这本书最像人话的三处,全都在这类地方:p0036 承认推理仍是难题,p0183 连说三次「不太适用」,p0266 承认榜单不可靠。这三处加起来不到三屏,却比前面 61 屏语言模型史更能建立信任。
324 屏读下来,我的判断是:它把 RAG 拆成了 110 个干净的零件,每个零件都擦得挺亮,唯独没给你一张装配图。而 RAG 这门手艺,恰恰全在装配上——先装哪个、后装哪个、哪个零件其实可以不装,这些决定成败的东西,它留给你自己了。
阅读记录
书名:大模型RAG实战:RAG原理、应用与系统构建 | 平台:微信读书 | 翻阅:324 屏(全书完,reached_end=true,end_reason=last_page)
抓取耗时 839.2 秒 | 章块 110 个(三部分八章) | 屏数分布:基础 118(36.4%)· 原理 121(37.3%)· 实战 77(23.8%)· 前言版权等 8(2.5%)
抽读核对页:p0006 前言 / p0029 RAG 的缺点 / p0033 表1-2 / p0036 图1-9 / p0050 CBOW / p0113 CoSENT / p0146 深度学习切块 / p0157 向量数据库 / p0180 MRR / p0183 四种评估法 / p0243 TRIME / p0266 模型选型 / p0290 数据构造 / p0318 推理代码
说明:章标签存在滞后(约 ±2 屏),正文 4.3.3 节 Weaviate 未被标签捕获,统计时按实际页面位置校正;本篇不引用书外材料,所有页码均可在原书中直接核对。
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: