
AI万金油:一本敢承认「我们不讨论AI好处」的书,反而更可信
微信读书《AI万金油:商业幻想与科技狂潮》· 逐页翻阅 353 屏 · 抓取标记 reached_end=True(end_reason=last_page,书尾落在 p0353 致谢)· 阅读器共记录 79 个章块,正文八章,前有四段序言,后有致谢
抽样说明:这本是论说型著作,重心在论证结构,所以我按「论点—证据—立场」三条线抽读:联合前言(p0006)、普利策中心与社交哨兵(p0040)、作者自陈取舍(p0045)、哮喘悖论(p0060)、自动化偏见(p0070)、不可消除误差(p0100)、80 亿问题(p0125)、Clearview 与 200 亿张脸(p0160)、专家与末日论(p0190)、通用性阶梯(p0200)、反末日论立场(p0216)、内容审核的滑坡(p0240)、400 篇论文的可复制性(p0295)、50 篇新闻的实测(p0300)、监管主张(p0330)、凯与玛雅(p0340)。
章屏数按阅读器顶部章标签切分,标签存在滞后(约 ±2 屏),统计时按实际页位校正。有一点必须提前说明:这是一本译作,案例几乎全部取自美国,我在下面会把这一点单独算作它的短板,而不是轻描淡写带过。本篇所有判断只依据上述页面与 353 屏的章块统计,不引书外材料。
这本书最让我意外的一页,是 p0045。
那一段先承认了一件事:生成式 AI 确实能对某些编程环节做自动化,提高开发效率。紧接着,作者写下了这么一句——「鉴于本书的重点,我们不会花太多篇幅讨论这些有益的应用。但我们必须要强调,我们对这些应用以及生成式 AI 的整体潜力感到兴奋。」
我把这句读了两遍。一本以「扒掉 AI 炒作皮」为卖点的书,在最该堆案例的地方,主动承认自己不打算讲好处。它没有假装中立,也没有假装全面,它直接告诉你它的镜头对准哪一侧。
在 AI 书这个品类里,这个动作稀缺得有点奇怪。你翻开十本讲 AI 的书,九本半会先给你三十个「效率提升 10 倍」的案例,然后在最后加一章「我们也要注意风险」。这本书反着来:它先把风险摆满一桌,然后在角落放一张纸条,说「好处我也认,但今天不聊」。
这么做当然有代价——后面我会把代价算清楚。但正因为这句坦白,我对它后面所有严厉的话,都多信了一分。一个愿意承认自己有取舍的作者,比一个宣称自己全面客观的作者,更像在说人话。
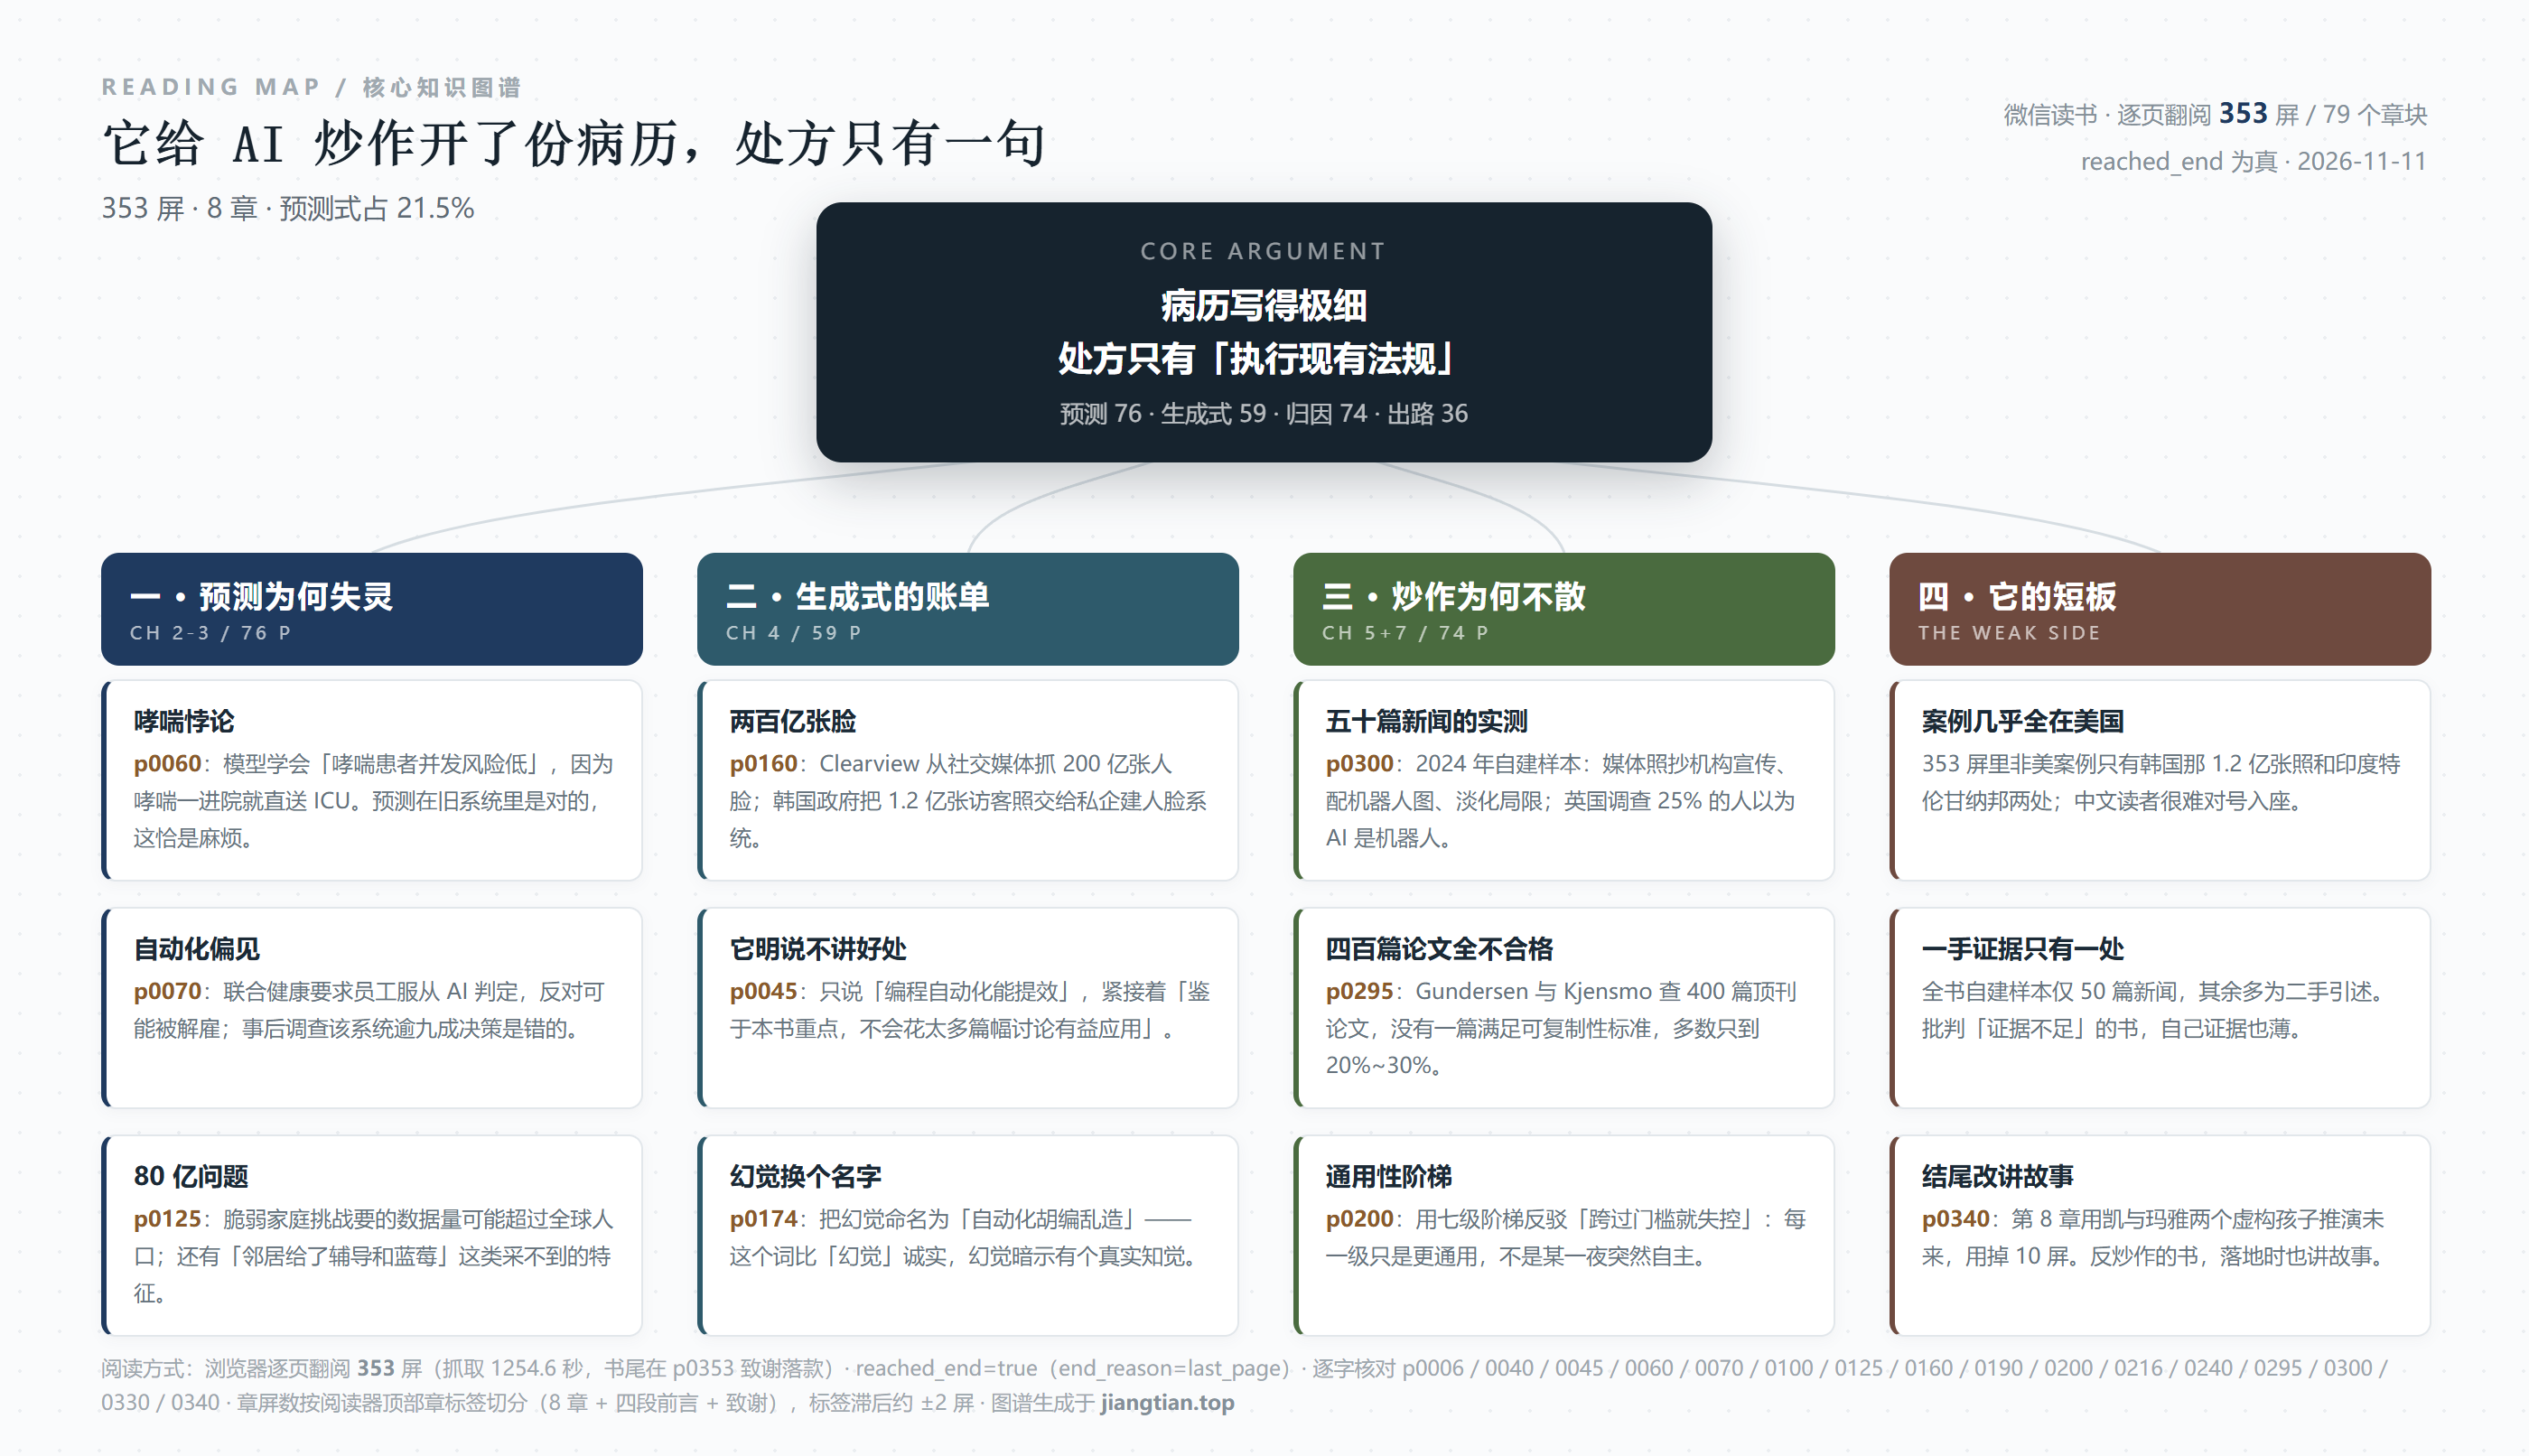
一、先把账摊开:353 屏里,预测式 AI 占 21.5%
我按阅读器顶部的章标签把 353 屏完整切了一遍。这本书的结构比多数技术书更值得算,因为它的篇幅分配本身就是一份立场声明:
第 1 章「引言」40 屏,11.3%。第 2 章「预测式 AI 何以误入歧途」31 屏,8.8%。第 3 章「何以 AI 难测未来苍穹」45 屏,12.7%。第 4 章「通往生成式 AI 的漫漫长途」59 屏,16.7%,是全书最厚的一章。第 5 章「高级 AI 是否关乎存亡之险」36 屏,10.2%。第 6 章「为什么 AI 无法修复社交媒体」54 屏,15.3%,第二厚。第 7 章「为何关于 AI 的迷思经久不衰」38 屏,10.8%。第 8 章「接下来我们该何去何从」36 屏,10.2%。前面四段序言共 10 屏,2.8%;致谢 4 屏,1.1%。
把第 2、3 章合起来,就是这本书真正的主题:预测式 AI,76 屏,21.5%。它讲的是用 AI 预测「谁会犯罪、哪个孩子会被虐待、哪个病人会死、哪部电影会火」这一整类应用——信用评分、再犯风险评估、儿童福利筛查、招聘筛选,都算在里面。
生成式 AI 那一章 59 屏,16.7%。这两块加起来 135 屏,38.2%,构成全书的技术底盘。
剩下的是「为什么这事停不下来」(第 7 章 38 屏 + 第 6 章 54 屏)和「那该怎么办」(第 8 章 36 屏)。
这个配比说明了一件挺重要的事:这本书不是「AI 科普 + 风险提示」,它是一本分类学著作。它花了五分之一的篇幅去讲一个几乎没人愿意细看的东西——预测式 AI 为什么从原理上就不可能成功。而这块恰恰是最容易被「AI 赋能千行百业」这类叙事糊过去的地方。
我认为这个重心选对了。生成式 AI 的问题,大家吵了两年,多少知道些;预测式 AI 的问题,藏在政务系统、保险定价、招聘筛简历的后台里,没人吵,因为看不见。一本愿意把 76 屏给「看不见的那部分」的书,起码不追热点。
二、哮喘悖论:预测在旧系统里是对的,这才是麻烦
如果要我挑一页让人瞬间理解「为什么 AI 预测会害人」,我会挑 p0060。
场景很日常:患者因为肺炎症状到医院,医护要决定是治疗后回家,还是留院观察。高风险患者直接进 ICU,以最大限度降低并发症。1997 年有研究团队想看看,AI 能不能在这件事上比医护做得更好。
他们训了一个模型,结果在预测「哪些肺炎患者可能出现并发症或死亡」上表现不错。然后出现了一个让研究人员意外的结论:模型认为,患有哮喘的肺炎患者,出现并发症的风险更低。
如果这模型进了医院,哮喘患者反而更可能被要求回家观察,而不是进 ICU。「这简直荒唐!」书里就是这么写的。
但接下来这半页,是全书最精彩的一段推理。研究人员回去查数据,发现哮喘患者在数据上确实显示出更低的严重肺炎或死亡风险。原因不是他们真的更安全,而是——哮喘患者一到医院就会被直接送往 ICU,接受比非哮喘患者更集中的治疗,所以并发症发生率更低。
书里给了一个我认为全书最锋利的句子:「模型的预测在现有系统下是『正确的』,但这正是它的问题所在。」更讽刺的是,这个模型的目的是要替代这个系统。
这个案例为什么值得单独讲?因为它一次性说清了三件事。
第一,机器学习学的是「现状」,不是「因果」。它看见「哮喘 = 并发症少」,就当成规律学了。它不知道中间隔着一个 ICU。
第二,越是「预测准确」的模型,越容易把系统的偏见固化下来。你的准确率是靠拟合现状得到的,而现状里已经包含了「谁被优先救治」这个不平等。模型把这个不平等学进去,然后你用它来分配救治资源——这叫自动化,也叫自我实现。
第三,这类错误在现场几乎无法被发现。模型跑出来的数字是漂亮的(AUC 很高),业务方看到指标满意,医生看到建议合理,没人会去问「为什么哮喘反而安全」。要不是那批研究者多问了一句,这个模型可能已经在某家医院跑了十年。
顺带说,这一页还解释了为什么「AI 医疗」的新闻总是好得不像真的。因为评估指标是在旧系统里算的,而模型上线后会改变那个系统。你测的不是它的效果,你测的是它和旧世界的契合度。
三、自动化偏见:当人被要求服从一个错的系统
如果 p0060 讲的是「模型错在哪」,p0070 讲的是「错了之后会发生什么」——答案是:什么都不会发生,而且会更糟。
书里给了一个极端案例:美国健康保险公司联合健康(United Health)集团要求员工即使面对 AI 决策的错误,也必须服从这些决定。如果多次反对 AI 的判断,员工甚至可能面临被解雇的风险。事后调查发现,该系统做出的 AI 决策中超过 90% 都是错误的。
「超过九成是错的」这个数字,我读到时是停了一下。它不只说明模型烂,更说明一个不允许被质疑的系统,能把错误率推到什么程度:没有人反馈,模型就没有修正信号,错误会一直累积,直到有人从外面踹门进来。
更能说明问题的是紧跟着的那个实验。飞行员从自动化系统收到一条错误的引擎故障警报时,75% 的飞行员遵循系统建议,错误地关闭了正常工作的引擎;相比之下,使用纸质检查单的飞行员只有 25% 犯类似错误。
75% 对 25%,三倍。而且受试者是飞行员——一群受过严格训练、以「不相信仪表」为职业素养的人。书里那句话我原样抄下来:「如果连飞行员在自己生命受到威胁时都可能因自动化偏见而犯错,那么其他官员也很难避免类似的情况。」
这一段的厉害之处在于,它把「AI 害人」从科幻拉到了组织行为学。问题不在于 AI 有多强,而在于人有多容易放弃判断。你给一个人一个「看起来很专业」的建议,再给他一个「反对要担责」的环境,他就一定会照做——这跟模型的准确率是 95% 还是 60% 关系不大,跟组织怎么奖惩关系很大。
而这一页的结尾,是全书语气最冷的一句:「无论原因如何,结果都一样,AI 负责决定与人们生活息息相关的重大事项,但针对错误决策,人们几乎没有申诉途径,甚至完全无法申诉。」
这句话之所以站得住,是因为前面 76 屏都在给证据。先证明模型会错,再证明人不敢反驳,最后才说「没有申诉途径」——三步走完,「AI 治理」这个抽象词才变成一个具体的人站在柜台前无处说理的画面。这是这本书在写法上最值得学的地方:它不喊口号,它铺垫。
四、它敢跟「AI 末日论」正面掰手腕
第 5 章 36 屏,是我认为这本书最有胆量的部分。因为它选的对手,是「AI 可能灭绝人类」这个当下最有道德光环的议题。
p0190 先拆了对手的动机,而且拆得很不客气。作者提出两个概念:选择性偏差——很多人之所以投身 AI 研究,是因为对「构建改变人类历史的强大技术」充满向往,所以他们的观点和最初入行时的兴奋是一致的,「这并不令人惊讶」;认知偏差——如果 AGI 即将实现并拥有巨大潜力,它会赋予个人工作一种特殊的崇高感,「试想,如果身处那样的情境,谁能不相信自己的工作至关重要呢?」
这话有点刻薄,但他紧接着做了两件让批评站得住的事。一是点名:图灵奖得主杨立昆(Yann LeCun)以及大部分 AI 伦理研究社区,都对 AGI 末日论持强烈反对态度——他不是在跟空气辩论。二是翻旧账:1958 年罗森布拉特团队做出感知机时,《纽约时报》报道称「美国海军今天展示了一台电子计算机的雏形,预计它将能够行走、谈话、观察、写作、自我复制并意识到自己的存在」;60 年代明斯基也有类似的乐观估计。
「预计它将能够……意识到自己的存在」——1958 年的报纸,和 2026 年的推特,用的是同一种句式。这个对照比任何论证都有效,因为它证明的不是「这次也一样」,而是「这类预言的语法七十年来没变过」。
然后是 p0200 的「通用性阶梯」。作者把计算技术的发展排成七级台阶:从「为每个任务构建硬件」,到「为每个任务编写程序」,到深度学习「用同一套学习算法加大量数据」,再到预训练模型、指令调优模型——当前技术大约在第七级。核心论点是:每一级只是比前一级更通用一点,没有哪一级是「突然获得自主性」的门槛。
这个论证我很喜欢,因为它把「AGI 会不会突然觉醒」这个玄学问题,换成了一个工程问题:通用性是连续变量,不是开关。如果是连续的,那就没有「奇点」这个断点,只有一段又一段更难的路。
但我也得说,这个阶梯有一个它自己没处理好的地方。阶梯描述的是「通用性」,而末日论担心的主要是「能力」和「速度」。一个系统可以在通用性上只爬了一级,但在某一项具体能力上远超人类——围棋、蛋白质折叠、网络攻击都是例子。用「通用性是渐进的」来回应「能力可能跃升」,其实绕开了对方的要害。书里 p0205 有一节「加速进步了吗」试图处理,但只有 4 屏,分量不够。
不过它的结论我认为是对的,而且说得很干脆(p0216):「对人类的最大威胁来自人类对 AI 的滥用,而非 AI 自主背叛。」理由也具体——聊天机器人的对齐方式「极其脆弱」,不良分子可以用类似 GPT-3.5 的模型绕过对齐限制;一国政府要搞网络战,完全有能力自己训模型,不必依赖商业系统;AI 可能找到「零日漏洞」,而这些漏洞若存在于关键基础设施的软件里,AI 可能借它控制电网或核电站。
把威胁从「AI 想不想害人」换成「人会不会拿它害人」,整个治理思路就变了:你不需要给模型装道德,你需要管住漏洞、管住出口、管住谁在用。这个转向务实,也是这本书全书立论的底座。
五、它自己做了一次小样本实测:50 篇新闻
批评「媒体在炒作 AI」很容易,说一句「标题党」就完了。这本书多做了一步:它自己去数了。
p0300 写得清楚:为了理解新闻中的 AI 炒作,作者在 2024 年分析了 50 篇新闻文章,研究媒体如何助推炒作。结果是三条,一条比一条具体:新闻报道往往未经批判地重复研究机构的宣传;频繁使用机器人的图片;对 AI 进行拟人化描述,并淡化其局限性。而且「这种现象在主流媒体(如《纽约时报》和 CNN)和小众出版物中都很普遍」。
第二条最容易被忽略,但我觉得最有用:新闻配图会改变公众对原理的理解。一篇讨论推荐算法的文章配一张机器人照片,读者就会以为 AI 是个机器人。书里引了英国一项研究:25% 的受访者将 AI 视为「可怕的机器人」。然后它给了一句我非常喜欢的比喻——「大多数 AI 被用于从数据中检测模式,实际功能更像微软的 Excel 软件,而不是像电影《终结者》里演的那样。」
「更像 Excel」这个说法,粗糙但准确。它一把抓住了普通人误解 AI 的根源:大家怕的是一个有意志的东西,而真实存在的是一个统计工具。你怕错对象,就会防错地方——你担心机器人造反,却不担心招聘系统把某一类人默默筛掉。
顺便说,p0040 那段材料也很扎实。普利策中心资助了一个记者群体,专注「深入的 AI 问责报道」,成果之一是阿里·森与德雷卡·K·本内特为《达拉斯晨报》写的调查:一款叫「社交哨兵」(Social Sentinel)的 AI 产品,被全美多所学校用于监测学生的社交媒体帖子,表面上是识别潜在的安全威胁,实际上常被滥用于监控学生的抗议活动。书里还补了一个冷静的数字:普利策中心的资金每年仅能支持 10 名记者。
10 名记者,对上整个行业的公关预算。这个对比不需要任何形容词,它自己会说话。这也是全书少见的、把「谁在监督」这件事摆上台面的地方。
六、可复制性危机:400 篇顶刊论文,一篇都不合格
如果说有一页能解释「为什么 AI 领域的很多结论不能信」,那就是 p0295。
书里先给了心理学的例子作为参照:2015 年,一大批研究者试图重复社会心理学领域的已发表研究,结果发现只有 36% 的结果可以成功重现——尽管这些研究都通过了同行评审,发表在顶级期刊上。
然后轮到 AI。2018 年,挪威科技大学计算机科学家奥德·埃里克·冈德森(Odd Erik Gundersen)和西格比约恩·肯斯莫(Sigbjørn Kjensmo)做了一项调查,审查来自顶级 AI 期刊的 400 篇论文,评估它们是否提供了足够细节,让独立研究人员能够重现结果。结论是:这 400 篇论文中,没有一篇完全满足可复制性的所有标准(比如代码和数据的共享),大多数论文只满足他们定义的要求的 20% 到 30%。
「没有一篇」。不是「大部分不合格」,是「一篇都没有」。
这个数字的分量在于,它把「AI 效果不可信」从一个抱怨,变成了一个可验证的行业事实。你没法复现,就没法验证;没法验证,那些「提升 30%」的宣称就只是宣称。而这本书后面所有的批评——媒体的、公司的、公众人物的——都建立在这个地基上:当证据本身不成立时,围绕证据展开的一切讨论都是空的。
紧接着还有一段我很欣赏的自我修正。作者说,2020 年在一场关于预测能力的研讨会上,他们探讨了哪些结果可预测、哪些不能。研究表明,大多数涉及人类行为的社会结果难以预测——「这与我们在第 3 章的发现一致」。唯一的例外是内战预测,一个政治学的分支领域,致力于预测哪些国家和地区会在特定时间内爆发内战。2016 年有论文声称,利用 AI 能以惊人的准确度预测内战。
书里没有把这条当反例藏起来,而是把它摆出来,并说「这一现象引起了我们的兴趣」,然后追问:为什么 AI 在预测内战上表现出色,而在其他社会结果预测中却表现糟糕?
这个动作叫「主动给自己的理论找麻烦」。一本论战性质的书愿意这么干,说明作者要的是对,不是赢。我读到这里,对前面那些强硬论断的接受度明显提高了。
七、它的短板
现在说代价。四条,都对着页码。
第一,案例地理极度单一,中文读者很难对号入座。353 屏翻完,非美国的案例我只数出两处:韩国政府把 1.2 亿张外国访客照片交给私企开发人脸识别系统(p0160),以及 2021 年印度特伦甘纳邦警察因未加解释、未经同意拍摄路人面临诉讼(p0160)。中国在全书里出现的次数,一只手数得过来——联合前言里有一句「无论是在硅谷的董事会议室,还是在北京的科技园区」,然后就没有然后了。
这不只是「水土」问题。它意味着这本书的核心案例——脆弱家庭挑战、再犯风险评估、Social Sentinel 监控学生——在中国没有对应的公共讨论场景。而中国 AI 落地的形态差异很大:政务热线、教育信息化、短视频推荐、社区治理。书里的框架(预测式 vs 生成式、滥用而非背叛)能套过去,案例套不过去。你得自己做那层翻译工作,而书没帮你做。
第二,一手证据只集中在两处。全书自建样本,我能确认的只有 50 篇新闻(p0300)和那次 2020 年的研讨会。其余论证大量依赖二手引述——别人的研究、别人的调查、别人的报道。这不是硬伤,但有点尴尬:一本用「证据不足」当主要武器的书,自己的武器库偏薄。尤其第 2 章那些预测式 AI 的案例,多数是转述,读者无法判断原始研究的质量。
第三,最该落地的两件事,篇幅最少。第 8 章「接下来我们该何去何从」只有 36 屏,其中「AI 与未来职场」6 屏、「监管的局限性」2 屏。而「凯的世界」4 屏加「玛雅的世界」6 屏,一共 10 屏,讲的是两个虚构孩子——假设 2022 年 11 月 ChatGPT 发布时出生,在两种截然不同的社会里长大。
我得承认,这两个虚构人物写得不错,也点出了要害:「两种未来的差异,根本不在技术的进步,而在于社会如何应对和利用这些技术。」但问题是——一本反炒作、反空谈的书,写到「怎么办」的时候改用故事了。读者跟着走了 340 屏的实证与数据,最后一章给他两个虚构小孩。这个转身,多少有点泄气。
第四,它明确放弃了「生产力」这一维。这是 p0045 那句坦白带来的代价。第 4 章 59 屏,讲版权、监控、深伪、幻觉,讲得都好,但没有一屏回答「用了它之后,人的产出到底变多还是变好」。于是这本书给人的整体印象是:AI 大部分是骗局,剩下的小部分是威胁。
这个印象对它自己的立论是不利的。因为「AI 万金油」这个批评最有力的时候,不是「AI 没用」,而是「AI 被用错了地方」。要论证「用错地方」,你得同时拿出「用对地方」的样子来对照,否则读者没法分辨边界在哪。作者选择了不画这条线,代价是全书读完,你知道该怕什么,不知道该期待什么。
最后补一条我自己觉得别扭的:第 6 章「为什么 AI 无法修复社交媒体」54 屏,是全书第二厚的一章,比「AI 与未来职场」多九倍。这一章写得好,但它更像是另一本书的一章——平台治理、推荐算法、内容审核的价值观风险,跟「AI 万金油」的主线只是勉强相关。一本 353 屏的书,用 15.3% 讲社交媒体,用 1.7% 讲职场,这个配比我不太服气。
八、它给出的那六个字,值不值
说回标题里那句「处方」。这本书对「怎么办」的回答,集中在 p0330,核心是破除三个误解。
误解一:法律管不了新技术。作者反驳说,法律不只是技术细节,还涉及原则;美国宪法第一修正案在互联网发明前几个世纪就已制定,但在处理网络审查和仇恨言论时,它依然作为指导原则发挥作用——「这些原则如何应用于新技术的具体细节可能会有所不同,但其核心原则却保持相对稳定。」
误解二:自我监管是唯一现实的选择。他说这个观点建立在一个错误前提上,即只有科技企业才能理解和管理其技术;而「当前 AI 系统的原理其实足够简单,能够被广泛理解」。
误解三:监管毫无希望,因为政策制定者不懂技术。他的类比很硬:政策制定者在其立法的任何领域都不是专家,「虽然他们没有土木工程学位,但我们依然有建筑法规来确保建筑物的安全」;而且「在像 AI 这样的快速发展领域,大多数情况下所需要的并不是创建新法规,而是执行现有的法规」。
然后他给了两个已发生的例子:美国联邦贸易委员会已经利用现有的针对虚假商业行为的规则,对 AI 企业发布的虚假声明采取行动;当企业以欺骗性手段收集数据时,该机构要求它们删除数据并撤回利用该数据创建的模型。
「撤回模型」这四个字,是全书对监管最具体的一个主张,也是我认为最值得记住的一句。罚钱不管用,删数据不够,得让那个用脏数据训出来的东西下线。这才叫有牙齿。
所以那六个字——「执行现有的法规」——不是敷衍,它有具体抓手。但它的确回避了最难的部分:谁来执行、执行到什么程度、跨境怎么办。这些在「监管的局限性」那一节里,只有 2 屏。
这本书的方法论其实只有一条,但它贯彻得很好:把「AI 会不会」这类关于未来的问题,换成「这个系统在哪个旧系统里跑、谁为它的错误负责、错了能不能申诉」这类关于现在的问题。前者永远吵不完,后者一查就有答案。
——这条方法论,比书里任何一个具体结论都更耐用。因为结论会随技术过期,提问方式不会。
至于这本书该不该读,我的判断分两种人。
如果你正在做 AI 产品,尤其是往政务、医疗、金融、招聘这些「决策会影响具体的人」的场景里做,这本书该读,而且要读第 2、3 章。那 76 屏会让你在写需求文档的时候多问一句「这个标签是怎么来的、旧系统在这里做了什么」——这一句能救掉很多麻烦。
如果你想知道「AI 到底能帮我干什么」,这本书帮不上忙,作者自己也说了不聊这个。它不是一本工具书,是一本免疫书:教你识别哪些宣称是空的。免疫不等于营养。
至于读法,我建议从第 4 章倒着读回第 2 章:先看生成式 AI 那 59 屏(离你最近,体感最强),再看第 3 章「何以 AI 难测未来苍穹」(45 屏,讲清楚为什么社会预测本质上做不到),最后回头看第 2 章的案例。先建立「为什么不可能」,再看「它是怎么被卖出去的」,顺序反过来读会顺得多。
353 屏读完,我的总结是:它给 AI 炒作开了一份非常认真的病历——症状、机理、并发症、既往史,全有;但处方那一栏,只写了「按现有规章办」,然后留白。这份病历值得每个要用 AI 做决定的人存档;至于处方,还得自己开。
阅读记录
书名:AI万金油:商业幻想与科技狂潮 | 平台:微信读书 | 翻阅:353 屏(全书完,reached_end=true,end_reason=last_page)
抓取耗时 1254.6 秒 | 章块 79 个(正文八章 + 四段序言 + 致谢) | 章屏数:引言 40(11.3%)· 预测式误入歧途 31(8.8%)· 难测未来 45(12.7%)· 生成式长途 59(16.7%)· 存亡之险 36(10.2%)· 社交媒体 54(15.3%)· 迷思不散 38(10.8%)· 何去何从 36(10.2%)· 序言 10(2.8%)· 致谢 4(1.1%)
抽读核对页:p0006 联合前言 / p0040 社交哨兵 / p0045 作者自陈取舍 / p0060 哮喘悖论 / p0070 自动化偏见 / p0100 不可消除误差 / p0125 80 亿问题 / p0160 Clearview / p0190 专家与末日论 / p0200 通用性阶梯 / p0216 反末日论 / p0240 内容审核的滑坡 / p0295 可复制性危机 / p0300 五十篇新闻 / p0330 监管主张 / p0340 凯与玛雅
说明:章标签存在滞后(约 ±2 屏),统计按实际页位校正;书中译名与人名按原书译法(联合健康、冈德森、肯斯莫、杨立昆)。本篇不引用书外材料,所有页码均可在原书中直接核对。
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: