
AI工程:它把评估排在提示工程前面,这个章序比任何技巧值钱
微信读书《AI工程:大模型应用开发实战》(Chip Huyen 著)· 逐页翻阅 823 屏 · 抓取标记 reached_end=True(end_reason=last_page,书尾落在 p0823 封面简介)· 阅读器共记录 63 个章块,正文十章,前有版权、两段赞誉、译者序、中文版序与前言
抽样说明:这本是工程方法论,重心在"顺序"和"判断",所以我按"结构—评估—手艺—短板"四条线抽读:p0020 如何阅读本书、p0080 业务指标与实用性门槛、p0095 技术栈与延迟、p0150 训练数据存量的预测、p0200 幻觉的两个假设、p0225 困惑度与保密、p0260 AI 当裁判、p0330 公开基准与饱和、p0420 防御性提示工程、p0485 智能体与计划生成、p0540 微调前的五连问、p0570 LoRA 与"为什么有效"、p0600 学习率与批次、p0790 用户反馈与偏好数据。
章屏数按阅读器顶部章标签切分,标签存在滞后(约 ±2 屏),统计时按实际页位校正。有一点先说明:这本书的中文名带"实战"二字,我下面会把"实战"到底实到什么程度,单列成短板,不轻描淡写带过。本篇所有判断只依据上述页面与 823 屏的章块统计,不引书外材料。
这本书我翻了 823 屏,最后记住的不是任何一个提示词模板,而是它的目录。
十章是这样排的:第 1 章讲 AI 工程是什么,第 2 章讲基础模型怎么被造出来,第 3 章评估方法论,第 4 章评估 AI 系统,第 5 章才讲提示工程,第 6 章 RAG 与智能体,第 7 章微调,第 8 章数据集工程,第 9 章推理优化,第 10 章架构与用户反馈。
这个顺序在 AI 书这个品类里是反常的。你去翻十本讲大模型应用的书,九本的写法是:先教你写提示词,再教你搭 RAG,再教你做智能体,最后腾出一章客气地说"我们也要注意评估"。评估永远排在倒数第二章,像一条不得不加的免责声明。
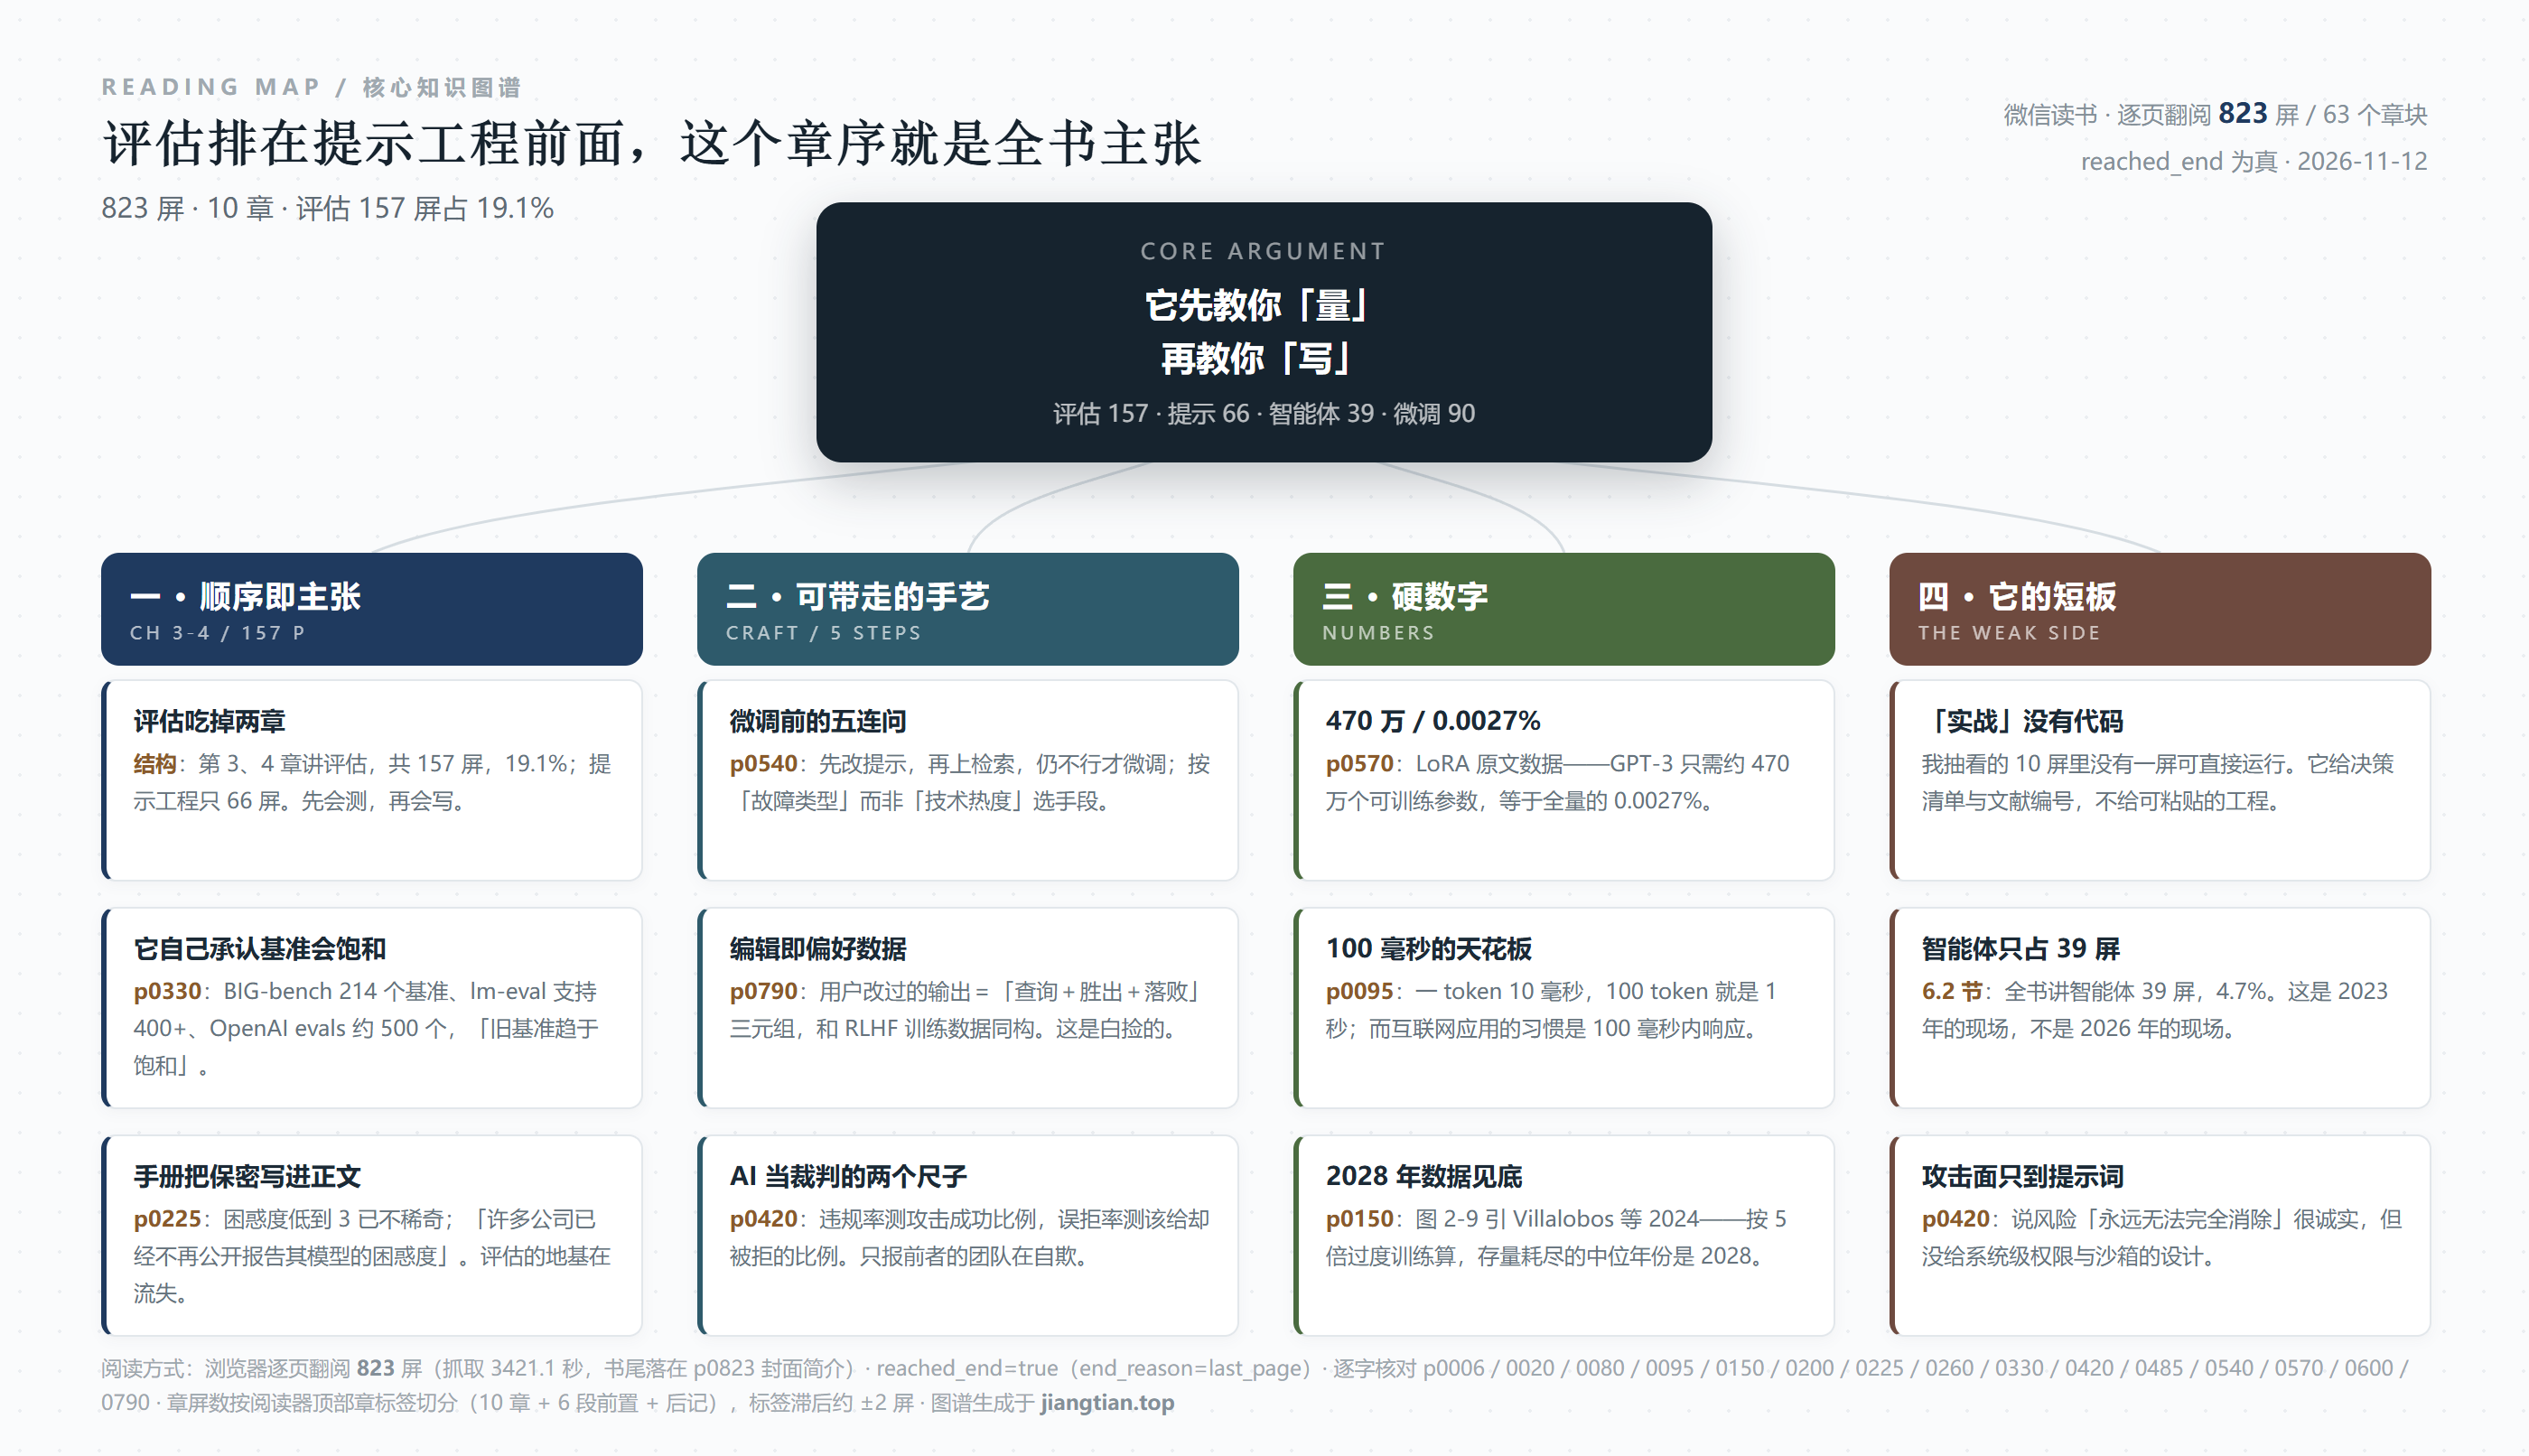
Chip Huyen 把它提到了正中间:第 3、4 两章合计 157 屏,占全书 19.1%;而"提示工程"只有 66 屏,占 8.0%。评估的篇幅是提示工程的两倍还多。
我把这个比例算出来的时候愣了一下。因为这不是排版习惯,这是一个很硬的取舍:作者认为,在你学会"怎么让它说得好"之前,必须先学会"怎么知道自己被骗了"。
说实话,翻开之前我以为这是又一本"教你搭个 RAG 聊天机器人"的教程。前 29 屏(版权、两段赞誉、译者序、中文版序、前言)也确实像:赞誉页上排着四位推荐人的话,讲"实用指南""全面参考""核心指南"。真正让我改主意的是第 3 章开头——它没有讲怎么调用 API,而是先问"你怎么知道它答得对不对"。
一、先把账摊开:823 屏的重心到底在哪
按阅读器顶部的章标签切分,这本书的 823 屏是这样分的(含章首标题页):
前置区(版权、两段赞誉、译者序、中文版序、前言)29 屏,3.5%;第 1 章入门与技术栈 79 屏,9.6%;第 2 章理解基础模型 100 屏,12.2%;第 3 章评估方法论 73 屏;第 4 章评估 AI 系统 84 屏——评估合计 157 屏,19.1%;第 5 章提示工程 66 屏,8.0%;第 6 章RAG 与智能体 88 屏,10.7%;第 7 章微调 90 屏,10.9%;第 8 章数据集工程 67 屏,8.1%;第 9 章推理优化 71 屏,8.6%;第 10 章架构与用户反馈 68 屏,8.3%;后记与作者简介 8 屏,1.0%。
单看这张表,第一个反直觉的地方就出来了:评估(19.1%)> 微调(10.9%)> 基础模型原理(12.2%)> 智能体所在的第 6 章(10.7%)> 提示工程(8.0%)。
很多人的直觉是"讲 AI 应用的书,提示工程和智能体应该占大头"。这本书的答案是:不。它把最厚的篇幅给了"怎么量",第二厚的给了"怎么改模型",最薄的给了"怎么写提示词"。这个配比放到 2026 年看,依然是少数派——现在市面上大部分 AI 应用书,提示词能占三成。
我并不认为篇幅大就一定重要,但篇幅确实暴露了作者认为什么是难的。在他眼里,写提示词是容易的,难的是你知道自己写的那句到底让效果变好了还是变坏了。
二、评估章的两个硬内核:延迟门槛与"实用性"
第 4 章开头那几页(p0080 附近),讲的是怎么给一个 AI 应用定标准。它没有一上来就抛指标,而是先问业务:做客服机器人,你要的是自动处理消息的比例、多处理多少消息、响应速度快多少、省多少人力成本——先把这四个问题回答清楚,再谈技术指标。
然后是这一页真正硬的地方:延迟要拆成三段看。TTFT(time to first token,首个 token 响应时间)、TPOT(time per output token,每个输出 token 的响应时间)、以及总延迟。这三段对应三种完全不同的用户感受——首字慢是"卡",逐字慢是"拖",总时长是"等"。
更值得抄下来的是它给的判断方法:"如果当前所有用户请求都由人工处理,中位响应时间为 1 小时,那么只要 AI 的响应比 1 小时快,可能就算足够好。"
这句话听着像废话,其实是全书最有工程味的一句。延迟不是绝对值,是相对基线。一个内部知识库问答,8 秒出首字没人抱怨;一个输入法补全,800 毫秒就让人烦躁。同一套指标,门槛可以差两个数量级,取决于你替代的是什么。
但紧接着的 p0095 又把这个乐观按住了:模型是自回归的,逐个生成 token,"如果模型生成一个 token 需要 10 毫秒,那么生成 100 个 token 就需要 1 秒",而互联网应用养成的用户习惯是 100 毫秒内响应。这两个数字摆在一起,你就明白为什么推理优化值得单独占一章(71 屏)——它面对的不是"能不能更快",而是"永远追不上 100 毫秒"这个结构性差距。
三、它自己承认了评估的地基正在流失
如果只让我留一页,我留 p0330。
那一页在讲公开基准测试,给了三个数字:谷歌的 BIG-bench(2022)包含 214 个基准测试;EleutherAI 的 lm-evaluation-harness 支持超过 400 个;OpenAI 的 evals 允许跑约 500 个现有基准。三个数字摆完,作者写了这么一句:
"随着AI模型性能的提升,旧的基准测试趋于饱和,因此需要引入新的基准测试。"
这句话很短,但它等于承认了一件事:排行榜是个会自我销毁的装置。基准一旦被刷满,就失去了区分度;于是换一套新的;新的再被刷满;再换。所以你在任何一份模型对比表上看到的分数,本质上都是"这一届考卷的分数",而不是"能力"。
比这更狠的是 p0225。那一页讲困惑度(perplexity),讲到一半,作者写:"遗憾的是,随着对模型信息的保密程度越来越高,许多公司已经不再公开报告其模型的困惑度。"
这是全书最诚实的一句话,也是最让人泄气的一句话。困惑度是少数几个还能横向比较的、口径相对统一的指标——它就是"预测下一个 token 时的不确定性"。当模型厂商连这个都不报的时候,外部人手里的评估工具就只剩下一堆自建基准和人工打分。
顺带说一个这页上的硬知识,我觉得比结论有用:困惑度低到 3 甚至更低并不罕见;困惑度为 3 意味着模型有三分之一的概率准确预测下一个 token;而 1951 年 Claude Shannon 评估他的模型时,只用了最多 10 个前序 token 作条件,现在的模型通常基于 500 到 10,000 个甚至更多。七十四年,从 10 个 token 到 10000 个 token,衡量"语言有多可预测"的尺子没换,量程换了三个数量级。
四、真正能搬走的三条手艺
这本书值不值钱,我认为取决于你能带走几条能用的东西。我数出三条。
第一条,微调前的五连问(p0540)。那一页是一张决策清单,不是代码。逻辑是这样:先按故障类型分诊——如果问题是"模型不知道你的知识",先试最简单的检索,哪怕只是基于词项的检索,加了相关知识就能提升;如果仍然频繁出现信息类问题,再上基于嵌入的检索;如果问题是行为类问题(持续生成无关、不规范、不安全的响应),才考虑微调。并且它明说了两条路的代价:"基于嵌入的检索会在推理过程中引入额外的组件,从而增加推理的复杂性;而微调会增加模型开发的复杂性,但不会改变推理过程。"
这段话之所以值钱,是因为它给的是代价的位置,不是技术的清单。检索把复杂度推到线上,微调把复杂度推到开发期。你在哪个阶段更缺人,答案就不一样。大部分教程告诉你"两种都能做",只有少数告诉你"复杂度会搬到哪里去"。
第二条,用户的编辑就是偏好数据(p0790)。这一页讲用户反馈,讲到"允许用户直接编辑模型响应"时,作者点了一句:用户改了模型生成的代码,这个动作本身是极强的信号;而每一次编辑都构成一个偏好示例——模型原始输出是落败响应,用户改完的是胜出响应,也就是(查询、胜出响应、落败响应)这个三元组。
这个观察的价值在于它把两件事缝上了:产品侧的"编辑按钮"和训练侧的"RLHF 数据"。你不需要另起一个数据标注项目,用户每天在帮你标。而且这种标注是"分布内的"——它标的是你真实流量里的失败,不是标注员想象出来的失败。
这也是我读这本书时唯一产生"我明天就能用"的瞬间。它没有教你做一个反馈系统,它告诉你反馈系统本来就在那儿,你只是没把它的输出接进训练。
第三条,AI 当裁判要用两把尺(p0420)。讲防御性提示工程时,它给了两个指标:违规率(violation rate,攻击成功的比例)和误拒率(false refusal rate,本该正常回答却被拒的比例)。
为什么这条重要?因为所有做安全对齐的团队都爱报第一个数字,很少有人报第二个。"我们把攻击成功率从 12% 降到 3%"是一句漂亮话;但如果同一时间误拒率从 2% 涨到 15%,你其实是把一个可用产品做成了一个会拒绝客户的机器人。只报违规率的团队,本质上是在用一个看不见的成本换一个看得见的指标。
这一页还有一句我认为是全书的底色:"只要系统具备产生有效输出的能力,提示词攻击的风险就永远无法完全消除。"这句话否定了"彻底解决"这个目标,把安全从"消灭漏洞"改成"控制损失"。一个愿意在教科书里写下这句话的作者,比一个承诺"我们的模型绝对安全"的厂商可信得多。
五、"为什么 LoRA 有效":这本书最好的提问方式
第 7 章讲微调,90 屏。我最想指出来的是 p0570。
那一页先给了 LoRA 的硬数据:对于 GPT-3,LoRA 仅使用约 470 万个可训练参数,相当于全量微调参数量的 0.0027%,就能获得与全量微调相当甚至更好的效果。470 万,对着 1750 亿,这个比例小到反直觉。
然后作者做了一个大部分同类书不会做的动作——他没有接着讲"怎么用",而是退一步问:"为什么 LoRA 有效?"
他先把这个疑问说得更难听:像 LoRA 这样的参数高效方法已经非常流行,以至于很多人认为这是理所当然的;但如果一个模型在预训练时需要大量参数才能学习某些行为,那么微调时改变这些行为,难道不也需要大量参数吗?
然后他把同一个问题推到数据上:如果模型需要大量数据才能学会某个行为,那么显著改善这个行为,难道不也需要大量数据吗?为什么预训练需要几百万甚至几十亿个样本,而微调时只需几百或几千个样本,就能有效地改变模型的行为呢?
最后他给的线索是"内在维度"——引了 Li 等 2018 的 "Measuring the Intrinsic Dimension of Objective Landscapes" 和 Aghajanyan 等 2020 的 "Intrinsic Dimensionality Explains the Effectiveness of Language Model Fine-Tuning"。
这一段我读得很慢,因为它示范了一种罕见的写法:先把常识性做法拆成一个尖锐的疑问,再用文献去接。市面上讲 LoRA 的内容,99% 停在"低秩分解、省显存、效果好";它多走了一步,把"为什么能省"变成一个可以继续追的问题。
同一条线上的还有 7.3 节那 18 屏"内存瓶颈"。p0600 讲的是学习率和批次:批次大小决定每一步更新权重时使用的样本量,批次过小(比如小于 8)可能导致训练不稳定;批次越大处理样本越快,但运行所需内存也越多。而"截至本书撰写时,计算资源仍然是微调的瓶颈"——模型规模很大、内存有限,于是只能用较小的批次,代价是权重更新不稳定。解法是梯度累积:跨多个批次累积梯度,攒够了再更新一次权重。
这段内容在 2026 年基本被框架封装掉了,你调一个参数、背后就是它在做梯度累积。但我觉得该读,理由不是"以后要手写",而是知道框架在替你做什么,才知道它什么时候会骗你——比如你以为把 batch 调大就快了,其实是内存先炸;你以为显存不够就不能训,其实还能靠累积换等效批次。
当然它也没有给完整答案——内在维度只是线索,不是定论。但我觉得这恰恰是好的教科书该有的样子:把确定的部分讲清楚,把不确定的部分标出来,让你知道边界在哪。
六、第 9 章那 71 屏:它连芯片的计算原语都讲了
这本书的技术密度最高点不在评估章,在推理优化那 71 屏。
p0700 是一张图,标题叫"图9-6:不同的计算原语(不可拆分的计算单元)",图里画了三块网格,分别标着标量、向量、张量,图片灵感注明来自 Chen 等 2018 的 "TVM: An Automated End-to-End Optimizing Compiler for Deep Learning"。
正文接着解释:一款芯片可能同时拥有多种计算单元,分别针对不同数据类型优化;传统 GPU 支持向量运算,但许多现代 GPU 包含专门为矩阵和张量计算优化的张量核心;而 TPU 把张量运算作为其主要计算原语进行设计。所以要在特定硬件架构上高效运行模型,需要充分考虑架构的内存布局和计算原语。
看到这里我确认了一件事:这本书的目标读者不是"想学会写提示词的产品经理",而是要做系统设计的人。从"为什么推理慢"(自回归、逐 token 生成)、到"内存带宽怎么成为瓶颈"、再到"芯片的计算原语长什么样",它是一路往下钻的。这个深度,在讲 AI 应用的畅销书里很少见——大部分书到"用 batch 提高吞吐"就停了。
但也正因为这一章,我对"应用开发实战"这个中文名的意见更明确了:它讲的是系统的物理约束,不是应用的搭建步骤。知道 TPU 以张量为原语,不会让你的第一个 RAG 跑起来;但它会决定你在选云厂商时问出什么问题。
七、它的短板:三条,都不轻
下面这三条,是我认为必须写清楚的。
第一,"实战"这两个字,名不副实。我抽看的十五页里——p0020、0080、0095、0150、0200、0225、0260、0330、0420、0485、0540、0570、0600、0700、0790——没有一屏是可以直接运行的代码。没有 pip install,没有一段完整的 Python 调用,没有一处配置文件。它给的是决策清单(p0540 的五步)、对比表(p0330 的商业 API 与自托管对比:成本、微调、控制权、边缘场景)、以及成串的文献编号。
这不是骂它。它是一本很好的判断手册,但它不是代码手册。中文书名里的"实战"会让人以为能照着敲,实际你得自己去补实现层。如果你要的是"跟着做一遍",这本书会让你落空;如果你要的是"知道该做什么、不该做什么",它是同类里排前面的。
第二,智能体只占 39 屏,而且被简化成了提示词。第 6 章讲 RAG 与智能体共 88 屏,其中 6.2 节"智能体"39 屏,占全书 4.7%。这 39 屏里,p0485 把智能体拆成"规划器 + 工具 + 计划生成",然后说了一句:"将模型转化为规划器最简单的方法是利用提示工程。"
在 2023 年这是对的。放到 2026 年读,这句话漏掉了三件最难的事:长任务的失败累积(二十步的链条,每步 95% 成功率,整体只剩 36%)、权限边界(智能体能不能删库、能不能转账,靠什么约束)、以及成本结构(一个会自我反思的智能体,token 消耗是普通问答的十倍以上)。全书对这三件几乎没有独立章节。
我不认为这是作者偷懒,这是时代差。他在 p0485 里也留了一个诚实的判断:从长远看,基础模型智能体与强化学习智能体很可能会逐渐融合。这句话现在正在被验证,但书里没有展开——因为写书的时候还没得展开。
第三,全书的现场是 2023 年的美国。Villalobos 等 2024 的数据存量预测、BIG-bench 2022 的 214 个基准、GPT-3 上的 LoRA 实验——这些证据都很扎实,但它们的年份集中在一个窗口里。中文版读者拿到的是一张两年前的工地快照:评估方法论那 157 屏不会过期(怎么定门槛、怎么拆延迟、怎么设两把尺,这些是原理),但"用什么模型、跑什么价格、拿哪个 harness"这一整层,两年就换了一遍。
还有一处我想单独挑出来。p0200 讲幻觉,说"要求模型给出简洁的回答似乎也有助于抑制幻觉——模型生成的 token 越少,编造内容的机会就越少"。这句话我认为不严谨:它把"编造的概率"和"输出的长度"混在一起了,短回答里编造的次数少,是因为分母小,不代表模型更诚实。一个 20 字的回答里塞一个假事实,比一个 200 字的回答里塞一个假事实更危险,因为前者的信息密度更高、更不容易被读者察觉。这是个可以被写得更准的地方,尤其在一本以"严谨"立身的书里。
八、这本书该怎么读
我的建议是不要从头读。p0020 里作者自己就说了:"由于本书采用模块化结构,你可以跳过任何你已经熟悉或与你相关性较低的部分。"他还专门提醒:某些章节会深入到技术细节,"如果你觉得某些内容过于深入,可以随意跳过"。
具体路线我给两条。
要动手的人:第 7 章 → 第 9 章 → 第 3、4 章。先看微调那 90 屏(尤其是 p0540 的五步和 p0570 的内在维度),再看推理优化的 71 屏(延迟和成本的真实结构),最后回头补评估的 157 屏。顺序反过来的原因是:你先得知道东西长什么样,评估指标才有对象。
要决策的人:第 3、4 章 → 第 10 章。先用 157 屏建立"我怎么知道它行不行"的框架,再看第 10 章的架构与用户反馈(68 屏),把"上线之后怎么继续量"接上。中间那些技术章节,等你要选型的时候当工具书查。
第 2 章那 100 屏(训练数据、建模、后训练、采样)可以按需读。它是原理章,写得清楚,但如果你不是要碰模型本身,读到能理解"为什么上下文长了困惑度会降"这个程度就够。
还有一处容易被跳过、但我建议留着看的:第 8 章数据集工程的 67 屏。p0150 那张图(图 2-9,来自 Villalobos 等 2024)画的是训练数据集规模的历史趋势与可用数据存量的预测,按"5 倍过度训练"算,存量被完全利用的中位年份是 2028。同一个位置还提了两件现在正在发生的事:一是有人故意往互联网上灌特定文本,指望影响未来模型的回答;二是"模型遗忘"——你今天发了一篇文章又删掉,如果它已经被卷进训练数据,模型仍可能在你没同意的情况下把它复述出来。
这两个问题在 2026 年都变成了显学(数据枯竭、版权诉讼、被遗忘权)。书里只用了两屏,但方向指对了。好的技术书就是这样:它不一定给你答案,但它把麻烦标在你还来得及看见的地图上。
823 屏读完,我的总结是:这本书最值钱的不是它教的任何一个技术,而是它把"评估"放在"提示工程"前面这个动作——它假定你会犯错,并且假定你不知道自己错了。一个愿意从这个假定出发写书的作者,比一个假定你只要照做就行的作者,靠谱得多。
至于那三个短板——没有代码、智能体太薄、现场在 2023 年的美国——它们不影响这本书作为"判断框架"的价值,但影响它作为"操作手册"的价值。把它当尺子用,别当图纸用。
阅读记录
书名:AI工程:大模型应用开发实战(Chip Huyen) | 平台:微信读书 | 翻阅:823 屏(全书完,reached_end=true,end_reason=last_page)
抓取耗时 3421.1 秒 | 章块 63 个(正文十章 + 版权/两段赞誉/译者序/中文版序/前言 + 后记/作者/封面简介) | 章屏数:前置 29(3.5%)· 第1章 79(9.6%)· 第2章 100(12.2%)· 第3章 73(8.9%)· 第4章 84(10.2%)· 第5章 66(8.0%)· 第6章 88(10.7%)· 第7章 90(10.9%)· 第8章 67(8.1%)· 第9章 71(8.6%)· 第10章 68(8.3%)· 后记区 8(1.0%)
抽读核对页:p0020 如何阅读 / p0080 业务指标与实用性门槛 / p0095 技术栈与延迟 / p0150 数据存量预测 / p0200 幻觉的两个假设 / p0225 困惑度与保密 / p0260 AI 当裁判 / p0330 公开基准与饱和 / p0420 防御性提示工程 / p0485 智能体与计划生成 / p0540 微调前的五连问 / p0570 LoRA 与内在维度 / p0600 学习率与批次 / p0700 计算原语 / p0790 用户反馈与偏好数据
说明:章标签存在滞后(约 ±2 屏),统计按实际页位校正;书中译名按原书译法(Chip Huyen、LoRA、TTFT、TPOT)。本篇不引用书外材料,所有页码均可在原书中直接核对。
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: