
大模型RAG实战:叫"实战"的那部分,只占24%
阅读提示:全书 324 屏、8 章、110 节,从版权页到书尾逐页翻完,抓取 853 秒,reached_end=true(end_reason=last_page)。我抽看了 11 张关键页,引句都标了页码,可以复查。这篇不按目录讲,只讲三件事:它凭什么值得读、哪几页最值钱、哪里没写完。
先说结论:这是一本合格的"检索教材",但不是一本合格的"系统实战书"。它把 RAG 这条链路上每一段的取舍讲清楚了——为什么切 512 个 token、为什么召回八个片段、为什么重排序要用交叉编码器——这些是真功夫。但书名许诺的"系统构建",只占全书 24%。
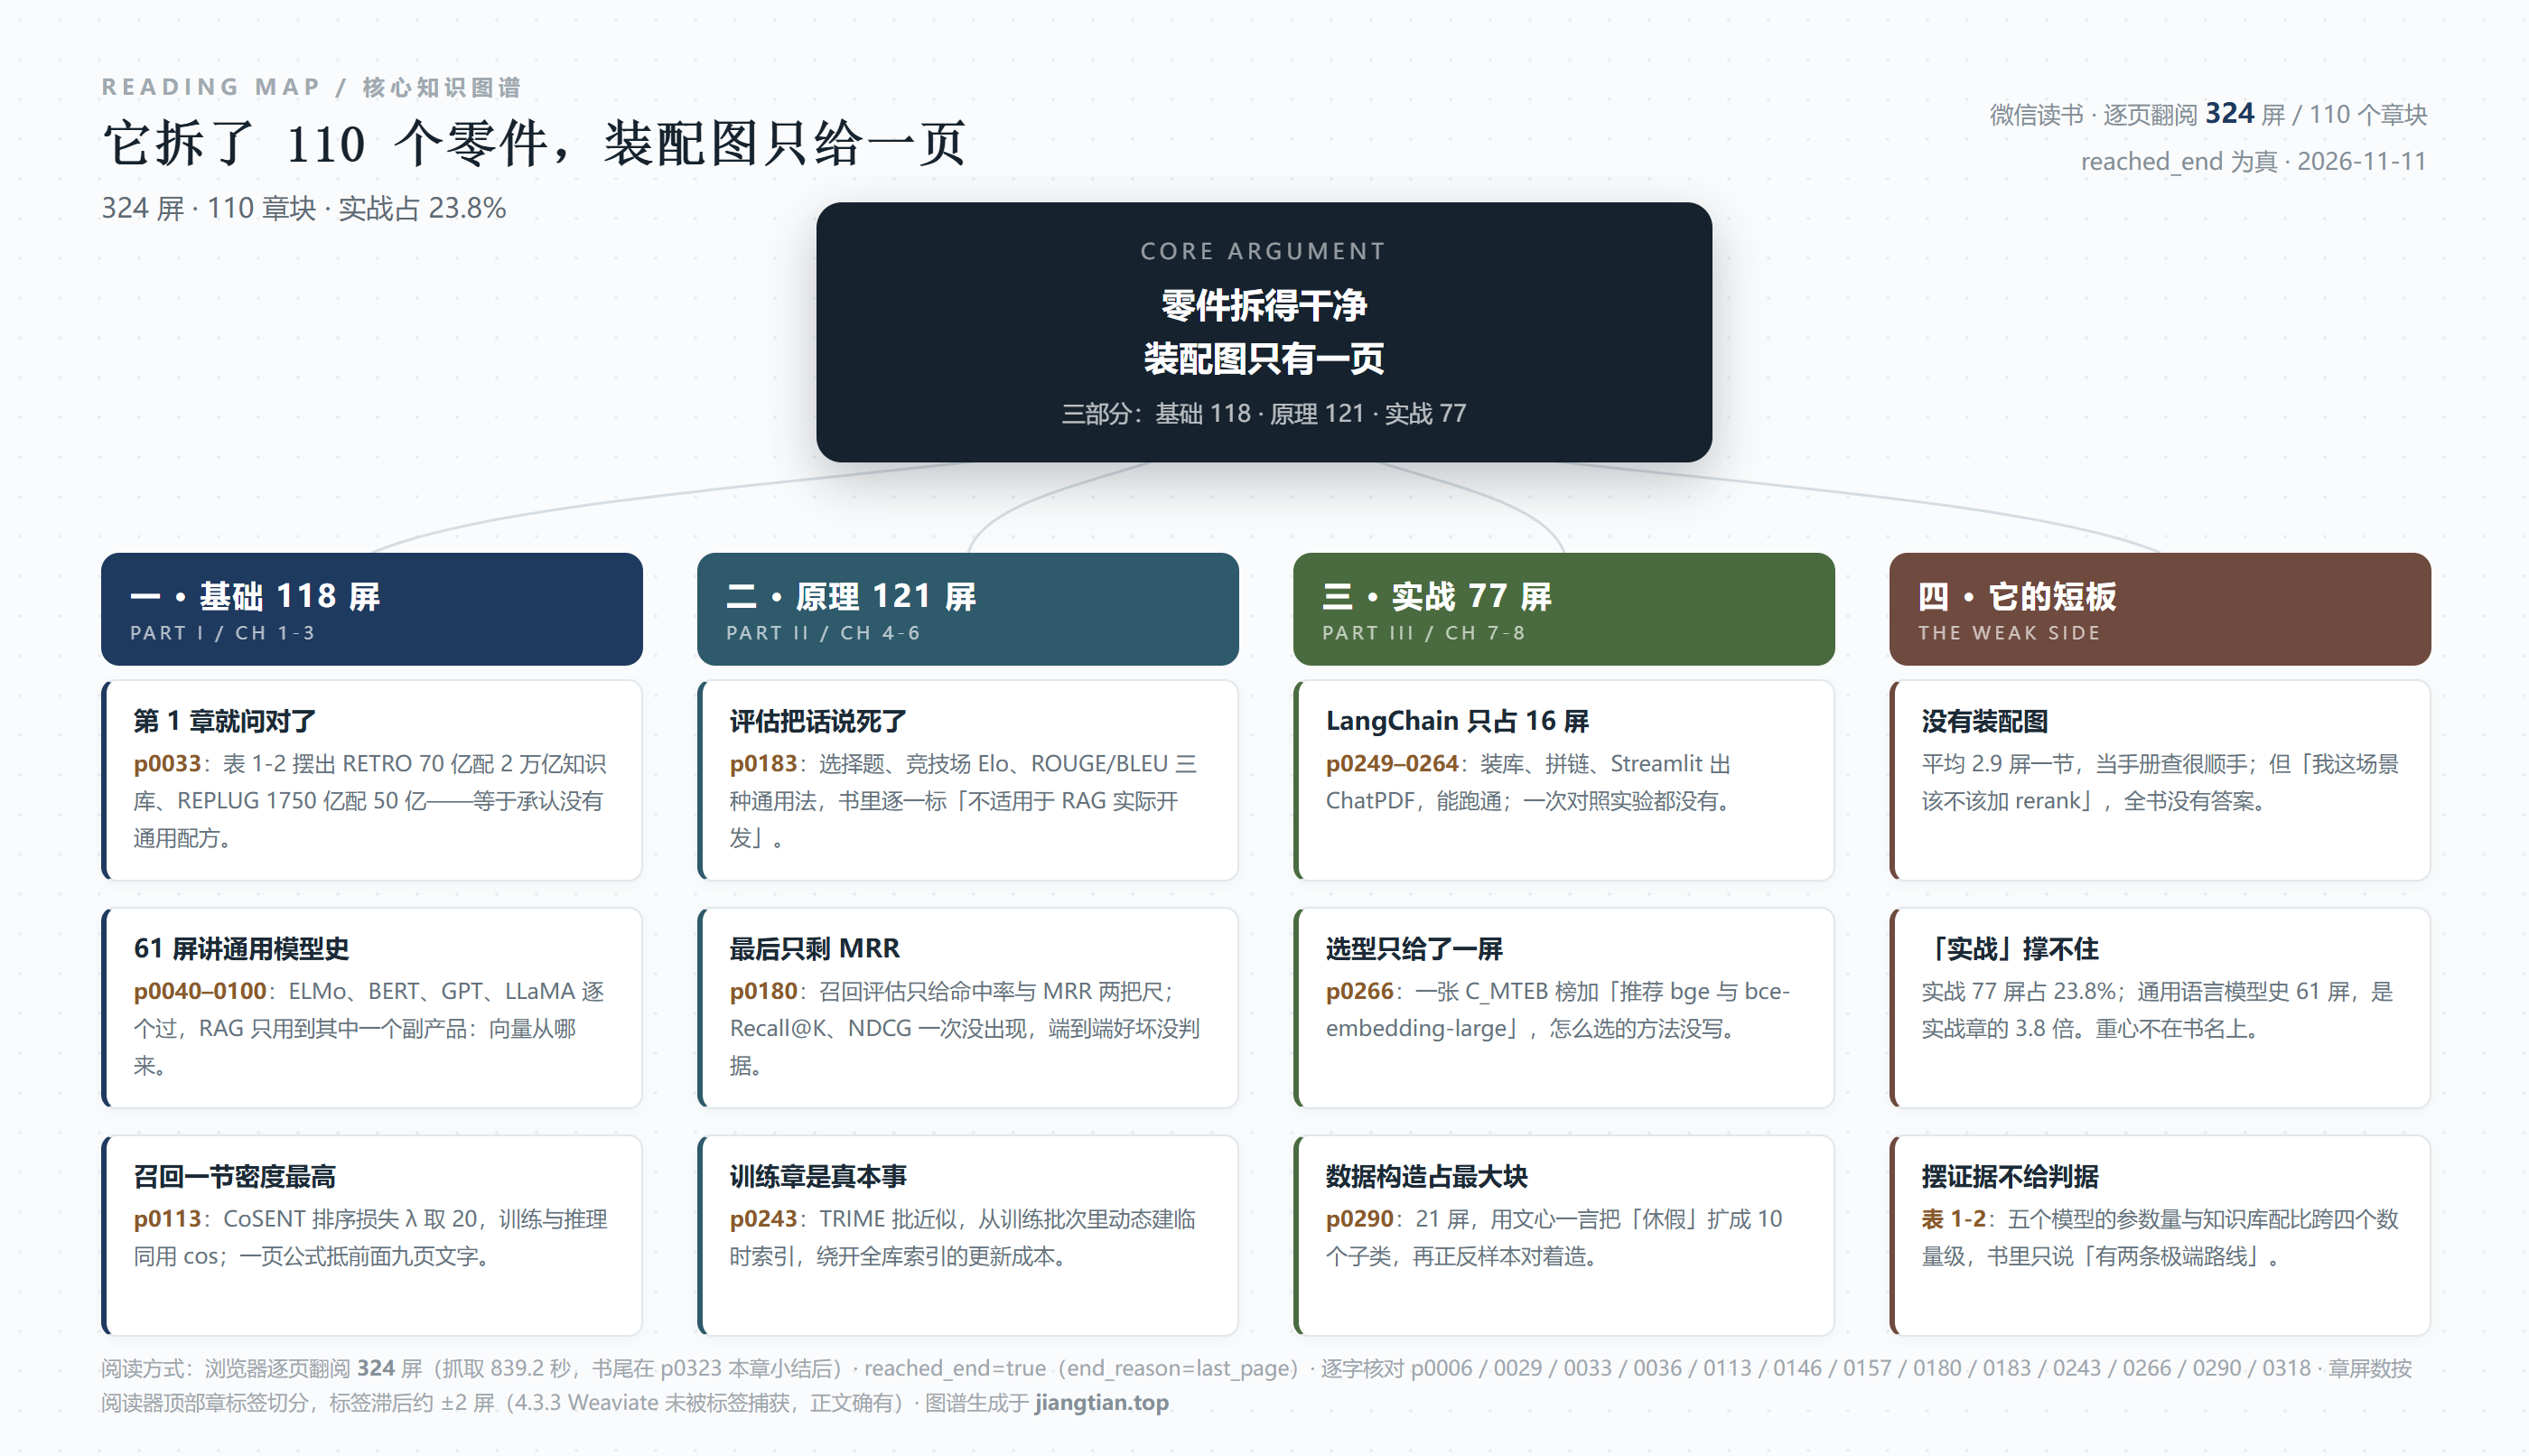
这个数字不是我拍脑袋说的。我把 324 屏按章切了一遍:第 1 章 31 屏,第 2 章语言模型基础 61 屏,第 3 章文本召回模型 26 屏,第 4 章 75 屏,第 5 章范式演变 23 屏,第 6 章系统训练 23 屏,第 7 章 17 屏,第 8 章系统构建与微调实战 60 屏。三个部分加起来:基础 118 屏(36.4%),原理 121 屏(37.3%),实战 77 屏(23.8%)。
一、作者是"落地过的人",这一点在前言里就藏不住
p0006 的前言里有一段自述,我认为是全书最可信的一处证据。他说写这本书的时候还在金山办公软件有限公司任职,现成的文档、知识库业务促使他在 2023 年初就开始尝试大模型落地,最先落地的应用就是基于金山知识库的 RAG,后续推出了基于云文档的 ChatFile,以及基于金山协作的搜索助手,它们均以 RAG 为核心。
这段话解释了这本书为什么能写——不是查资料查出来的,是做过产品做出来的。也解释了它的视角:全书的默认场景是"企业知识库 + 文档问答",不是"通用聊天机器人"。你如果要做的是客服知识库、内部文档助手、合同检索,这本书的假设跟你的处境是对得上的。你要做的是角色扮演、创意生成,那它大半篇幅跟你无关。
前言里还有一个我很欣赏的处理:他正面回应了"上下文窗口越来越长,RAG 是不是要没用了"这个流行论调。他的回答不是喊口号,是讲机制——大模型在无损推理时,为了保证推理效率,需要缓存每个时间步的 KV,随着长度增加显存消耗非常庞大,所以单张推理卡的推理长度有限;而且企业知识库体量再小也远超窗口。顺带他还补了一句:靠召回大量候选来提高查全率,靠调整切块大小来保证答案完整。
这是一个懂工程的人才会写的段落。它没有说"RAG 永存",它说的是"在单卡显存约束下,窗口再长也不够用"。这句话可以被反驳,但反驳它需要拿出显存账单,而不是拿出口号。
二、它给 RAG 找的四个理由,比我预想的硬
1.2 节标题就叫"为什么需要 RAG",下面拆成知识更新、数据泄露、训练成本、上下文窗口四小节。四小节里我最想拎出来的是第一个,因为它用了一个具体到可以复现的例子(p0016)。
书里说,问 GPT-3.5-turbo(0315)"拼多多的 CEO 是谁",它回答"拼多多的 CEO 是黄峥"。而实际上早在 2020 年 7 月,黄峥就已经公开宣布卸任拼多多的 CEO。紧接着作者做了对照:同样的问题问 Bing Chat,得到的是正确答案——因为 Bing Chat 在拿到用户问题之后,会借助自己的搜索引擎搜索出问题相关的网页,再结合网页内容和用户问题生成答案,这是一个典型的 RAG 落地应用。
这个对照的妙处在于它把"幻觉"从一个抽象缺陷,变成了一个可测量的延迟问题:模型的错误不是因为笨,是因为它的知识停在了训练截止日。p0010 里作者把这个截止日写得很具体——2023 年 11 月 OpenAI 发布的 GPT-4 Turbo,知识更新时间的截止日期是 2023 年 4 月。对一个 2026 年还在读这本书的人来说,这个日期本身就是一种提醒:书里的技术坐标,也停在了某个时刻。
另外三个理由,书里写得平实,没有夸张:数据泄露是"不能把敏感数据拿去训练",训练成本是"更新知识库通常要重新训练",上下文窗口是 4096 个 token 的硬顶。这四个理由放在一起,逻辑是闭环的——它们不是在论证 RAG 先进,而是在论证"没有别的便宜办法"。这个论证姿态比技术优越论可信得多。
三、拆链路:它每一层都告诉你代价,这是本书最硬的品质
讲 RAG 的文章很多,多数讲"怎么做",这本书多讲了一层"这么做要付什么"。p0150 那一段是我划了线的:
要说明的是,除精确检索外,其他算法均属于近似检索,会降低检索精度,但是可以提高检索速度。
紧接着它把两类做法摆开:精确检索是暴力检索,把所有向量保存在连续内存里,逐个计算与查询向量的相似度,速度慢、内存占大,但结果准确,适合数据量小的场景;倒排索引在向量检索场景下变成了聚类——先对所有向量聚类得到若干聚类中心,检索时查询向量只需与聚类中心算相似度,再在选中的几个类里精搜。书里明确写了它要付的代价:检索出的向量可能不是全局最相似的,需要调节聚类的个数来权衡速度和精度,而且还需要额外的训练过程来寻找聚类中心。
这种写法在工程书里其实不多见。多数书会告诉你"用 HNSW 更好",这本书告诉你"你换来的是近似"。差别在于:前者让你在出问题时不知道该调什么,后者让你知道出问题该往哪调——召回不准,先问是聚类个数设小了,还是走了近似路径。
同样的品质出现在重排序那一节(p0170)。书里说,在 RAG 场景下最常用的重排序模型是基于 Transformer 编码器架构的交叉编码器,把用户查询和一段候选文本同时输入模型,预测它们之间的相关性分值,"可以考虑到用户查询和候选文本的上下文关系,因此具有更高的预测精度"。它顺带点了背景:这种多级排序的思路,在互联网搜索、推荐、广告等领域被广泛使用。
再往上一层,它给了两个不用训练就能上手的方案:LangChain 的 ContextualCompressionRetriever 写得很清楚——把基础检索器和压缩器传进去,LLMChainFilter 负责判断召回的文本是否与问题相关,LLMChainExtractor 负责从召回文本中提取关键句,"这两种压缩器的底层实现原理非常简单,仅仅是通过设计提示词来实现"。书里还附了提示词原文:
"Given the following question and context, return YES if the context is relevant to the question and NO if it isn't."
一行提示词,替代一个重排序模型。这是全书最"能用"的地方:你不需要标注数据,不需要训练,加一层 LLM 过滤就能把无关片段挡在生成之前。代价书里也说了——"如果算力允许"。算力不允许呢?书里没往下讲,这正是我后面要说的短板之一。
四、最值钱的 21 屏:教模型说"我不知道"
如果这本书只能留一节,我留 8.3.1 微调数据构造,它占了 21 屏,是全书单节最长的一段。原因很简单:RAG 系统最难的从来不是"答对",是"答不了的时候别编"。
作者在 p0130 已经铺过这个伏笔,标题就叫"设置兜底回答方式"。他说在 RAG 场景下,向量化模型可能无法准确召回与用户问题相关的文本,甚至几乎没有任何关联,如果让 LLM 根据这些召回的文本生成答案,可能会得到与问题无关或不符合事实的答案,所以需要明确告知 LLM:如果上下文中没有与用户问题相关的答案,就不要强行生成。接着他用推荐乐队的场景做了对照——场景 1 只告诉 ChatGPT 小明和小红喜欢哪些乐队,信息其实回答不了"给我推荐乐队",但 ChatGPT 还是强行回答了;场景 2 明确告知"不能回答就不要回答",才给出合乎逻辑的答案。
这段是"提示词层面"的兜底。真正硬的是 p0308 那一步:把兜底做进训练数据里。书里给的样本长这样——先给一段知识,问一个知识里答不出的问题(比如带薪年假的天数),让模型输出"根据提供的知识,无法确定带薪年假的天数",再让模型补 Summary、Thought、Answer 三段,最后把整条样本的否定段落结果固化成训练格式:
Answer:根据提供的知识,无法确定带薪年假的天数。
……由于无法确定具体的天数,我们无法给出员工在选择休哪种年假时需要考虑哪些因素的具体答案。
我看这一节的时候有一个明确的判断:这才是"实战"该有的样子。它不是在讲一个概念,是在演示一条数据是怎么被造出来的——用模型自己生成否定样本,再把否定样本固化进微调集,让"拒答"从一个提示词技巧变成模型的默认行为。这一步做完,兜底就不再依赖用户在提示词里写不写那句话了。
顺带说一句 p0230 的独立训练一节,它用 ChatPDF 做例子把整条链路走了一遍:文章按固定窗口切片 → 用 OpenAI 的向量接口把每个段落转成向量 → 用户问题转成向量 → 比较相似度排序 → 取最接近的一个或几个段落作为上下文交给对话接口。然后它点了一句关键的:在这个类别下,召回模块和生成模块是解耦的,可以随意替换为其他模型或 API。
解耦这件事,很多人当成架构优点在讲,书里当成一个事实在讲。我认为后者更准确:解耦不是设计出来的美德,是因为这两件事本来就没有共享参数,硬绑在一起才需要理由。
五、它的短板
第一,名实错位,而且这次错得比同类书更明显。副标题是"RAG 原理、应用与系统构建",实战部分 77 屏,占 23.8%;第 8 章 60 屏里,光"微调数据构造"一节就吃掉 21 屏。也就是说,全书真正讲"系统怎么搭起来"的篇幅,不到 40 屏。40 屏能讲什么?一个最小可用的 demo 可以,一套能上生产的系统不行——权限、增量索引(p0240 提到的"异步更新索引"只有零散几屏)、灰度、监控、回滚,这些是"系统"的真正含义,书里没有成节的篇幅给它们。
第二,没有一笔成本账。一个在金山办公做过 ChatFile 的人,一定知道这套系统一天烧多少钱、一次问答的 P95 延迟是多少毫秒、单卡能扛多少 QPS。书里对成本的表述停留在定性:"RAG 系统需要先检索文档,然后生成答案,相比于纯粹的大模型推理,整个系统的推理耗时会更长。在这种情况下,对于一些延时要求高的场景就无法满足需求。"(p0030)这句话是对的,但它等于没说——所有工程师都知道加了检索会更慢,他们想知道的是慢多少、在哪一步慢、能不能用缓存和并行把这段补回来。
第三,没有一次失败复盘。书里所有经验都是"应该这样做"的形状,没有一处是"我们当初那样做,结果错了"。这是产品实战书最容易补、也最容易被跳过的一环。一个做过三个 RAG 产品的人,踩过的坑一定比正确做法多,而坑恰恰是读者最需要的部分——因为读者的处境通常不是"我该选哪条路",而是"我已经在一条路上,现在卡住了"。
第四,评估这一环明显薄。4.5.2 模型回答评估,9 屏。RAG 的评估是公认最难的部分:检索的召回率、生成的可信度、拒答的正确率,三个指标互相牵制;评测集怎么建、标注一致性怎么保证、LLM 当裁判的偏差怎么校准,每一个都是硬骨头。9 屏给不出这些。我说得直白一点:如果一本书教你怎么搭 RAG,却没教你怎么判断它搭得对不对,那它教的是搭建,不是工程。
第五,第 2 章 61 屏的语言模型基础,是这本书的"体积填充"。18.8% 的篇幅在讲词嵌入、编码器、GPT 演进——p0060 是位置编码的 numpy 实现,p0092 是 GPT-1 的 1.17 亿参数和 BooksCorpus 约 7000 本书。这些内容本身没错,写得也算清楚,但它们和"用 RAG 解决企业知识库问题"之间,隔着一整个技术栈。把这段放进书里,唯一的理由是要覆盖"零基础读者",代价是让有基础的读者多翻 61 屏。
六、谁该读,怎么读
如果你正准备给公司做第一个知识库问答系统:值得买。读第 1 章建立必要性论证,读第 4 章建立取舍意识,读 8.3.1 学会造拒答样本。这三块合起来大约 100 屏,够你把一个能用的东西搭出来。
如果你已经在做,卡在效果上:直接跳到 4.4.5 重排序和 4.5.2 评估。前者告诉你还有一层没用上,后者告诉你为什么你判断不了自己好不好——然后你会去补评测集,而那本书帮不了你。
如果你是想理解 RAG 概念的非技术读者:读第 1 章就够,31 屏,一小时。剩下的部分对你是负担。
最后一句话:这本书最像一本写得扎实的研究生讲义,而不像一本工程手册。讲义的特点是覆盖全、逻辑顺、每节都有定义和出处;工程手册的特点是有账单、有坑、有"我们当时差点死在这"。这本书在前者上做得不错,在后者上基本缺席。它值它的价钱,但它不配它的书名。
阅读记录:微信读书《大模型 RAG 实战:RAG 原理、应用与系统构建》。全书 324 屏、8 章、110 节,逐页翻完,抓取 853 秒,reached_end=true(end_reason=last_page)。逐字核对页码:p0006(前言)、p0010(1.1.1 什么是 RAG)、p0016(1.2.1 知识更新问题)、p0030(上下文窗口限制)、p0060(位置编码)、p0092(GPT 演进历史)、p0130(设置兜底回答方式)、p0150(精确检索与倒排索引)、p0170(召回文本重排序)、p0230(6.3 独立训练)、p0308(8.3.1 微调数据构造)。章节屏数由 pages.jsonl 逐条统计,非估算。2026-11-12。
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: