
AI万金油:一句“它曾在谁身上测过”,比任何案例都值钱
阅读提示:这本书全书 353 屏、10 章,我只读到 137 屏——第 4 章开头,p138 连续三屏渲染不出来,抓取中断(end_reason=render_stall)。所以这篇只评上半本:引言、预测式 AI、以及"何以 AI 难测未来"三块。后半本讲生成式 AI,我没读到,就不装读过。引句标了页码,可以复查。
先讲一个巧合。昨天我刚读完一本 52 屏的 AI 写作口袋书,今天翻这本书的 p0018,看到作者写:聊天机器人容易被滥用,尤其是那些"试图快速获利的人,比如出售 AI 生成的书,却对内容质量毫不在意的出版商"。
我不是要拿这句话去嘲讽谁。我是想说:这本书的判断力,是那种"连自己所在行业也不放过"的判断力。一本由两位普林斯顿研究者写的、批评 AI 炒作的书,如果只批评别人的炒作、不批评自家门口的生意,它就还是营销品。这本不是。
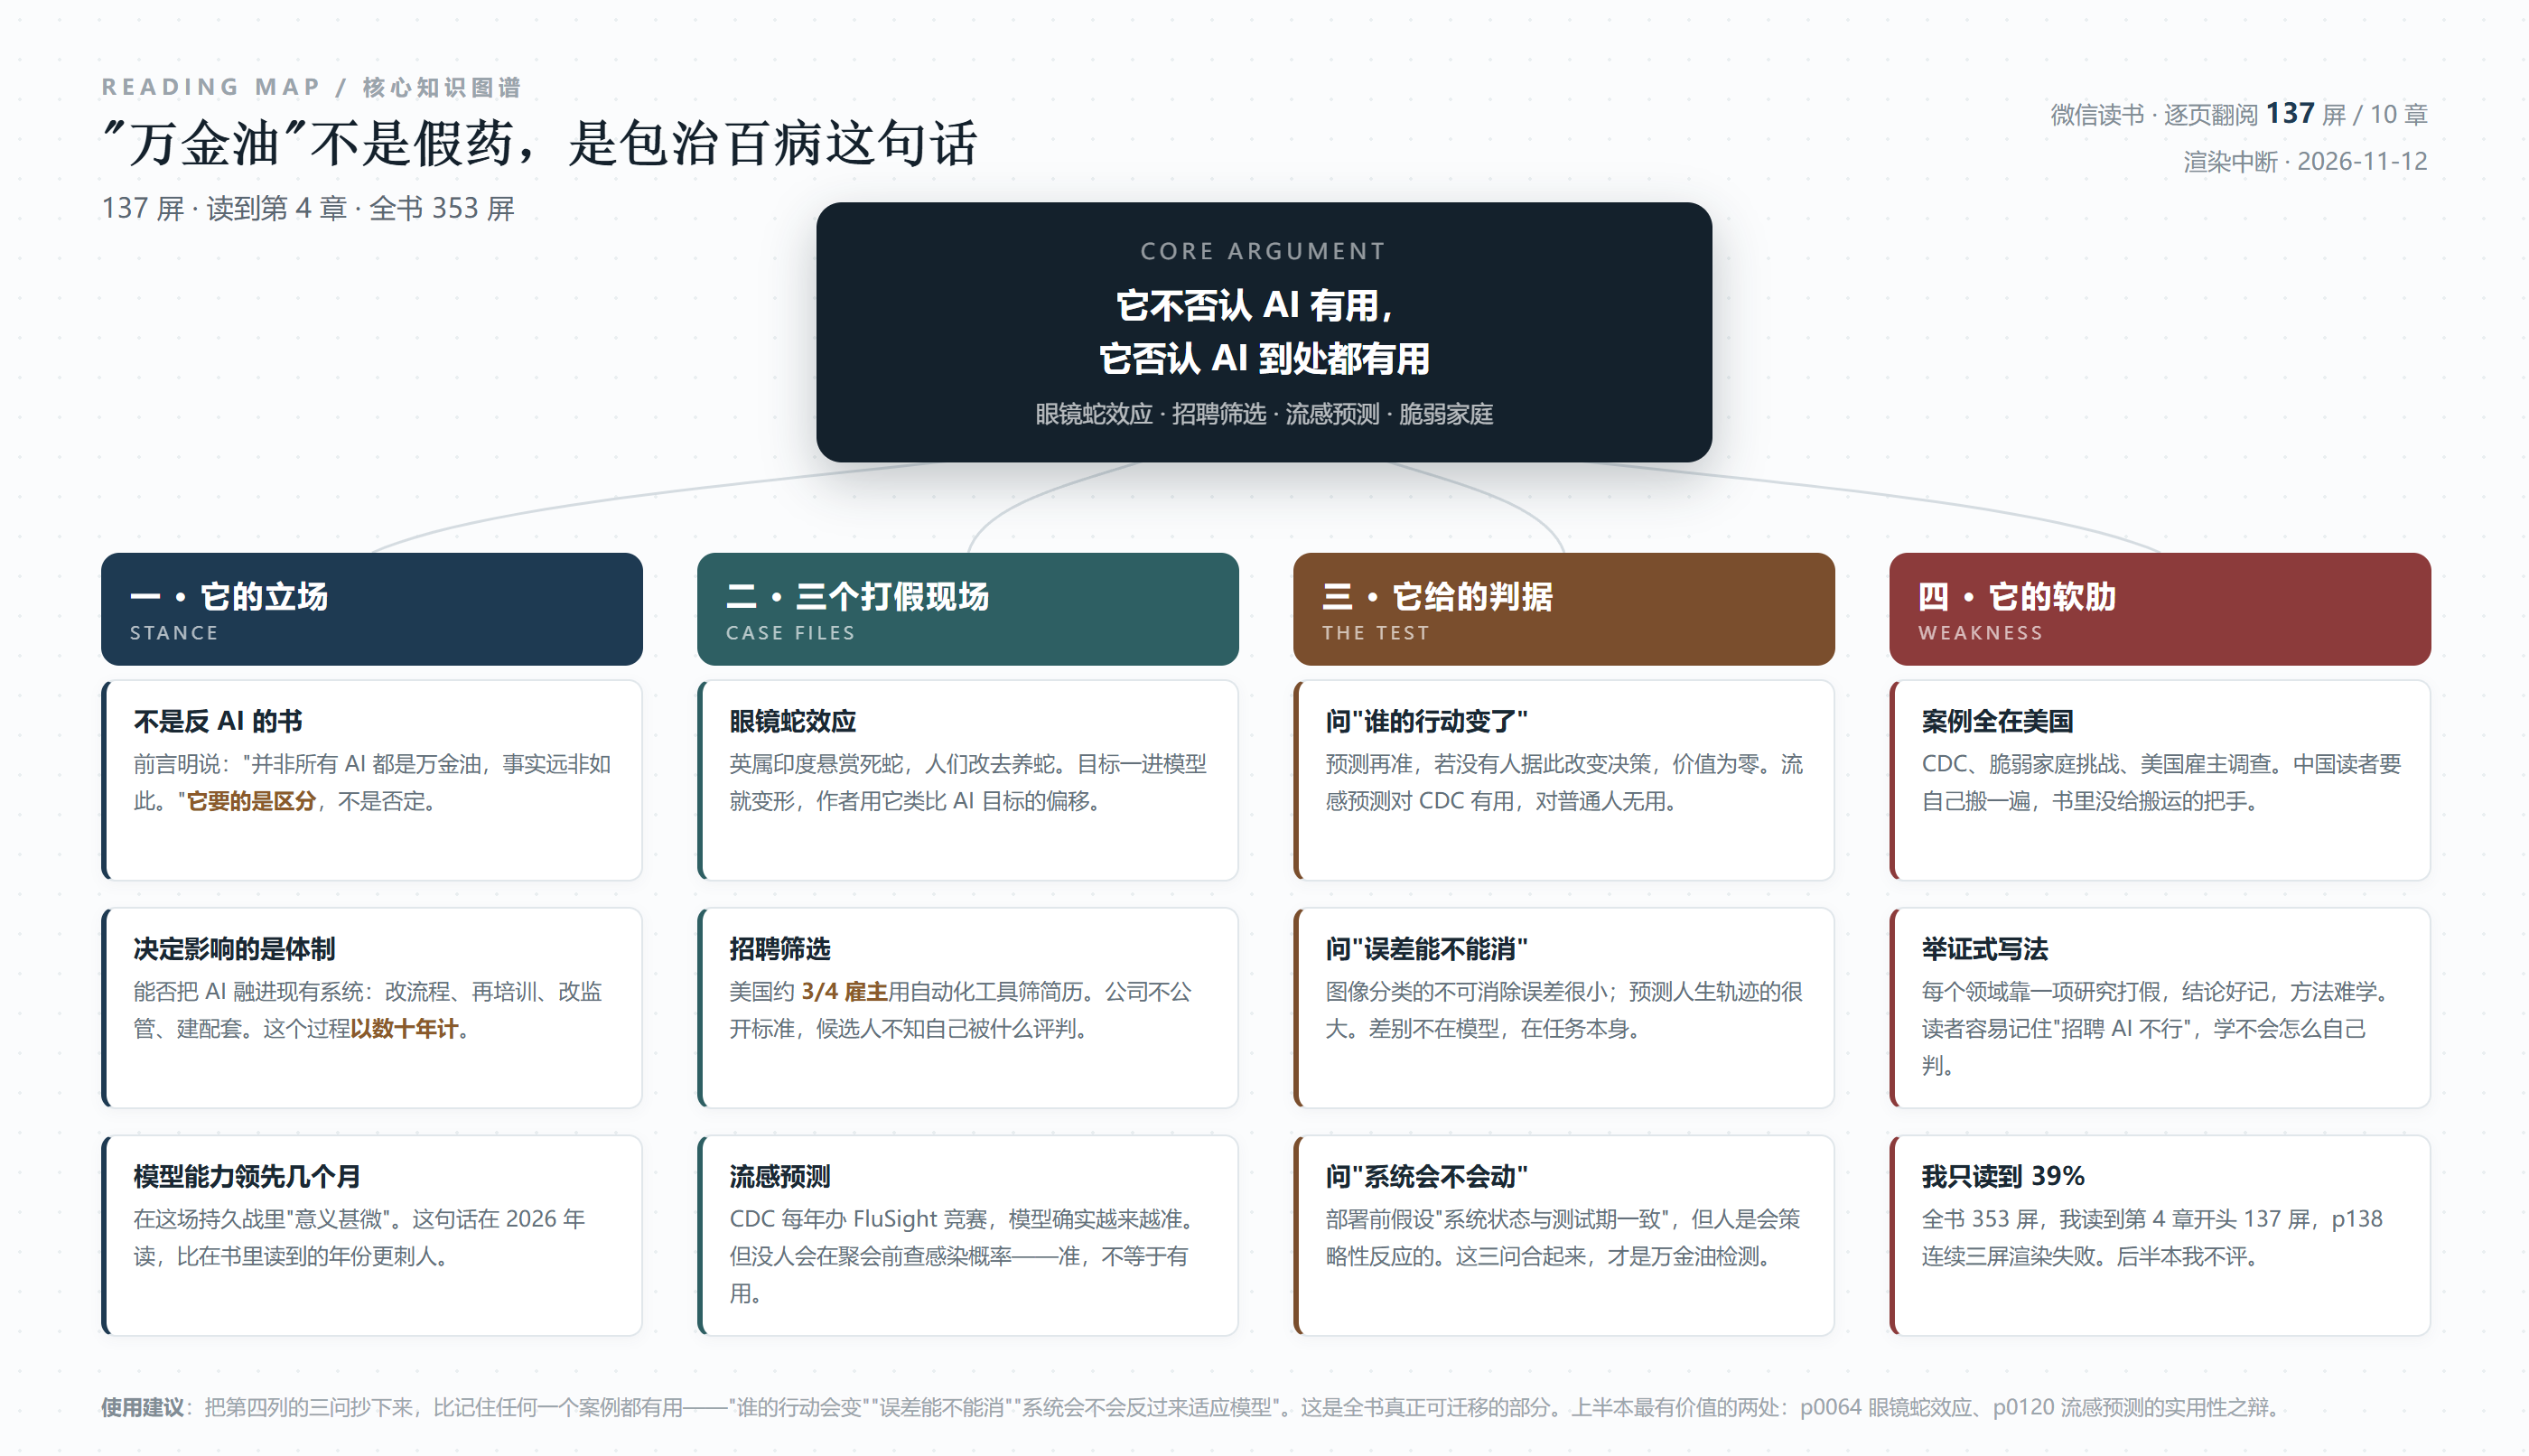
一、"万金油"这三个字用得很准
书名直译大概是"AI 蛇油"——蛇油是十九世纪美国走街串巷卖的万灵药,治风湿、治咳嗽、治脱发,什么都治,所以什么都治不好。译成"万金油"是聪明的选择,中文读者一听就懂,还带点熟悉的讽刺味。
但作者对这个词的使用比讽刺更克制。p0006 里有一段:"这本书致力于以既通俗易懂又具学术深度的方式,为读者呈现当下的 AI 格局……同时帮助读者识别那些将 AI 描述为'万金油'的误导性叙事。"紧接着一句关键的自我限定:"并非所有 AI 都是万金油,事实远非如此。"(p0034)
这个限定很重要。它决定了这本书不是"反 AI 宣言",而是"分类学"——把 AI 应用分成"真有用"和"被说成有用"两类,然后告诉你分界线在哪。市面上反 AI 的书和吹 AI 的书都太多了,肯做分类的少,因为分类会得罪两边。
p0006 还有一段我认为是全书写得最好的判断:"真正决定 AI 对经济和社会产生何种影响的,是一个国家能否有效地将 AI 融入现有体制与系统。这一扩散与融合的过程包括重塑工作流程、再培训劳动力、更新监管制度,以及构建有助于各行业高效使用 AI 的配套基础设施。这个过程以数十年为单位展开,而非以数月来计量。模型能力领先几个月,在这场持久战中意义甚微。"
这句话在 2026 年读,比在它出版那年读更刺人。两年里我们看过多少次"某模型又领先三个月"的通稿?而工作流程、监管、培训这些真正决定产出的东西,动得很慢。技术曲线和制度曲线之间那道越来越大的缝,才是这本书真正想说的东西,只是它用了"万金油"这个更轻的词来包装。
二、眼镜蛇效应:目标一旦写进代码,就开始变形
第 2 章的核心论证只用了一个历史案例(p0064):英国殖民者统治印度期间,为减少眼镜蛇数量,实施奖励政策——交出死眼镜蛇的人可以获得报酬。结果适得其反,人们不去捕蛇,改去养蛇换奖励,眼镜蛇数量反而增加。
作者用这个案例要说明的不是"激励会失效"这种老话,而是一件更具体的事:部署模型之前,无法完全确定 AI 的实际影响,因为 AI 在预测时假设系统状态会与测试期间保持一致。然而系统是动态的,人类行为本身就是显著的不确定因素;当人们采取策略性行为时,情况会变得更复杂。
接着他把靶子对准了本行业:开发人员构建 AI 时,会明确设定希望预测的目标,但由于依赖历史数据,只能基于现有数据来定义这个目标,因此 AI 实际预测的结果,可能与我们真正希望预测的结果存在显著偏差。
这句话值得单独抄下来。它说的是:你以为你在让它预测"好员工",实际上你在让它预测"过去被判定为好员工的人";你以为你在优化"减少犯罪",实际上你在优化"减少被记录在案的犯罪"。指标不是目标的近似,指标是目标的替代品。每一本讲 KPI 的书都说过类似的话,但这本书把它挪到了模型训练的第一行代码上。
三、招聘 AI:3/4 的美国雇主,和一场没人被告知的考试
p0064 举的第一个现实案例是招聘。书里写:在美国,约 3/4 的雇主使用自动化工具来筛选求职者。这些工具形式多样——有的根据简历筛选候选人,有的通过自动化视频面试评估候选人,还有一些要求候选人完成谜题测试。它们通常作为筛选流程的第一步;如果某位候选人未能通过筛选,他的简历可能会被直接删除,甚至无人再查看。
然后是这一节最关键的一句:然而,这一过程完全不透明。公司不会公开其软件是如何设计的,候选人也不完全了解自己被评估的标准。
我读到这里停了一下。三比四,这个比例比我想的高得多。也就是说,你今天投出去的简历,大概率先过的不是人眼。而它凭什么判断你,你无权知道;它判错了,你连申诉的入口都没有——因为流程的第一步就把你删了,你甚至不知道自己被删了。
书里接着写求职者的应对:他们会在简历里刻意填写某些关键词、包装某些经历,去迎合那套看不见的标准。这一段是全书最冷的幽默——当评估标准不可见时,人的理性选择不是提高能力,而是猜测标准。而一旦足够多的人开始猜,标准就失效了,因为它测的变成了"谁会猜"。
这正好接回眼镜蛇效应。悬赏死蛇,人就养蛇;模型筛关键词,人就堆关键词。作者没有把这两件事并列写,但它们显然是同一件事的两个年代。
四、灯下黑:一个县的家庭筛查工具
如果说招聘那一节讲的是"不透明",p0072 讲的更狠,是"错位"。书里提到宾夕法尼亚州的阿勒格尼县(Allegheny County):2016 年该县引入"阿勒格尼家庭筛查工具",用于预测哪些儿童有遭受虐待的风险,并据此决定哪些家庭应接受社工调查;调查结果赋予社工权力,可以强制将儿童从家中带走并安置到寄养家庭。
这套工具依赖公共福利数据,主要涵盖使用公共服务(如医疗补助资助的诊所)的低收入家庭。而这些数据并不包括使用私人保险的富裕家庭的信息。因此,基于这些数据训练的模型,无法有效评估从未依赖公共服务的富裕家庭的情况。结果,该工具不成比例地将目标集中在较贫困家庭上。
书里给这个现象起了一个名字:"灯下黑"——AI 的聚光灯往往照向的是弱势群体。然后是全章最锋利的一问:每当预测式 AI 工具被部署时,关键问题是,它曾在谁的身上测试过?如果一个 AI 工具基于某一群体的数据建立,却被用于另一群体,其性能主张往往缺乏充足的证据支持。
同一页还提到一个更早的案例:某再犯风险评估系统(PSA)虽然使用了全美范围内的数据,却未充分考虑到一些地区的犯罪率可能明显偏低;这一问题导致数千名被告在审前因模型预测被不必要地监禁数月,而这些预测并未基于任何实际犯罪证据。而在被预测为高风险的被告中,只有约 1/10 最终犯下了暴力罪行。
"1/10"这个数字,比任何一段理论都更能说明问题。审前羁押的代价是自由的丧失、工作的丢失、家庭的破裂;换来的准确率是十中有一。这不是模型不够好,这是把"概率"直接兑成了"惩罚"。而概率一旦兑成惩罚,它的误差就不再是统计问题,是人的问题。
五、流感的教训:准确,是最容易做对的那部分
p0120 那一节,是我认为全书方法最干净的一节。作者要论证"预测准不准"不是唯一标准,"有没有用"才是。
他先给正面例子:每年美国疾病控制与预防中心(CDC)都会预测流感季节的发展情况,以帮助医疗机构应对可能出现的病患激增;因为 CDC 每年都会举办名为 FluSight 的公开竞赛,我们对这些预测的准确性有一个相对清晰的了解。多年来参赛模型不断改进,其预测准确性明显优于基于上一流感季某周和某地区病例数的简单基准数据。
然后他反问:但这些模型足够好吗?要回答这个问题,评判的关键在于其实用性,而不是是否达到某个特定的数值门槛。事实是,人们不会在计划聚会前查看感染流感的可能性,因此流感预测尚未对普通人的日常生活产生直接影响。然而当前的模型已足够可靠,使得 CDC 年复一年地继续举办 FluSight,这些模型也已经证明对医疗机构非常有用。
这个论证的漂亮之处在于它同时给出了肯定和否定:同一个模型,对 CDC 有用,对普通人无用,这两句话都成立,不矛盾。所以"AI 有没有用"这个问题问错了,正确的问法是"对谁、在什么决策上、有没有用"。
紧接着是反例:新冠预测更令人沮丧。我们未能预测到 2020 年新冠疫情的大流行;即使在疫情开始后的几个月里,专家们仍然无法准确估计其严重性,预测数据四散不一;到 2024 年,美国的新冠死亡人数已达 120 万左右,远高于专家最初的预测。书里给的解释是结构性的:新冠疫情由偶然事件引发,疫情通常源于难以预测的随机突变,我们尽管清楚大流行的风险,却无法预知何时以及以何种形式发生。
p0100 里有一段把这件事说到了底:科幻作品里预测犯罪的作品(《少数派报告》《疑犯追踪》)核心矛盾通常集中在宿命论与自由意志的对立上,但它们往往忽略了一个关键且无法消除的误差来源,那就是偶然事件。AI 在某些任务上表现良好,是因为任务本身的不可消除误差较小——判断一张图里是猫还是猫,误差很小;而社会预测的不可消除误差有多高,目前理论尚未成熟。没有任何模型能够准确预测某人是否会中彩票,或者是否会遭遇车祸。
这一段,是我把这本书推荐给别人的理由。它不否认 AI 的能力,它划出了能力的边界,并且指出这条边界不在模型侧,在任务侧。你可以换更大的模型,但你换不掉偶然。
六、它的短板
第一,案例几乎全在美国。CDC、FluSight、阿勒格尼县、PSA、3/4 雇主调查——每一个论据都扎实,但每一个都需要中国读者自己搬一遍。公共数据覆盖谁、不覆盖谁,中国的情况和美国完全不同,书里没给搬运的把手。这不是书的错,是译作的天然损耗,但读者得知道自己付了这笔损耗。
第二,举证式写法,结论好记,方法难学。每一节的结构基本是:一个领域 + 一项研究 + 一个结论。读起来非常顺,合上书你能复述"招聘 AI 不行""再犯预测不行",但你未必学会了怎么自己判断一个新出现的 AI 应用。全书真正可迁移的东西,其实只有那三问——谁的行动会变、误差能不能消、系统会不会反过来适应模型。而这三问,是我自己从散落的段落里拼出来的,书里没有把它们集中成一张检查表。
第三,译名不统一,读起来磕绊。正文里"萨亚什""阿尔文德""马修·萨尔加尼克"交替出现,同一个人在不同页有不同的称呼方式,读者要花力气对齐人名。这不是内容问题,是编辑问题,但一本讲"要看清叙事"的书,自己在文本清晰度上失分,有点可惜。
第四,也是最大的一个:我只读到 39%。后半本讲生成式 AI——从 p0018 和 p0050 的预告看,至少涉及版权(搜索引擎用 AI 答案取代十个链接,AI 整合重写他人内容却不为原创站点带去流量)、劳动力(生成式 AI 依赖数百万人的低薪重复性工作创建训练数据,利用网络内容却不为创作者署名或提供补偿)。这两块恰恰是 2026 年最要紧的两块,而我没读到,所以不评。这是我这次阅读的缺口,不是书的缺口,我把它写在这里,免得读者以为这就是全书的全貌。
七、一句话判断
这本书的价值不在于它说了多少"AI 不行",而在于它示范了一种问法:不问"这个 AI 强不强",问"它在谁身上测过、给谁用、让谁的行动真的变了"。三个问题里,第二个最容易被跳过,第三个几乎没人问。
我读完这 137 屏,最大的收获不是任何一个案例,是那句"它曾在谁的身上测试过"。这句话可以拿去问任何一个正在向你推销模型的供应商,也可以拿去问自己团队里那个已经上线的评分系统。如果答不上来,那它就是万金油——哪怕它真的很准。
阅读记录:微信读书《AI 万金油:商业幻想与科技狂潮》。全书 353 屏、10 章,本次读到 137 屏(第 4 章开头),p138 连续三屏渲染失败,抓取中断,end_reason=render_stall,未读完,后半本未评。逐字核对页码:p0006(联合前言)、p0018(聊天机器人的陷阱与权力问题)、p0034(谷歌流感趋势与本书缘起)、p0050(生成式 AI 与劳动力)、p0064(眼镜蛇效应与招聘 AI)、p0072(PSA 与阿勒格尼县家庭筛查工具)、p0084(普林斯顿课程的由来)、p0100(偶然事件与不可消除误差)、p0120(FluSight 竞赛与新冠预测)。2026-11-12。
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: