
大模型浪潮:前半本是教材,后半本是产品手册
微信读书《大模型浪潮:商业机遇、产业变革与未来趋势》(沈抖 著)· 逐页翻阅 264 屏 · 前置 20 屏 + 四章 · 章块 29 个
抽样说明:这本书的目录本身就是论点,所以我两条线一起抽——目录与推荐序(p0003、p0006、p0018)、七十年技术史(p0030)、算力三组数(p0050)、人机交互(p0070)、百模大战(p0080)、智能体(p0125)、混合专家模型(p0136)、DeepSeek(p0149)、新型基础设施(p0174)、产业结合(p0188)、技术栈与 MaaS(p0210)、四层开发模式(p0230)、提示词优化(p0240)、RAG 与政务案例(p0264)。
要说清楚一件事:这本书我没读完。抓取在 p0264 之后卡住,阅读器把页面压成 2953px 的短页、按钮消失,连续三次渲染超时后停止。所以我读到的是「第四章第三节 人工智能原生应用的开发」开头的实践案例,后面的章节(如果存在)我没看到。本篇所有判断只覆盖这 264 屏,页码都能在书里直接核对,不引用任何书外材料。读了一半就说一半的话,这比假装读完更诚实。
先给结论:这本书是两个人写的,虽然署名只有一个。
前面 197 屏(含推荐序)的作者是个不错的工程师型作者,他知道 GPT-3 训练要算多久、知道 MoE 为什么要做专家路由、知道 RAG 的两个阶段各干什么,还愿意把「联结主义的低谷不是原理错,是算力不够」这种话讲明白——这在国产技术书里算稀罕。
从第 198 屏开始,作者换成了一个人:百度集团执行副总裁。他不再解释技术,他开始给建议,而每一条建议的最后,都通向同一个地方——百度智能云千帆平台。
这不是什么罪过。企业高管写书,带着自家产品是常态,读者自己打折就行。但打折这件事得有人提醒你,书自己不会提醒。所以这篇笔记的主要工作,就是标出从哪一页开始打折、打几折。
一、它怎么讲历史:把七十年压成一条螺旋
第一章用了 66 屏(占 25.0%),讲的是从 1956 年达特茅斯会议到今天的路。这段写得比我预期扎实,因为它没有把历史写成一条昂扬向上的曲线,而是老老实实承认了三次低谷。
最见功力的是 p0030 那一段。1962 年,IBM 的塞缪尔写了套西洋跳棋程序,赢了当时的人类棋手罗伯特·尼利;斯坦福研究所造出移动式机器人 Shakey,能自己感知环境、建个简陋的模型、再规划路径去把一个木箱推到指定位置。听起来很神,但作者紧接着就给了一个冷静的判断:当时算力和存储都有限、推理规则也不完善,所以这些产品「虽然很惊艳,但实用性不强,甚至连翻译工作也不能保证准确率」。
然后就是 1973 年。英国数学家詹姆斯·莱特希尔交了一份调查报告《人工智能:综述》,俗称莱特希尔报告,结论是当时的人工智能「都是夸大其词,实际效果很差,研究已经彻底失败」。报告一传开,各国政府投资大幅削弱,行业进入第一次低谷。
这段最值钱的是作者在 p0030 上方给出的那句归因:「联结主义并非原理有重大缺陷,而是其发展与算力高度相关。」
这句话看着平淡,其实是整本书的暗线。如果七十年的失败主要是算力不够,那今天一切的乐观,本质上都建立在一个赌注上——算力会继续便宜下去。作者后面所有关于「时机已到」的论证,都押在这个赌注上,但他从头到尾没有正面讨论过:如果算力不再便宜,或者电不够用了,这条曲线会怎么走。这是全书最大的一个沉默,我放在短板那一节细说。
二、全书最有用的三个数字,都在第 50 屏
如果这本书你只打算翻一页,我建议翻 p0050。这一页把「大模型为什么只有大公司玩得起」讲得比任何行业分析报告都清楚,而且全是可以复述的硬数字。
第一个数字:10 的 23 次方。这是 OpenAI 技术报告里 GPT-3 训练一次所需的总计算量。作者怕你没感觉,换算了一下:以一秒能算 60 万亿次的英伟达 H800 为例,需要 1000 块显卡连续跑 50 天。
第二个数字:500 万到 1000 万美元。这是上面那 50 天对应的成本。作者还补了一句很中国的换算——用传统算盘打,得让全世界 80 亿人一起算 100 万年,才能算一遍。他给这组数字下的结论是:「大模型的出现绝对称得上是个奇迹,仅靠个体是绝对解决不了如此规模的计算问题的。」
第三个数字:45TB。GPT-3 的预训练数据量,作者换算成「10 万人一辈子不睡觉才能读完」的阅读量。
这三个数字我建议你记住,因为它们是这本书后面所有商业判断的地基。谁能一次性烧掉一千万美元且不心疼,谁才有资格谈「自研基础模型」;剩下的人,只能谈「用」。书里后来那句「卷大模型不如卷应用」,其实不是战略洞察,是这三个数字算出来的必然结果。把必然包装成洞察,是这本书的一个习惯。
三、第二章值得逐字读:它把「技术」讲成了「工程」
第二章 76 屏,占 28.8%,是全书篇幅最大的一章,也是我认为唯一值得逐字读的一章。理由很简单:它讲的不是「技术有多厉害」,而是「技术是怎么被工程化的」——这两件事的差别,决定了你读完是获得知识,还是获得情绪。
八节的结构是这样的:预训练(p0091)、有监督微调(p0099)、人类反馈强化学习(p0107)、检索增强生成(p0116)、智能体(p0125)、混合专家模型(p0136)、长上下文(p0143)、DeepSeek(p0149)。前四节基本上就是大模型的四道工序,作者讲得干净:预训练是「读万卷书」,微调是「学规矩」,强化学习是「对齐人类偏好」,RAG 是「开卷考试」。
其中我最推荐的是 MoE 那一节(p0136)。它用两句俗语把混合专家模型讲明白了:一句是「隔行如隔山」,说的是通用大模型再强也吃不下所有专业场景;另一句是「三百六十行,行行出状元」,说的是那就给模型配一批「状元」——每个专家网络管一摊,前面再加一个调度器决定这活儿派给谁。作者的总结是「既跑得快,又吃得少」。这个比喻不精确,但足够让你在开会时讲清楚为什么 MoE 能降成本。
RAG 那一节(p0116)和第 4 章的实践(p0264)是接上的。p0264 把 RAG 拆成两个阶段:数据准备阶段是「原始文档→数据提取→文本分割→向量化→数据入库」,应用阶段是「用户提问→数据检索(召回)→注入提示词→大模型生成答案」。这个拆法没有花活,但它是标准答案,照着做不会错。
第二章的问题不在内容,在它的位置。它被夹在一章历史和一章商业之间,像一个技术顾问被临时拉进董事会汇报,讲完就被请出去了。后面第四章再也没回过头引用过这里的任何一个概念——除了 MoE 的成本,而那里引用它是为了证明平台便宜。
四、第二章的后半段:两页值回书价
p0125 是全书信息密度最高的一页,值得单独说。作者从《钢铁侠》里的贾维斯讲起——J.A.R.V.I.S. 的全称是「Just A Rather Very Intelligent System」,一个「只是相当聪明的系统」,然后用这个「Just」引出反差:说起来轻描淡写,做起来极难。
接下来他排了一条时间线,四个人的四句话:
李彦宏在多个场合表示,智能体是人工智能时代的网站,是目前最能激发大模型潜力的应用方向。2024 年 5 月,OpenAI 首席执行官萨姆·奥尔特曼在麻省理工学院参加活动时提出,智能体将是人工智能的杀手级应用。2024 年 11 月,黄仁勋在英伟达 AI 峰会上表示,未来有两种类型的人工智能会非常受欢迎:数字人工智能工作者(智能体)和物理人工智能(机器人技术)。吴恩达在参加 2024 年 Snowflake 峰会开发者日时也表示,智能体工作流将在 2024 年推动人工智能取得巨大进步,甚至可能超过下一代基础模型。
这条时间线排得很聪明:一家中国云厂商的 CEO、一家美国模型公司的 CEO、一家卖铲子的、一位教课的,四个立场完全不同的人,说了同一个词。这种「交叉验证」的写法比任何论证都有说服力,因为它绕开了「谁对」的问题,直接告诉你「所有人都这么想」。
但我要提醒一句:四个人都看好,和这件事能成,是两码事。2024 年说这话的人,2024 年也都在卖与之相关的东西——李彦宏卖云,奥尔特曼卖 API,黄仁勋卖卡,吴恩达卖课。这不是说他们错了,是说这条时间线证明的是「共识」,不是「正确」。作者用共识代替论证,在这里用得最漂亮,也最应该被看穿。
再说 p0149 到 p0162 那 14 屏,全书读着最提神的地方
作者把 DeepSeek-R1 的发布称为「2025 年人工智能领域最令人惊叹的事件」,然后给了一组我很喜欢的对比数据:
万维网从发布第一个网站到拥有 1 亿用户,用了大约 7 年;推特用了 5 年 5 个月;微信用了 14 个月;ChatGPT 用了两个月;而 DeepSeek 从几乎为 0 到 1 亿,只用了 7 天。
这组数字之所以有力,不是因为 7 天有多快,而是因为它把前面所有的「门槛论」一次性打了个对折。上一节刚说完训练一次要一千万美元、要一千块 H800 跑五十天,这一节就告诉你:有一家公司用低得多的成本做出了同级别的效果,而且七天内被一亿人用上。书的第二、三章一直在论证「只有大玩家能上桌」,第八章(技术意义上的第八节)却亲手把这个论证撕开一个口子。
可惜作者没有顺着这个口子往下问。他讲了 DeepSeek 2023 年 11 月先做 DeepSeek Coder、基于开源 Llama 架构起步、同月发布 670 亿参数的 DeepSeek LLM,讲了效率革命的路径,但没有回答那个最有价值的问题:如果效率可以这样提升,那「算力即壁垒」这个前提还站得住吗?他绕开了,因为一旦回答,第四章的整套推荐逻辑就要重写。
这是我的判断,也是我读这一节时最不舒服的地方:全书最好的一块材料,被放在了最不该放的位置——它应该在第 3 章的开头,用来推翻第 3 章的标题。
五、第三章只用 35 屏,下了一个很大的判断
第三章叫「机遇研判:大模型成为生产力,时机已到」,35 屏,占 13.3%,是四章里最薄的一章。薄不一定是坏事,但这一章薄得有点不对——因为书名承诺的「商业机遇、产业变革」全在这一章里,而它只给了 35 屏。
它真正的论证在 p0174。作者从「要想富,先修路」讲起,说人类两百年的人均 GDP 突然爆发式增长,靠的是三次工业革命带来的基础设施升级,然后给了全书我最认同的一段判断:
前两次工业革命——蒸汽机和电力,改变了人类体力的赋能;第三次工业革命——信息革命,在一定程度上开始辅助脑力工作,但依然扮演着工具的角色。而人工智能以及最近大模型的出现,在很大程度上正从辅助脑力的角色,向代替脑力的角色演变。这和之前每一次的工业革命都截然不同,会彻底改变所有行业。
这段话有分量,因为它给了一个可检验的坐标:以前的技术是延伸你的手和眼,这次的技术替换你的判断。「辅助」和「代替」之间那条线,才是所有焦虑的真实来源——不是「AI 会不会取代我」,是「我这份工作里,有多少比例是判断,多少比例是执行」。执行那部分先被拿走,判断那部分留着,而这个比例每个人都不一样。
可惜这个坐标提出来之后没有往下走。接下来的「便捷享用新型人工智能基础设施」14 屏,讲的是云、算力、模型服务怎么像水电一样买;「大模型和中国产业结合的时刻」只有 3 屏,用的是毛竹和解放牌汽车的比喻;「技术革命时常产生于危机中」5 屏,基本是宏观叙事。一个这么大的判断,论证只用了不到 8 屏,其余全是铺陈。
我的看法是:这一章是全书最该写厚、结果写得最薄的一章。因为它要回答的问题——「为什么是现在,而不是明年、不是五年前」——恰恰是读者最需要答案的。而作者的答法是「历史类比 + 基础设施论」,这在演讲台上很有效,在书里就变成了不可验证的断言。等到第四章给出结论「所以要选全栈平台」时,中间那座桥其实是没有的。
六、从第 198 屏开始,它换了身份
第四章叫「抓住红利:大模型带来技术平权」,67 屏,占 25.4%。这一章的开头还在讲道理:技术栈变了、门槛降了、从「最后一公里」缩短到「最后一百米」。p0210 有一句话写得挺动人——「未来的编程过程,就是一个人表达愿望的过程」。
但读到 p0210 的后半段,语气就变了。作者开始谈「可以借鉴的思考」:优先选择具备面向企业全栈服务能力的企业,包括从算力平台、基础大模型到模型开发和应用开发平台在内的全栈能力,「只有基于这样的能力,创新才能更快,成本才能更低」。
这句话本身没错。问题是它长得不像判断,更像招标文件的资格条款。而且这条建议在 p0080 已经出现过一次了,那里的原话是:
「卷」大模型,不如「卷」应用。对于用户而言,应谨慎选择大模型产品,优先选择技术实力、资金实力以及整体盈利能力靠前的大公司,从而避免因大模型供应商的问题(例如在竞争中掉队、产品更新停滞等),而影响自身业务运营。
「整体盈利能力靠前的大公司」——这句话放在任何一家云厂商的 PPT 里都成立。但放在一本书里,它就需要一个脚注:说话的人所在的公司,正好是这句话的受益者。而作者在同一页把「百度」和「DeepSeek」并列为「两个重要的行业参与者」,这个并列本身也是一种修辞——一家是提建议的人自己家,一家是刚用效率革命打了所有人脸的公司。
再往后就是 p0230 的四层开发模式:提示词工程 → RAG → 大模型融合业务执行的 Copilot → 自主规划与执行智能体。这个分层我很认,它讲清楚了一件事:这四层往上加的不是「聪明」,是「权限」。提示词只是让它说得像;RAG 让它答得有依据;Copilot 让它能动手改东西;智能体让它自己决定下一步干什么。每上一层,你交给它的决定权就多一分,需要设的检查点也多一分。这个视角书里没明说,但四层的顺序本身就是这个意思。
然后就是 p0240,全书最「手把手」的一页。作者举了个提示词优化的例子:你问「请列举增值税的税率」,模型会给一大段又全面又啰嗦的话,税率、适用范围、例外情况全说一遍;改成「列举增值税的税率,并按如下格式直接返回结果。税率:13%。你列举的结果是:」,输出就干净得能直接进表格。他的解释是:把大模型想象成学生,它模仿能力很强,所以你尽量给一个或多个示例。
这个技巧是对的,也确实有用。但它同时暴露了这本书的层次:全书唯一称得上「操作」的地方,是教你改写一句提问。这不是作者水准的问题,是定位的问题——它想同时服务「企业决策者」和「开发者」,结果到了要动手的环节,只能给决策者听得懂的那种动手。
然后是 p0264 那句关键的话:「在百度智能云千帆平台上,这些过程可以通过点击配置等步骤轻松完成。」
到这一句,第四章的身份就彻底清楚了:它不是一章书,它是一份售前方案。写得还挺好——政务咨询的案例很典型,一线人员工作量饱和、回复率上不去、拿私域知识文档和政策文件建库做问答助手,这个需求描述准确得像是从标书里抄的。但它没有预算、没有工期、没有验收标准、也没有「做砸了怎么办」。
七、它的短板
下面四条,是我读完这 264 屏之后认为最该说清楚的缺点。不是挑刺,是因为这本书会被很多企业拿去做决策参考,缺点得提前标出来。
第一,谈趋势靠比喻,不靠数据。p0188 那一节讲「大模型和中国产业结合的时刻」,开头是一段毛竹:「这种竹子在生长初期,地上部分生长缓慢,而在地下扩展庞大根系。竹笋一旦破土而出,短短几周就可以长到十几米高,所谓『三年不长,一夜千尺』。」接着是 1956 年的解放牌汽车、2023 年的 C919、三一重工的灯塔工厂、蓝箭航天的液氧甲烷火箭。四个例子都是真的,也都很提气,但它们证明的是「中国工业能攻坚」,不是「大模型现在就该上」——这是两件不同的事。用比喻解释技术是好文笔,用比喻论证趋势是偷懒。
第二,案例里没有失败。政务咨询、能源电力、教育个性化,三个场景全是成功叙事。全书 264 屏,我没有看到任何一个「这个项目失败了,因为数据太脏/流程没改/没人维护」的段落。而按我的经验,企业做大模型项目死掉的原因,八成在这三件事上。一本书如果只讲成的,读者就没法判断自己会不会是那个没成的。
第三,实操部分绑死在一个平台上,不可迁移。第 4 章第 3 节 36 屏,是全书的「实战」部分,但几乎每一步都落在千帆上——点几下、配一配、上传文件、选个模型。这对百度云的客户是好事,对其他人是负担:你学到的不是「怎么搭 RAG」,是「怎么在千帆上搭 RAG」。于是「技术平权」这个结论就变得可疑了——如果平权只在一个平台上成立,那它不是技术平权,是平台平权。门槛没有消失,只是从「会不会写代码」换成了「选没选对平台」。
第四,全书的乐观建立在一个没说出口的前提上。前面说过,作者把七十年低谷归因于算力不够,这就意味着今天的繁荣依赖算力持续变便宜。但全书没有一页讨论能源、没有一页讨论推理成本随用量的线性增长、没有一页讨论「如果电价涨了会怎样」。第三章讲「大模型的波折与前行」只有 8 屏,大部分在讲 Gartner 曲线一类的通用框架,没落到成本曲线上。这是最该被补上、也最难被作者补上的一块——因为补上它,第四章的乐观就得降调。
八、怎么读这本书:给三类人的建议
如果你是开发者或者技术负责人:只读第二章,特别是 p0030、p0050、p0116、p0136 这四页,再读 p0230 的四层分层。这五页加起来不到半小时,能给你一套在会议上讲得清楚的框架。第四章可以不读,你要的东西在官方文档里更准。
如果你是企业里负责选型的人:读第三章和第四章程的前半,但把每一条建议都反过来问一遍——这条建议对谁说最有利?p0080 说「优先选盈利能力靠前的大公司」,这句话该配一个脚注。真正该问的问题不是「选大公司还是小公司」,是「我的业务如果三年后要换供应商,迁移成本有多大」。
如果你是想搞清楚这波到底怎么回事的普通人:读 p0050 和 p0149 这两页就够了。前者告诉你这件事为什么贵,后者告诉你它为什么突然不贵了。这两页之间的张力,才是 2025 年真正的故事,而这本书把它拆开放在了相隔 99 页的两个地方。
最后说一句公道话。这本书的技术部分不是拼凑的,自序里作者写自己 1997 年考进华北电力大学计算机专业、2001 年去清华跟陆玉昌教授读研、2004 年到香港科技大学跟杨强教授做人工智能方向的博士——这条履历解释了为什么第二章写得像内行:他确实是内行。问题不在他懂不懂,在他写这本书的时候,坐在哪个位置上。
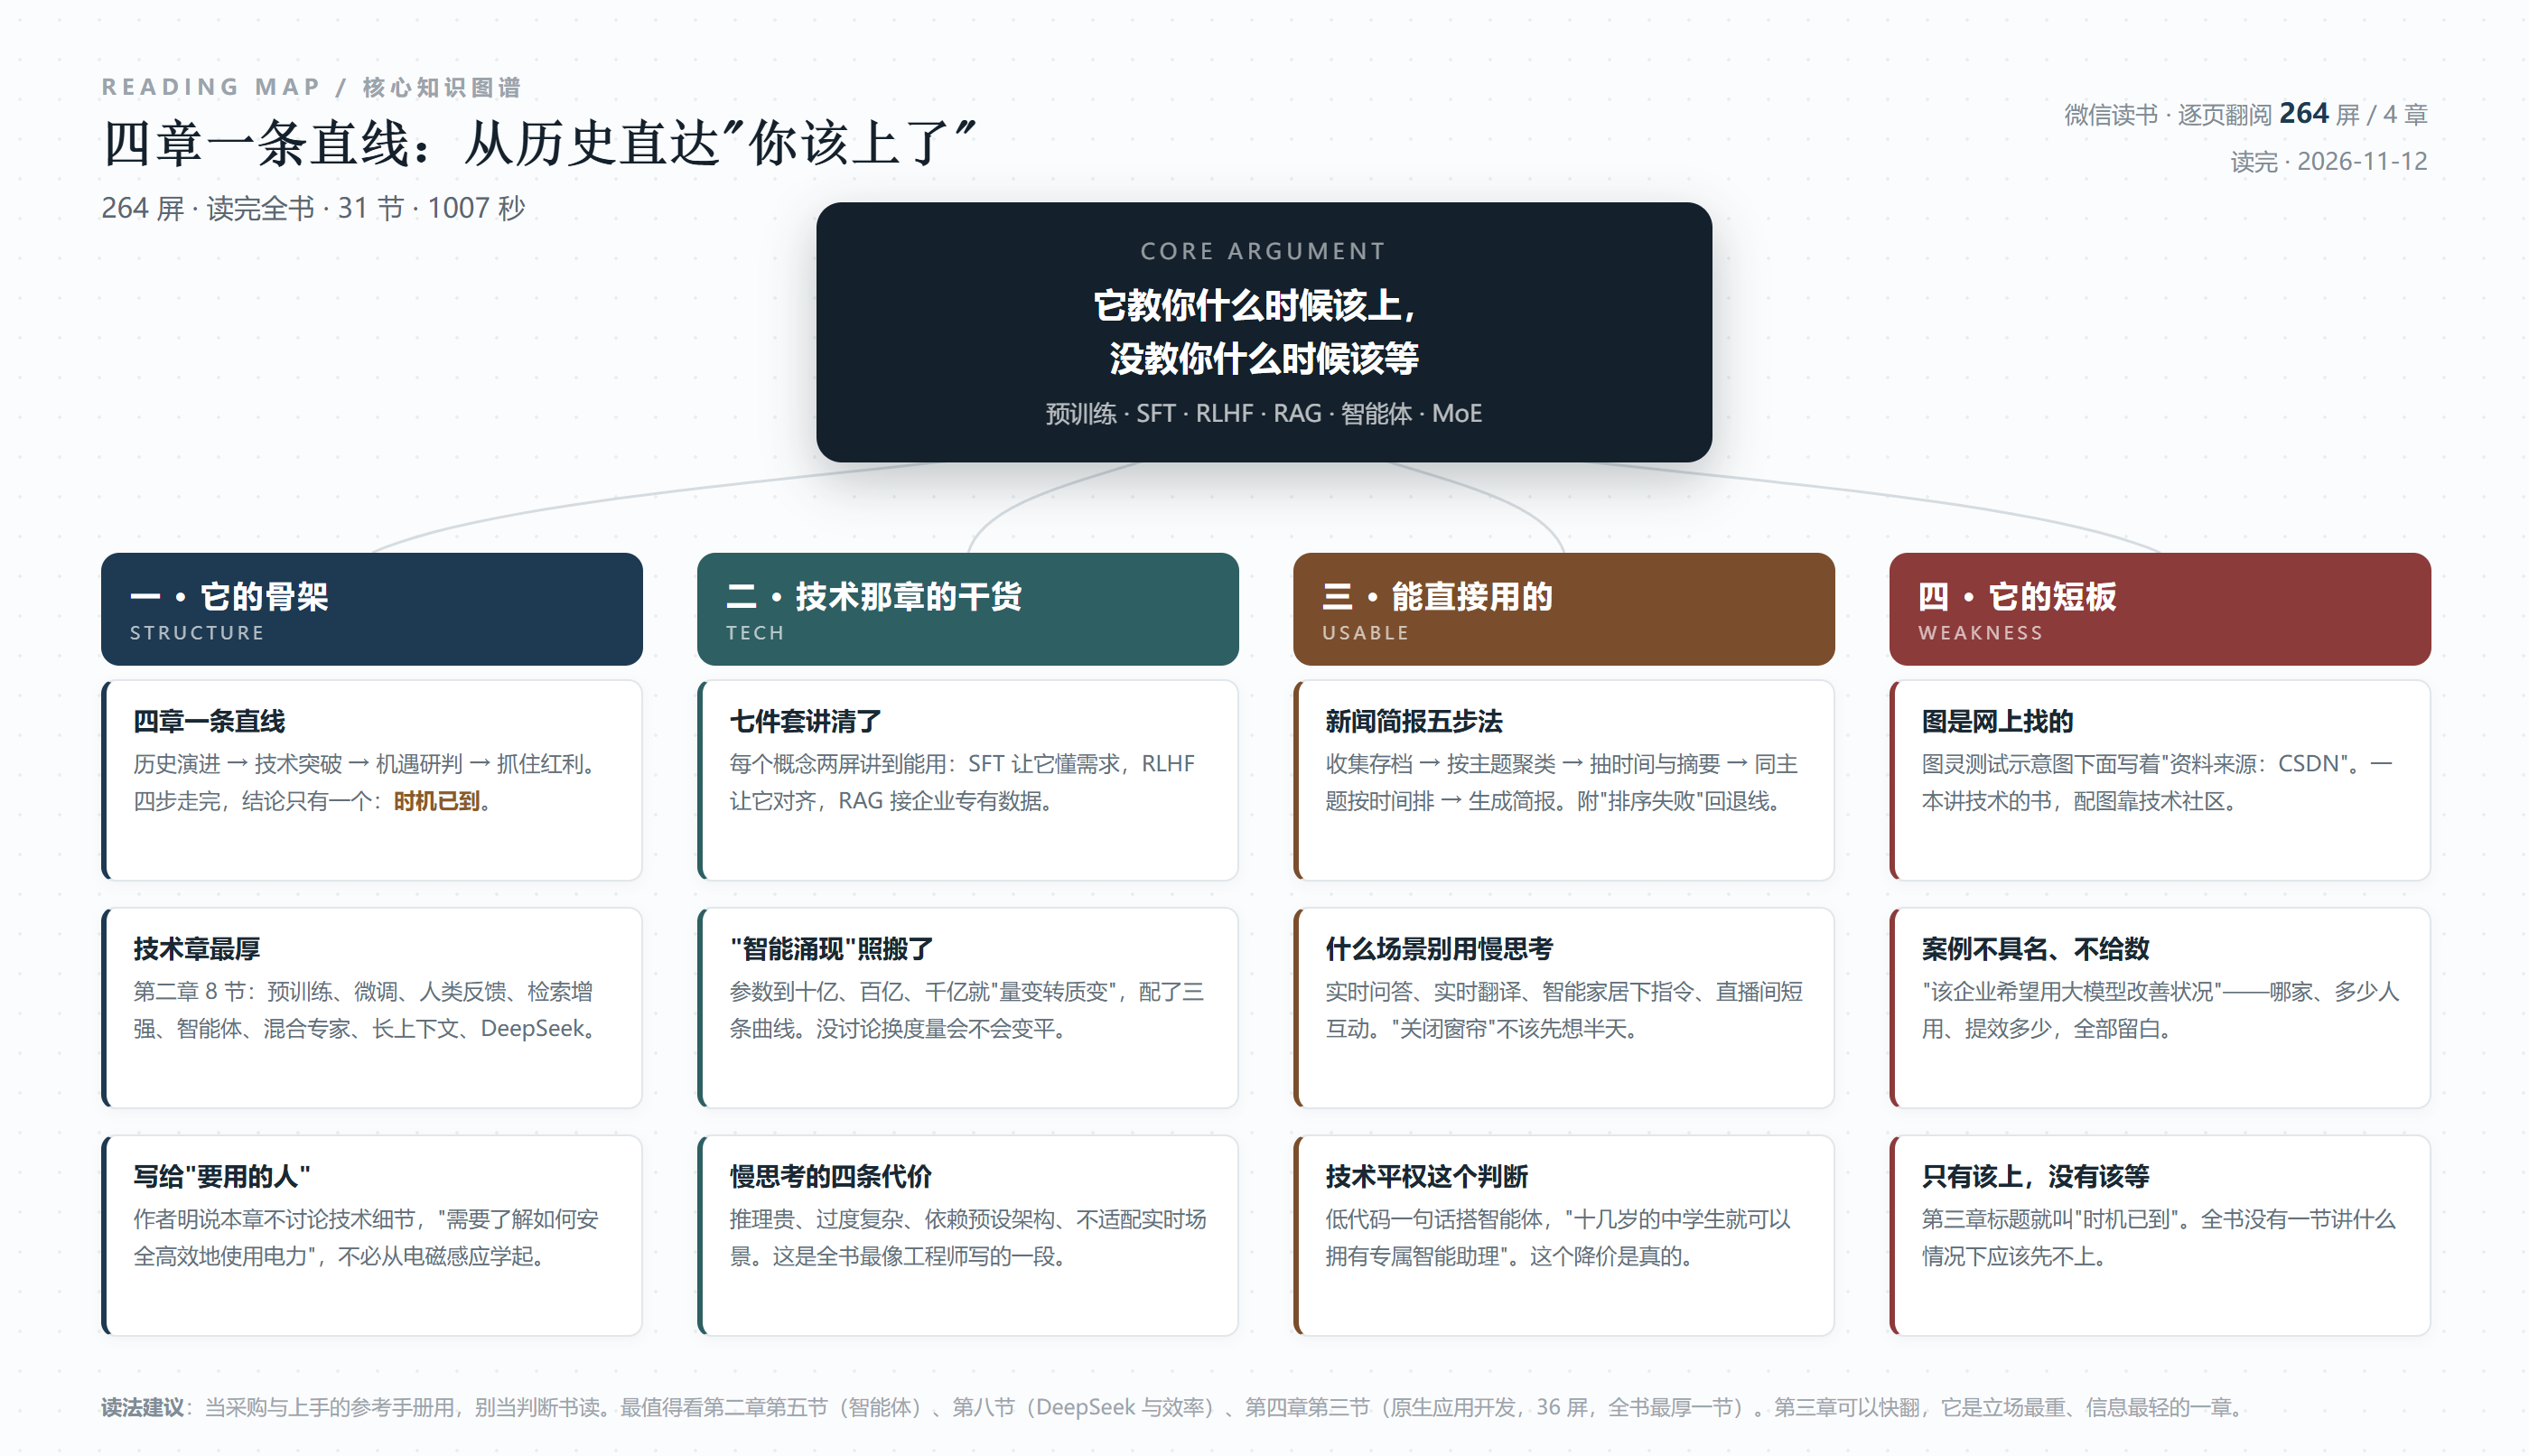
264 屏读下来,我的判断是:它把技术讲成了工程,把选型讲成了推荐——前半本值得划线,后半本值得划问号。
阅读记录
书名:大模型浪潮:商业机遇、产业变革与未来趋势 | 作者:沈抖 | 平台:微信读书 | 翻阅:264 屏(未读完,停在 p0264 / 第四章第三节实践案例)
抓取耗时约 720 秒 | 章块 29 个 | 屏数分布:前置推荐与自序 20(7.6%)· 第一章 历史演进 66(25.0%)· 第二章 技术突破 76(28.8%)· 第三章 机遇研判 35(13.3%)· 第四章 抓住红利 67(25.4%,未完)
抽读核对页:p0003 重磅推荐 / p0006 推荐语 / p0018 自序 / p0030 莱特希尔报告 / p0050 算力三数 / p0070 人机交互 / p0080 百模大战 / p0125 智能体 / p0136 混合专家 / p0149 DeepSeek / p0174 新型基础设施 / p0188 产业结合 / p0210 MaaS / p0230 四层开发 / p0240 提示词优化 / p0264 RAG 与政务案例
说明:抓取在 p0265 连续三次渲染超时(页面被压成 2953px 短页、按钮消失)后停止,后续章节未取到;本篇结论只覆盖上述 264 屏,不引用书外材料,页码可在原书直接核对。
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: