
大模型浪潮:它教你什么时候该上,没教你什么时候该等
阅读提示:全书 264 屏、4 章、31 节,从版权页翻到最后一面,抓取 1007 秒。结尾停在 p265 连续三屏渲染失败,但这本书总页数就是 264 屏,所以算是读完了(end_reason=render_stall,而非 last_page,我如实标出来)。引句标了页码,可以复查。
先说结论:这是一本合格的上手手册,也是一本不合格的判断书。它把"大模型能干什么、怎么接进业务"讲得清楚,甚至有点教科书式的整齐;但它从第一页到最后一页只有一个结论——时机已到,你该上了。至于什么时候该等,全书没有一节讲。
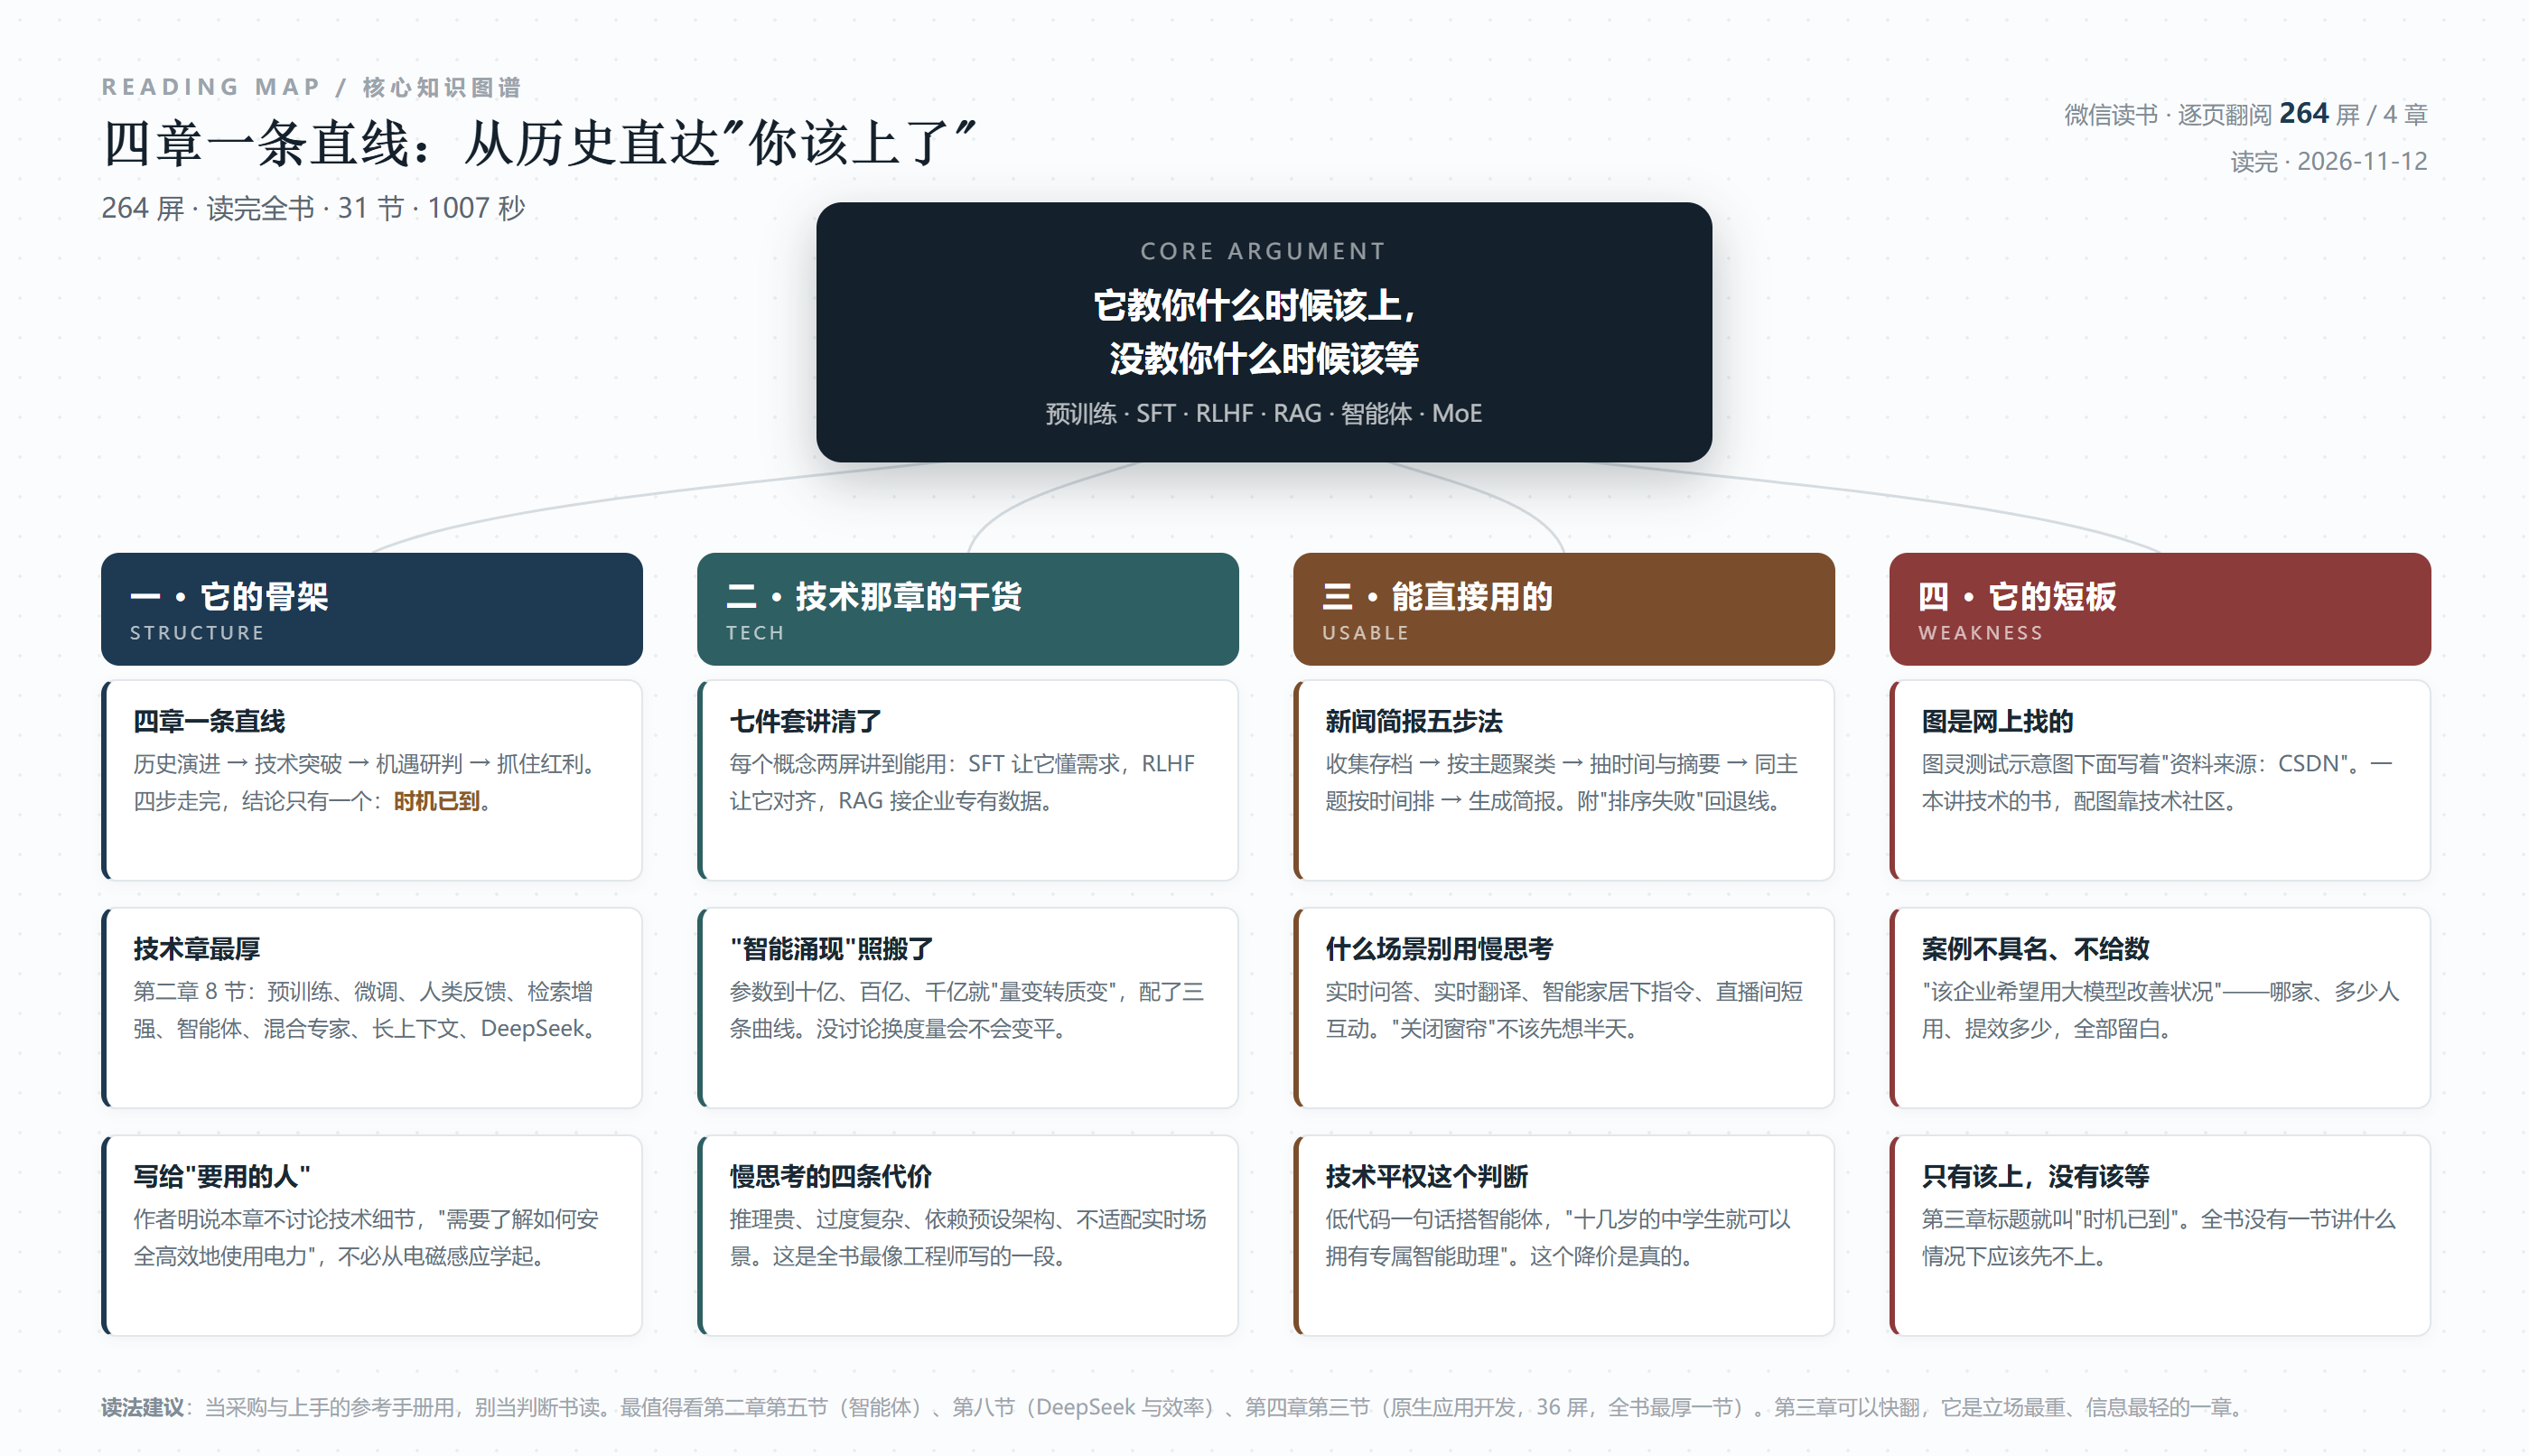
这个"只有一个结论"不是我瞎猜,你看它的四章标题就明白了:第一章"历史演进:大模型带来人工智能应用拐点",第二章"技术突破:大模型为何更具有商业化价值",第三章"机遇研判:大模型成为生产力,时机已到",第四章"抓住红利:大模型带来技术平权"。历史→技术→机遇→红利,一条直线,中间没有一个岔口。
一、它的水平,看第二章就够了
这本书真正的技术含量集中在第二章,8 节,一节一个概念:预训练、有监督微调、人类反馈强化学习、检索增强生成、智能体、混合专家模型、长上下文、DeepSeek。
这种写法有一个明显的好处:每一节都能让你在十分钟内知道这个东西解决什么问题、代价是什么。它不是论文,不推导公式,但它会把边界告诉你。比如 p0160 讲慢思考(推理型)模型,先列四条代价:部署和运行时推理成本较高;存在过度复杂化的风险——"即使面对'1+1 等于几'这样简单的问题,慢思考推理型大模型也会进行深度思考";依赖预设的逻辑架构;如果训练过程中模型的推理能力没有适配真实问题场景,整个推理过程就可能出错。
然后它给了两端清单。适合的场景:复杂任务的学术研究、代码开发中的编程问题、数学类的复杂计算、深度分析和推理问题。不适合的场景它写得更具体:一是实时性要求较高的任务,比如即时问答或实时翻译;二是决策类场景和任务,尤其是智能硬件的决策任务;三是短文本理解类任务。
紧接着是全书我最喜欢的一个例子:如果对智能家居设备下达"关闭窗帘"的指令,模型没有直接运行,而是先思考半天,再回复"当前是白天,阳光特别好,多晒太阳有助于屋内杀菌,建议你保持窗帘打开",这显然不符合用户的需求。还有直播间的例子——有用户评价"产品很棒,我非常喜欢",智能运营助手需要立刻互动,但如果思考十几秒再回复"谢谢",效果就比较差。
这两个例子比十条原理有用。因为它们把"能力边界"翻译成了"你会被用户骂的场景"。我读这一段的时候立刻想到自己那些"什么都想加个思维链"的冲动,确实该收一收。
二、它把"智能涌现"照搬了,我不太同意
p0052 有一段,讲的是这本书里我唯一想举手反驳的地方。它说:在模型参数规模比较小的时候,随着参数变大,效果提升并不明显;但在参数规模达到十亿、百亿、千亿级别时,智能水平会从量变转化为质变,各类任务的效果出现了明显的拐点,"这也被科学家称为'智能涌现'"。配图是三张曲线,横轴参数规模,纵轴准确度,在某个点上突然抬头。
问题在于:这条曲线是"度量方式"的函数,不是"能力"的函数。我前两天读另一本讲多模态的书,里面有一节专门算过这件事——把评价指标从"准确率"换成"编辑距离"或者 Brier 分数,所谓涌现的阶跃曲线立刻就变平滑了。也就是说,模型能力一直在平滑增长,"涌现"很大程度上是我们用了一个非线性指标造成的视觉错觉。
这本书没有提这一层。它把"涌现"当成既成事实来讲,然后据此推出"所以规模就是一切"。这个推论在 2023 年很有说服力,在 2026 年已经不太站得住了——业界这两年在讨论的恰恰是数据质量、推理时计算、小模型蒸馏,而不是单纯堆参数。一本讲"浪潮"的书,如果连浪潮的方向都还停在两年前,它就只能算一本好书,不能算一本新书。
三、那个"电力"类比,看着顺,其实不通
p0090 里作者交代了整章的写法:"如果你是非技术背景,在阅读本章时也不需要担心,本章并不会过多讨论技术细节,而是有所放矢,重点关于技术的背景、基本原理、技术特点以及带来的效果等内容。"接着他给了一个类比:
当电力时代来临时,各个企业、单位、家庭、个人等并不需要从电磁感应等原理开始了解,而只需要了解如何安全高效地使用电力。
这个类比很讨巧,也让这本书的定位变得清晰:它不是给工程师看的,是给要用的人看的。但我认为这个类比是错的,而且错得挺关键。
电是确定的。你按下开关,灯亮;电压不对,断路器跳闸。你不需要懂麦克斯韦方程,也能安全用电,因为电的失效模式是物理的、可预测的、有保险丝的。
大模型不是确定的。同一个提示词,今天给你一个答案,明天给你另一个;它会在没有任何提示的情况下编一个看起来很像的假数据;它的错误不带报错信息,只带自信。你不懂它的原理,就判断不了它什么时候在胡说——这不是"安全使用"的问题,这是"没法验收"的问题。
所以"不必从电磁感应学起"这句话,用在大模型上会导出错误的结论。对大模型来说,你不需要懂反向传播,但你必须懂它为什么会错、错在哪种任务上、错了怎么发现。这本书在第二章给了不少"为什么",这是它的功劳;但它在开头用电力类比把"懂原理"这件事轻轻放下了,这是它的责任。
四、案例全是"某企业",这是这类书的通病
p0245 有一段讲新闻简报的落地:某企业发现同一标题但来源不同的新闻信息有歧义,时间脉络梳理难,报道时间先后顺序混乱,想梳理事件脉络耗时费力,形成简报效率低下。解决方案是通过提示词来解决,步骤是:从公开的新闻媒体中收集信息存档;按照主题对新闻信息进行聚类;抽取新闻时间、摘要基础信息;同一主题的新闻按照时间排序;同一主题的新闻由大模型形成简版。流程图里还画了"排序失败"的回退分支。
这段是全书最有工程感的一处——因为它画了失败分支。大多数人画流程图只画成功路径,肯画"排序失败→重新排"的人,是真的跑过。
但问题也在这里:它通篇都叫"某企业"。哪家、多少人用、上线前后各花多少时间、返工几次、成本多少,全部留白。全书没有一个可以复核的数字。我理解这有保密原因,但一本讲"商业化价值"的书,通篇不给商业数据,就像一个讲健身的人只给你看动作、不给你看体重变化——动作可能都对,但你没法验证。
还有一个小细节,我翻到的时候愣了一下:p0026 那张图灵测试示意图,图下面写着"资料来源:CSDN"。一本讲技术演进的书,核心概念的配图来自一个技术社区。这不影响内容正确性,但它暴露了这本书的生产方式:它是编出来的,不是研究出来的。编得好也是一种本事,第二章确实编得清楚;但你得知道自己在读什么。
五、它的短板
第一,立场先于论证。四章标题连起来就是一句广告词,全书没有一节讨论"什么情况下不该上大模型"。第三章甚至有一节叫"技术革命时常产生于'危机'中"——这种句式的作用不是解释,是催促。
第二,技术判断停在两年前。"智能涌现"不加辨析地照搬,参数规模决定论没有被质疑,DeepSeek 那一节(14 屏)讲的是效率革命,但没有把它对"堆算力"路线的颠覆讲透。它记录了浪潮,没有解释浪潮为什么会转向。
第三,案例匿名,数据缺失。前面说过,不重复。补一句:这类书对读者的真实伤害不是"讲错了",是"让你以为别人都跑通了"。你看到"某企业用大模型把简报效率提升了",你会觉得自己落后了;但你不知道那家企业投入了几个人、跑了多久、最后有没有弃用。
第四,推荐序的分量超过正文。开篇有三篇推荐序,其中蒋涛那篇提到沈抖博士提出"算法—算力—数据"的黄金三角和"智能体即服务"。这些概念在正文里被反复引用,但都没有展开成可验证的论证。序里的判断力,比正文强。这是一个尴尬的信号。
六、谁该读,怎么读
要给公司做 AI 落地的中层:值得买,但只读第二章和第四章。第二章帮你把七个技术名词和它们的边界搞清楚,第四章(尤其第三节 36 屏)讲原生应用怎么开发,是全书最长也最实的一节。读完你能在会议上听懂供应商在说什么,也知道该问哪几个问题。
技术负责人:可以快翻。你会发现它讲的东西你都知道,唯一的收获是"原来可以这样跟老板解释"。
想判断"该不该上"的人:这本书帮不了你。它默认你已经决定了要上,只教你怎么上得好看。
最后一句话:这本书的价值,在于它把"浪潮"讲成了一份可以照着做的清单;它的局限,也在于它只讲浪潮,不讲退潮。而在 2026 年,比"怎么上"更值钱的问题,是"什么时候该停、什么该撤、什么根本不该开始"。这个问题,得由你自己带着这本手册去回答。
阅读记录:微信读书《大模型浪潮:商业机遇、产业变革与未来趋势》,沈抖博士著。全书 264 屏、4 章、31 节,逐页翻完(书共 264 屏,p265 起无内容,抓取停在 render_stall),抓取 1007 秒。逐字核对页码:p0006(推荐序一,蒋涛)、p0026(图灵测试示意图,资料来源 CSDN)、p0052(智能涌现与缩放曲线)、p0090(电力类比与本章写法)、p0160(慢思考模型的代价与适用场景)、p0200(技术平权与千帆平台)、p0245(新闻简报五步法)。2026-11-12。
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: