
具身智能:讲清了机器人的身体,没算清它的账
微信读书《具身智能:从虚拟 AI 到现实 AI》(杜雨、张孜铭 著)· 逐页翻阅 65 屏 · 前言 + 四章
抽样说明:这本书的骨架很清楚,我按骨架抽——前言(p0006)、感知与认知(p0013、p0019)、厂商表与成本(p0024)、核心零部件份额(p0027)、政策表(p0030)、AIGC 与多模态(p0035)、智能体(p0040)、Sim2Real(p0043)、自动驾驶技术史(p0052)、十年后的街景(p0060)。另有 p0010 那页「火腿肠的三个维度」,是我见过讲具身感知最省力的例子。
两件必须说清楚的事。第一,这本书我没读完:读到第四章第三节(自动驾驶的应用前景)时,本机有另一个抓取进程在抢同一个浏览器页面,我的阅读位置被重置回「序」,随即停止,所以止于 65 屏。第二,抓取期间有 6 张截图是空白的(p0007、p0008、p0016–p0018、p0022),都是章节切换瞬间的加载画面,我没有拿它们充当证据。本篇所有判断只覆盖这 65 屏,页码可对照原书核对,不引用书外材料。
先说一句可能让作者不太高兴的话:这本书最好的部分,是它开篇的那个比喻;而它最大的问题,是它此后一直没有回到这个比喻上。
前言里,作者写了一段我认为值回书价的话:
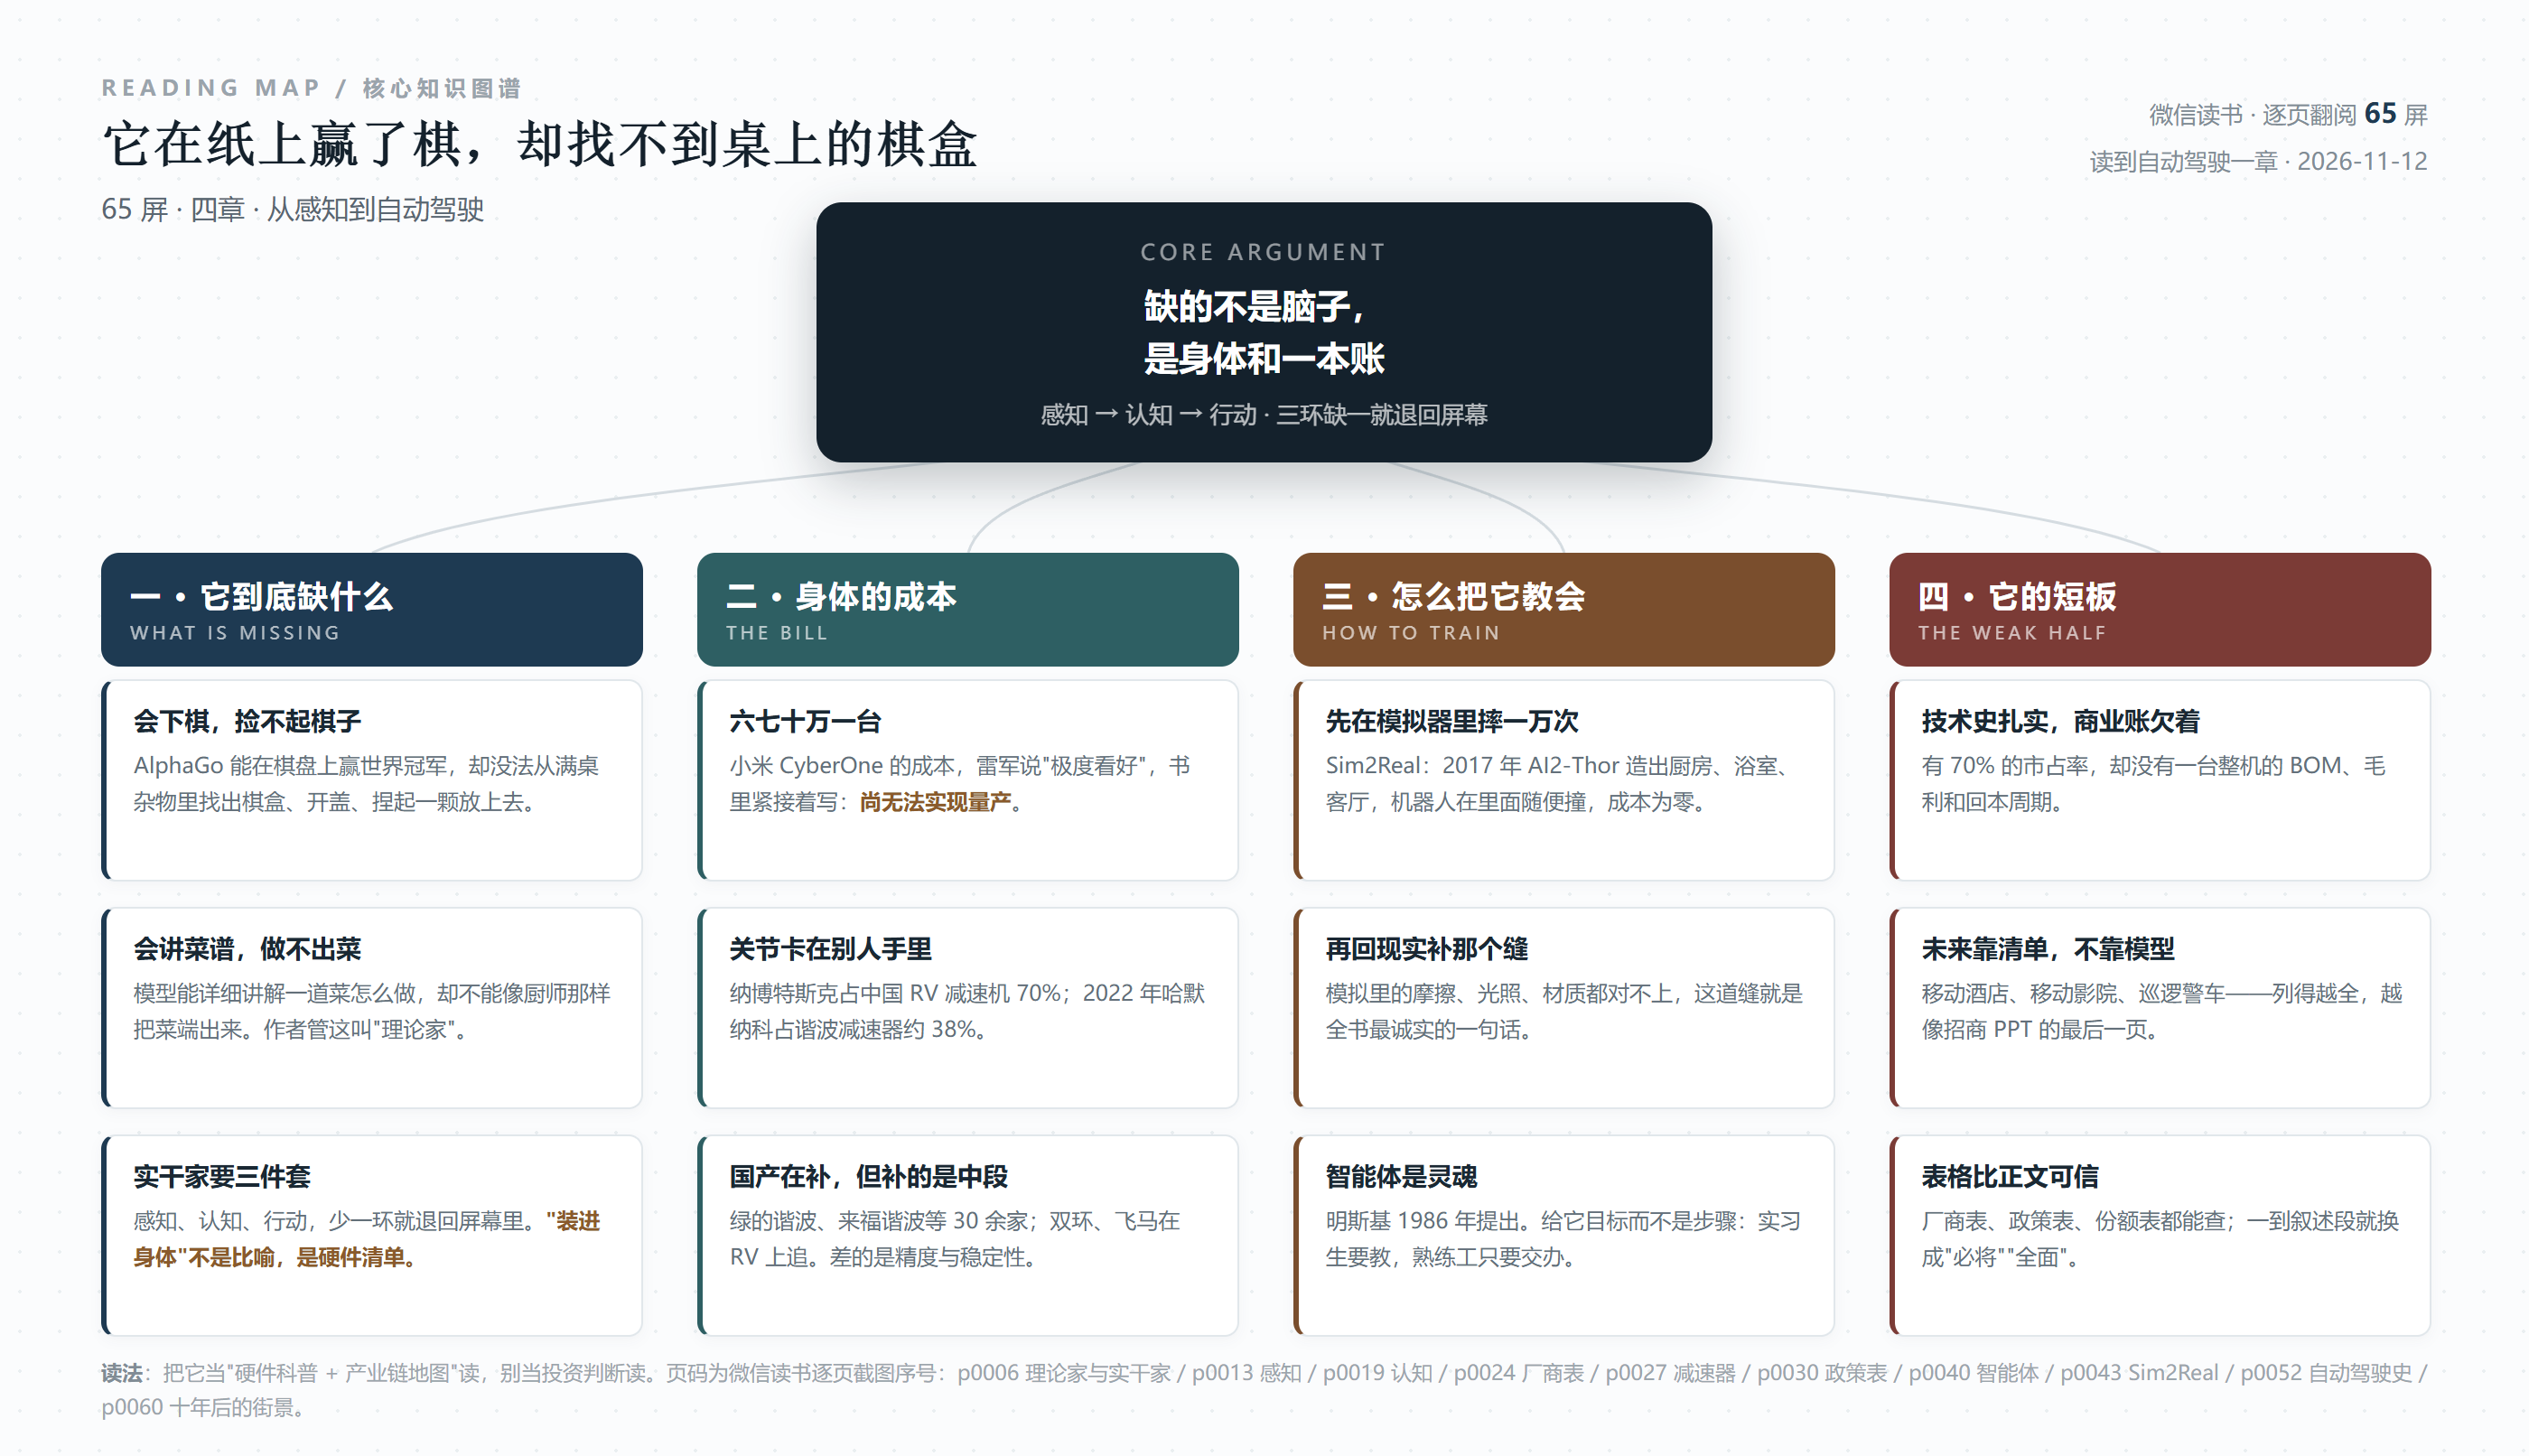
举例来说,虽然 AlphaGo 的围棋实力很强,但如要它从桌上繁多的物品中找到棋盒,打开盖子,拾起一颗棋子放在棋盘上,这种每一位棋手都能做到的事情它显然难以做到;而 ChatGPT 虽然可以详细地解答像菜谱咨询这样复杂的问题,但它并不能像人类厨师一样,根据菜谱直接为你制作一餐美味的佳肴。所以,现在的人工智能,似乎更像是「理论家」,而非「实干家」。想要人工智能不再「纸上谈兵」,就必须把它们装入现实的身体,让它们拥有与环境交互的能力。
这个对比好在哪里?好在它把「智能」拆成了两件可以分开的事:会想,和会做。过去几年所有人都在为「会想」鼓掌,这本书选择去问「会做」为什么这么难。这是个真问题,而且是个贵问题——贵到整本书后面的产业链、成本、政策、训练方法,全都是为它服务的。
一、它把「感知」讲成了一道判断题
第一章讲三件事:感知、认知、行动。真正让我停下来的是 p0010 那页的火腿肠。
作者说,计算机视觉要为具身智能搭一个类似人类的视觉体系,但人类视觉可不仅是「看见」,还要「理解看见的东西」。以厨房桌面上的一根火腿肠为例,机器要理解三个维度:
形状外观——它知不知道什么样的形状、什么样的外观的物体叫「火腿肠」,下次出现其他火腿肠的图像能不能认出来;空间关系——看到桌上摆放的火腿肠,能不能理解它的三维位置,以及如何运用机械手臂去触达;功能属性——它知不知道火腿肠的可食用属性,收到「去出发拿点吃的」这句指令时,能不能想到去抓这根火腿肠。
这三个维度一层比一层难,而且难的不是算法,是常识。第一层今天的模型做得很好,第二层勉强能用(实验室里能抓,家里抓不准),第三层基本靠猜——因为「可食用」这件事不在图像里,在人的生活经验里。一根火腿肠就把「具身」两个字讲完了:它的难点从来不是算力,是世界知识没有形状。
p0013 接着补了一个我很认的细节:模仿人类视觉的光学方案有缺陷,黑夜或者下雨天,相机就像人眼一样不太好使了,所以要模仿蝙蝠,借助各种形式的波来构建视觉——激光雷达、毫米波雷达、超声波雷达。对自动驾驶这种复杂且对环境适应力要求较高的场景,通常会采用多种视觉感知方案。
这个思路是对的,也很工程:不是让一个传感器变强,是让几个弱传感器互相兜底。这句话如果被记住,比记住任何一个模型的参数都有用。
顺便说一个书里没展开、但推荐语里点到的事。「手」比「眼」难得多。p0003 有位推荐人写:「灵巧手」是打开具身智能大门的钥匙,是机器人皇冠上的明珠,并说具身智能需要既是「灵芯」,也是「巧手」。这句推荐语写得比正文诚实——眼睛可以靠雷达兜底,手不行,手要抓起来不掉、要拧得动、要能感觉到「这个瓶子快滑了」。做视觉的人可以买现成模组,做手的人得自己磨。这也是为什么全书里所有整机成本都高:贵不在算力,贵在关节和手。
二、认知这一段,写得比感知弱
到了 p0019 讲「具身认知」,文风就变了。作者举了个房间里的例子:机器人要学会绕过椅子,或者学会推开门,每次做对了给奖励,撞到椅子就给负反馈,鼓励它下次换个方法。然后他下结论:这个学习过程就像一个调皮的孩子通过不断试错逐渐学会走路,每一次摔倒后都会更快地站起来;无论是模仿学习还是强化学习,人工智能学习的过程其实可以看作沉淀具身认知的过程。
这段没错,但它退回到了「打比方」的层次。感知那一节有火腿肠,有雷达,有可检验的三层;认知这一节只有一个小孩学走路。而认知恰恰是最难的部分——强化学习在真实世界里最大的问题是试错成本,机器人摔坏一次可能就要赔几万块,这个约束作者提都没提,直到第三章讲模拟器时才侧面碰到。
一句话:第一章的前半是好教材,后半是科普文。而全书后面所有的技术乐观,都建立在「认知能像感知一样被工程化」这个假设上,这个假设在这本书里没有被论证,只被比喻过。
三、第二章是全书最硬的地方:一张表,一个 70%
如果要我推荐这本书的一章,是第二章。它不讲道理,它给清单,而清单恰恰是这类书最稀缺的东西。
先看成本。p0024 讲小米的 CyberOne:能识别 45 种人类语义情绪、分辨 85 种环境语义,搭载自研深度视觉模组,结合 AI 交互算法可以实现人物身份识别、手势识别、表情识别。雷军说「极度看好智能机器人在生活、工作中的应用」,但书里紧接着写了一句很不给面子的话:CyberOne 的成本每台需六七十万元,尚无法实现量产。
这句话是全书信息量最大的一句。因为它把「技术可行」和「商业可行」之间的距离,用一个数字标出来了:六七十万。一台能干活的机器人,价格是一辆高配奔驰的十倍,而它一天能干的活还顶不上一个工人。所有关于「人形机器人进家庭」的想象,都要先过这道算术题。
再看产业链。p0027 讲减速器,讲得非常专业:精密行星减速器多用于机床、新能源设备、工业和服务机器人,日本新宝市场份额最大,国内厂商有湖北科峰、纽氏达特、精锐科技、利茗;RV 减速器主要用于工业机器人,2023 年该场景占到 RV 整体市场份额的 90%,而 RV 减速机市场仍被外资品牌垄断,仅纳博特斯克一家就占据中国 70% 的市场份额;谐波减速器市场集中度较高,2022 年日本哈默纳科市场占有率约为 38%,中国本土大约有 30 余家谐波减速机厂商,如绿的谐波、来福谐波等。
这段为什么值钱?因为它没有喊「国产替代」,它先给了你外资的份额:70%、38%、90%。先承认被卡,再谈替代,这才叫产业链分析。作者还补了一句更关键的判断:目前本土品牌 RV 减速机与外资品牌的主要差距,依然在于控制的精度与稳定性。这句话把「造得出来」和「装得上」分开了。
p0030 是一整页政策表,从工信部等 15 部门 2021 年的《「十四五」机器人产业发展规划》开始,一条条列发布单位、文件名称、发布时间和相关内容解读,其中提到建成 3—5 个有国际影响力的产业集群、培育专精特新「小巨人」企业。
我得说句实话:这一页表格比前面二十页正文都可信。因为它可查、可核、可反驳。而正文里那些「必将」「全面」「深刻改变」,一个字都查不了。
不过这张表也暴露了一个结构性问题:政策表里的每一条都是「支持」「攻关」「培育」,没有一条是「考核」「验收」「退出」。做产业的人看政策表,看的不是它给了什么,是它没给什么。这本书把表抄全了,却没有替读者读出这一层,这本来是行业作者最该提供的附加值。
四、第三章讲训练:先在模拟器里摔,再回现实补那道缝
第三章是我最期待的一章,因为「怎么教一个身体」才是具身智能的真问题。它给出了标准答案:Sim2Real。
p0043 写得很清楚:既然智能体是「灵魂」,而具身智能的最终目标是在现实世界中活动,那么一个训练思路是——我们是否可以先在虚拟的仿真环境里把智能体训练好,然后再植入现实世界中的设备上呢?这种仿真方法被称为「从模拟到现实」(Simulation to Reality,简称 Sim2Real)。在模拟器环境中,具身智能可以提高训练速度、降低训练成本,并可以提高整个训练阶段的安全性。
然后它介绍了 AI2-Thor:2017 年由艾伦人工智能研究所的计算机科学家构建,智能体可以在厨房、浴室、客厅和卧室等模拟场所徘徊,获取各个角度的空间视图,观察随时间变化的动态视图,完成各种全新任务。
这段写得挺克制,但漏掉了最有意思的部分:Sim2Real 的难点从来不是「模拟」,是 2Real 那个缝。模拟器里的摩擦系数、光照、材质、物体重量都是理想的,真实世界的桌面上有一层油、有一根头发、有一块不平的桌角。你在模拟里练了一万次抓取,到现实里第一次抓就滑了。这个「缝」在书里只用一句「降低训练成本、提高安全性」带过去了,而我恰恰认为它是决定人形机器人能不能落地的核心变量。
还有一个更基本的问题,书里也没答:训练数据从哪来。大模型靠互联网上的文本,几十年的存量随便用;具身智能靠的是「一个动作一个动作地做出来」的数据,得有人戴着力反馈手套去搬箱子、去拧瓶盖、去叠衣服,一小时一小时地录。这种数据没有存量,只能现采,而且采的时候还得有人在旁边看着。如果说大模型的燃料是捡来的,具身智能的燃料是自己炼的。这本书讲了模拟器能省成本,但没讲真实数据的采集成本有多重——而后者才是这个行业真正的产能瓶颈。
同一章里讲智能体(p0040)倒是讲得好。作者给了个来历:智能体最早由马文·明斯基在 1986 年提出,认为通过协商解决问题的个体就是智能体。然后是一个我很喜欢的比喻:你希望大语言模型写一个贪吃蛇游戏,你需要拆解构成、依次提问、引导它写出各模块,遇到运行不了的代码还要主动追问让它修正;而对智能体,你只要告诉它「写一个贪吃蛇的游戏」,它便自主设计结构、撰写程序、自主调试、遇到问题主动上网查资料,最终直接交付成品。如果说大语言模型像一个刚入职场的实习生,那么智能体就是一个熟练的职场专家,只需要你规定目标,它自己就能按时按质地完成相关的任务。
这个比喻好用,但它也暴露了全书的一个习惯:凡是讲不清机制的地方,就上一个比喻。实习生和专家之间差的是什么?是经验、是判断、是知道什么时候该问你一句。这三样东西没有一样是「给个目标」就能长出来的。
五、第四章讲自动驾驶:技术史写得比商业前景好
第四章转到自动驾驶,这一章的史料部分写得很扎实,值得单独说。
p0052 提到 1977 年,日本通产省(现经产省,相当于我国的工信部)下属的机械工程实验室开发出一台具备障碍躲避能力的试验车,成功取得了现代意义上第一辆自动驾驶乘用车的桂冠。它在车头安装两台摄像机和一个信号处理器,计算机视觉第一次被用在自动驾驶领域;当时的决策算法相对简单,系统内预置了 256 种场景与输入的信号值,只需要像查字典一样就能查找到对应的控制策略;凭借这套系统,试验车可以保持 30 千米/小时的速度自动驾驶。
1983 年,受日本突飞猛进的信息技术能力刺激,美国政府决定拨给 DARPA 一大笔经费,全力推动「战略计算计划」,其中陆军的项目是自主陆地车辆 ALV,激光雷达被首次装到自动驾驶车辆上用于识别障碍物特征;在最终测试中,ALV 能够绕过沟壑、陡坡等不利地形,也能绕过垃圾桶等障碍物,并达到 20 千米/小时的最高时速。参与项目的卡内基梅隆大学在项目结束后持续改进,率先引入神经网络技术,并在 20 世纪 90 年代拿到美国国防部科研经费。
这两段好在哪?好在你看到一个行业最原始的形态:256 种场景查表、30 公里时速、两台摄像机。所有今天看起来宏大的东西,起点都笨得可爱。这种细节能让人对技术保持耐心,也能让人对「十年后遍地移动酒店」这种话保持警惕——1977 年那台车到今天的无人出租车,中间隔了将近五十年,而不是十年。
但第四章的后半段就滑走了。p0060 说,在无人驾驶时代,汽车将成为可自主移动的全能空间或生产作业平台,我们可能会在 10 年后的世界中随处可见移动酒店、移动影院、移动 KTV、移动按摩店等新一代线下商业门店,也会见到无人化自主执行任务的环卫车、消防车、巡逻警车、移动储能车等新一代专业/特种用途车辆,从而迎来一个极度繁荣的具身智能汽车生态。
读到这一段,我的反应不是兴奋,是疑问:移动按摩店这个生意,解决的是「车会自己开」的问题,还是「有人愿意在车里按摩」的问题?前者是技术,后者是消费。作者把两者放在同一句话里,读者就容易误以为它们会同时发生。而现实里,决定前者的是法规和成本,决定后者的是钱包和习惯,这两件事的节奏完全不同。
六、它的短板
第一,技术与商业之间缺一本账。书里给了 70% 的市占率、38% 的份额、六七十万的成本、10 万亿的市场规模,唯独没有给一台整机的成本拆分:减速器占多少、伺服占多少、电池占多少、传感器占多少,卖多少钱、多久回本。而这本书的书名里有「从虚拟到现实」,现实的核心就是这本账。没有 BOM 的产业分析,本质上还是行业综述。
第二,未来段落是清单,不是预测。移动酒店、移动影院、移动 KTV、移动按摩店、环卫车、消防车、巡逻警车、移动储能车——一口气列了八种。清单越全,越像招商 PPT 的最后一页。真正的预测应该可证伪:说清楚哪一种会先起来、为什么是它、谁付钱、单价多少。书里没有一条这样的判断,全是「可能会」「将迎来」。
第三,结构像两本书拼起来。前三章讲的是「感知—认知—行动」这套框架,第三章还在讲智能体与 AIGC 怎么给它装脑子;第四章突然整体切到自动驾驶,前面那套框架一次都没回收。自动驾驶当然是具身智能最大的应用,但它应该作为「行动」那一环的案例,而不是另起一章重讲一遍技术史。读者读完会有一种感觉:前一半是教科书,后一半是行业报告,中间少了一页过渡。
第四,时间表不可证伪。全书反复出现「未来 10 年」「十年后」「必将」这类表述,但没有给出任何一个能被打脸的里程碑——没有说哪一年哪类场景的机器人出货量会到多少台,没有说哪一年单台成本会降到多少万。这不是苛刻:1977 年那台日本试验车跑到 30 公里/小时,到今天的无人出租车用了将近五十年;一个行业如果连「明年要发生什么」都不敢写,那它对「十年后」的描绘就只是抒情。
第五,推荐人和数据之间有点微妙。p0003 那页推荐语,署名的是凌迪科技创始人兼 CEO、进化智能合伙人、灵心巧手联合创始人——都在具身智能这条链上。这不影响书的价值,但影响你对某些句子的折扣:全书对国产替代的叙述是乐观的,而作者自己给出的 70% 和 38%,恰恰说明核心零部件还在外资手里。数据是诚实的,语气是乐观的,这两者之间的落差,读者得自己补。
七、给三种人的读法
你是做硬件或供应链的:直接读第二章,p0024 的厂商表(智元、达闼、傅利叶、宇树、逐际动力、蔚蓝智能,成立时间与业务定位都列了)和 p0027 的减速器份额,这两页能省你两天调研。第一章可以跳。
你是做算法或模型的:第一章的感知那节(p0010、p0013)和第三章的 Sim2Real(p0043)值得读,但别指望它讲清 sim-to-real gap,那里它只给了个概念。真要动手,去看仿真器文档比看这本书快。
你是想搞明白这波热闹到底靠不靠谱的:只读 p0006 和 p0024。前者告诉你这件事难在哪,后者告诉你它贵在哪。「难」和「贵」这两件事叠在一起,基本就能判断一个具身智能项目能走多远。
最后说句公道话。这本书的定位是「从虚拟 AI 到现实 AI」,它确实把「现实」那一半的物理世界讲清楚了——传感器怎么配、减速器谁在做、政策怎么给、模拟器怎么用。这些是很多同类书懒得写的脏活。它的问题不在不懂硬件,在于它太想让读者相信这件事快了。而 65 屏读下来,我看到的恰恰相反:技术路线清楚了,成本账还没算,时间表是愿望。
如果要给它一个准确的位置:它是一本合格的「具身智能入门读物」,不是一本合格的「具身智能投资指南」。这两者的区别在于,前者负责让你听懂,后者负责让你下判断。这本书做到了前者,而且做得比市面上多数同类书干净——它至少敢把 70% 和 38% 这两个数字写出来。但它没做到后者,因为它回避了所有会让人犹豫的东西:谁在亏钱、哪条路线会死、这一轮热潮和上一轮的机器人热潮有什么不同。
一句话收尾:它讲清了机器人的身体,没算清它的账——前半本可以当工具书,后半本只能当愿景书。
阅读记录
书名:具身智能:从虚拟 AI 到现实 AI | 作者:杜雨、张孜铭 | 平台:微信读书 | 翻阅:65 屏(未读完,止于第四章第三节「自动驾驶技术的应用前景」)
章块:前言 + 四章(探索具身智能的奥秘 / 具身智能机器人 / 具身智能与 AIGC 智能体 / 自动驾驶) | 有效截图 59 张,空白 6 张(章节切换瞬间的加载画面,未采用)
抽读核对页:p0006 前言「理论家与实干家」/ p0010 火腿肠的三个维度 / p0013 视觉与听觉感知 / p0019 具身认知 / p0024 CyberOne 成本与厂商表 / p0027 减速器份额 / p0030 政策表 / p0035 AIGC 与多模态 / p0040 智能体与明斯基 / p0043 Sim2Real 与 AI2-Thor / p0052 自动驾驶技术史 / p0060 十年后的街景
说明:抓取期间有并行进程占用同一浏览器页面,阅读位置被重置回卷首,故本轮止于 65 屏;本篇结论只覆盖上述页面,不引用书外材料。
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: