
Skills+OpenClaw:它讲清了“是什么”,没给“怎样算好”
阅读提示:抓取到 400 屏停下(第 8 章开头),是我把抓取上限设在 400 屏,不是书到这儿结束。所以这篇只评前七章。全书 102 节、平均每节不到 4 屏——这个数字本身也是我要说的一件事。引句标了页码。
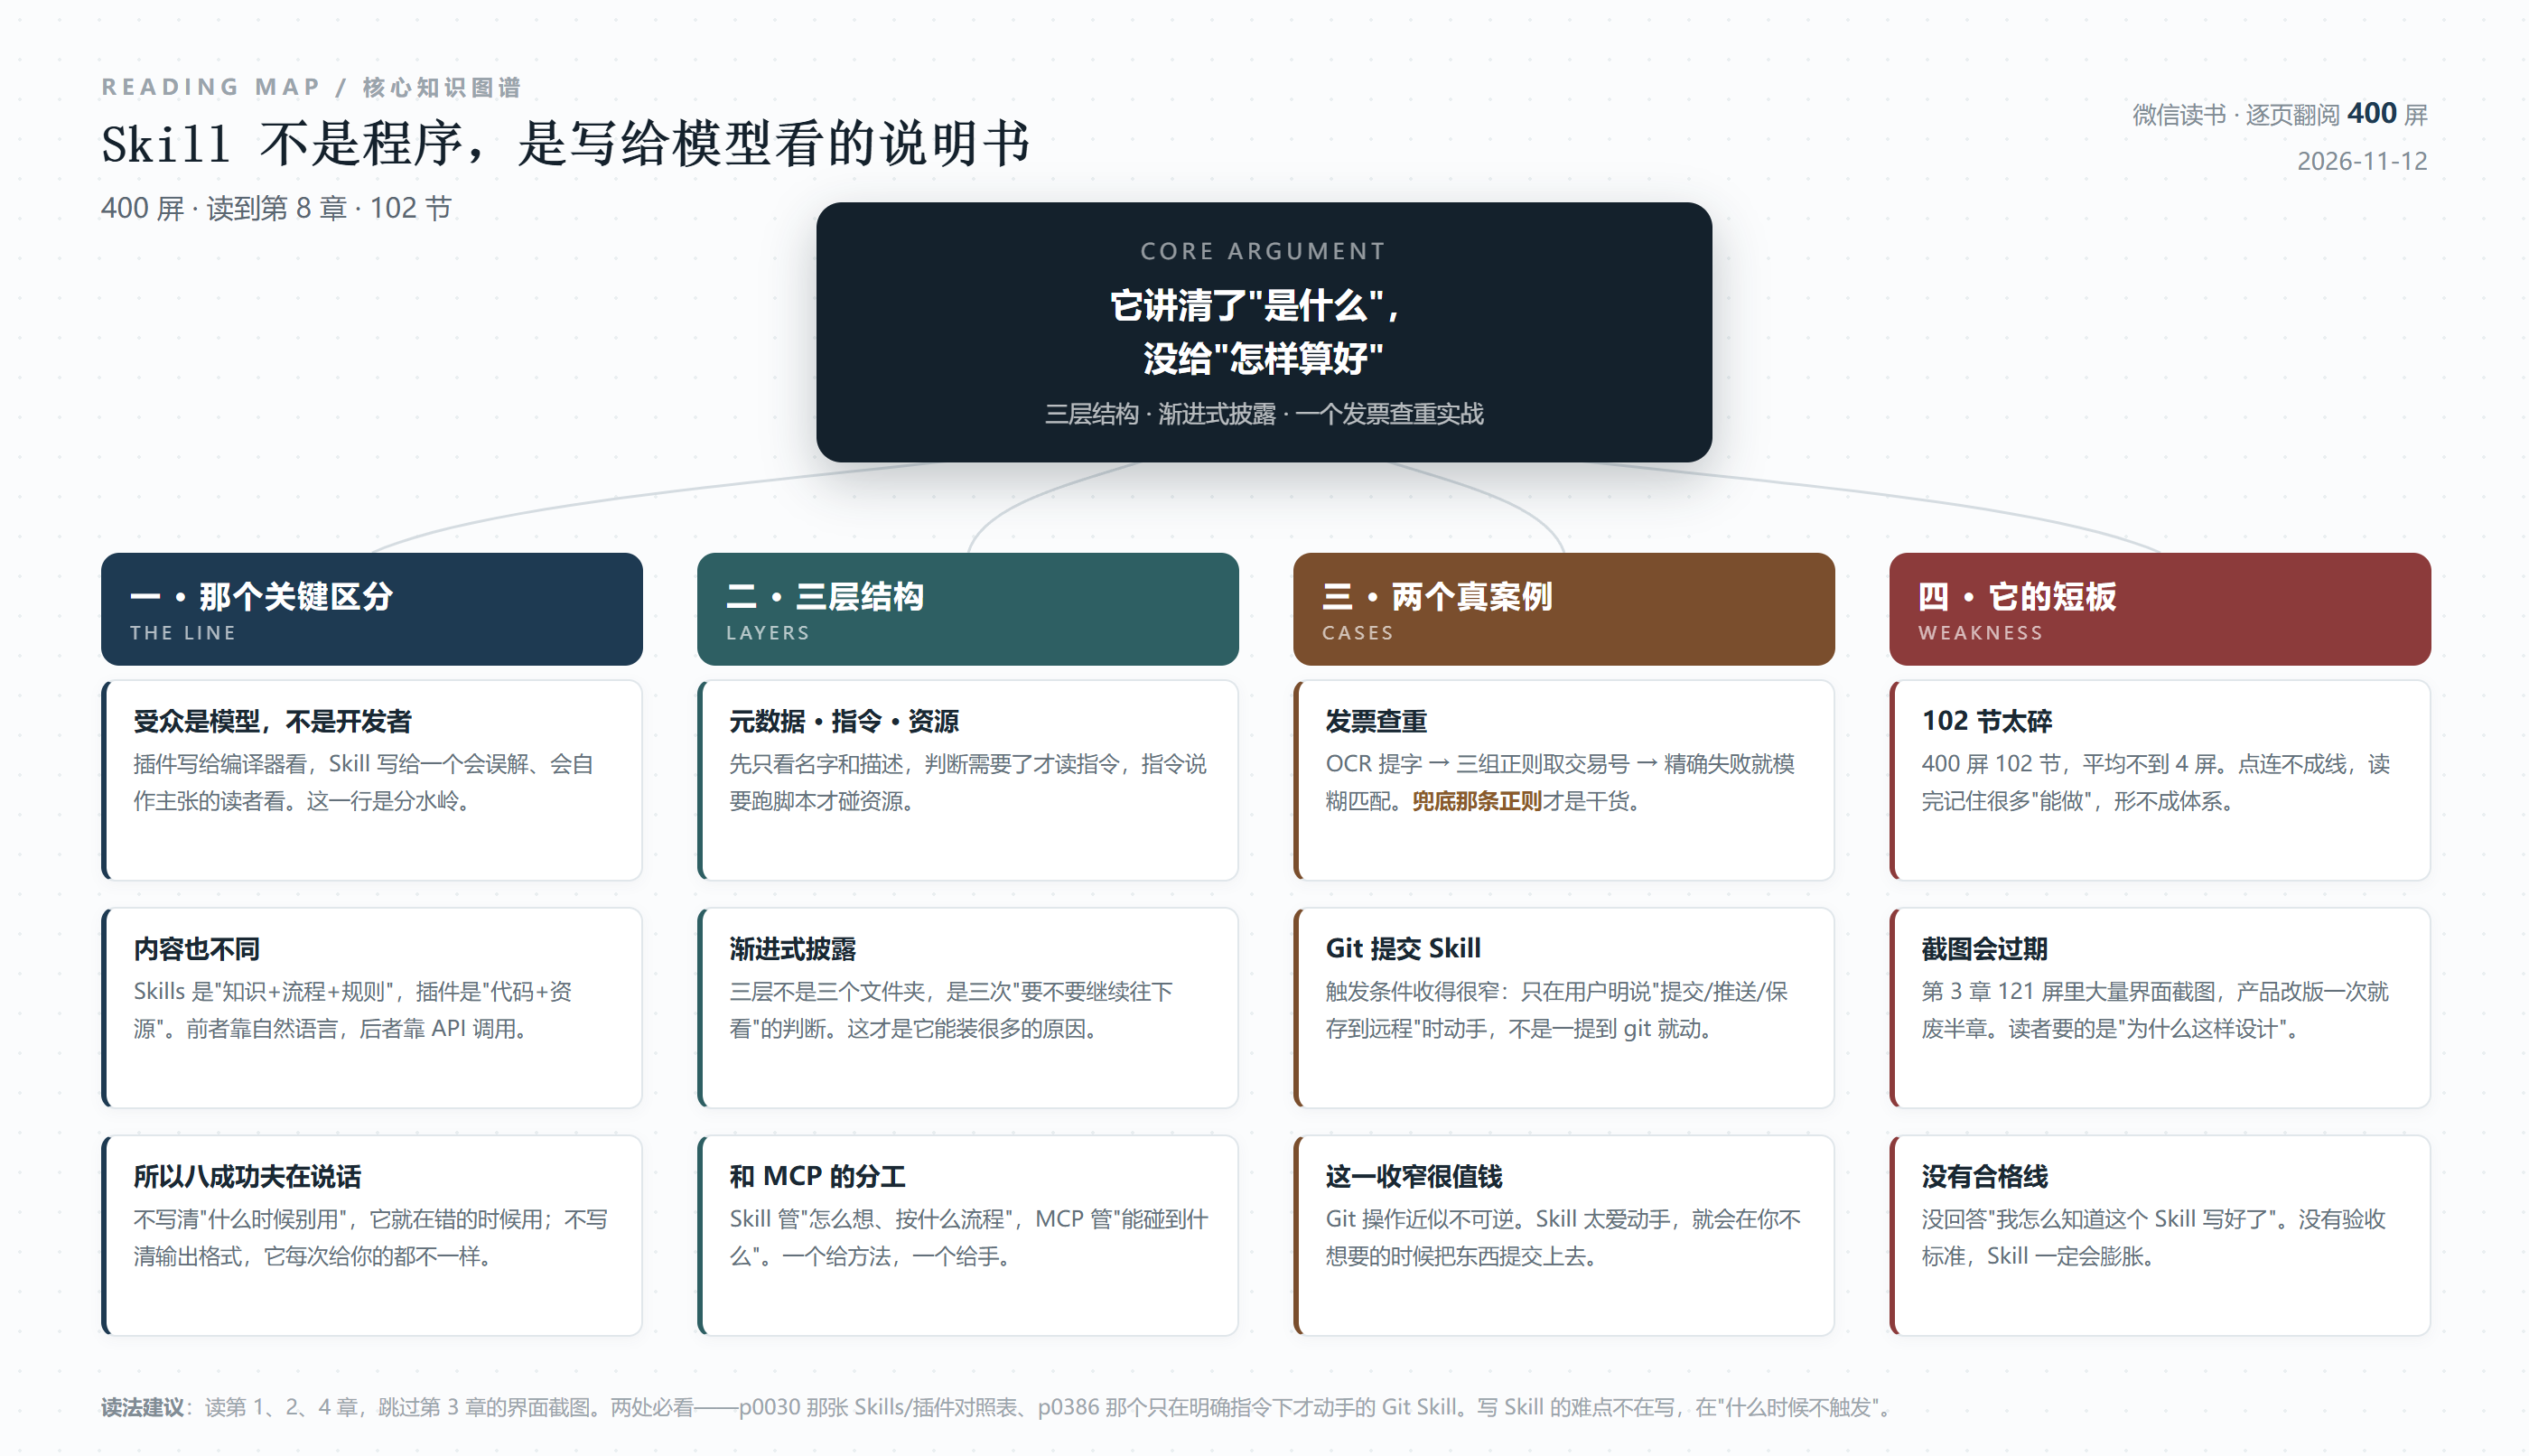
先说结论:这本书讲对了一个关键区分,也暴露了一类书的通病。讲对的是"Skill 不是程序,是写给模型看的说明书";通病是 400 屏里,截图和代码占了大半,真正需要作者判断力的地方——比如"一个 Skill 做到什么程度算合格"——反而没写。
一、全书最值钱的是那张对照表
p0030 有一张表,标题叫"Skills 与插件的区别"。六行,我一行一行抄下来:
核心内容——Skills 是"知识+流程+规则",插件是"代码+资源";执行方式——Skills 是"AI 理解指令后执行",插件是"直接调用代码";灵活性——Skills"可以动态调整指令",插件"需要重新编译";适用场景——"知识封装和流程自动化"对"功能扩展";目标受众——"AI 模型"对"开发者";交互方式——"自然语言描述"对"API 调用"。
这六行里,我认为只有第五行是真正的分水岭:目标受众是 AI 模型,还是开发者。因为受众一变,写作要求全变。
写插件是写给编译器看的:接口要对、类型要对、异常要处理,写错了编译不过。写 Skill 是写给一个会读、会误解、也会自作主张的读者看的:你不写清楚"什么时候该用、什么时候别用",它就会在错的时候用;你不写清楚"输出成什么样",它每次给你的格式都不一样。所以写 Skill 的功夫,八成在"把话说清楚",不在"把代码写对"。
这也解释了一个很多人踩过的坑:程序员写 Skill,最容易写成 README——结构漂亮、术语准确、但没有一句告诉模型"遇到 X 情况就停下"。而写文档出身的人反而上手快,因为他们习惯想"读者会在哪一步卡住"。
二、三层结构:元数据、指令、资源
书里把 Skill 拆成三层:元数据层、指令层、资源层,并配了"渐进式披露"的加载机制(内容提要 p0006 里就说了"详细剖析 Skills 的元数据层、指令层、资源层设计,以及'渐进式披露'的加载机制,让复杂概念一目了然")。
这个拆法是对的,而且它解释了一个很实际的问题:为什么 Skill 可以很多,却不把上下文撑爆。因为一开始只加载元数据(名字、一句话描述、什么时候用),模型判断需要了,才去读指令层;指令层里说"跑这个脚本",才去碰资源层。三层不是三个文件夹,是三次"要不要继续往下看"的判断。
第 4 章把三层分别怎么编写讲了一遍(4.2.3 指令层编写、4.2.4 资源层编写,两节各占 10 屏左右)。资源层那部分给了一个完整例子(p0250):发票查重 Skill。它先用 OCR 把图片里的文字提出来(pytesseract.image_to_string(image, lang='chi_sim+eng')),再用三组正则去匹配交易号和票据号("优先精准匹配,兜底匹配长数字串",兜底那条是 r'\d{20,30}'),最后用 SequenceMatcher 算字符串相似度,解决 OCR 误识别导致的比对失败。
这个例子选得好。好在它不炫技:三组正则 + 一个相似度算法,就是真实世界里"够用"的工程解。而且它把"为什么要兜底"写在了注释里——OCR 会认错字,认错了精确匹配就全废,所以要有一层模糊匹配接住。这种细节,编是编不出来的。
三、它连"让 AI 提交代码"都写成了一节
第 7 章讲 Skills 在开发流程里的用法,其中 7.5 是"Skills 辅助代码版本管理",配了一个叫 Git-Pushing 的 Skill。p0386 展示了它的功能边界:用户明确要求推送更改("push this""commit and push");提到保存工作到远程("save to githb""push to remote");完成功能开发并希望分享时;使用类似"let's push this up""commit these changes"的短语。
然后是用它:在对话框输入"暂存所有更改",Skill 收到指令后读取并分析当前项目的 Git 状态,检测所有已修改但未暂存的文件,自动把这些文件的更改全部添加到暂存区;完成后界面显示操作成功提示,并列出当前状态——分支 main、已暂存文件约 100+ 个、修改的文件 4 个、新增的文件包括 PDF 处理脚本、文档、前端项目、各种 skills,最后给"下一步操作"的建议。
我读这一段时注意到一个小细节:它的触发条件写得很收。不是"用户提到 git 就用",而是"用户明确要求推送/提交/保存到远程"才用。这个收窄很关键——因为 Git 操作是不可逆的(至少对普通用户是),一个 Skill 太爱动手,就会在你不想要的时候把东西提交了。
这一点,恰好是很多 Skill 作者会忽略的:写清楚"什么时候不要触发",比写清楚"什么时候触发"更重要。书里在 Git 这个例子上做到了,但在其他案例上没有系统讲这个原则——这是我下面要说的短板之一。
四、它的短板
第一,102 节、400 屏,平均每节不到 4 屏,碎片化严重。这不是排版问题,是结构问题:一节讲一个点,点与点之间不连成线。读者读完会记住很多"这个可以做",但很难形成"我该怎么设计一整套 Skill 体系"的判断。章节越细不等于越清楚,有时候只是把一本书写成了 102 篇推文。
第二,截图和代码挤掉了判断。我按章统计了 400 屏:第 3 章 121 屏(30%)是全书最厚的一章,第 1 章 56 屏,第 4 章 49 屏。而第 3 章里有大量界面截图——展示卡片长什么样、点开 Markdown 文档是什么效果、下载按钮在哪(图3-49、图3-50、图3-51 这一类)。界面截图的问题是它会过期。产品改版一次,半章内容就作废了,而读者真正需要的是"为什么这样设计"。
第三,也是最重要的:它没给"合格线"。书里教了元数据怎么写、指令怎么分层、资源怎么打包,但没回答一个问题:我怎么知道我这个 Skill 写好了?什么情况下算"模型总是误解"、什么情况下算"指令太长导致失效"、一个 Skill 该不该拆成两个——这些是写 Skill 的人真正会卡住的地方,书里没有验收清单。
我自己写 Skill 的经验是:没有验收标准的 Skill,一定会膨胀。因为每次出错,你的第一反应都是"再加一条规则",加到某一天,模型开始忽略其中一半,而你不知道是哪一半失效了。这个循环,书里没提。
第四,生态那一节更像渠道介绍。内容提要里写"解读 Skills 与 MCP、Agent、RAG 等技术的协同关系,并介绍 Coze、CodeBuddy、可学 Skills 等主流平台的支持情况"。协同关系那部分有价值(图1-8 画了 Skills 调脚本、查数据库的路径),但平台支持情况这种内容,更新周期以月计,写进书里注定很快过时。
第五,我读到的 400 屏里,没有一次失败复盘。所有案例都是"这样写就好了",没有一处写"我们第一版写错在哪、为什么错、后来怎么改"。对比我前几天读的那本 Cursor 手记——它敢写"AI 偷偷改测试用例"——这本书明显更"干净",也更不真实。
五、谁该读,怎么读
准备写第一个 Skill 的人:读第 1、2、4 章。三层结构和那张对照表,能让你少走一大段弯路——尤其是"目标受众是模型不是开发者"这一条,想通了,写法就变了。
已经写了一堆 Skill 的人:只看 p0250 那个发票查重的例子和 p0386 那个 Git Skill 的触发条件。前者教你"兜底",后者教你"收窄"。
想搞懂 Skills 生态的人:可以读,但别把平台那一章当资料存——它会过期,而且过得很快。
最后一句话:这本书把"Skill 是什么"讲清楚了,把"Skill 怎样算好"留给了读者。而后者才是真正难的部分。它像一本很详细的产品说明书:每个按钮都标了,但没告诉你什么情况下不该按。而写 Skill 这件事,恰恰是"什么时候不触发"比"什么时候触发"更难想。
阅读记录:微信读书《Skills+OpenClaw:从零打造个性化 AI 助理》。抓取 400 屏(我在抓取参数上设了 400 屏上限,读到第 8 章开头),全书 102 节。逐字核对页码:p0006(内容提要六条特色)、p0030(Skills 与插件对照表、Skills 与 MCP 协同)、p0160(展示卡片与 Markdown 文档截图)、p0250(发票查重 Skill 的 OCR + 正则 + 相似度实现)、p0386(Git-Pushing Skill 的触发条件与"暂存所有更改"实录)。章节屏数由 pages.jsonl 逐条统计:第 3 章 121 屏占 30%,第 1 章 56 屏。2026-11-12。
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: