
CodeBuddy领航:安装章吃掉 23%,讲架构只有 6 屏
阅读提示:这本书我逐页翻了 350 屏,翻到第 7 章 7.1.1 节时撞上了抓取上限,第 7 章以后的桌面应用部分没读到。所以下面写到的每一处,都以我实际看到的屏幕为准,页码标在句后;没读到的部分我不猜。这不是一本靠读完才能评价的书——它的问题在前两章就全暴露了。
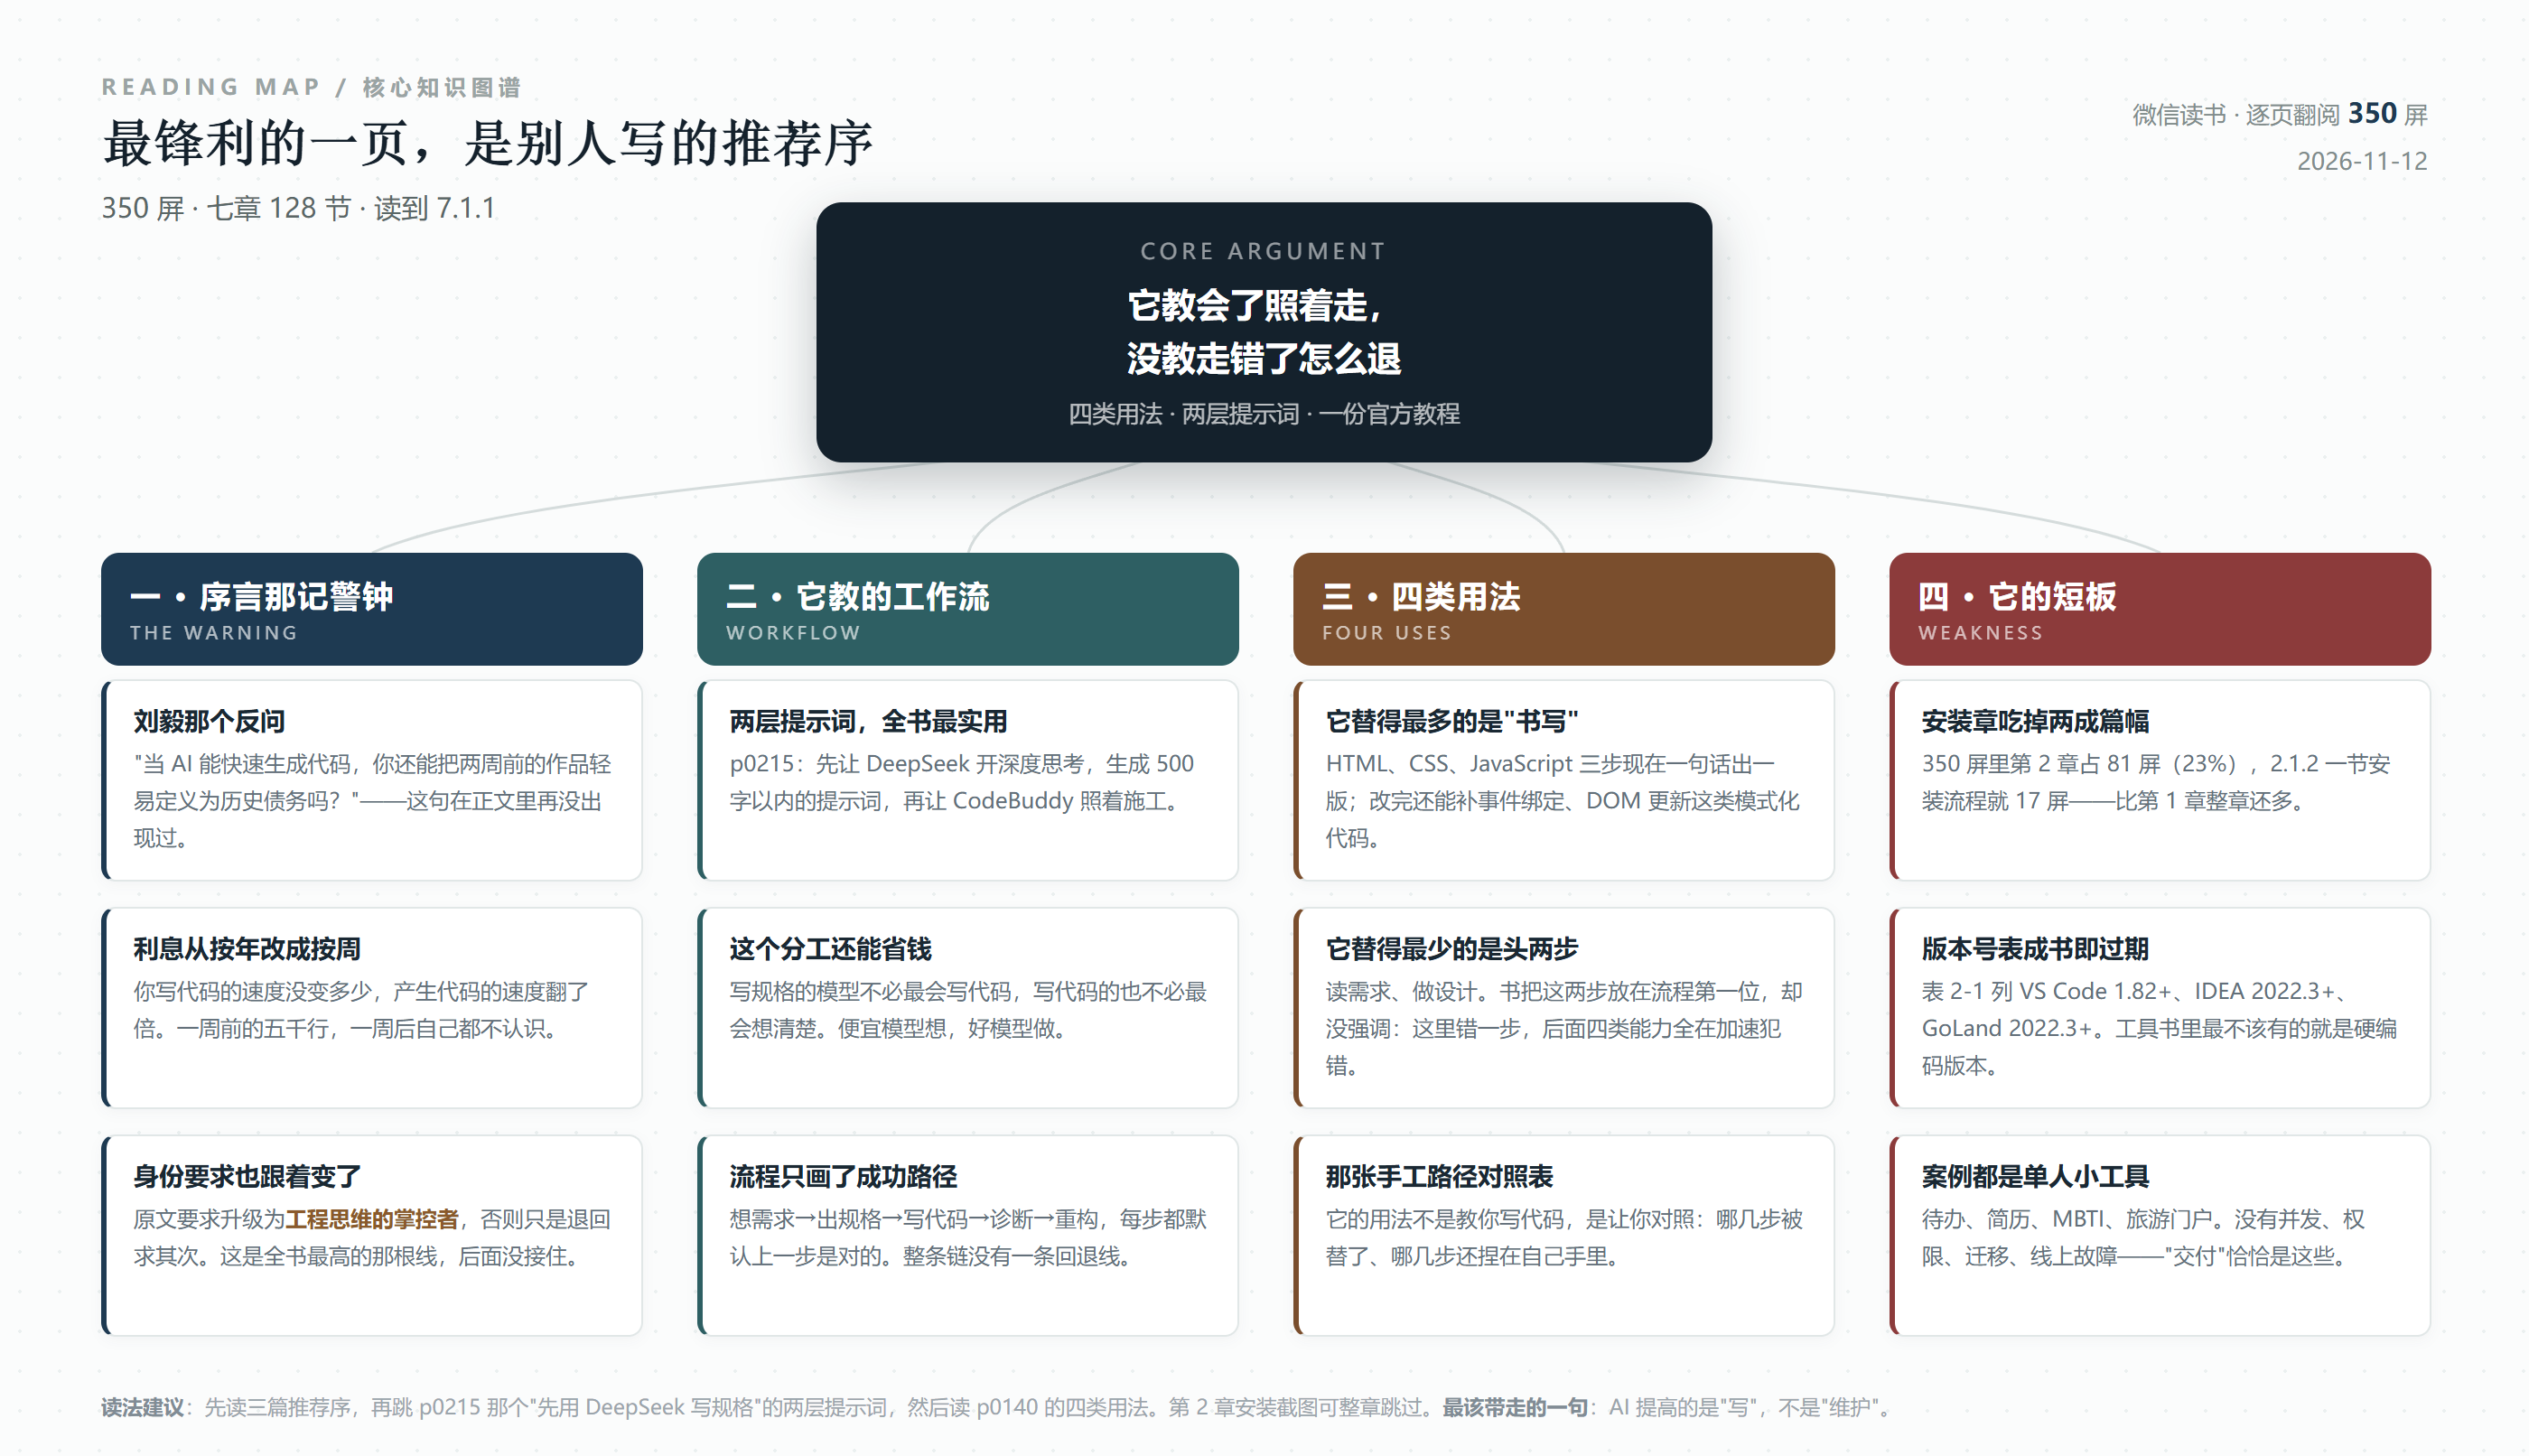
先说结论:这是一本写得很用心的产品手册,但推荐序里藏着一段真判断。全书最锋利的话不在正文,在三篇推荐序里;全书最接近"架构"的内容只有两屏,藏在一个不起眼的小节里;而全书最有价值的一招,是一个跟这本书本身没关系的做法——先让另一个模型帮你把需求写成规格。
一、序言里那句话,比正文所有章节都锋利
p0006 是推荐序三的结尾,落款是腾讯云 CODING CEO 刘毅。这一段的核心是一个反问:
若仍停留在"被动编码"的思维里,AI 会让"垃圾代码"的积累速度翻倍,"历史技术债务"将呈现更猛烈的爆发态势。当 AI 能快速生成代码,你还能把两周前的作品轻易定义为"历史债务"吗?
这句话把时间尺度点出来了。传统技术债的利息是按年算的,AI 编程的利息是按周算的。因为你写代码的速度其实没变多少,但产生代码的速度翻了倍——一周前生成的五千行,一周后你自己都不认识了。它还补了一句更狠的:程序员必须主动升级为"工程思维的掌控者",否则就只是"退回求其次"。
我在另一本书里读到过同一件事的另一面:《十倍速开发:AI时代的Cursor编程手记》那位作者说,AI 会把"很多不相关的代码改得面目全非,最后彻底失控"。两本书说的是一件事的两头——一本讲失控的过程,一本讲失控的成本。而这两件事加起来,才是"AI 提高效率"这句话的全部真相:它提高的是写,不是维护。
这 350 屏之后的所有章节,都在讲"怎么让它写得更多"。没有一章讲"怎么让它少欠债"。这就是它最大的问题——序言提出了一个成本问题,正文只回答了产能问题。
二、它给的工作流里,有一招我之前没想到
p0215 讲 MBTI 性格测试网页的案例,第一步不是直接让 CodeBuddy 写代码,而是先打开 DeepSeek,让它生成提示词。作者的原话是:利用 DeepSeek 构建精准提示词,选择"深度思考"和"联网搜索"模式,输入需求描述,要求它输出一段 500 字以内、可直接用于网页代码生成的提示词。
图 4-20 里那段需求描述写得很规范:生成一套简化的 MBTI 测试题库,共 20 道题,每道题包含题干和两个选项,并标注选项所对应的 MBTI 维度(E/I、S/N、T/F、J/P);网页包含三个关键模块——题目呈现区(每次展示一题或分页展示)、计分逻辑区(将用户的选择映射至相应的维度分值)、结果展示区(以文字或图表形式展示 MBTI 类型);网页之间能够进行有效交互,并要求具备一定可视化分析能力。
这个"两层提示词"的做法,我认为是全书最实用的一招:先让一个模型把模糊需求翻译成结构化规格,再让另一个模型按规格施工。它解决的是一个人人都遇到、但很少有人明说的问题——你自己也不知道自己想要什么。让模型来问你、替你把规格写清楚,比你自己憋一段提示词有效得多。
而且它隐含了一个很好的分工:写规格的模型不需要是最会写代码的,写代码的模型不需要是最会想清楚的。用便宜的模型想清楚,用好模型照着做,成本能省一半。这个道理作者只是顺嘴提了一句,没有展开——但它其实是"AI 编程降本"这个话题里最实在的一条。
三、它把"AI 能帮什么"归成了四类,归得准
p0140 有一段把 CodeBuddy 的用法归纳成四类,我认为这是正文里最有价值的一页:
第一类是自然语言到代码片段的映射——你把话说明白,它给你一段能用的代码;你在人工修改或补充之后,它还能基于上下文补全重复性、模式化较强的部分,比如事件绑定、DOM 查询与更新。
第二类是解释与诊断——现有代码报错或行为与预期不一致时,它分析代码片段与错误信息,指出潜在原因并给出修正建议。书里给的例子很具体:"标记完成状态后样式未更新""删除按钮无效",都只要把相关代码和错误描述一起给它,就能定位到逻辑错误或 DOM 操作遗漏。
第三类是重构与文档——功能基本实现后,用于局部重构与文档生成:拆分冗长函数、抽取重复代码、为关键逻辑生成更规范的注释说明,必要时还能生成"功能说明""使用说明"作为教学项目的辅助文档。
第四类,作者其实写在前面:它把传统纯手工路径列了一遍——阅读需求、手工设计方案、书写 HTML、书写 CSS、书写 JavaScript……这个列表的作用不是教你,是让你对照:哪几步它替你了,哪几步没替。
我的看法是:它替得最多的是第二步之后的"书写",替得最少的是第一步"阅读需求"和"设计方案"。而这恰恰是后面所有返工的源头。书里对这一点交代得不够重——它把"阅读需求"放在流程的第一位,但没告诉你,如果这一步没想清楚,后面四类能力全都会帮你把错误做得更快。
四、它不只给代码,还给一张说明清单——这件事被低估了
p0160 是我觉得最被轻描淡写的一页。图 3-8 左边是生成出来的 style.css,右边是 CodeBuddy 给出的一份逐条说明清单:页面布局(最小宽度、内容居中、最大宽度 600px)、标题样式(字号、颜色、字重)、输入区域(输入框与按钮同行排列、间距、圆角、聚焦状态高亮)、任务列表样式(去掉默认列表符号、条目间距、底部边框、圆角)、悬停与交互效果、以及"实时预览和即时反馈"的提示。
为什么说这一页重要?因为它把"我给了你一段代码"变成了"我告诉你我为什么这么写"。前者你只能接受或丢弃,后者你能学、能改、能拒绝。这是 AI 编程工具和"代码生成器"的分界线,也是我在这本书里唯一看到它主动越过的线。
但作者只用了一句话带过它:CodeBuddy 返回了一份完整的样式文件,"并给出了逐条说明"。整本书都在教你按按钮,只有这一页在教你审代码。而"能不能审"才是序言里那个"工程思维掌控者"的门槛——你审不了它给的代码,你就永远是打下手的那一个。
五、全书最接近"架构"的两屏,藏在一个小节的末尾
书名叫《AI 辅助编程应用·架构·交付》,我一路找"架构"在哪,找到 p0119 才有答案——Subagent 机制,而这部分只给了两屏。
书里的定义是:Subagent 可以理解为"具备专用角色定义的 AI 助手实例"。每个 Subagent 可以独立配置它的 System Prompt、可调用的工具、以及可访问的 MCP 服务,从而专注特定类型的任务,比如代码审查、测试生成、文档整理、构建脚本维护。关键的一句是:Subagent 拥有独立的上下文空间,其对话和生成结果不会污染主对话的语义状态,有助于在复杂工程中保持上下文清晰。
p0119 还给了两个维度的划分:运行模式上分 Agentic(在授权范围内自主调用工具、推进任务,适合需要多步推理的场景)和 Manual(仅在显式指令触发时运行,用于替代人工执行某一固定职责,适合受控环境或高风险操作);作用域上分项目级(放在项目目录下的 .codebuddy/agents/,用于固化团队共用的角色定义)和用户级(放在用户主目录的 ~/.codebuddy/agents/,用于个人效率增强)。
我认为这是全书唯一一段真正在讲架构的话,因为它回答的是分工与边界的问题:谁管什么、谁能碰什么、什么情况下不许自己动手。"Manual 模式适合高风险操作"这一句,价值比前面 80 屏的界面截图加起来都大——它承认了 AI 该有不许动手的时候。
p0110 的项目级斜杠指令是同一思路的轻量版:在 .codebuddy/commands 里配快捷指令,指令会自动绑定到当前项目,能访问当前仓库的代码、提交记录和工作目录内容,可以引用当日的 Git 提交摘要、代码变更统计或项目文档,用来生成结构化的日报周报;保存即生效,输入斜杠就触发。书里对它的定位是"适合高频重复执行的任务,如生成测试说明、梳理提交内容、格式化输出文档"。
这两块加起来只有 6 屏,占 1.7%。一本名字里带"架构"的书,把架构写成了附录的体量。
六、一个"注意"框,暴露了整套流程的软肋
p0261 有一页紫色边框的"注意",全文不长,但我认为它是这本书的良心所在:
尽管 CodeBuddy 中的大语言模型能够理解"帮我搭建 Hadoop 系统"这样的自然语言指令,但一个模糊的开端往往会导致部署的失败。在未指定环境时,CodeBuddy 会默认采用其最优解——通常是基于 Linux 的 Docker 或 Shell 脚本方案。当这套方案在用户本地的 Windows 11 + WSL(Ubuntu)环境中被执行时,环境差异将直接导致测试阶段报错。这样的尝试不仅浪费了计算资源(token),也延长了获得可用环境的时间。因此,高效提示词的首要原则就是精确定义技术栈与运行环境。
这段话说了三件事,作者自己可能没意识到它们有多重:
第一,它承认了 AI 有一个默认解法,而这个默认解法经常是错的。模型不是在"理解你的环境",它是在猜,猜的依据是它训练数据里最常见的那个环境。你什么都不说,它就给你 Linux+Docker——因为程序员世界里 Linux 更多。
第二,它承认了错误的代价是 token 和时间,而不只是一次重试。"浪费计算资源"这句话在一本产品书里出现,说明作者是真踩过。第 5 章那个 Hadoop 环境搭建占 17 屏(5.4.1 到 5.4.3),大部分篇幅在处理"它默认给了错方案"之后的补救。
第三,也是最重要的一点:它把这条经验写成了"提示词技巧",而不是"流程缺陷"。正确的写法应该是:在动手之前,先把运行环境固化成一份项目配置,让它不必再猜。这恰恰就是项目级指令该干的事——但作者没把这两件事连起来。第 2 章讲指令配置,第 5 章讲环境报错,中间隔了 150 屏,读者得自己接上。
这就是我说的"流程只画成功路径":书里的流程是 想需求 → 出规格 → 写代码 → 诊断 → 重构,每一步都默认上一步的结果是对的。可真实情况是规格可能错、代码可能跑不起来、诊断建议可能让你推倒重来。而整本书里唯一一条"会失败"的提示,被做成了一个小小的注意框,塞在第 5 章中间。
七、它的短板
第一,最硬的一条:版本号表格在成书那天就开始过期。p0060 有一张"表 2-1 CodeBuddy 插件版最低 IDE 版本要求":VS Code 1.82 以上、IntelliJ IDEA 2022.3 及以上、PyCharm 2022.3 及以上、WebStorm 2021.3 及以上、GoLand 2022.3 及以上,还附了一列"备注说明"。这些数字在出版时是对的,读者拿到书时大概率已经不对了。工具书里最不该出现的,就是会随版本失效的硬编码信息。这类内容更适合放在官方文档里,而不是印在纸上。
第二,安装上手章吃掉超过四分之一的篇幅。我按页统计了一遍:全书 350 屏里,第 2 章"快速上手:安装配置与界面介绍"独占 81 屏,占 23.1%;而讲理念的第 1 章只有 17 屏,占 4.9%。更极端的是 2.1.2 一节"获取方式与安装流程",一节 17 屏,跟整个第 1 章一样多。一本讲"AI 编程"的书,把最大的篇幅给了"怎么装软件"。这些内容在产品改版后归零,而理念部分才是能留住的。
第三,截图占比决定了这本书的保质期。侧边栏入口在哪、设置项长什么样、弹窗里有哪些选项、图 2-34 的 Create Command 菜单——这类内容对"当下就想上手"的读者很友好,代价是产品改版一次小半本书作废。一本书如果是靠截图支撑的,它其实是在跟产品迭代赛跑,而书永远跑输。
第四,案例清一色是"一个人做的小东西"。待办清单、在线简历、MBTI 测试网页、旅游信息门户——共同点是:没有并发、没有权限、没有数据迁移、没有线上故障。而"交付"这个词在真实工程里指的恰恰是这些。书名里有"架构"和"交付",正文里这两块最薄:架构 6 屏,交付 0 屏。
第五,它没回答那个最要命的问题:当 AI 生成的代码你看不懂时,你该怎么办?《十倍速开发》给了一个诚恳的答案——"我会让它详细解释,事实上是我在通过 AI 学习"。这本书没有正面碰这个问题,它默认你看得懂。而这个问题决定了一件事:你到底是在用工具,还是在给工具打下手。
八、谁该读,怎么读
团队刚采购了 CodeBuddy,需要让成员半天内上手的人:这本书合适。按第 2、3 章照着走一遍就行,别指望更多。
想学"AI 辅助编程方法论"的人:读三篇推荐序 + p0215 那个两层提示词 + p0160 那张说明清单,其余可以跳过。
做团队规范和架构的人:只读 p0110 和 p0119 这五屏——项目级指令与 Subagent 的分工、边界、Manual 模式。这五页值得你把它抄成团队规范,剩下的部分帮不了你。
最后一句话:这本书最像一份写得很用心的官方教程,而不是一本工程书。它把工具的每个按钮都讲清楚了,也顺手给了三个好东西(两层提示词、说明清单、Subagent 的权限分层);但它绕开了两件真难的事——看不懂的代码怎么办,和流程走错了怎么退。而这两件事,恰好就是序言里"AI 让技术债利息按周计"那句话中,"债"字的来历。
阅读记录:微信读书《CodeBuddy 领航:AI 辅助编程应用·架构·交付》。逐页翻 350 屏,读到第 7 章 7.1.1 节(受 350 屏抓取上限截断,第 7 章桌面应用部分未读)。逐字核对页码:p0006(推荐序三,刘毅)、p0060(表 2-1 插件版最低 IDE 版本要求)、p0110(项目级斜杠指令 .codebuddy/commands)、p0119(Subagent 机制与两种模式)、p0140(四类用法与手工路径对照)、p0160(图 3-8 生成样式文件并给出说明清单)、p0215(先用 DeepSeek 生成 500 字提示词)、p0261(注意框:模糊开端的代价)。章屏数统计自本地 pages.jsonl。2026-11-12。
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: