
AIGC智能营销:五个缩写,讲的是一套道理
阅读提示:这本书我逐页翻了 142 屏,全部落在"前置部分 + 第 1 章"(版权、赞誉、推荐序、前言、第一章的新技术与提示工程)。翻到 1.3.6 之后,渲染反复卡死,4A 模型真正落地的那几章(第 2 到第 9 章)我没读到。所以这篇只谈我眼睛看到的东西,页码都标了;没读到的部分我不评论,也不替它吹。
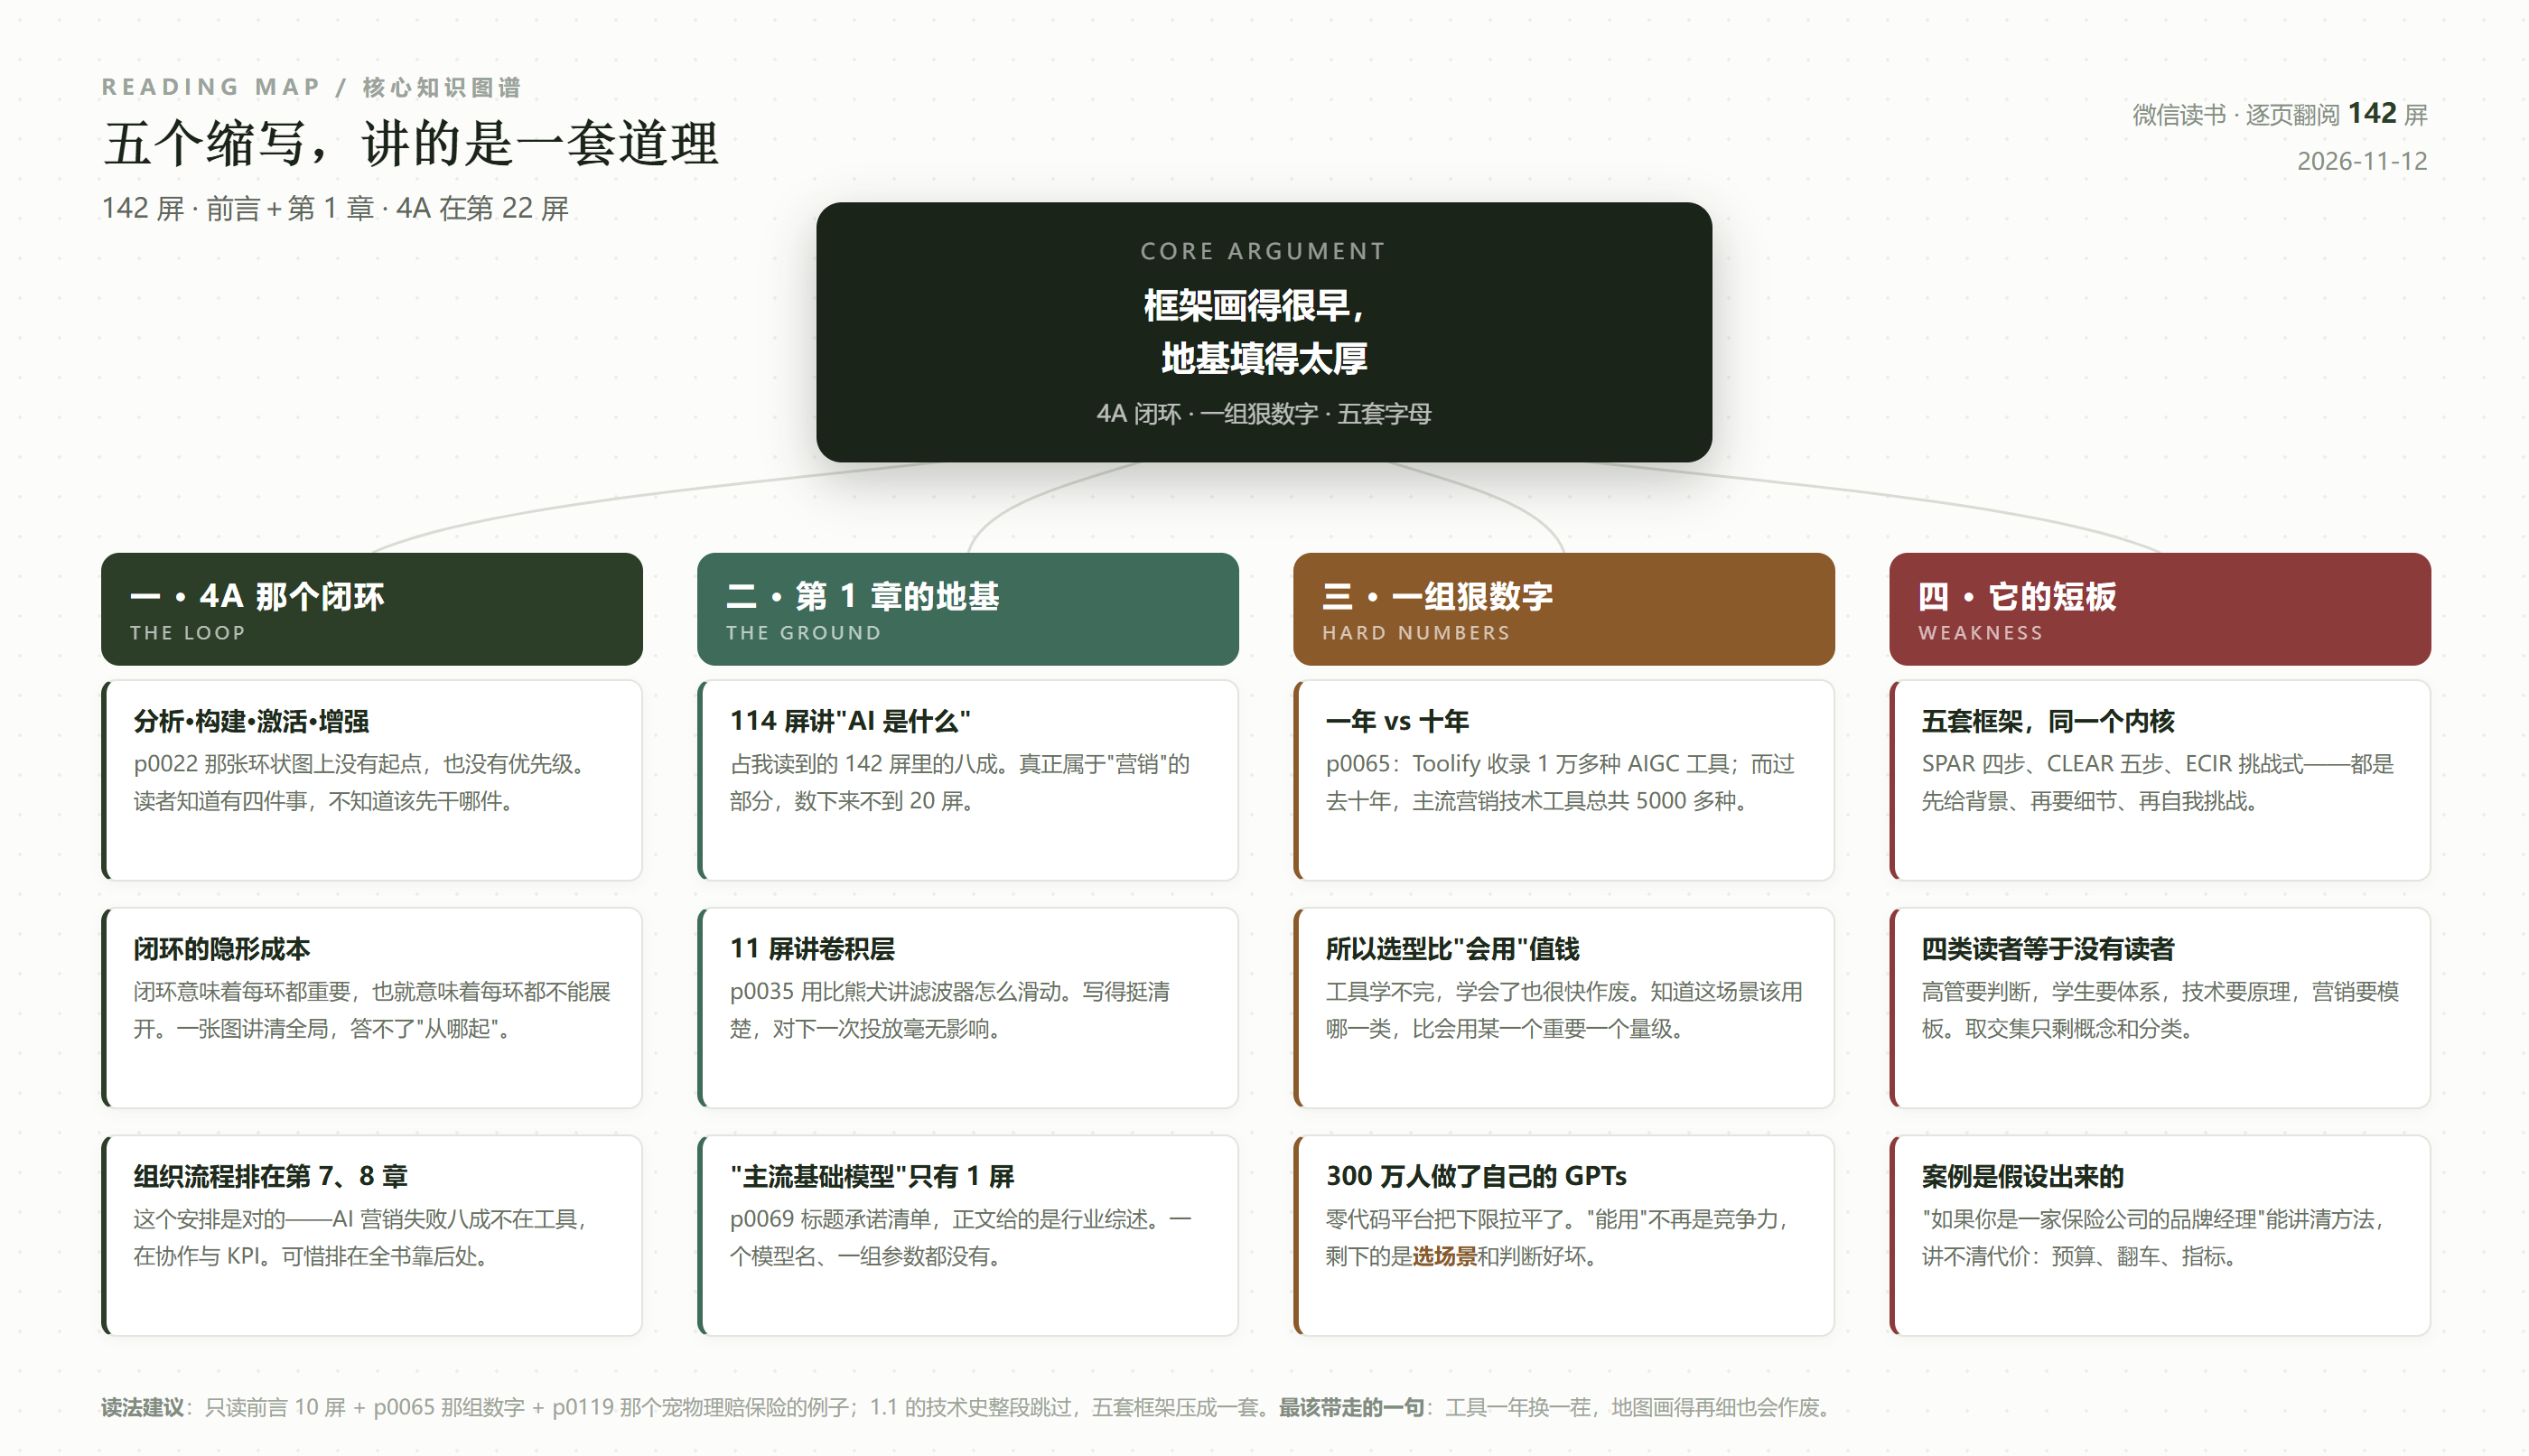
先说结论:这本书的框架画得很好,画在第 22 屏,一张闭环图,四个字母。问题是它用一整章(114 屏)在给这张图填地基,而填地基的方式是"技术名词综述"。AI 是什么、深度学习怎么来的、卷积层怎么识别熊猫、文本图片语音视频各有哪几种工具——这些内容放进任何一本 AIGC 书都成立,也就是放进这本书并不特别。
一、三篇赞誉说的都是同一个词,作者也认了这个定位
p0006 是赞誉页,三位推荐人说的话不一样,落点却撞在了一起:
"这本书就好像是内容创作和营销的'导航系统',指引我们在创意的高速公路上纵横驰骋。"——顾婷婷,考拉营销创始人
另外两位(胖鲸传媒创始人范怿、Marteker 创始人冯祺)用的词是"全局观与结构性思维""宝贵的指导"。三个人的共同点是:没有人说这本书给了新方法,都在说它给了地图。
这不是坏事,但作者显然也认了这个定位。前言里他写得很坦白:这本书面向四类读者——市场营销专业人士、企业高管、技术人员与 AI 研究者、商学院师生(p0025)。四类人的需求差得很远:营销经理要的是明天能用的模板,高管要的是要不要投钱的判断,技术研究者要的是原理,学生要的是体系。一本书同时满足这四类人,实际结果通常是每类人都拿到七成。
我的看法是:这不是"贪心",是"教材化"的必然。它承认真相——AIGC 在营销里的方法论还没沉淀到能写"操作手册"的程度,所以只能先写"导览"。而导览的命运,就是被后来者覆盖。
二、4A 是在第 22 屏画出来的,画的是一张闭环
全书的骨架在 p0022:
AIGC 智能营销的超级闭环由 4 个核心要素构成:分析(Analyze)、构建(Architect)、激活(Activate)和增强(Augment)。这 4 个要素共同构成了超级闭环的 4A 模型。
四个词选得不错,覆盖面也够:分析对应数据与洞察,构建对应内容生产,激活对应投放与触达,增强对应反馈与优化。这是一条能自洽的链路,而且比市面上"AI 营销 = 用 AI 写文案"的粗糙理解要完整得多。
但"闭环"这两个字,在管理类书里有个隐形成本:闭环意味着每个环节都重要,也就意味着每个环节都不能展开。一张环状图(p0022 那张)里没有起点,也没有优先级——读者读完知道有四件事要干,但不知道自己应该从哪一件开始干。而现实中,做 AI 营销的人 90% 卡在"第一件事从哪起"。闭环图最擅长解释全局,最不擅长回答"我先做哪个"。
另外,前言交代了全书四部分的安排:第一部分新技术与新思维,第二部分(营销场景),第三部分组织与流程(第 7 章智能化转型、第 8 章企业内的流程与技术栈),第四部分未来展望(第 9 章,还包括版权、隐私、数据安全)。把"组织与流程"单列一部分,这个安排是对的——AI 营销失败的原因八成不在工具,在协作方式和 KPI。可惜这部分排在第 7、8 章,也就是全书靠后的位置;我这次没读到,无法评价它写得实不实。
三、一本讲营销的书,用十几屏讲卷积层怎么识别熊猫
第 1 章占了我读到的 142 屏里的 114 屏。它的结构是:1.1 是什么(AIGC 概念、技术发展史、深度学习突破、AIGC 2.0),1.2 有哪些工具(基础模型、文本、图像、语音音乐、视频),1.3 怎么提问(五个字母框架)。
问题出在 1.1.2 那 11 屏。p0035 这一页在讲卷积神经网络的层级:
以使用卷积神经网络识别一只比熊犬来举例……在网络的第一层,滤波器(也称为卷积核)在图像上滑动,计算滤波器与其覆盖区域的像素之间的点积。这个过程类似用于"电子眼"识别并提取图像中的基本特征,例如比熊犬圆润的脸部轮廓、黑色湿润的鼻子和卷曲的毛发。进入第二层,网络可能会进一步提取和识别比熊犬的下垂耳朵和圆润的眼睛等更具体的特征。
这段写得没错,甚至挺清楚。但它跟营销的关系是什么?一个品牌营销经理,知道卷积核在图像上滑动这件事,对他的下一次投放有任何影响吗?没有。
这就是"技术综述型"章节的通病:它把"讲清楚 AI 是什么"当成了义务,于是把深度学习的教科书内容压缩了一遍。而这些内容有三个毛病——对读者无用、会过期、而且挤占了本该给方法论的篇幅。114 屏里,真正属于"营销"的部分,我数了数,不到 20 屏。
四、它敢给数字,而且给了一组很狠的数字
第 1 章最有力的一页是 p0065,我建议所有做营销的人都看一眼:
截至 2024 年 5 月,Insidr.ai 网站已收录了超过 300 种 AIGC 工具,AI 万花筒(aiwht.com)则录入了 1200 多种,Futurepedia 记录了超过 5000 种相关工具,而 Toolify 则收录了超过 1 万种工具和应用。作为对比,过去十年里,主流营销技术工具总共才 5000 多种。
这一组对比是全书最有信息量的地方,虽然作者只是把它当成背景陈述。它其实说明了三件事:
第一,工具的数量已经超过了任何人的学习能力。一年之内出现的 AIGC 工具,是营销技术十年积累的两倍。这意味着"学会用工具"这条路已经堵死了——你学不完,学会了也很快作废。
第二,选型比使用更值钱。当有一万种工具时,知道"我这个场景该用哪一类"比"会用某一个"重要一个量级。这也是为什么 1.2.3 到 1.2.6 那四节(文本、图像、语音音乐、视频)按类型分工是有道理的——它教的是分类,不是清单。
第三,也是最容易被忽略的一点:工具爆炸的另一面是"下限被拉平"。书里提到扣子(coze)这类零代码平台,让"任何零基础用户以无代码构建自己的 AIGC 应用",还说已有超过 300 万人开发了自己的 GPTs。当 300 万人都能做出一个"能用"的东西时,"能用"就不再是竞争力。剩下的差别只在两处:你选了哪个场景,以及你怎么判断它做得好不好。而这两件事,恰好是这本书最薄的地方。
五、五个字母框架,讲的是同一件事的五种缩写
1.3 讲提示工程,作者一口气给了五套框架:SPAR、CLEAR、ECIR、CREATE、COSC。我对着屏幕数了一下篇幅:SPAR 6 屏,CLEAR 6 屏,ECIR 5 屏,CREATE 1 屏,COSC 1 屏。
p0119 的 SPAR 是四步:情境(Situation)、角色(Role)、行动(Action)、响应(Response)。例子给得很具体——假设你是一家保险公司的品牌营销经理,要为一款"宠物理赔保险"做推广,先给情境(新兴宠物保险公司、中国市场、竞品激烈),再给角色(你是该公司品牌营销经理),再给行动(制定创新营销计划),最后给响应约束(要求输出格式、规避幻觉)。
p0125 的 CLEAR 是五步:Contextualize(语境设定)、List(列出问题)、Elaborate(详细阐述)、Associate(信息关联)、Review(回顾总结)。p0131 的 ECIR 是"挑战式提问":先问"有哪些关键因素被普遍忽视",再让 AI 列出反方观点,再做头脑风暴。
问题在于:这三套东西的内核完全一样——先给背景,再要细节,再让它自我挑战。SPAR 的"情境"就是 CLEAR 的 Contextualize,SPAR 的"响应"大致对应 CLEAR 的 Review 加输出约束;ECIR 的"挑战"是 SPAR 里没有的一步,这算是它的增量,但它只有 5 屏,且没讲清"挑战"之后怎么办。
我的判断比较直接:五套框架里,一套够用,第五套就是记忆负担。对读者来说,真正需要的不是"五个缩写",而是一句话:把背景、角色、要什么、不要什么,四件事说清楚,效果就超过 90% 的人。这句话 SPAR 已经说完了,后面的四套是在用不同的字母重复它。
不过有一处我必须承认它写得好。p0119 那个宠物理赔保险的例子,是全章唯一一个"能照着改"的东西——它把抽象框架落到了一个真实业务场景上,连"公司面对的挑战是如何在竞争激烈的市场中突出产品特色"这种约束都写进了提示词。如果这本书每个框架都配一个这样的例子,五套也就五套了。可惜只有 SPAR 有。
六、"主流的基础模型"这一节,只有一屏,而且一个模型名都没有
这是我在整本第 1 章里最不能接受的一处。1.2.2 这一节叫《主流的基础模型》,篇幅是1 屏(p0069)。这一屏的内容是:大部分大语言模型先在未标注文本上预训练、再微调;2022 年 OpenAI 发布 GPT-3.5 引发竞赛;当前格局是"美国在基础模型和图像生成模型领域占据了领先地位,而中国紧随其后"。
标题承诺的是"主流的基础模型",正文给的是一段行业综述,没有一个模型清单,没有参数规模对比,没有适用场景区分。而这一节前后紧挨着的,是 12 屏的文本工具选型、3 屏图像、6 屏语音音乐、4 屏视频——工具层写得很细,模型层一笔带过。这个详略关系是反的:对营销人来说,"用哪个模型"确实不如"用哪个工具"重要,但既然你写了这一节,就不该只给一屏的宏观叙事。
顺便说一句会过期的问题。p0080 讲文本生成工具,配图是 ChatGPT 的界面截图(图 1-3),正文写"支持 GPT-3.5、GPT-4、GPT-4o 版本",还提到 DALL·E 与 Data Analyst。这些在写作时都对,读者拿到书时大概率已经不对了。工具书里最不该出现的,就是会随版本失效的硬编码信息——不如把它写成"判断标准",比如"看它是否支持长上下文、是否给你 API、是否有数据留存政策",这些三五年不会变。
七、它的短板
第一,定位决定了它必须是"导览",而导览的保质期很短。书名里"方法与实践"五个字,实践部分我读到的都是"某类工具是什么",不是"某家公司怎么做的"。赞誉页说它是"导航系统",这个比喻很准,但导航有个前提:路得是通的。当工具一年换一茬,地图画得再细也会迅速作废。
第二,读者对象开了四类,等于没有对象。p0025 列的四类人:营销专业人士、企业高管、技术人员与 AI 研究者、商学院师生。四类人对同一本书的期待是互斥的——高管要判断,学生要体系,技术人员要原理,营销经理要模板。写一本书同时服务四类人,写法上只能取交集,而交集就是"概念 + 分类 + 框架",恰恰是最不耐用的那部分。
第三,第 1 章的地基太重。114 屏讲"AI 是什么",其中 11 屏讲卷积层识别熊猫、5 屏讲深度学习突破史、12 屏讲 AIGC 2.0。这些内容放在 2023 年是必要的,放在今天,读者更需要的是"哪些能力已经稳定、哪些还在变"——区分"已稳定"和"仍在变",才是真正省时间的知识。这本书没有做这个区分,它把一切都当成新知识来讲。
第四,五个字母框架的边际收益递减。SPAR、CLEAR、ECIR、CREATE、COSC 五套并列,没有一句话告诉读者"你该用哪一套、什么场景用哪一套"。框架的价值不在数量,在选择。给了五套却不给选择标准,读者只会记住"好像有五个缩写"。
第五,案例是假设出来的。"如果你是一家保险公司的市场部品牌营销经理"——这个开头很好,但它接下来给的是一个虚构情境,不是一次真实投放。虚构案例能讲清方法,讲不清代价:预算多少、试了几轮、哪一轮翻车了、最后指标动了几个点。而营销这件事,值钱的恰恰是代价。
八、谁该读,怎么读
刚被要求"搞一下 AI 营销"、完全没头绪的人:这本书有用。读前言(10 屏)+ 1.2.1 那组工具数量对比 + 1.3.2 的 SPAR 例子,一小时能建立起一张能用的地图。
已经在做投放、想找方法的人:直接跳到第 7、8 章(组织与流程)。1.1 那 30 多屏技术史可以整段跳过——你不需要知道卷积核怎么滑动。
要给团队做培训的人:把 1.3 那五套框架压缩成一套(我建议只留 SPAR,加上 ECIR 的"挑战"那一步),配 p0119 那个宠物理赔的例子,比原书五套并列更好用。
最后一句话:这本书最值钱的一页是 p0065 那组数字,最值钱的一张图是 p0022 那个闭环,最值钱的一个例子是 p0119 那个宠物理赔保险。三样东西加起来不到 10 屏。剩下的 130 多屏,是在为一本书的"完整性"付账——而完整性,从来不是读者要的东西。
阅读记录:微信读书《AIGC 智能营销:4A 模型驱动的 AI 营销方法与实践》(栗建)。逐页翻 142 屏,覆盖版权、赞誉、推荐序、前言、第 1 章(全 6 节),1.3.6 之后渲染反复卡死,第 2 至 9 章未读。逐字核对页码:p0006(赞誉,顾婷婷"导航系统")、p0022(4A 闭环图)、p0025(四部分结构与四类读者)、p0031(四个模型写春联横批对比)、p0035(卷积层识别比熊犬)、p0065(工具数量对比:1 万种 vs 5000 种)、p0069(1.2.2 主流的基础模型,仅 1 屏)、p0080(ChatGPT 界面截图与版本号)、p0119(SPAR 四步与宠物理赔保险案例)、p0125(CLEAR 五步)、p0131(ECIR 挑战式提问)。章节屏数统计自本地 pages.jsonl。2026-11-12。
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: