
Claude Code实战:它最值钱的一页,是告诉你它什么时候帮不上忙
阅读提示:这本书我只读到 70 屏、第 4 章开头(p0082 起是另一本书的截图,本次抓取在此中断),所以下面的评价只覆盖第 1 到第 3 章加第 4 章开篇。全书共几章、后面写了什么,我没读到,不装作读过。引句标了页码。
先说结论:这是一本少见的、愿意告诉你"我什么时候不灵"的工具书。市面上讲 AI 编程的书,九成在证明"它能行",剩下一成在证明"它更行"。这本在第 26 页放了一张表,标题就叫"Claude Code 帮不上忙的情况",第一行写着:实时交互的 UI 调试,它看不到浏览器,不能操控 DevTools,CSS 布局和 React 渲染问题不如你自己开 DevTools 看。
一张这样的表,比十页"它能做什么"更值钱。因为它替读者省下的不是学习时间,是踩坑时间。工具书最坏的写法是让你以为买了就什么都能干,最好的写法是先划一条线,告诉你线那边得自己来。
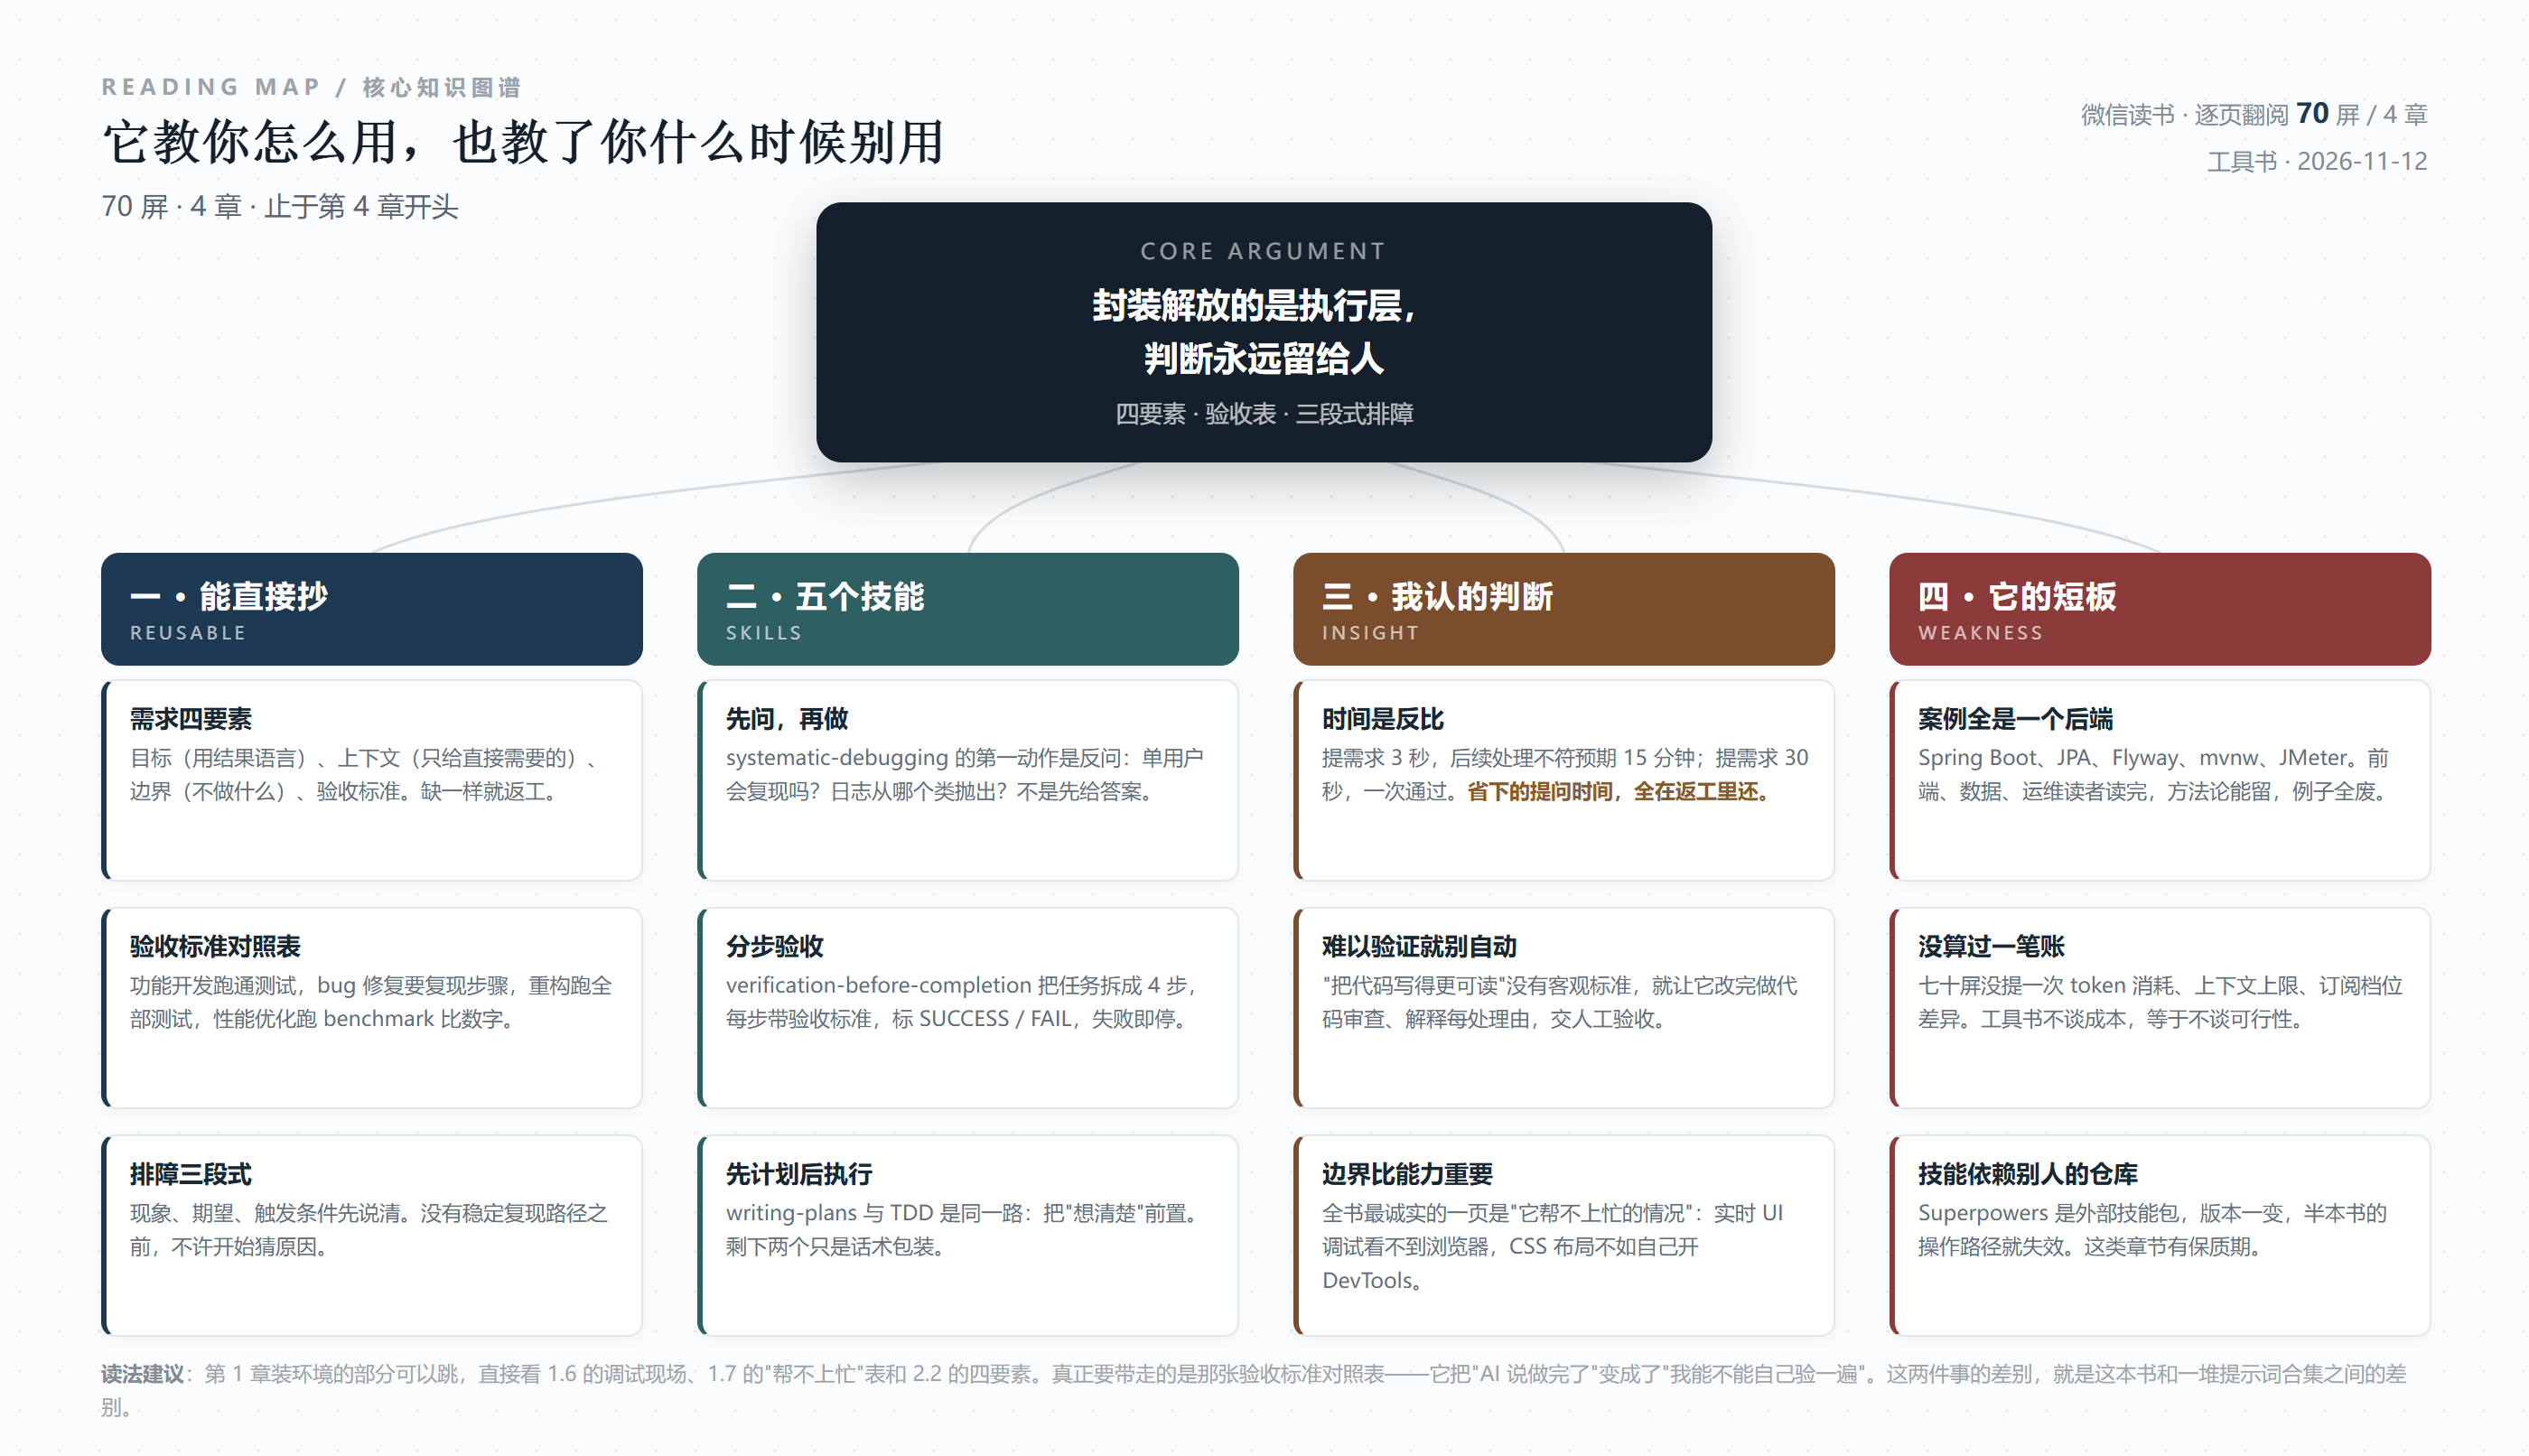
一、前言那句话,比后面七十屏都准
第 6 页的前言,开头三句就把这本书的立意说完了:
软件工程的历史,是一部不断把"怎么做"封装成"要什么"的历史。高级语言封装了寄存器分配,开源生态封装了基础模块,云计算封装了服务器运维。每一次封装,都让"一个人独立能做的事"上了一个台阶。这些跃升的共同规律是:它们解放的是执行层,而不是判断层。判断——定义问题、权衡方案、确定边界——始终留给人。(p0006)
这段话写得比全书任何一章都好,因为它给出了一个可检验的历史框架,而不是一句"AI 将改变一切"。
但我认为作者把这句话写软了。他写这句是想安慰读者——别怕,判断还是你的。而这句话其实是一句警告:判断是唯一还能保住的东西,也正是最容易被放弃的东西。
道理不复杂。高级语言封装了寄存器分配,代价是一代程序员不再知道一个 int 在内存里怎么摆;云计算封装了服务器运维,代价是一批人不再会看 dmesg。每一次封装都真的解放了执行层,也真的顺手把一批人的判断力一起封进去了——因为他们不再需要判断,就慢慢不再会判断。
所以这本书真正该问的问题不是"它能帮你做多少",而是"用它三年之后,你还会不会自己判断" 这个问题的答案,取决于你在用它的时候有没有保留验收动作。而这本书后面七十屏,恰好就在教这个。
顺带说一句这本书的来历,写得很实在:作者第一次用完,觉得"它就是命令行里的一个对话工具",关掉继续用 Cursor。一个月后,他在技术群里看到一个案例——有人丢进去一句"帮我做一个天气 CLI",从依赖安装、错误处理到 README 生成全部自动完成。那天晚上他才重新打开它。这个细节可信,因为它不体面。大多数工具书的前言都会把作者写成一开始就慧眼识珠的人,这本没有。
二、第一个排障现场:它先问,再猜
第 1.6 节"第一个调试场景"是我读得最慢的一节,因为它给了一段完整的对话记录,不是结论。
场景是一个 Java 后端的偶发故障。它没有直接给答案,而是先列了三个可能原因,每条都点到具体文件:
数据库连接池耗尽(最可能)——JpaConfig.java 里每次请求都创建新的 EntityManager 而不关闭,导致连接泄漏。它甚至给了判据:"错误偶发、复现不稳定、高流量时更频繁。"
未处理的数据库异常——OrderService.java 里 orderRepository.findAll() 的特定异常可能逃过外层的 try-catch。
环境变量缺失——GlobalExceptionHandler.java 里 System.getenv("SENTRY_DSN") 没有 null 检查。
然后作者人工确认第一个最可能,让它修。它改成 @PersistenceContext 注入 Spring 管理的 EntityManager,改完先说明改了什么,再问要不要执行测试,确认后跑测试通过。
这一节的价值,书里自己总结得很准:"Claude Code 能快速扫描多个文件,把可能的原因列出来。调试的思路来自人(排除法、偶发性代表什么),执行工作交给 Claude Code。"
我要补一句书里没说的:这个分工成立的唯一前提,是你自己知道"偶发性"意味着什么。知道偶发=并发/时序/资源泄漏的人,看到"错误偶发、高流量时更频繁"会立刻想到连接池;不知道的人,看到这三个原因只会觉得"都挺有道理",然后随便挑一个。工具把三个假设摆在你面前,但没有把"怎么排序"教给你——而排序才是判断。
这段对话里还有一个细节值得单独拎出来:它不是只说"可能是连接池",它给了判据——"错误偶发、复现不稳定、高流量时更频繁"。这三个词是把"疑似"和"确诊"分开的东西。没有这三句,你只能挨个试;有了这三句,你可以先去监控里看并发曲线和连接数有没有同时对顶,一次就能排除或确认。
这也是我对所有 AI 排障建议的评价标准:给结论的同时给判据的,能用;只给结论的,等于让你抽奖。因为 AI 的语气永远笃定,它不会告诉你自己只有六成把握——那段 85% 的概率标注,是技能里强制要求的动作,不是模型自带的诚实。
第 3 章的 systematic-debugging 技能把这件事做得更狠。第 53 页的对话里,Claude 的第一句话是:
进入系统性调试模式。第一步:建立可复现的最小路径。请回答:1. 单用户单次下单会出现,还是只有多用户并发时才出现?2. 日志里"库存不足"是从哪个类被抛出的?在没有稳定复现路径之前,我不会开始猜测原因。(p0053)
后面这段是全书我最想抄下来的一句:"在没有稳定复现路径之前,我不会开始猜测原因。"
这句话值得抄,不是因为它新鲜——任何一个带过新人的老工程师都会这么说——而是因为它出现在一个 AI 的对话框里。绝大多数 AI 编程工具的行为是反过来的:你描述一个现象,它立刻给你三条修改建议。这个技能把顺序调回来了:先复现,再隔离,最后按可能性排序给假设(对话里假设 A 的概率标了 85%,理由是"多线程 ABA 场景,最终 setStock 导致库存为负")。
我实测过类似的做法,效果差异很大。让 AI"先问三个问题再动手",比让它"直接给方案"慢两分钟,但省掉的是后面半小时的返工。这不是玄学,就是它把假设空间收窄了。
三、需求四要素里,最被低估的是"边界"
第 2 章讲"怎么把话说清楚",给的框架是四要素:目标(What)、上下文(Context)、边界(Scope)、验收标准(Done)。
这个框架本身不新,提示词工程的书里到处都是。但这本书对每一条的解释有具体口径,这是它比同类书强的地方。
目标,用结果语言,不用实现语言。别说"加一个过滤器",说"未授权的请求返回 401 和 JSON 格式的错误"。这个区分很关键:前者是把你的方案交给它执行,后者是把你的目标交给它解决。前者你只能得到你想到的那个解,后者它可能给你更好的。
上下文,只给任务直接需要的背景。这一条反直觉——大部分人的直觉是"多给点总没错"。第 31 页专门有一节叫"需求描述不是越长越好",讲的就是这个:你塞进去十页背景,它会挑错重点。
这一条背后有个更深的机制值得说:模型的注意力是有限的,你给的每一段背景都会分走一份。给"这个模块的历史沿革"和给"这两个函数的调用关系",前者读起来更像专业沟通,后者才真正影响输出。所谓"只给直接需要的",其实就是一句话:把上下文当预算花,不是当礼数送。
我在自己的项目里试过一个粗糙的对照:同一个修 bug 的需求,一次附上整份需求文档,一次只附报错日志和那两个文件的片段。后者的结果更准。不是因为信息少了更好,是因为它不用在无关段落里做取舍。书里没解释这个机制,只给了结论,但结论是对的。
边界,不做什么和要做什么同样重要。第 35 页的四要素示例里,这一条是这样写的:"只改 src/main/java/com/example/controller/OrderController.java,不要动其他文件,不需要写测试代码。"
我认为边界是四要素里最被低估的一条,理由跟 AI 无关,跟工程习惯有关。人写需求时天然只写"要什么",因为"不要什么"在自己脑子里是默认的;但对一个没有你脑子里那份默认的人来说,"不要什么"必须显式说出来。一段 AI 生成的代码把三个文件都改了、顺手升了个依赖版本、还加了个你没要的配置文件——这不是它乱来,是它不知道你的边界在哪。
这一条也是我认为这本书最实用的一处:它把"边界"从一种修养变成了一个必填字段。修养是可以没有的,必填字段不能空着。
四、验收标准那张表,建议截图存下来
第 35 页有一张表,我建议任何一个用 AI 写代码的人都存下来。它是"不同任务类型,验收标准该写成什么形式":
功能开发——跑通测试,或给出 curl 示例、演示调用方式。bug 修复——跑复现步骤,确认 bug 不再出现。重构——跑通所有测试、类型检查通过。性能优化——跑 benchmark,对比优化前后的数字。代码解释——不需要验收标准,解释清楚即可。
这张表的价值不在内容,在它的作用:它把"AI 说做完了"变成"我能不能自己验一遍"。
书里还专门写了边界情况,这是我没想到的细致:有些任务本身难以自动验证,比如"把代码写得更可读"。这种时候怎么办?书里的答案是——让它改完后做一次代码审查,解释每处改动的理由,由人工验收。
这一句很轻,但它承认了一个重要事实:不是所有任务都能自动验收,而剩下那些必须由人接。大多数 AI 编程书在这里会含糊过去,直接说"AI 会自己检查"。
但我要指出这张表最大的漏洞,书里没提:它的每一条验收标准,都默认"你的项目本来就有测试、有 benchmark、有类型检查"。功能开发要跑通测试——如果这个项目一个测试都没有呢?重构要跑通所有测试——如果没有呢?性能优化要跑 benchmark——如果没有基准脚本呢?
真实情况是:大量业务项目测试覆盖率个位数。在这种项目上,这张表是空的。所以这张表真正的前置条件是"工程基建及格",而这一点,恰恰是最多读者不具备的。书里应该在表下面加一句提醒,它没加。
五、唯一给了数字的一段:3 秒和 15 分钟
第 40 页,作者做了一次对照实验:同一个需求,两种写法。
写法 A(模糊):提需求只花 3 秒,但后续要花 15 分钟处理不符合预期的结果。
写法 B(清楚):提需求花 30 秒,一次对话就完成任务,总耗时少得多。
书里的结论是:提需求的时间和最终完成任务花的时间成反比。
这是全书唯一一处给出数字的地方,也是我读到时精神一振的地方——终于有作者愿意量化了。而且这个结论方向是对的,我在自己的工作里反复验证过:花在"把话说清楚"上的每一分钟,都能在返工里省回好几倍。
但这段的严谨性经不起追问:只有一个样本,没说任务复杂度,没说模型版本,没说"15 分钟"里包含多少等待时间、多少重述时间。严格讲这不算实验,算一次经验记录。
不过我认为它仍然值得信,原因是这个结论符合一个更普遍的规律:所有"前置成本"和"返工成本"的关系都是反比的,代码审查、写单测、需求评审,全都是这个形状。AI 只是把这条老规律的杠杆放大了——因为它的返工比你想象的更隐蔽:它不会报错,它会给你一个看起来跑通的错误答案。
这也解释了第 40 页那段代码对话为什么值得看:它让 Claude 只新建了 src/main/java/com/example/config/LoggingFilter.java,"现有代码没有任何改动",然后执行 ./.mvnw test,"全部 47 个测试通过,耗时 3.2 秒"。三个数字钉死了三件事:改了哪个文件、测试跑没跑、跑了多久。这就是好的验收长什么样——不是"我改好了",是"我改了这一个文件,47 个测试通过,3.2 秒"。
六、五个技能里,只有两个是"技能"
第 3 章介绍 Superpowers,列了五个核心技能:systematic-debugging(系统性调试)、test-driven-development(测试驱动开发)、writing-plans(先计划后执行)、verification-before-completion(完成前验证)、brainstorming(头脑风暴)。
我读完这五个的说明,判断是:只有两个算真技能,另三个是话术包装。
算真技能的第一个是 systematic-debugging。它给了一个可执行的动作序列:现象/期望/触发条件三段式描述 → 建立最小复现路径 → 隔离阶段(读具体文件,找到 checkAndDeduct 的查询与扣减之间没有锁保护)→ 按可能性排序给假设。这个序列换任何一个工程师来做都一样,它的价值是"强制不跳步"。
第二个是 verification-before-completion。第 60 页给的例子很具体:把"把会话从 Redis 迁到数据库"这个任务拆成 4 步,每步带验收标准——步骤 1 创建 user_sessions 表的 Flyway 迁移脚本,验收标准是 mvn flyway:migrate 执行成功且表结构与 DDL 一致;步骤 2 实现 Repository 和实体,验收标准是单测通过;步骤 3 切换 JWT 读写逻辑,验收标准是登录→访问受保护接口→退出全流程通过;步骤 4 迁移存量数据,验收标准是抽查 10 条记录数据一致。
而且每条完成都标 SUCCESS 或 FAIL,"出错后立刻停在那一处,不继续往下走"。这个设计解决的是 AI 编程最要命的一个毛病:它会带着一个错误往下走十步,然后告诉你全部完成。
剩下三个——TDD、writing-plans、brainstorming——在我看来不是技能,是态度。TDD 的前提是你先写测试,这是纪律不是技能;writing-plans 是"想清楚再动手"的另一种说法;brainstorming 是"先发散再收敛",一个提示词就能实现。它们被列成"技能",更像是为了凑成五个。
顺带说一句这一章的结构性风险:Superpowers 是外部的技能包(放在项目里的技能定义文件),不是 Claude Code 的内置功能。这意味着它随时会变——作者写这一章时的那套技能名、那套触发词、那套目录结构,读者半年后照着做可能对不上。工具书里凡是"依附于第三方仓库"的章节,都有保质期,而且通常不超过一年。读的时候要把这一章和前面的方法论分开看:方法论能留,操作路径会废。
同一章还提了两个命令:/loop 和 /schedule,用来自动循环和定时执行,让它在后台持续干活。这两个功能是这本书(或者说 2026 年上半年这一代工具)真正的分水岭——从"你问它答"变成"它自己在跑"。但书里对它们的描述只有一小节,而且没讲代价:后台持续跑意味着持续烧钱、持续改文件、持续可能改错。一个在后台跑了四小时的智能体,如果每轮都往你的分支上提交一次,你第二天要处理的东西比你自己写还多。
权限和回滚,是这类"自动化"章节唯一必须配的东西,而这一节没有。这是我认为第 3 章最该补的一段。
七、它帮不上忙的一张表,才是这本书的良心
回到开头说的第 26 页。1.7 节"Claude Code 帮不上忙的情况",是一张两列表:不适合的场景 / 原因。
我看到的几行是:实时交互的 UI 调试——看不到浏览器(需要借助 playwright 等插件),不能操控 DevTools,对于 CSS 布局或 React 渲染问题,不如自己在 DevTools 里调试。
只有这一页,只有寥寥几行。但这一页的存在本身,说明作者是站在读者这边的,不是站在工具那边的。
我之所以看重这一页,是因为它教了一种读工具书的方法:先翻"局限性"那一节,如果它写得比"功能"那一节认真,这本书可以信;如果局限性只有半页、全是"目前尚有不足,未来可期"这种话,那这本书是广告。
但这本书这一页也写得太短了。我按自己的经验,可以补三条它没写的边界:
第一,它读不了你的运行环境。本地跑得通、服务器跑不通的问题,它只能靠你贴日志。日志贴错一行,它给的方案就全错。
第二,它判断不了"这个需求该不该做"。你让它实现一个功能,它不会问你"这个功能有必要吗"。它会非常认真地帮你把一件不该做的事做得很漂亮。
第三,它对"历史包袱"没有感觉。一段看起来多余的兼容代码,可能是三年前某个客户的特殊要求。它看到"冗余",你看的是"血债"。它删得越干净,你越要紧张。
把这三条和我看到的书里那一条放在一起,边界清单就有四条了。四条不算多。一个诚实的作者应该能列到十条——因为工具的边界清单是最不容易过时的部分,功能半年一换,边界三年不变。可惜大多数作者把最该长的那一节写得最短,因为那一节不显本事。
这也是我给工具书打分时看得最重的一项:把"局限"写在第 26 页(而不是藏在附录的最后一页)、写得比"功能"更具体、并且承认有些事它做不了——满足这三条,作者就是站在读者这边的。这本书满足了前两条,第三条只满足了一行。所以它不是满分,但它的方向是对的。
八、它的短板
按惯例写短板,四条。
第一,案例全部压在一个技术栈上。Spring Boot、Spring Data JPA、Flyway、mvnw、JMeter,从头到尾一个 Java 后端项目。做前端的读者,看到 1.7 说"看不到浏览器"就已经到底了;做数据、做运维、做移动端的读者,例子几乎用不上。方法论可以迁移,案例不能。这本书的副标题是"从 Vibe Coding 入门到智能体工程",但实际给的是"Java 后端工程师的 Claude Code 入门"。
第二,七十屏没算过一笔账。没有一次提到 token 消耗、上下文窗口上限、订阅档位差异,也没提长任务的等待成本。工具书不谈成本,等于不谈可行性——因为读者真正要决策的是"这东西每月花我多少钱、值不值",不是"它能不能干"。一本教人用付费工具的书,通篇不提价格,这是结构性缺失。
第三,只写成功路径。1.6 的排障、2.4 的两种写法、3.3 的四步验收,全部是"这样做就对了"。没有一个"我这样做,结果它给我搞砸了"的案例。而 AI 编程的真实体验里,搞砸的比例不低:它自信地改错文件、自信地编一个不存在的 API、自信地说测试通过而其实没跑。这些坑比正确姿势更需要被写下来,而它们不在书里。
第四,前置条件没说清。前面提过:所有验收标准都依赖项目本身有测试、有 benchmark、有类型检查。这本书从头到尾没提醒读者"如果你项目没有这些,先补基建,否则这套方法对你无效"。它默认读者在一个健康工程环境里——这个默认,把大部分真实项目排除在外了。
最后说读法。
已经在用 Cursor 或同类工具的人:值得读第 2 章和第 3 章的两节(systematic-debugging、verification-before-completion)。你会发现自己一直在用"改进提示词"解决"流程没设计"的问题。
刚上手的人:第 1 章装环境的部分可以跳,直接看 1.6 的调试现场、1.7 的边界表和 2.2 的四要素。这三块读完,你的第一次实战会少走一半弯路。
不写代码、只是想知道 AI 编程到什么程度的人:读第 26 页那一页就够了。它告诉你 AI 现在能接手"执行",接不了"判断";而这本书最有价值的部分,全是关于怎么把判断做扎实的——四要素、验收表、先复现再猜。这些东西跟你用什么工具没关系,跟你愿不愿意在动手前多想三十秒有关系。
最后一句话:这本书真正教的不是怎么用 Claude Code,是怎么当一个能验收 AI 的人。前者会随着版本失效,后者大概能撑到你退休。
阅读记录:微信读书《Claude Code 实战:从 Vibe Coding 入门到智能体工程》,全书抓取 70 屏、覆盖第 1 章至第 4 章开头(p0082 起抓取中断,后续章节未读,如实标注)。逐页核对:p0006(前言,封装与判断层)、p0025(1.6 调试场景三假设与 1.7 边界表)、p0035(验收标准对照表、四要素组合示例)、p0040(写法 A/B 对照、47 个测试 3.2 秒、2.5 渐进式需求)、p0053(systematic-debugging,先复现后猜因)、p0060(verification-before-completion 四步验收)。2026-11-12。
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: