
大语言模型原理、微调与Agent开发:524 屏里,RAG 只占了 31 屏
微信读书《大语言模型原理、微调与Agent开发》(丁小晶 马全一 冯洋 著)· 逐页翻阅 524 屏 · 抓取标记 reached_end=True(end_reason=last_page,书尾落在"10.4 翻译系统评估与用户反馈迭代")· 阅读器共记录 51 个章块,十章四部分。
抽样说明:这本自称"原理 + 微调 + Agent"三件套,所以我按"理论—工程—微调—量化—应用—智能体"六条线抽读:p0006 前言结尾(核对书名与四部分结构)、p0012 大语言模型发展现状、p0038 应用开发基础的数据处理、p0050 React 计数器示例、p0068 P-Tuning 的虚拟标记、p0090 CUDA 矩阵乘法基准、p0140 FastAPI 情感分析接口、p0190 企业文档问答的微调与部署、p0230 TorchScript 编译与计时、p0255 电商客服需求分析、p0330 t5-small 代码修复微调、p0362 代码复杂度分析输出、p0370 图像特征与多模态入库、p0415 硬件知识库的"模型测试结果"、p0495 多语言翻译原理。
章屏数按阅读器顶部章标签切分,标签有滞后(约 ±2 屏),统计时按实际页位校正过;第 2 章末尾有一段 14 屏的标签回跳成"2.1 CUDA并行编程技术",实际内容是应用开发收尾,我把它并入了第 2 章。所有引文只来自上述页面,技术判断(比如某个模型属于哪个年代、某段代码能不能跑)是我自己的核查意见,不是书里的原话,凡属此类我都点明了。
524 屏,十章,51 个章块。
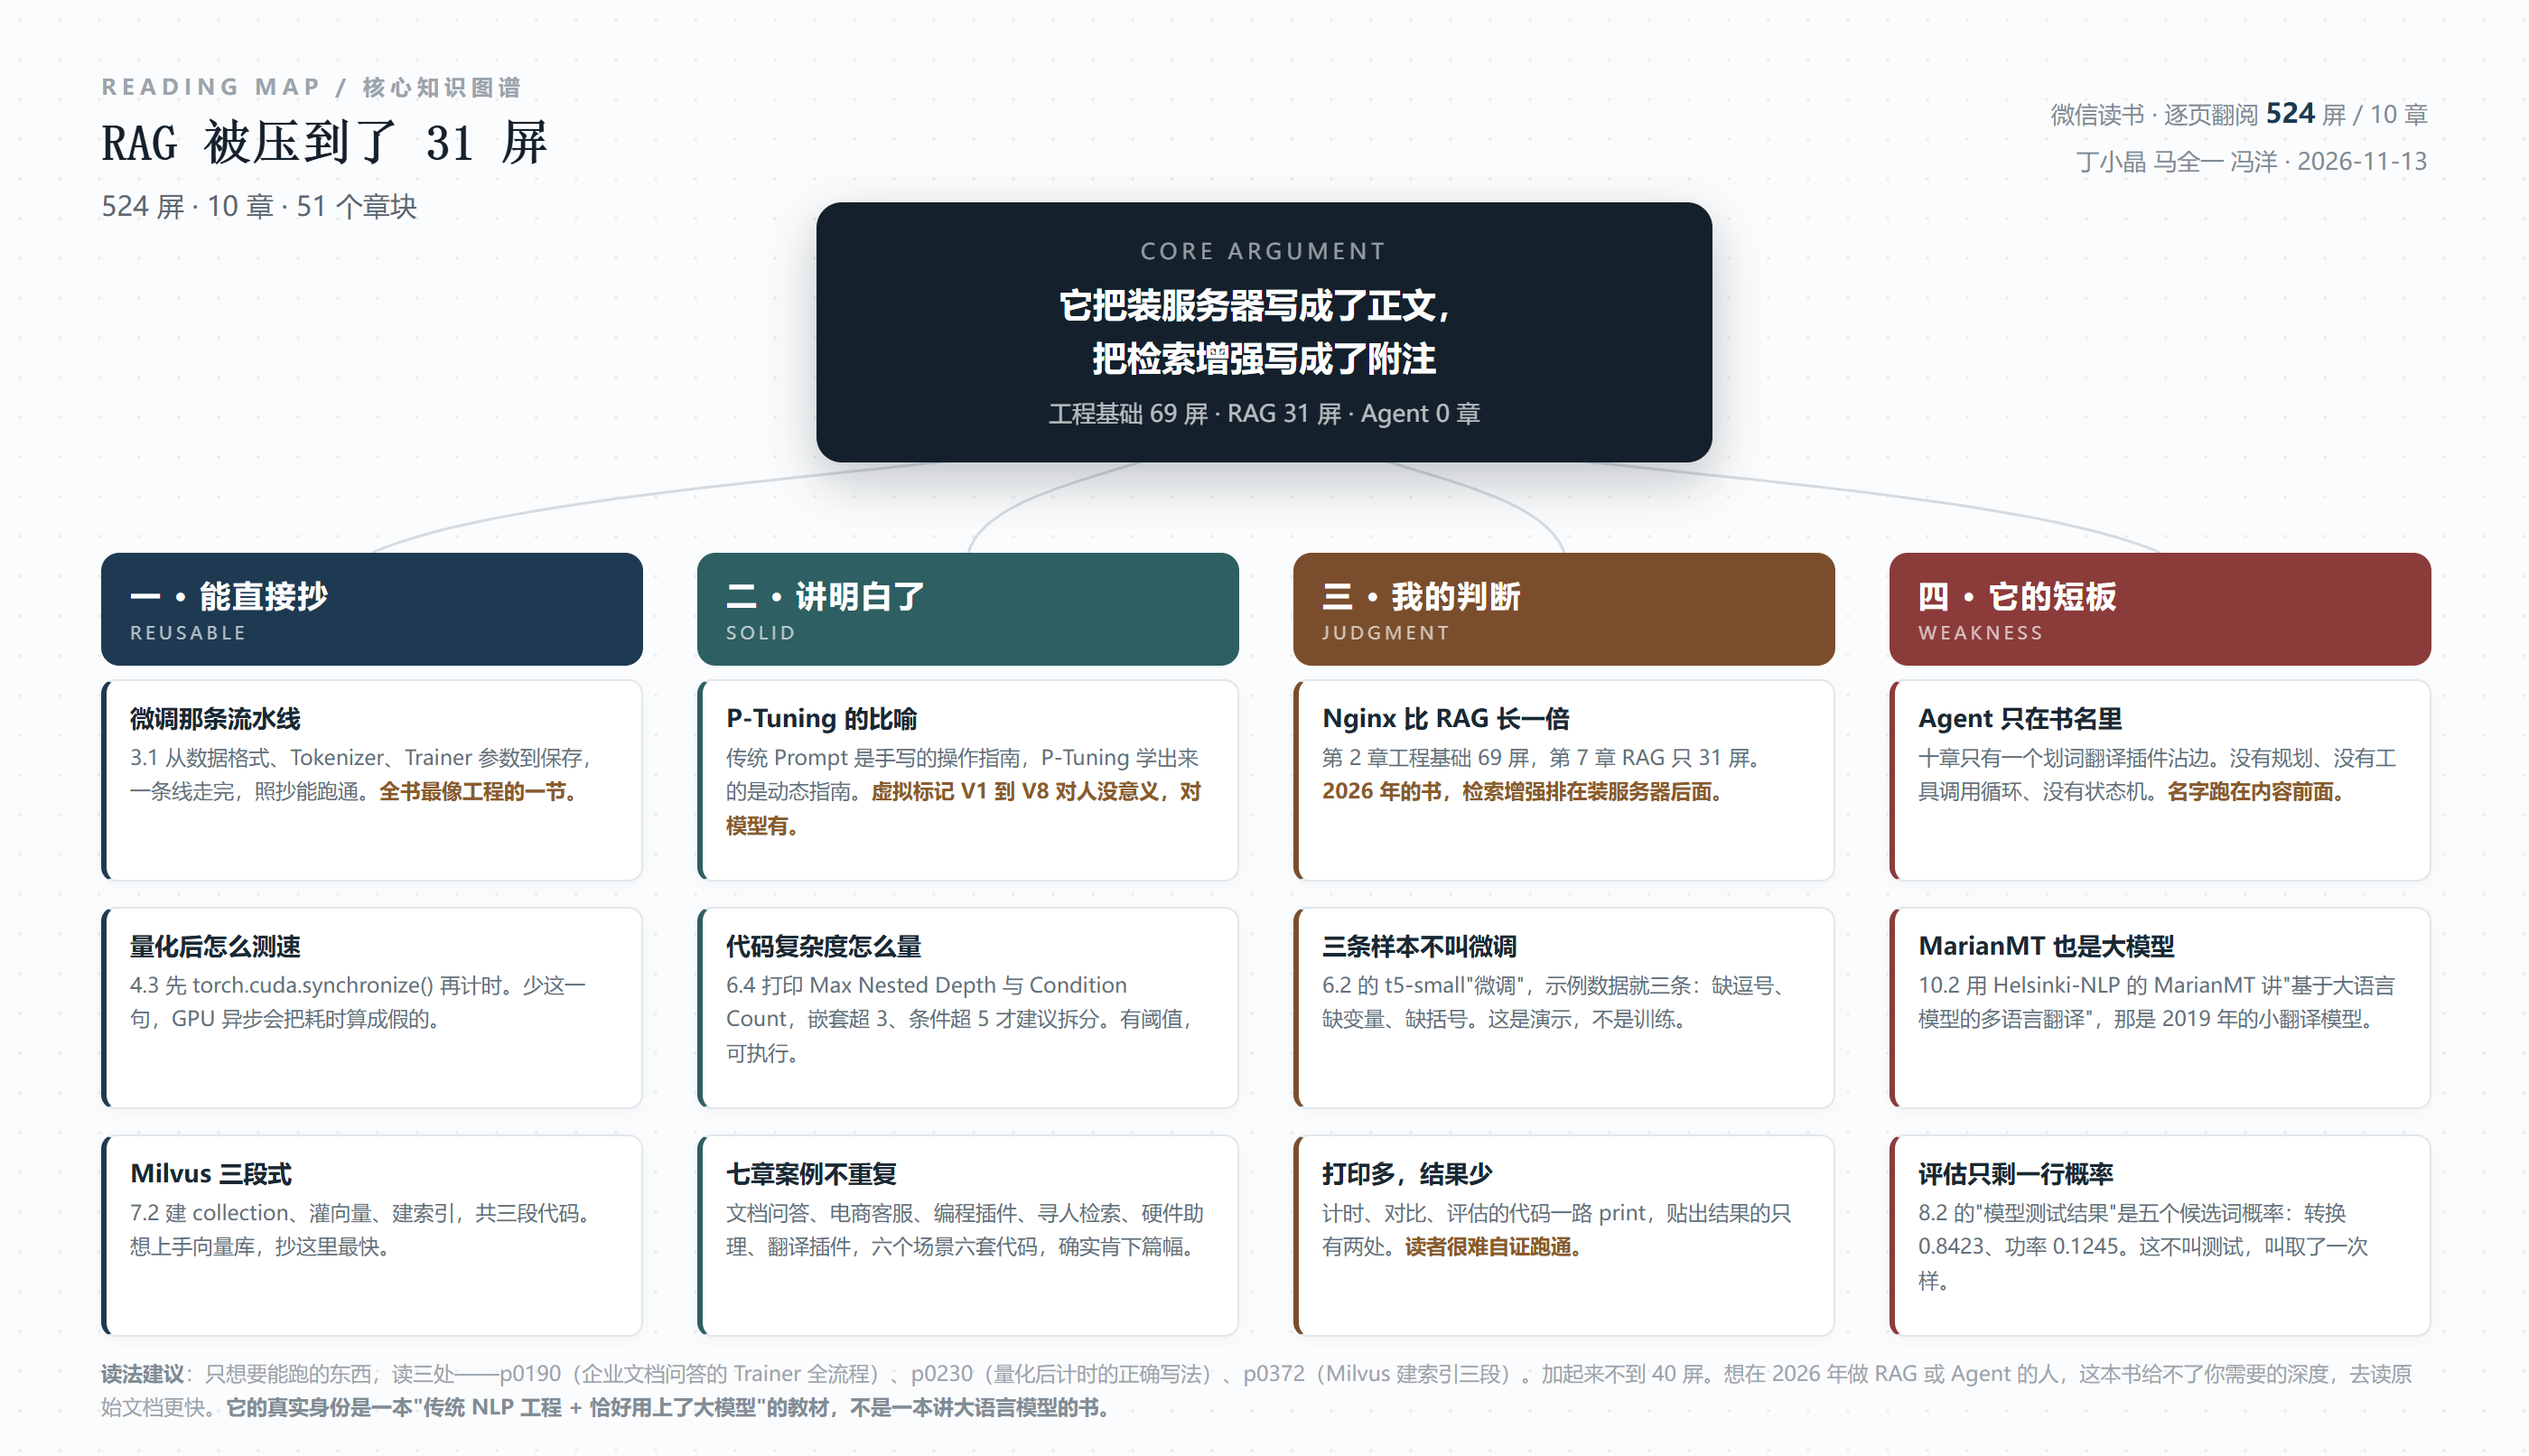
我先说结论:这是一本不差的教材,但它不是一本讲大语言模型的书。它是一本"传统 NLP 工程 + 恰好用上了大模型"的教材,然后被冠上了一个 2026 年的书名。
证据不在我的主观感受里,在它自己排出来的篇幅比例里。
一、先把这 524 屏摊开
按阅读器的章标签一路统计下来,十章的实际屏数是这样的:
第 1 章 大语言模型概述与训练原理 75 屏;第 2 章 大语言模型应用开发基础 69 屏;第 3 章 微调技术 44 屏;第 4 章 模型量化、编译与推理 55 屏;第 5 章 客服平台 56 屏;第 6 章 编程辅助插件 53 屏;第 7 章 RAG 应用开发 31 屏;第 8 章 LangChain 与硬件助理 46 屏;第 9 章 提示词优化 32 屏;第 10 章 划词翻译插件 49 屏。前面还有版权、作者简介、前言合计 14 屏。
加起来 524,对得上。
两个数字放在一起看,就有点刺眼:讲"应用开发基础"的第 2 章 69 屏,讲"RAG"的第 7 章 31 屏。前者是 CUDA 并行编程、PyTorch 建模、Nginx 服务器、Hugging Face 库四件套,后者是 2024 年之后这个领域真正在往前走的唯一方向。
一本 2026 年出版、书名里带"大语言模型"的书,给装服务器的篇幅是给检索增强的两倍多。
还有一个数字值得看:第 9 章"提示词优化"32 屏。在 2026 年,提示词工程已经从"玄学"退成"基本功",它退场的原因是大模型自己变强了,不需要你手把手教格式。可这本书仍然给了它一整章,篇幅跟 RAG 一样多。
这三个数字并排放——装环境 69、提示词 32、RAG 31——书的骨架就露出来了:它是一本写给"从零开始搭一个 AI 应用"的新手的书,不是一个写给"想搞懂大模型怎么用"的读者的书。
这不是我在挑刺,是它自己摆出来的账。四个部分的划分很规整——理论基础与开发准备、核心技术解析与优化、行业应用开发与实战、高级技术拓展与创新(9 到 10 章)——问题恰恰出在"开发准备"这一部分太厚,"核心技术"这一部分太薄。
二、先给账:它讲对了什么
批评之前,得先把它的长处说清楚,不然不公平。
第一处,是 1.3 节的数据处理。这一段把 tokenizer 的调用拆解得非常老实:把一句话喂进分词器,得到 input_ids 和 attention_mask,然后逐条解释——input_ids 是词表里的索引,attention_mask 标记哪些是有效输入、用来忽略填充部分;顺带把 return_tensors="pt"(返回 PyTorch 张量)、padding=True(短文本补齐,保证序列长度一致)、truncation=True(截断超长文本)三个参数一个一个讲明白。
这一段的价值在哪?在于它是绝大多数人第一次调用模型时真正会卡住的地方。很多同类书到这里就一句"用 tokenizer 处理后送入模型"带过,然后直接跳到 loss 曲线。这本书愿意花两屏解释"你传进去的那三个参数到底是干什么的",这个诚意我认。
而且它没有只停在参数表。它在末尾补了一句作用说明:把自然语言转化为模型可处理的张量数据,是模型推理或训练的基础步骤。这句话看似废话,但它把"分词"从"预处理的一个步骤"抬到了"模型入口"的位置——你在这一步截断的、补齐的、遮掉的东西,模型永远看不到。理解这一点,后面调 max_length 才不会瞎设。
第二处,是 6.4 节的代码复杂度分析。它给了一段能跑的实现,输出是这样的:
===代码复杂度分析结果 ===
Max Nested Depth: 2
Condition Count: 4
===优化建议 ===
无优化建议。
紧接着它给了判定阈值:嵌套深度超过 3,或者条件数量超过 5,才建议优化,方式是拆解函数或简化条件。
我特别喜欢这一段,因为它罕见地把"模糊的建议"变成了"可执行的规则"。工具类书最常见的毛病就是只说"要保持函数简洁",什么叫简洁?没人说。这本书说了:3 和 5。你不一定同意这个阈值,但你至少有了一个可以反对的对象。
第三处,是 P-Tuning 那一节的比喻。它把传统 Prompt 比作"手工编写的操作指南",把 P-Tuning 学出来的东西比作"动态指南",然后举了一个特别具体的例子:任务是回答"今天天气如何",传统 Prompt 写成"问题:今天天气如何?答案:",而 P-Tuning 变成"[V1][V2]问题:[V3][V4]今天天气如何?答案:[V5][V6]"。
然后它自己把话说明白了:这些虚拟标记对人类毫无意义,但模型通过学习能理解它们的含义。
这句话很轻,但它其实回答了很多人对 P-Tuning 的困惑——为什么一段人看不懂的乱码能让模型变好。答案是:因为这些乱码不是给人看的,是给连续向量空间里的位置用的。
第四处,得说句公道话:这本书对"门槛"的判断是准的。它默认读者只有 Python 基础,连 pip install 都写出来,连 attention_mask 是什么都要解释。对一个大三学生或者刚转行的工程师,这个起点是对的,不是所有书都得假设你会分布式训练。
三、第 2 章 69 屏:装服务器成了正文
现在说问题。
第 2 章的四节是:CUDA 并行编程技术、基于 PyTorch 的大语言模型构建方法、Nginx web 服务器开发、Hugging Face 的 Transformer 库。
CUDA 那一节写的是一个矩阵乘法的优化基准,1024×1024 的矩阵,block_size=128,分块计算,然后 torch.cuda.synchronize() 等所有 GPU 操作完成,最后打印标准方法耗时、优化方法耗时、加速比。代码本身没毛病,甚至可以说是规范的——知道要在计时前 synchronize,这个细节很多教程都漏。
Nginx 那一节讲 web 服务器开发,14 屏。
这两节加起来,说明一件事:作者是把它当成一门"AI 应用开发全栈课"来写的,从 GPU 内核一路铺到 web 服务器。作为一门课,这个覆盖面是完整的,学生学完确实能把一个模型部署成一个网站。
但作为一本书,这里有个问题:这些内容跟"大语言模型"没有因果关系。你做不做大模型,CUDA 分块矩阵乘法都那么写;你部不部署大模型,Nginx 的 conf 都那么配。它们是大模型应用的前置条件,不是大模型本身。
更要紧的是,这部分篇幅挤掉的是别的东西。
举个具体的例子。1.3 节讲完 tokenizer 之后,出现了一整段 React 代码——ApiData.js 里写 data.map((item) => ...) 渲染列表,App.js 里 import 进来挂到页面上,最后还贴了运行结果:"(1) 计数器界面:React 计数器示例"。
一段讲大语言模型应用开发的书,花了整整一屏教你怎么在 React 里渲染一个计数器。
我理解作者的用意:一个完整的应用得有前端。但读者翻开这本书,想看的是"大模型怎么用",不是"前端怎么写"。这一屏的信息量,对目标读者接近于零。而它挤掉的,可能正好是"为什么 temperature 会影响输出"这种真正属于这本书主题的内容。
还有一个更隐蔽的问题:这些章节的内容,时效性极差。Nginx 的配置十年不变,CUDA 的分块范式五年不变,这些写进书里是安全的。而真正会变的——模型版本、API 形态、框架接口——书里反而写得少。这是教材写作的一种保守策略:写不会变的东西,书就能活得久一点。代价是,读者拿到手的是一本活得很久、但跟他当下要解决的问题关系不大的书。
四、微调三章:流水线完整,可惜名字拼错了
第 3 章讲微调,三节:基于 LLaMA3 的微调、基于 GeMMA-7B 的微调、案例实战企业文档问答平台。
对,你没看错,书里写的是 GeMMA。这个模型的正式名字是 Gemma,Google 在 2024 年发布。全书从 3.2 节开始,一直到 4.3 节的量化,目录、正文、代码注释,统一写成 GeMMA-7B。
一个人的博客拼错无所谓,一本正式出版的技术书,一个模型名在目录里错了三次,这反映的是编辑流程里没有人真的跑过这些代码、也没有人对着官方文档核过一遍名字。
这不是小事,因为读者是要拿这些名字去 from_pretrained() 里填的。填错一个字母,报错信息会是"找不到这个模型",而读者第一反应会是"我环境有问题",然后在环境上折腾两小时。
内容本身呢?3.3 节的企业文档问答平台,是全书结构最完整的一个案例。它把 AutoTokenizer、AutoModelForQuestionAnswering、TrainingArguments、Trainer、pipeline 全部串起来,再加上 flask 起服务,从"文档加载"到"问答"走完一整条链路。小节标题写的是"3.3.3 微调、部署与性能测试",目标列了三条:微调预训练模型以适配企业文档问答场景、将微调后的模型部署为服务、通过性能测试验证系统的响应速度和准确性。
三条目标,前两条它做到了。第三条——性能测试验证响应速度和准确性——我需要单独说。
因为这是全书反复出现的同一个动作:把"测试"写成一段会 print 的代码,然后不贴结果。
第 4 章 4.3 节更典型。它把 Gemma-7B 用 TorchScript 编译一遍,保存成 gemma7b_scripted.pt,加载回来,eval(),然后计时:
start_time.record()
with torch.no_grad():
output_compiled = compiled_model(**inputs)
end_time.record()
torch.cuda.synchronize()
scripted_time = start_time.elapsed_time(end_time) # 毫秒
print(f"编译后模型推理时间:{scripted_time:.3f} 毫秒")
写法是对的。torch.cuda.synchronize() 放在计时结束之后,这比绝大多数教程规范。它还打印了未编译和编译后的 logits 前五项做对比,验证输出没被编译改变。
然后呢?然后下一页就是 4.4 节"量化模型与推理"。
没有编译前多少毫秒、编译后多少毫秒。没有加速比。没有 logits 对比的结果。读者拿不到任何一个数。
一段"性能测试"的代码,如果不给结果,它就不是测试,它是一份测试的草稿。你照着敲一遍,得到的是你自己的机器的数字,跟这本书一点关系都没有。
第 4 章一共 55 屏,讲量化的原理、LLaMA3 的量化过程、Gemma 的量化过程、量化模型与推理。55 屏里,我找不到一处"4bit 量化后显存从多少降到多少""困惑度涨了几点"这类最基本的量化账。量化这门手艺的核心就是拿精度换空间,不报这两个数,等于讲减肥不讲体重。
顺带一个观察:4.2 和 4.3 两节,一共 35 屏,讲的是同一个流程在两个模型上的执行——LLaMA3 一次,Gemma 一次。两次的差别只有模型名和路径。这 35 屏,如果写成"以 LLaMA3 为例,Gemma 的差异见下表",20 屏就够了,省下的 15 屏可以给第 7 章。这本书的篇幅问题,一半是这么浪费掉的。
五、第 5 到第 8 章:三个案例,一个比一个薄
第 5 章电商客服,56 屏,是全书最厚的一章。5.1 节的需求分析写得挺实在,把客服需求拆成多轮对话、FAQ、上下文理解三块,还解释了为什么多轮对话难:用户的咨询往往不是独立问题,而是包含多个关联话题的连续交互,可能在问完商品特性后紧接着问库存和优惠活动,所以对话状态的准确追踪、意图识别和槽位填充必须一起做。
这段判断是对的。做过客服机器人的人都知道,难的不是单轮答对,是第二轮别忘了第一轮说了什么。而且它明确写出了"槽位填充"这个词——说明作者知道这套东西的工程实现叫什么,不是泛泛而谈。
但 56 屏里,真正落到"上下文怎么管"的只有 5.4 节 11 屏。剩下的是需求 9 屏、数据清洗 13 屏、模型选择与微调 12 屏、API 与部署 11 屏。也就是说,这一章自己认定的最核心难题,占了全章的五分之一。
第 6 章编程辅助插件,53 屏,6.2 节"编程语言模型微调:从代码生成到Bug修复"值得单独拿出来。它的做法是拿 t5-small 做序列到序列的微调,示例数据是这样的三条:
# 示例数据:输入为带有错误的代码,目标为修复后的代码
data = {
"input": ["def add(a b): return a+b", # 缺少逗号
"def square(x): return xx", # 错误变量名
"print( Hello World" # 缺少括号
], ...}
三条样本,训练一个代码修复模型。
我知道这是教学示例,不是生产方案。但"三条样本"和"微调"这两个词放在一起,会产生一个很坏的暗示:让读者以为微调的门槛是"找几条数据"。真实情况正相反——微调的全部难度都在数据上:要几千到几万条、要覆盖错误类型、要有难例、要清洗掉模型本来就会的简单样本、要留出验证集防止过拟合。这些一个字没讲。
而且 t5-small 是 6000 万参数级别的模型,用它做代码修复,输出质量的上限摆在那。书里选它,我猜是因为它小、能在笔记本上跑。这个取舍可以理解,但书里应该明说:"这里用小模型是为了演示流程,真实场景请换 7B 以上的代码模型。"它没说。
第 8 章硬件开发工程师助理更值得说。它用 LangChain 串知识检索到问题解答,8.2 节讲硬件知识库构建与预训练模型微调,然后给出了"模型测试结果":
模型测试结果:
候选词:转换,概率:0.8423
候选词:功率,概率:0.1245
候选词:电能,概率:0.0341
候选词:热量,概率:0.0029
候选词:电流,概率:0.0017
停在这五行上想一下。
这是一个"硬件领域微调"的评估结果。它给的是五个候选词在某个位置上的概率分布。第一名 0.8423 是"转换",第二名 0.1245 是"功率"。
这说明什么?说明模型在一句话的某个位置上,有 84% 的概率接"转换"。这连"答对了一道题"都算不上,这只是一次前向传播里 softmax 的输出。
它不能告诉你:模型在 100 道硬件题上答对了几道;微调前答对几道、微调后答对几道;在不同温度下稳定性如何;遇到没见过的术语会不会编;把知识库更新之后,旧答案会不会被污染。
一个领域微调项目,评估手段只有一次取样的 top-5 概率,然后结论写"通过领域微调,模型能够更好地理解硬件领域专有术语"。这个结论,用这五行数据推不出来。
我把这一段当成整本书的缩影:它知道该做什么(微调、测试、评估),也有能力把代码写出来,但它不愿意花篇幅把"做完之后到底怎么样"交代清楚。因为交代清楚需要真的跑,真的跑需要真的有一块 GPU 和几天时间。
六、RAG 只有 31 屏,这是全书最刺眼的地方
第 7 章,标题是"RAG应用开发:复杂场景下的寻人检索数据库"。
三节:7.1 应用场景分析:寻人检索需求与数据库构建,8 屏;7.2 数据嵌入向量化与存储:使用 Milvus 构建检索索引,7 屏;7.3 检索模块开发:从语义搜索到多模态查询,15 屏。合计 31 屏,占全书 5.9%,是十章里最薄的一章。
先给个参照:第 9 章"提示词优化"32 屏,比 RAG 还多一屏。
在 2026 年,这个比例意味着什么?意味着这本书把"怎么跟模型说话"和"怎么让模型知道你的资料"放在了同一个权重上。而业界的共识恰恰相反:提示词的收益已经很低了,检索的收益还很高。
7.2 那 7 屏,其实是全书最像工程的地方。建 collection、灌向量、建索引,三段代码,没有废话。想上手 Milvus 的人,抄这里比看官方文档快。
但 7 屏讲完一个向量数据库,意味着它只能讲"怎么调用",讲不了"为什么"。分片怎么切、索引类型怎么选、召回率和延迟怎么权衡、元数据过滤放在检索前还是检索后——这些才是 RAG 真正的工程量所在,一个都没进去。
7.3 的多模态部分,我需要单独说,因为它涉及一个技术判断。
书里的做法是:用 ResNet-50 提图像特征,把图像归一化到 224×224、按 ImageNet 的均值方差标准化,取模型输出做特征向量,然后——把文本 embedding 和图像特征直接拼进同一条记录里入库:
def store_multimodal_data(collection, text_embeddings, image_features):
ids = list(range(1, len(text_embeddings) + 1))
multimodal_data = text_embeddings + [image_features]
collection.insert([ids, multimodal_data])
这里有三个问题,都是硬问题。
第一,ResNet-50 是 2015 年的 ImageNet 分类模型。它的特征空间是为"这是猫还是狗"训练的,不是为了"这张脸是不是失踪者"训练的。用人脸检索场景套 ResNet-50,等于用体重秤量身高——能出数,但那数没意义。人脸检索该用的是 ArcFace、CosFace 这一类度量学习模型,2026 年做寻人检索不用它们,属于基础知识缺环。
第二,文本 embedding 通常是 768 维或 1024 维,ResNet-50 的全局池化输出是 2048 维。两段向量拼在一起丢进同一个向量空间做相似度检索,前提是它们已经被对齐到同一个语义空间。CLIP 之所以要做对比学习预训练,干的就是这件事。直接拼,就是假设"没对齐也算对齐"。检索时文本查询会找到一堆向量长度接近但语义无关的记录。
第三,代码本身是把 image_features 当成一个元素 append 到列表里(text_embeddings + [image_features]),这个写法在 Python 里会把整个特征数组当成列表的一项。真跑起来,Milvus 那一步大概率会报维度不匹配。
这三个问题叠在一起,说明这一节是从别处搬来的思路,但没有真的跑通过。
而这一节所在的章,只有 31 屏。31 屏讲不完 RAG,正如同 7 屏讲不完向量数据库。
七、Agent 只在书名里
书名最后三个字是"Agent开发"。
全书十章,跟 Agent 沾边的只有第 10 章:文本文档划词翻译插件。四节——需求设计 20 屏、翻译模型微调与多语言支持 10 屏、插件开发与跨平台兼容 11 屏、翻译系统评估与用户反馈 8 屏。
一个划词翻译插件,是不是 Agent?按最宽的定义,能感知输入(划词)、能调用模型(翻译)、能输出结果(回填),算一个极简的"工具型助手"。按业界现在的用法——规划、工具调用循环、状态管理、多轮自主决策——它一个都不沾。
书里没有讲:Agent 的循环怎么写,工具怎么注册与选择,多步任务的中间状态存在哪,失败了怎么回退,上下文超长了怎么压缩。这些是 2024 到 2026 年所有人做 Agent 时真正在解决的东西,这本书一处没碰。
更说明问题的是 10.1 节。它花了 20 屏做"文档翻译场景分析与划词翻译需求设计"——是全书单节最长的一节之一。20 屏的需求分析,配 8 屏的评估。这个比例本身就是答案:这本书更愿意写"想清楚要做什么",不太愿意写"做完之后好不好"。
10.2 节更能说明问题。标题叫"翻译模型微调与多语言支持实现",正文第一句是"多语言翻译基于大语言模型的核心原理在于通过大规模语料训练,使模型具备跨语言的理解与生成能力",然后举的例子是 Helsinki-NLP 的 MarianMT。
MarianMT 是 2019 年前后的神经机器翻译模型,几十到几百兆参数,专门做句子级翻译。它不是大语言模型,它是被大语言模型取代的那一代技术。
用 MarianMT 演示"基于大语言模型的翻译",就像用一台诺基亚演示"智能手机的触屏体验"——东西是好的,但它不是标题说的那个东西。
我不反对书里讲 MarianMT。它轻、快、单机可跑,对教学很友好。我反对的是把它叫作"大语言模型的多语言翻译"。这个称呼会误导读者:读完之后,读者会以为自己知道怎么用 LLM 做翻译,实际上他知道的是怎么用一个 2019 年的 MT 模型。
而这两件事的差别,在真实项目里就是生死。MarianMT 只会翻译你给的那一句,它不懂上下文、不懂术语表、不懂语气;LLM 做翻译的关键恰恰在"整篇喂进去、术语表放提示里、风格用少样本锁定"。这三种做法,这本书一种都没提。
八、它的短板
把批评收成四条。
第一,篇幅分配与书名不符。书名里三个词,原理、微调、Agent。原理 75 屏,微调 44 屏,Agent 0 章(只有第 10 章挂了个名)。而没写进书名的"开发环境搭建"(CUDA + PyTorch + Nginx + HF 库)拿了 69 屏,比微调和 Agent 加起来还多。读者买的是"大模型怎么用",收到的是"AI 全栈怎么入门"。
第二,全书没有一处真实的实验结果。这是最要命的一条。性能测试不给毫秒数,量化不给显存与困惑度,微调不给准确率,RAG 不给召回率,Agent 不给成功率。所有该出数字的地方,都停在了 print() 那一行。技术书的价值有一半在数据上,这一半是空的。
第三,代码存在明显的跑不通处。GeMMA 的大小写错了三次;7.3 的多模态入库把特征数组当列表元素 append,维度对不上;第 10 章标题写"基于大语言模型",例子是 MarianMT;6.2 用三条样本演示微调且不提数据量的真实门槛。这几处都不是学术分歧,是对一遍文档、跑一遍代码就能发现的问题。
第四,案例之间没有难度递进。六个案例——企业文档问答、电商客服、编程插件、寻人检索、硬件助理、翻译插件——听起来很丰富,但打开看,骨架高度相似:需求分析 → 数据准备 → 微调 → 接口封装 → 部署。第 5 章和第 8 章的代码结构几乎可以互换。真正的差异被压平了,读者学到的是"一套模板套六个场景",不是"六个场景各自的难点"。
再补一条软性的:这本书的行文是标准的教材腔。"本节探讨……""通过深入分析……展示……为……提供全面的技术支持"这类句子,一屏能出现三四次。它们不承载信息,只负责把段落填满。524 屏里,如果把这层壳刮掉,我估计真实内容在 350 屏左右。
还有一条判断,说给我自己听:这本书不是烂书,它是一本"错位"的书。它的写作方法、结构意识、代码规范都在及格线以上,问题全部集中在选择题上——写给谁、写到多少、写到哪停。这三个选择题答错了,后面写得再认真也救不回来。
九、这本书该怎么读
如果你已经决定要翻它,我给一条最省时间的路线。
只读三处,加起来不到 40 屏:
p0190 附近,3.3.3 企业文档问答的微调、部署、性能测试全流程。这是全书唯一一条从数据到服务的完整链路,把 Trainer 怎么配、flask 怎么起、pipeline 怎么接,一次看全。
p0230 附近,4.3 的 TorchScript 编译与计时。重点不是编译,是那句 torch.cuda.synchronize() 的位置。记住这个位置,你以后所有 GPU 计时都不会算错。
p0372 附近,7.2 的 Milvus 三段式。建集合、灌向量、建索引,抄下来就能跑,这是全书性价比最高的一节。
剩下 480 多屏,按需查。CUDA 和 Nginx 两节留给真的要部署的人;量化的两节可以看,但别指望拿到数字;第 5 到第 10 章的案例,挑跟你业务最近的一个看骨架就行,六个都读是浪费时间。
如果你是想搞懂 RAG 或者 Agent 的人,这本书可以直接跳过。它给不了你需要的深度——31 屏的 RAG 教不会你切分策略,0 章的 Agent 教不会你循环设计。去做一个真项目,遇到问题查框架文档,两周之后你懂的会比这本书多。
一句话收尾:这是一本把"能跑"当成终点的书——它教会你怎么把代码敲出来,却没打算告诉你敲完之后,它到底行不行。
阅读记录:《大语言模型原理、微调与Agent开发》,丁小晶 马全一 冯洋 著。微信读书逐页翻阅 524 屏 / 51 个章块 / 十章四部分,读到 10.4 节书尾(reached_end=True)。抓取与抽样核对日期 2026-11-13。本文所有引文与代码片段均来自上述截图页面;关于 ResNet-50 与 MarianMT 的年代判断、关于向量拼接需先对齐、关于 t5-small 参数量级的判断,是我的核查意见,非书中原文。
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: