
LangGraph 实战:800 屏的说明书,79 屏的设计课
微信读书《LangGraph 实战:构建新一代 AI 智能体系统》(张海立 著)· 逐页翻阅 800 屏 · 抓取标记 reached_end=True(end_reason=last_page,书尾落在"11.2.3 智能体应用的巨大潜力")· 阅读器共记录 181 个章块,十一章。
抽样说明:这是一本框架书,所以我按"概念—原语—交互—记忆—API—架构—平台"七条线抽读:p0006 专家赞誉(核对书名与推荐人)、p0012 前言(作者自述写作动机,这段很关键)、p0110 状态结构与自定义归约函数、p0215 流式处理与图 4-1、p0250 存档点与 get_state_history、p0305 语义搜索增强记忆、p0450 协调器—工作者工作流、p0600 并发与双重文本策略、p0660 Configuration 配置类解析、p0730 开放画布核心代码。
章屏数按阅读器顶部章标签切分,这本的标签粒度很细(181 个章块,小节级),所以单块只有 1 到 17 屏,标签滞后影响可忽略。所有引文与代码片段只来自上述页面;关于"平台绑定会降低迁移率""全书缺评测数字"这类判断是我的核查意见,不是书里的原话。
800 屏,十一章,181 个章块。
先说我的结论:这是近两年中文技术书里少见的、真的把一套框架讲到能上手的一本。它不水,代码是真的,概念是准的,作者知道自己在写什么。
但它有一个结构性的错位:它是一本优秀的"框架说明书",却不是一本及格的"智能体设计书"。而书名承诺的是后者。
我用篇幅把这个判断摆出来,你自己看。
一、800 屏是怎么分布的
按章统计:前置(版权、内容简介、推荐序、专家赞誉、前言)21 屏;第 1 章 AI 智能体的原理和机制 44 屏;第 2 章 LangGraph 框架概览 30 屏;第 3 章 状态图结构 115 屏;第 4 章 交互体验 73 屏;第 5 章 记忆系统 64 屏;第 6 章 核心 API 72 屏;第 7 章 架构设计与模式应用 79 屏;第 8 章 LangGraph 平台介绍 145 屏;第 9 章 开发模板 69 屏;第 10 章 官方应用案例 71 屏;第 11 章 技术展望 17 屏。
加起来 800。
这张表里有两个数字要单独拎出来。
第一个:第 8 章"平台介绍"145 屏,是全书最长的一章。它讲的是 LangGraph Platform——部署选项、应用格式、Cloud SaaS、自托管、Docker、本地测试、Studio、语义搜索、运行时重建图、Agent Protocol、Assistant/Thread/Run 三件套、并发策略、身份验证与授权、RemoteGraph、React Hook。
第二个:第 7 章"架构设计与模式应用"79 屏,是全书唯一在讲"一个智能体系统该怎么搭"的章节。提示链、路由、并行化、协调器—工作者、评估器—优化器,加上主管/分层/网络三种多智能体架构。
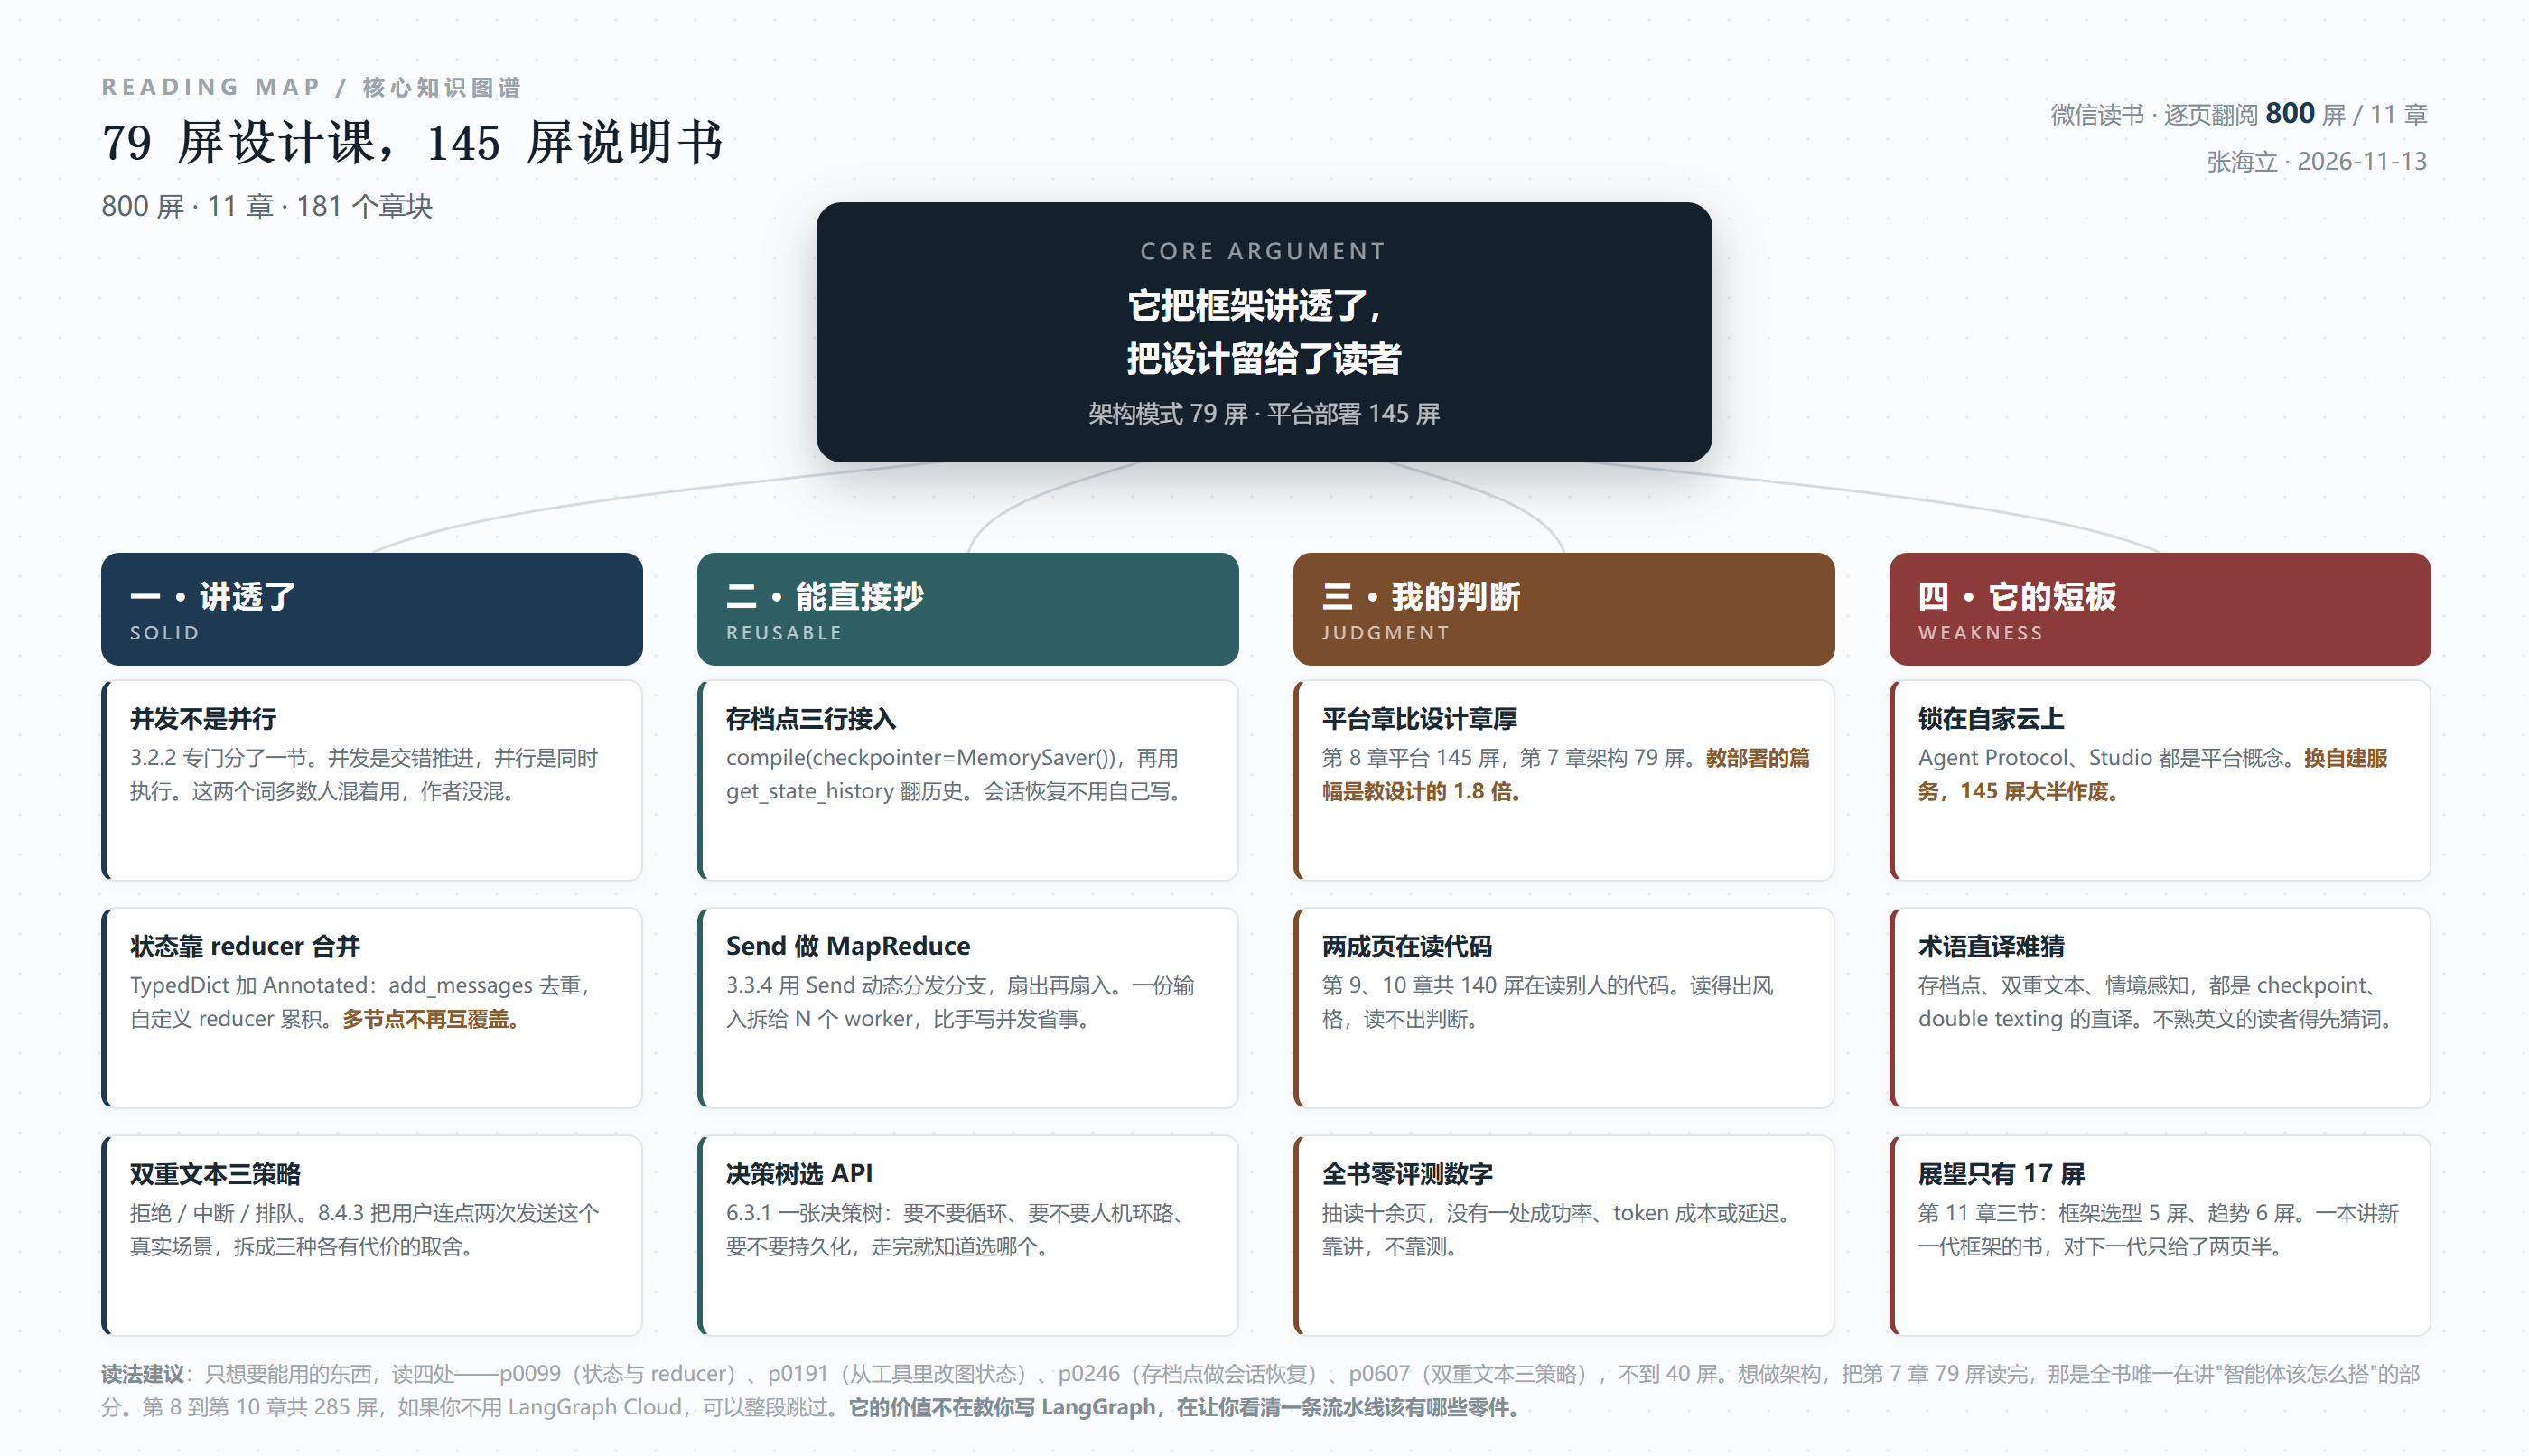
145 比 79。教你怎么部署的篇幅,是教你怎么设计的 1.8 倍。
再算一笔:第 9 章模板 69 屏 + 第 10 章官方案例 71 屏 = 140 屏,基本是"逐段读别人的代码"。加上第 8 章的 145 屏,与平台和现成代码相关的部分合计 285 屏,占全书 35.6%。
换句话说,这本书三分之一还多,在教你怎么用 LangGraph 这个产品;真正在教你怎么想清楚一个智能体的,只有不到十分之一。
二、它为什么非要这么写:一句很诚实的自述
在下判断之前,得先看作者自己怎么说的。前言里有一段,我认为是整本书的钥匙:
尽管 LangGraph 官方提供了丰富的资料和课程,但这些内容基本上以英文为主,且信息较为分散,对于希望快速切入 Agent 应用开发的国内开发者而言,存在一定的学习门槛。
这句话解释了这本书的全部取舍。
它要解决的问题不是"没人知道智能体该怎么设计",而是"中文世界里没有一条从零到部署的完整路径"。前一个问题需要洞察,后一个问题需要耐心。这本书选了后者,而且做得很好。
同一段前言里还有两个信息值得记:一是体例的延续性,作者上一本写的是《LangChain 实战:从原型到生产,动手打造 LLM 应用》,这本是它的进阶篇;二是作者明确说了,LangGraph 虽然和 LangChain 同属一个生态,但本身可以独立使用,读者不需要 LangChain 的使用经验。
第二条很重要,因为很多人在网上看到"LangGraph 是 LangChain 的扩展",就以为必须先学 LangChain。作者在开头就把这个误解拆了。
所以我的批评不是"这书写错了",而是"这书把力气用在了对的地方,但那不是书名暗示的地方"。
三、最硬的一章:状态与 reducer
第 3 章 115 屏,是全书技术密度最高的一章。它的核心是一个问题:多个节点同时往一个共享状态里写东西,怎么不打架。
答案是把"怎么合并"从节点里挪出来,写进类型标注。书里给了这样的代码:
class ChatState(TypedDict):
message_history: Annotated[list[BaseMessage], add_messages]
user_intent: str
tool_output: str
item_list: Annotated[list[str], reducer_extend_unique] # 应用自定义归约函数
然后它解释了这个机制的效果:当有节点尝试更新 ChatState 中的 item_list 键时,LangGraph 会自动调用 reducer_extend_unique 函数来进行状态合并,确保 item_list 中的元素是唯一且累计添加的。
这十几行,是整本书最值钱的部分之一。
为什么?因为它是"类型即契约"这个思路的一个干净实现。传统写法里,你会在每个节点函数内部手动读列表、判重、再写回;五个节点就有五份判重逻辑,改一次判重要改五处。而这里,判重逻辑写在类型标注里,节点只管 return {"item_list": [...]},合并规则由框架统一执行。
这个设计有一个隐含的代价,书里没明说:它把"状态变更"从命令式变成了声明式,调试的时候你不能顺着代码看数据怎么流,只能去查 reducer 的定义。新手第一次遇到"我明明只返回了两个元素,状态里怎么变五个了"的时候,会卡很久。
书里在 3.1.1 花了 17 屏讲状态,篇幅是这个机制该得的。
四、"并发不是并行"这一节,值得单独抄下来
3.2 节讲流程控制,里面有两个小节,我认为是全书对概念最清醒的一段。
3.2.1 讲并行分支的扇出与扇入。3.2.2 的标题是"并发而非并行"。
这两个词在中文技术圈被混用得一塌糊涂。作者专门分了一节来讲它们的区别:并发是多个任务交错推进、共享同一段时间,并行是多个任务在同一时刻真的同时执行。在 LangGraph 这种以图为核心的编排框架里,你写下的"并行分支",实际得到的往往是并发——因为底层可能只有一个模型端点、一个线程池,任务是被调度着交错跑的。
为什么这个区别重要?因为它决定了你怎么估算延迟。如果你以为三个分支是并行的,你会预期总耗时等于最慢那个分支;实际如果是并发加限流,总耗时可能是三个相加再打个折。线上第一批超时报警,多半来自这个误判。
紧接着 3.2.3 讲递归限制与并行分支——这是并发带来的第二个坑:一个带环的图如果被并行触发,递归计数怎么算。这一节没有给答案,它给的是"这里有问题,你得管"。
我喜欢这种写法。技术书最难得的不是说"这个 API 怎么用",而是说"这个 API 会让你在哪里翻车"。
同类的段落还有几处:3.5.5 处理工具调用错误(工具报错时状态怎么走)、3.5.6 从工具中更新图状态(工具不只是返回值,还能改状态,这个能力很危险也很强)、6.2.6 常见陷阱(Functional API 里最容易踩的坑)。这几节加起来不到 20 屏,但它们的价值超过后面 285 屏的平台说明书。
五、第 4 到第 6 章:交互、记忆、API
第 4 章 73 屏讲交互体验,三件事:流式、持久化、人机环路。这三件事恰好是一个智能体从"能跑"到"能用"必须跨过的三道坎。
流式那节,图 4-1 画得清楚:用户请求进来,LangGraph 处理,然后按数据类型分流成值流、更新流、自定义流、消息流四种,再实时传到界面。四种流对应四种前端需求——值流给你完整快照、更新流给你增量、自定义流给你自己的进度条、消息流给你逐字打字效果。它还提醒了一句容易被忽略的:用 graph.stream() 时如果不指定 subgraphs=True,子图的输出不会被流式传输。
这一句是真踩过坑才写得出来的。子图是这本书反复推荐的模块化手段,但子图和流式放在一起就有这个暗坑,官方文档里散落在两处,书里把它们放一起说了。
持久化那节 13 屏,讲线程与存档点的概念、存档点器的实现、以及实际应用。核心就一行:
graph = (
StateGraph(State)
.add_node(refine_topic)
.add_node(generate_joke)
.add_edge(START, "refine_topic")
.add_edge("refine_topic", "generate_joke")
.compile(checkpointer=MemorySaver())
)
compile(checkpointer=MemorySaver()),一行接入存档点。之后 get_state_history() 能列出这个线程的完整执行历史,最新状态快照排在最前。
这里有一个设计上的取舍,书里点到了但没深挖:MemorySaver 是把状态存在内存里的。进程一重启,全部会话丢失。生产环境必须换持久化后端(SQLite、Postgres 之类)。书里在"持久化的实际应用"里应该提到了,但从抽读的页面看,重点放在了怎么用,而不是"什么时候不能用"。
第 5 章记忆系统 64 屏,是全书最有意思的一章。它把记忆分成短期(对话连贯性)和长期(跨会话),然后给了三层递进:基础存储操作、语义搜索增强检索、构建自定义记忆存储。
语义搜索那节举的例子很具体:把"附近有什么好吃的餐馆"和"当地美食推荐"关联起来,因为这两句字面不同、语义相近。它解释了原理——向量嵌入 + 余弦相似度。
但我得说句实话:这一节讲的是"语义检索能做什么",不是"语义检索什么时候会骗你"。真实的记忆检索里,最麻烦的是相似但不相关——用户上次问"这家店的退款政策",这次问"这家店的退货政策",语义上高度相似,可这是两个不同的问题。书里没有讨论这种负例。
第 6 章 72 屏讲核心 API,把 create_react_agent 和 Functional API 两套写法并排讲,最后用一张决策树帮你选:要不要循环、要不要人机环路、要不要持久化,走完就知道选哪个。
这个安排是对的。LangGraph 现在有两套写法(Graph API 和 Functional API),新手最容易的困惑就是"我该用哪个",官方文档给了对比表,但对比表是罗列特性,决策树是给判断路径。书里选了后者,这是"书比文档强"的地方——书可以替你排序。
六、第 8 章 145 屏:这是一本平台说明书
现在说那一章最厚的。
第 8 章从 LangGraph 平台的架构与核心概念讲起,然后是部署选项、应用格式定义、部署到 Cloud SaaS、自托管、自定义 Docker、本地测试、LangGraph Studio、向部署中添加语义搜索、运行时重建图。再往下是 Agent Protocol——标准化的需求和核心组件、API 细节、助手和助手 API、数据格式与可扩展性,以及"助手、线程和运行"的应用示例,10 屏。最后是高级功能:可观测性与调试、人机环路、并发和双重文本策略;访问控制:身份验证授权、自定义实现、常见访问者模式;RemoteGraph 和 React Hook。
这一章里,我认为最值得读的是 8.4.3"并发和双重文本策略"。
"双重文本"(double texting)这个词,讲的是一个特别真实的场景:用户在等智能体回复的时候,又发了一条消息。现实世界里这太常见了,而绝大多数自己手写的 Agent 服务,遇到这种情况会直接崩——两个请求同时往同一个线程写状态。
书里给的三种策略是:
拒绝(reject):线程已有运行处于活动状态时,立即拒绝新的运行请求,向用户发出"智能体当前正忙"的信号。
中断(interrupt):出现新请求时取消当前运行,让新请求先执行,被中断的运行标记为"interrupted",但历史记录会被保留。
排队(enqueue):把新请求放入队列,按接收顺序依次执行。
这三种策略,每一种背后都是一种产品哲学。拒绝是最省事也最粗暴的,用户体验最差;中断是"最新优先",符合聊天的心智,但用户刚打的字白费了;排队最公平,但如果智能体一次要跑三十秒,用户会以为卡死了。
书里把三种都列出来,把代价写清楚,不给结论。这个处理很成熟——因为选哪个取决于产品,不取决于框架。
但这一章的其余部分,问题就来了:它几乎全部绑定在 LangGraph Platform 上。
Agent Protocol 是平台的服务协议,Assistant / Thread / Run 是平台的三级对象模型,Studio 是平台的调试工具,访问控制是平台的身份体系。如果你像大多数国内团队一样,自建一个 FastAPI 服务、把图包在里面、自己接数据库做存档点,那么这 145 屏里能直接用的,大概只有"并发与双重文本策略"的思辨部分和"可观测性"的一些原则。
真正能落地的代码,可能不到 20 屏。
这不是作者的错。LangGraph 的平台本来就是这套框架的价值锚点,官方也希望你用它。但对一个中国读者来说,这 145 屏的期望收益,被一行没写出来的话打了折:你需要先有一个能用 LangGraph Cloud 的账号,以及一张能付美元账单的卡。
七、第 7 章那 79 屏,才是这本书真正值钱的地方
我想把第 7 章单独拎出来说,因为它被夹在 115 屏的原语和 145 屏的平台之间,最容易被读者跳过去,而它恰恰是唯一在回答"该怎么想"的一章。
它的结构是两层。第一层是单智能体的工作流:增强型 LLM(一切的基础构件)、提示链、路由、并行化、协调器—工作者、评估器—优化器。第二层是多智能体:主管架构、分层架构、网络架构。最后加一个"情境感知智能体架构",把前面这些拼成一个完整设计的样例。
协调器—工作者那一节给的是能跑的代码:把 orchestrator、llm_call、synthesizer 三个节点加进图,用 add_conditional_edges 从协调器连到工作者,条件边里用 Send API 动态创建工作者节点,最后从工作者连到合成器,覆盖 END。这段代码的价值不在语法,在于它示范了一件事:图的形状是可以由运行时决定的——一个任务要几个 worker、每个 worker 处理哪一块,不是写代码时固定的,是协调器根据输入临时决定的。
这是"图编排"相对"链式调用"的根本优势。链式调用(LangChain 的 LCEL 那套)适合固定的流水线,图编排适合"步骤数量取决于输入"的任务。书里没有把这句话直接写出来,但这 7 屏讲的就是它。
评估器—优化器那 9 屏,是另一个我认为被低估的模式:一个模型生成,另一个模型打分,不合格就打回重生成,直到达标或者超过循环上限。这个模式在真实业务里极其常用——写文案、改代码、校对翻译,几乎都是这个结构。书里给了实现,也给了循环上限的位置,但没有讨论最关键的那个问题:评估器的标准从哪来。
评估器是这套结构的地基。如果打分标准是"你写得对不对",评估器就会倾向于说"对";如果标准是"是否符合下面这十条检查项",它才有约束力。书里停在"有评估器这个角色",没走到"评估器的标准该怎么写"。这中间隔着的,正是从"能跑"到"能用"的距离。
多智能体那三种架构(主管、分层、网络)梳理得清楚,尤其网络架构那 8 屏,讲的是"谁都可以跟谁说话"这种去中心结构什么时候会失控——消息在 agent 之间来回传,没人负责收敛,成本和延迟一起炸。这个提醒很实在。
需要说句公道话:这一章的模式划分,大框架来自业界那篇流传很广的智能体设计总结(提示链、路由、并行、协调器、评估器优化器这套分类)。书做的事是把它 LangGraph 化,给出每种模式的本地实现。这是翻译工作,不是原创工作,但翻译得准确、落到代码,本身有它的价值——毕竟那篇文章是英文的,而且不给代码。
可惜的是它没做本土化。这些模式在英文语境里的成本假设,跟国内不一样:他们的模型调用按美元计价、按 token 计费,评估器多跑一轮就是多花一笔钱;我们的选择更多是本地部署的开源模型,多跑一轮的成本是显存和延迟,不是账单。同一套架构,权衡点完全不同。这一层,书里一个字没提。
八、它的短板
收成四条。
第一,结构跟着 API 走,不跟着问题走。第 3 章是原语字典(状态、节点、边、命令、分支、子图、工具、可视化),第 6 章是 API 字典(create_react_agent、Functional API、选型),第 8 章是产品文档。这三章加起来 332 屏,占 41.5%,全是"这个功能是什么、怎么调"。真正的设计方法论在第 7 章,79 屏。
结果是:读者读完能写代码,但说不清为什么这么搭。等到业务变了、要在图里加一个新环节,他会去翻书找"有没有类似的例子",而不是"我的流程该拆成几个节点"。这正是"说明书"和"设计课"的区别。
第二,全书没有一处评测数字。我抽读的十余页里,看不到任何一个智能体在任务上的成功率、平均执行步数、token 成本、端到端延迟。这本书讲了怎么开可观测性、怎么调试,却没给出一份"开了之后你该看到什么数"的参照。对做技术选型的人来说,这是最缺的一块——因为你决定要不要上 LangGraph,靠的恰恰是这些数。
需要说清楚:这不是这一本书的问题,整个中文 LangGraph 书都这样。原因也简单,做评测要跑基准、要花钱、要写实验设计,这已经超出"写一本书"的成本结构了。但读者付的是书的钱,理应知道这个缺口。
第三,术语直译,把理解成本转给了读者。checkpoint 译成"存档点",double texting 译成"双重文本",situational awareness 译成"情境感知",reducer 译成"归约函数"。这些译法都不能算错,但它们和英文原词的对应关系不直观——你在代码里看到的是 checkpointer,在书里看到的是"存档点",中间隔着一层。
对熟悉框架的人无所谓,对刚上手的人,这一层翻译成本会实际拖慢速度。更好的做法是首次出现时写成"存档点(checkpoint, checkpointer)",之后统一用哪个都行。这本书在部分地方做了,但没有贯彻到底。
第四,展望只有 17 屏。第 11 章三节:多智能体开发框架的选择(框架特性介绍 5 屏、框架选型分析 3 屏)、智能体发展趋势(基础模型进步 2 屏、应用潜力 3 屏)。
一本讲"新一代"框架的书,对"下一代是什么"只给了两页半。而框架选型那 8 屏,恰恰是很多人最想看的——AutoGen、CrewAI、LangGraph 到底怎么选。8 屏讲三个框架,每个不到 3 屏,只能是蜻蜓点水。
这里我要给一个反向的公道话:短,也可能是因为作者不想吹。技术书的"展望"章最容易变成科幻小说,作者压到 17 屏,反倒显得克制。但克制到这个程度,读者该得到的判断就没给够。
九、这本书该给谁,该怎么读
先说该给谁。
如果你已经在写 Agent,被自己手写的 while 循环、上下文拼接、状态管理折磨过一轮,这本书非常适合你。你会带着具体问题进来——“多个工具并行调用怎么合并结果”“用户中途插话怎么办”“会话怎么恢复”——这本书对每一个都有答案,而且答案是能跑的代码。
如果你是刚入门,想先搞懂"智能体是什么",那这本书太重了。第 1 章 44 屏的概念铺垫不够,你会被第 3 章的 115 屏原语直接压死。这种读者应该先去看一篇 ReAct 的解读,再回来。
如果你只是想选一个框架,这本书帮不了你,它太深也太专,第 11 章的选型分析只有 8 屏。
再说怎么读。我的建议是四段式,加起来不到 250 屏:
第一段,读第 3 章的 3.1 与 3.5,约 40 屏。状态怎么定义、reducer 怎么合并、工具怎么注册、工具报错怎么处理。这四件事是所有 LangGraph 应用的骨架,先立骨架。
第二段,读第 4 章的 4.2 和 4.3,约 40 屏。存档点怎么接、人机环路怎么设计。interrupt() 这个机制是 LangGraph 相对其他框架最硬的一个差异点,值得花时间。
第三段,把第 7 章 79 屏整章读完。这是全书唯一在讲"设计"的部分,提示链、路由、并行化、协调器—工作者、评估器—优化器,以及主管/分层/网络三种多智能体架构。读完这一章,你才有能力判断一个需求该用哪种模式。
第四段,按需查第 8 章和第 9 章。用 Cloud 的读第 8 章,自建的只看 8.4.3 和 8.4.1,然后直接跳到第 9 章的模板目录结构那 4 屏——那是团队协作规范,跟部署方式无关,谁都用得上。
第 10 章三个官方案例(开放画布、报告大师、Agent Inbox),我建议不要通读。它们是给"我要做个类似产品"的人看的,不是给"我要学怎么设计"的人看的。读别人的成品代码,最容易的收获是抄目录结构,最难的是看懂他为什么这么拆。71 屏的投入,收益率不高。
最后说一句我心里的话。
这本书让我确认了一件事:中文技术书现在的问题,已经不是"写得水",而是"写得太像文档"。它把官方文档里散落的东西整理得很好,但整理不等于提炼。一本真正好的框架书,应该在读者还没遇到问题时,就告诉他"你三个月后会在这里翻车"。
这本书偶尔做到了——并发不是并行、子图不传 subgraphs 就没有流、双重文本的三种策略、递归限制与并行分支。这几处加起来不到 30 屏,是真正的经验。如果整本书都按这 30 屏的密度写,800 屏会变成 300 屏,价值反而更高。
一句话收尾:它是一本合格的框架手册,把 LangGraph 讲到了能用的程度;但它不是一本智能体设计书,因为设计的部分,它只肯给 79 屏。
阅读记录:《LangGraph 实战:构建新一代 AI 智能体系统》,张海立 著。微信读书逐页翻阅 800 屏 / 181 个章块 / 十一章,读到 11.2.3 书尾(reached_end=True)。抓取与抽样核对日期 2026-11-13。文中引文与代码片段均来自上述截图页面;关于平台绑定降低迁移率、语义检索负例缺失、全书缺评测数字的判断,是我的核查意见,非书中原文。
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: