
企业级高并发Agent实战:代码写到最后一行,数字停在第一句
微信读书《企业级高并发Agent实战:CloudWeGo Eino工程化落地》(王中阳、李培森、熊美龙 著,人民邮电出版社 2026-08,ISBN 9787115701299)· 逐页翻阅 396 屏 · 抓取标记 reached_end=True(end_reason=last_page,书尾落在第 13.4 节"小结"后的"下一章"按钮)· 阅读器共记录 162 个章块,十三章。
抽样说明:这是一本 Go 语言工程书,全书围绕同一个"智能面试系统"展开,所以我按"工程骨架—可靠性—性能—可观测—评估"五条线抽读:p0001 版权页(核对作者与出版社)、p0006 专家推荐(晁岳攀、刘丹冰等人的评语)、p0019 前言(作者自述出身与写作动机)、p0044 Eino 三大核心原语、p0147 评估维度表、p0189 解析效果验证、p0266 输出守卫代码、p0304 网关性能优化、p0314 连接池调优、p0332 Token 记账代码、p0365 自动化评估脚本。
章屏数按阅读器顶部章标签切分(162 个章块,小节级)。所有引文与数字只来自上述页面;关于"零压测数据""验证只有走查""培训班出身"这类判断,是我的核查意见,不是书里的原话。
396 屏,十三章,162 个章块。
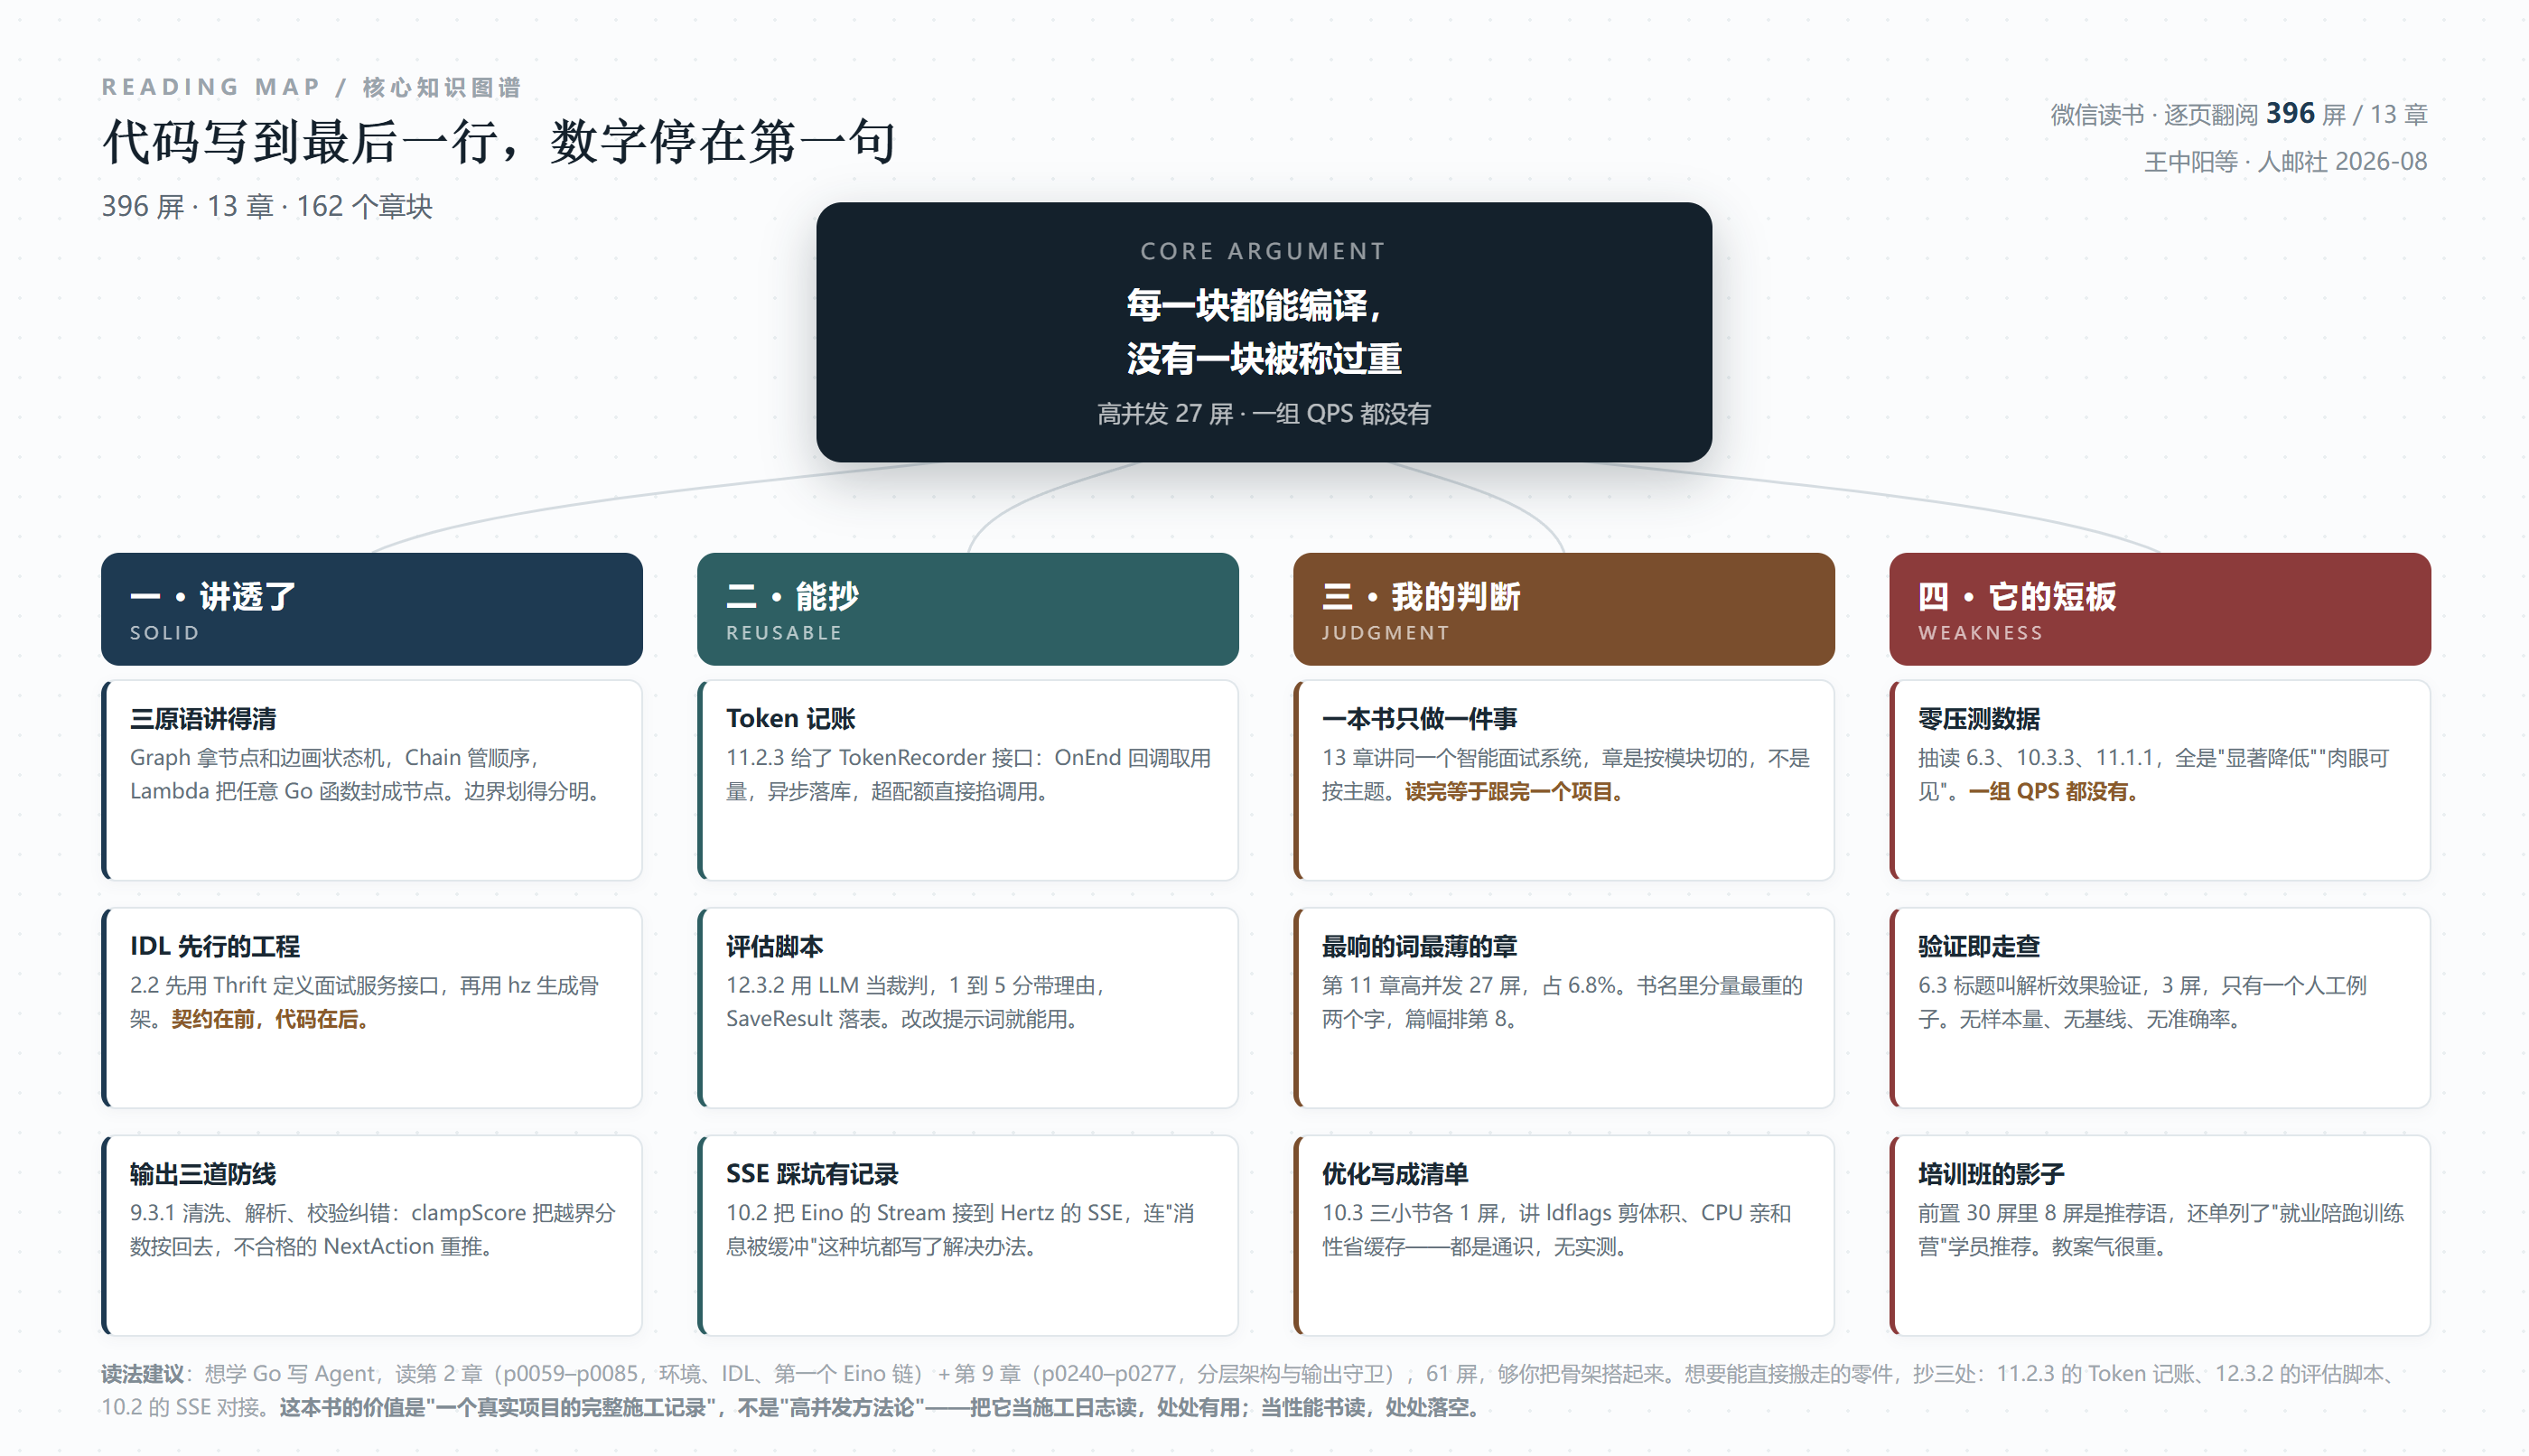
这本书我读得挺矛盾。一方面,它是这个系列里少见的、代码能真跑的书——Go 写得干净,接口定义得规矩,连"SSE 消息被缓冲"这种只有真联调过才会遇到的问题都记下来了。另一方面,它的书名里写着"高并发",而全书真正讲高并发的只有 27 屏,一组 QPS 数字都没有。
读完我把书合上,心里那句话是:代码写到最后一行,数字停在第一句。
它教你怎么把它做出来,教得很好;它没教你怎么证明它扛得住,一次都没有。
一、396 屏的账:十三章,其实只讲了一个项目
按章统计:前置(版权、内容提要、专家推荐、学员推荐、序、前言、作者简介、资源与支持)30 屏;第 1 章 启程:CloudWeGo 与 AI 工程化 28 屏;第 2 章 环境搭建与规范 27 屏;第 3 章 基于 Milvus 的 RAG 知识库 23 屏;第 4 章 工具使用与多模态处理 26 屏;第 5 章 方法论:企业级 Agent 构建 34 屏;第 6 章 简历解析 Agent 23 屏;第 7 章 专项面试官 Agent 24 屏;第 8 章 多 Agent 协同面试系统 24 屏;第 9 章 系统集成 38 屏;第 10 章 Hertz 网关实战 32 屏;第 11 章 高并发性能优化实战 27 屏;第 12 章 打造可信赖的 AI 系统 35 屏;第 13 章 容器化与云原生 25 屏。
加起来 396。
这张表最反常的一点是:它的章节不是按知识点切的,是按模块切的。
普通技术书的结构是"一章一个主题":这章讲 RAG,那章讲多 Agent,各章可以打乱顺序读。这本书不是。第 3 章的 RAG 是为了给面试系统挂知识库,第 6 章的简历解析是为了给面试系统供数据,第 7、8 章的面试官和多 Agent 协同是面试系统的主流程,第 9 到 13 章是把它推上线。
十三块拼起来是同一个东西:一个叫"智能面试"的系统,从建目录到进 K8s。
这种写法有它的好处,而且是很大的好处:你从头读到尾,等于跟着一个人做完一个项目。你知道每一块代码为什么存在、被谁调用、放到哪个包下面。这在"讲知识"的书里是得不到的——那些书教你 RAG 的十种切分策略,但不告诉你切分器该放在哪个目录、跟谁共用一个 logger。
坏处也很清楚:这本书没法当参考书用。你想单独查"Milvus 的索引怎么建",得先接受它的项目结构、它的 MilvusManager 封装、它的配置注入方式。你想看"多 Agent 协作有哪些模式",它只给你一种——Agent-as-Tool——因为它的项目只用了这一种。
一本书只做一件事。这件事它做得挺扎实,但它确实只做了一件。
二、它最硬的地方:Go 工程化的每一块都是真的
先把好话说清楚,因为这本书的"实"是实打实的。
第 1.2.2 节讲 Eino 的三大核心原语,讲得很利索:Graph 用节点和边表达依赖,能画有向无环图,也能画带循环的图,面试里的"追问"和"话题切换"正好用这个;Chain 是图的特殊形式,处理顺序任务,一条 ChatModel → PromptTemplate → OutputParser 的流水线;Lambda 是逃生舱,标准组件不够用时,把任意 Go 函数封成节点。
三个原语的边界划得清清楚楚,而且它说清了什么时候该用哪个——这比列一堆 API 有用。
第 2.2 节讲 IDL 驱动开发,是这本书最"工程"的一段:先用 Thrift 定义面试服务的接口,再用 hz 生成 Go 代码骨架。契约在前,代码在后。这个顺序在 Python 生态里很少见,在 Go 微服务里是常识,作者没有为了迁就读者而把它简化掉,这一点我认。
第 9.3.1 节讲 LLM 输出守卫,是我认为全书最值得单独拎出来的一节。它把守卫拆成三道防线:第一道清洗,用字符串操作把模型输出的杂质去掉,不做复杂逻辑;第二道解析;第三道校验与自动纠错——代码清单 9-13 里,clampScore 把越界的分数按回区间,validateAndFixResult 检查总分是否落在 1 到 10 之间,不合规就用 CalculateOverall 重算,NextAction 不认识就交给 inferNextAction 重新推断。
这段代码的价值不在技巧,在于它承认了一件事:模型的输出永远可能是脏的,所以解析之后必须还有一层"修"。很多书讲到"让模型输出 JSON"就停了,这本书往下走了两步。
第 3.3.2 节的检索实现也值得记一笔。它没有停在"向量检索"这一步,而是先承认"单一的向量检索在某些精确匹配场景下会表现不佳",然后上混合检索加重排序:HybridRetriever.Search 先按 CandidateTopK 召回一批候选,再交给 reranker.Rerank 重排,代码清单 3-6 把召回和重排的联动写全了。
这是检索的正确姿势——召回要宽,排序要准。很多教程直接拿向量相似度前五就喂给模型,效果不好就怪模型。这本书知道问题在召回和排序是两件事。当然,知道归知道,重排之后 hit rate 涨了多少,它同样没给。
还有两处细节,只有真上过线的人才写得出来。第 11.2.1 节用 sync.Once 做全局 http.Client 单例,配了 TLSHandshakeTimeout 10 秒,注释写的是"在网络不稳定的情况下,快速失败比长时间等待更好";又设 DisableCompression: true,理由是"如果 LLM 响应已经是文本流,禁用压缩可以减少 CPU 开销";总超时给到 120 秒,并提醒"对于流式响应,这个超时通常指整个请求的超时,如果对话时间较长需要按业务场景适当放宽"。
第 12.2.3 节的告警降噪更狠。它用 ShouldSendAlert 加一个滑动窗口做抑制,去重键是"组件名 + 错误信息",然后在注释里补了一句:"TraceID 不应该包含在 Key 中,因为每次请求的 TraceID 都不一样。"
这一句是值钱的经验。所有做过去重的人都在这上面翻过车——把 trace id 拼进去重键,等于每个请求都是新告警,降噪百分之百失效。作者知道这件事,说明他真的值过夜班。
三、我立刻能抄走的三样东西
读工程书我有个习惯:读的时候在便签上记"这个能抄",读完看有几张。这本书记了三张。
第一张:Token 记账。第 11.2.3 节给了一个 TokenRecorder 接口,五个方法,入参是用户 ID 和 prompt/completion/total 三个计数;CheckQuota 返回 error 表示配额不足、阻断调用;真正的记账发生在 MonitoringHandler.OnEnd 里——组件执行结束(不论成功失败)都会被回调,从 ctx 里取出 userID,从输出结构里反射出 token 用量,然后 go func 异步落库,注释里特意写了"使用 context.Background() 确保记录操作不随请求 Context 取消而中断"。
这一句注释是内行话。所有做过计费的人都在这里踩过:请求被客户端取消,ctx 变成 Done,你那条写数据库的调用跟着一起死,钱就白花了。
第二张:评估脚本。第 12.3.2 节给了一段完整的 Go 测试代码:遍历测试用例,先跑被测 Agent 拿输出,再拼一个裁判提示词——"你是一名公正的面试评估专家",给问题、参考答案、AI 面试官的追问,让裁判按 1 分到 5 分打分并给理由,最后 SaveResult 落表。
这不新鲜,LLM-as-a-Judge 到处都是。但它是能编译的,而且把"测试用例 → 跑 → 判 → 存"四步闭环写全了。大多数人停在第二步。
第三张:SSE 对接。第 10.2 节把 Eino 的 Stream 输出接到 Hertz 的 SSE 写入上,然后 10.4.2 专门讲了一个坑:SSE 消息被缓冲。这个坑不性感,但它会让你在本地一切正常、上线后前端一个字都收不到。书里给了解法。
这三张便签加起来不到 20 页。一本书能给我三样能直接用的东西,已经不算亏。
四、较真:一本叫"高并发"的书,QPS 一个都没给
现在说不舒服的地方。
书名里"高并发"排第三,专家推荐里也在强调这一点。晁岳攀的推荐语是这么写的:
Agent开发的核心不在于浅层的API调用,而在于成熟的工程化落地实力,以及高并发业务场景下系统稳定性的兜底能力。
话说得很对。那么"高并发"这件事,书里兑现了多少?
27 屏。第 11 章,占全书 6.8%,篇幅排第 8。比第 12 章可观测性(35 屏)薄,比第 9 章系统集成(38 屏)薄,比第 5 章方法论(34 屏)薄。
更关键的是这 27 屏里有什么。11.1 讲 Hertz 网关高并发配置,拆成三个小节:连接池调优、协程模型优化、分布式限流。11.2 讲 Eino Agent 资源调度优化:客户端复用、sync.Pool 对象池、Token 成本控制。
内容本身没毛病,都是对的方向。但全是怎么配,没有配完差多少。
举 11.1.1 那段原文:
server.WithKeepAlive(keepAlive):这是连接复用的核心开关。开启后,Hertz会复用底层的TCP连接,避免频繁的握手开销。在QPS较高的场景下,这能显著降低CPU使用率和延迟。
"显著降低"。降到多少?从多少降到多少?在什么并发下测的?单机还是集群?一个都没有。
再看第 10.3 节,标题叫"Hertz 网关性能优化",三个小节:连接与协程优化、缓冲区与 I/O 优化、编译与运行时优化。三个小节,各 1 屏,合计 3 屏。一段书里能给出的最强数字是这个:
最常用的是-ldflags="-sw",它能剥离符号表和调试信息,不仅能减小二进制文件体积(通常减少20%~30%),还能略微提升程序的启动速度。
这句是真的,但它是 Go 的通用常识,任何一个 Go 老手都能背出来,跟这本书的面试系统没有关系。真正该测的是:把 MaxRequestBodySize 从 4MB 调到 1MB 之后,P99 掉了多少;开了 KeepAlive、IdleTimeout 设 1 分钟之后,长连接场景下的吞吐涨了多少;用 sync.Pool 复用好 client 之后,GC 的 STW 少了多少。
这些数字一个都没有。整本书的性能部分,是一份配置清单,不是一份测试报告。
这才是我最想不通的地方。前面说过,作者在告警降噪那一节知道"TraceID 不能进重进去重键",在客户端复用那一节知道"流式响应该禁用压缩省 CPU",这些都是从事故里捡回来的经验。既然他真的在生产里待过,为什么不把压测结果贴出来?
我猜答案是:压测做过了,但结论是"能跑",不好写成表格;或者压测的环境、数据、脚本不在手上,写了也不好复现。无论哪种,结果都是读者拿到一份猜不出水位的配置。IdleTimeout 设 1 分钟"比较合适"——在多少并发下合适?MaxIdleConns 默认 100 要调大——调到多少?
这些问题书里没有答案,而它们恰恰是上线前最需要答案的问题。
我得说,这不是这一本书的毛病,几乎是所有"实战"类技术书的通病:写测试要环境,要压测工具,要跑足够久才能拿到稳定曲线,成本比写代码高得多。但既然书名里放了"高并发"三个字,读者就有权要这组数字。哪怕只给一台 8 核机器、wrk 跑三分钟、前后对比一张表,也比现在强。
五、"验证"这个词,被用得太轻了
第 6 章讲简历解析 Agent,最后一节叫"6.3 解析效果验证",3 屏。
我以为会看到准确率、样本量、错误类型分布。看到的是一段走查描述:候选人只用 Docker 搭过基础开发环境、没碰过容器编排,达不到精通层级,评为入门级;Go 语言能力仅停留在初步认知阶段,项目主力开发语言是 Java,实战储备不足,同样评为入门级——然后据综合能力输出面试适配难度建议。最后一段落在这样一句上:
简历解析Agent实现了从纯文本阅读向量化数据应用的转变,经过推理校验、偏差修正后的结构化数据无须人工二次修正,即可赋能下游招聘环节。
"无须人工二次修正"。这句话如果是真的,是这个系统最值钱的一句;如果没测过,是这本书最危险的一句。
因为简历解析这个任务,难就难在格式的多样性——排版千奇百怪、表格套表格、PDF 里嵌图片要 OCR、中英文混排、时间线跳着写。这种任务没有 95% 以上的字段级准确率,下游根本不敢用。而书里给的证据是:一个候选人的例子,跑通了。
3 屏的"验证",撑不起"无须人工二次修正"这八个字。
还有一个更微妙的例子。第 5.1.1 节讲提示词管理,说他们把各个面试官的人设集中定义在 constants.go 里,做成常量,理由写得很好听——"以便后续的版本迭代和 A/B 测试"。代码清单 5-1 给了 Redis 专项面试官的提示词定义,角色、目标、约束分三块,其中约束还分成合规约束(严禁询问隐私信息、禁止输出歧视性言论)、功能约束("不要要求候选人编写代码")、体验约束("只返回一个问题,且不超过 200 字")。
三层约束的拆法很专业,把提示词当配置文件管也是个好习惯。但"便于 A/B 测试"这句话说完,全书就再没有一次 A/B 测试。396 屏里没有一个提示词版本对比,没有一组"改了约束之后追问质量提升多少"的数据。好习惯被写出来了,好习惯带来的收益被跳过了。
第 7 章讲面试官 Agent、第 8 章讲多 Agent 协同,同样是这个模式:讲难点、讲实现、给一段代码、给一段输出示例,然后"本章小结"。三章加起来 71 屏,"效果如何"的部分不到 10 屏,且全是单例走查。
这本书教会你怎么把东西做出来,但没教会你怎么知道它做对了。而这恰恰是工程化里最难、也最值钱的一半。
六、它的短板
按这本书自己的结构,我给四条。
第一,没有一组可复现的性能数字。见上一节。一本把"高并发"写进书名的书,抽读 p0304(10.3.3)、p0314(11.1.1)两处性能核心论述,结论都是定性的。这是最大的落差。
第二,"验证"停在单例走查。6.3 三屏、7.3 无独立验证节、8.5 只给"最终产出:自动生成包含雷达图的面试报告"。没有样本量、没有基线、没有错误分类。评估方法给了(第 5.1.3 节的维度表其实做得不错:幻觉率用捏造知识点数除以总知识点数、响应性用总响应时间除以对话轮数、体验性用 LLM-as-a-Judge 打 0 到 1 分),但方法给完就没有下文,没见它用这套方法跑出一张表。
第三,只有一个项目、一种写法。13 章讲一个智能面试系统,等于只展示了一条路径:DDD 分层 + Thrift IDL + Hertz 网关 + Eino 图编排 + Milvus。这条路径是对的,但读者看不到别的选择——为什么不用 gRPC 而用 Thrift?为什么向量库选 Milvus 不选 pgvector?为什么多 Agent 只讲 Agent-as-Tool 这一种模式?书里有零散的理由,但没有横向比较。一本书只做一件事的代价就在这里:你不知道自己学到的是"一种做法"还是"唯一做法"。
第四,前置 30 屏,占了 7.6%。版权 2 屏、内容提要 2 屏、专家推荐 6 屏、学员推荐 2 屏、序 4 屏、前言 6 屏、作者简介 3 屏、资源与支持 5 屏。396 页的纸书里,翻开正文之前要走 30 屏。这个比例在技术书里偏高了,尤其"专家推荐"独占 6 屏。
还有第五点,不算错但值得提醒:凡是新东西,这本书都给得很省。4.1.4 讲下一代工具标准 MCP,2 屏;3.3.4 讲 GraphRAG 与向量检索的融合,2 屏;12.4 安全与合规,5 屏,拆成敏感数据脱敏和内容安全围栏两小节。这几个恰恰是 2026 年最该多讲的题目,在书里都成了点缀。
作者显然有自己的取舍:先把一条老实的老路走完,新的路留一句话。这个取舍我能理解,但它让这本书的"前沿感"很弱——你从它这里学到的是一套 2024 年就已成熟的写法,而这套写法本身没什么不好,只是不新。
七、培训班的影子,以及为什么这不是坏事
前言里有一段,把这本书的出身交代得很清楚:
我们创办了"就业陪跑训练营",把这套实战方法论教给成千上万名陷入转型焦虑的后端开发者。
再往后,是"两年时间,我们辅导学员拿下了千余份优质 Offer,很多学员从传统后端开发者成功转型为 AI 开发工程师,薪资翻倍"。
这段话解释了很多事:为什么结构像教案(每章"任务定义—实现路径—小结");为什么前置有"学员推荐"这一栏;为什么语气里总带着一点"跟着做就行"的鼓励感;为什么选了一个"智能面试"这种特别适合做课程 Demo 的题目——它天然有画面感,跑起来就能演示,还能反过来说明"我连面试都能自动化"。
我不觉得这是坏事,反而觉得它解释了这本书的可用性。
培训班出来的东西有一个特点:它是被几百个真实学员卡过一遍的。哪些地方新手一定会错,哪些概念必须先讲,哪个坑不讲学员就跑不通——这些东西不是想出来的,是被问出来的。第 2 章的 Docker 部署 MySQL、Milvus、Redis,第 10.4 节的"SSE 消息被缓冲",这些都是被卡过才知道要写。
代价是:教案的目标是"让你跑通",不是"让你判断"。所以它会给标准答案,不给选项;会告诉你"通常设置 1 分钟比较合适",不告诉你这个 1 分钟是怎么试出来的。
作者在前言里其实自己立过靶子:
我不想写一本满是空洞理论、脱离一线实战的书,更不想写一本只教API调用、没有工程化思考的手册。
前半句他做到了——这本书一点都不空,每一页都有代码。后半句做到了一半:有工程化思考,但思考停在"这样写更规范",没走到"这样写更快,快多少"。
八、怎么读
我给三个读法。
想学用 Go 写 Agent 的,读两段就够:第 2 章(p0059 到 p0085,环境、IDL、第一个 Eino 链,27 屏)+第 9 章(p0240 到 p0277,分层架构、统一模型接入、输出守卫,38 屏)。65 屏,能把骨架立起来,而且第 9 章的分层思路是所有语言通用的。
想抄零件的,直接跳三处:11.2.3 的 Token 记账(p0331 起)、12.3.2 的评估脚本(p0364 起)、10.2 的 SSE 对接(p0292 起)。这三处是全书最"能拿走"的部分,跟你的项目结构无关。
冲着"高并发"来的,我劝你降低预期。第 11 章 27 屏是一份配置清单,方向对,但没有数字。真要压测,还是得自己上 wrk 或者 k6,用它的系统当靶子跑一遍——那本书给不了你的,你自己跑一次就有了。
最后说一句公道话。
这本书最适合的读者,其实是一个很具体的人:写了三五年后端、会 Go、想转 AI 方向、但不知道工程上该怎么落地的人。对这个人来说,这本书的价值几乎不可替代——他会写 HTTP 服务,会调数据库,但不知道 Agent 的图该怎么编、流式该怎么接、token 该怎么记、告警该怎么降噪。这本书把这些一块一块补上,而且每一块都给能编译的代码。
反过来,如果你的目标是"让系统扛住十万并发",这本书帮助有限。它告诉你的都是必要的配置,不是充分的能力。真正的并发能力,得拿压测工具去问系统本身。
这本书让我想起一句话:能被完整讲完的项目,通常已经不是最难的那部分了。它把"从 0 到 1 做出一个企业级 Agent 系统"讲得很完整,这本身有价值——很多人卡在的不是并发调优,是不知道怎么把 LangChain 式的脚本变成一个能部署的服务。这本书正好补这一段。
但它确实欠读者一张表。一张写着"优化前 QPS 多少、P99 多少;优化后多少"的表。有了那张表,这本书就从"一份施工记录"变成"一份工程证据"。而这中间差的,不是作者的能力,是一次老老实实的压测。
一句话收尾:它把一栋楼从打地基到装电梯全拍了下来,只是没告诉你能住多少人。
阅读记录|微信读书《企业级高并发Agent实战:CloudWeGo Eino工程化落地》,王中阳、李培森、熊美龙 著,人民邮电出版社 2026 年 8 月第 1 版,ISBN 9787115701299。逐页截图 396 屏,162 个章块,十三章,抓取耗时 452.4 秒,读到书尾(end_reason=last_page)。本文引文出自 p0006、p0019、p0044、p0147、p0189、p0266、p0304、p0314、p0332、p0365 等页;篇幅统计按阅读器章标签逐页归属计算;判断与批评为本人观点。
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: