
大模型RAG应用开发:三个案例,其实是同一个模板填了三遍
微信读书《大模型 RAG 应用开发:构建智能生成系统》(凌峰 著,清华大学出版社 2025 年 4 月第 1 版,ISBN 9787302685982)· 逐页翻阅 471 屏 · 抓取标记 reached_end=True(end_reason=last_page,书尾落在第 11 章 11.5「思考题」之后的"全书完")· 阅读器共记录 152 个章块,十一章 · 抓取耗时 455.5 秒。
抽样说明:我按"章节厚度 + 代码位置"抽读——p0001 版权页、p0005 前言(全书结构)、p0028 Pandas 清洗与 NumPy 相似度、p0069 A* 寻路、p0214 三种 FAISS 索引、p0253 检索生成衔接、p0332 分阶段计时、p0378 企业部署的 Flask 与索引类、p0398 医疗案例的嵌入与建库。
章屏数按阅读器章标签逐页归属计算,含章标题页。所有引文与数字只来自上述页面;"三个案例是同一个模板填了三遍"是我的核查意见,不是书里的原话。
先说结论:这是一本施工图,不是一本设计手册。它能带你从零把一套 RAG 跑起来,代码基本可执行;但它把「RAG 系统」当成了一个固定的步骤清单,一旦你的语料不听话、召回不对,它没法告诉你该改哪一步。
一、前言给的地图和实际的地形,对不上
前言第 3 屏(p0005)把全书结构交代得很清楚:
第4~8章着手构建 RAG 系统,涉及向量数据库的搭建、数据向量化和文本检索增强的实战内容……第9~11章聚焦 RAG 的实际应用,展示 RAG 技术在企业文档问答、医疗文献检索和法律法规查询等场景中的典型应用。(p0005)
接着是那句自我定位:「本书主要特点是,理论与实践紧密结合,以实战案例和代码示例贯穿全书,使读者不仅能够掌握 RAG 的基本原理,更能上手搭建符合实际应用需求的 RAG 系统。」
我按这句话去核对了 471 屏的屏数分布,结果是:
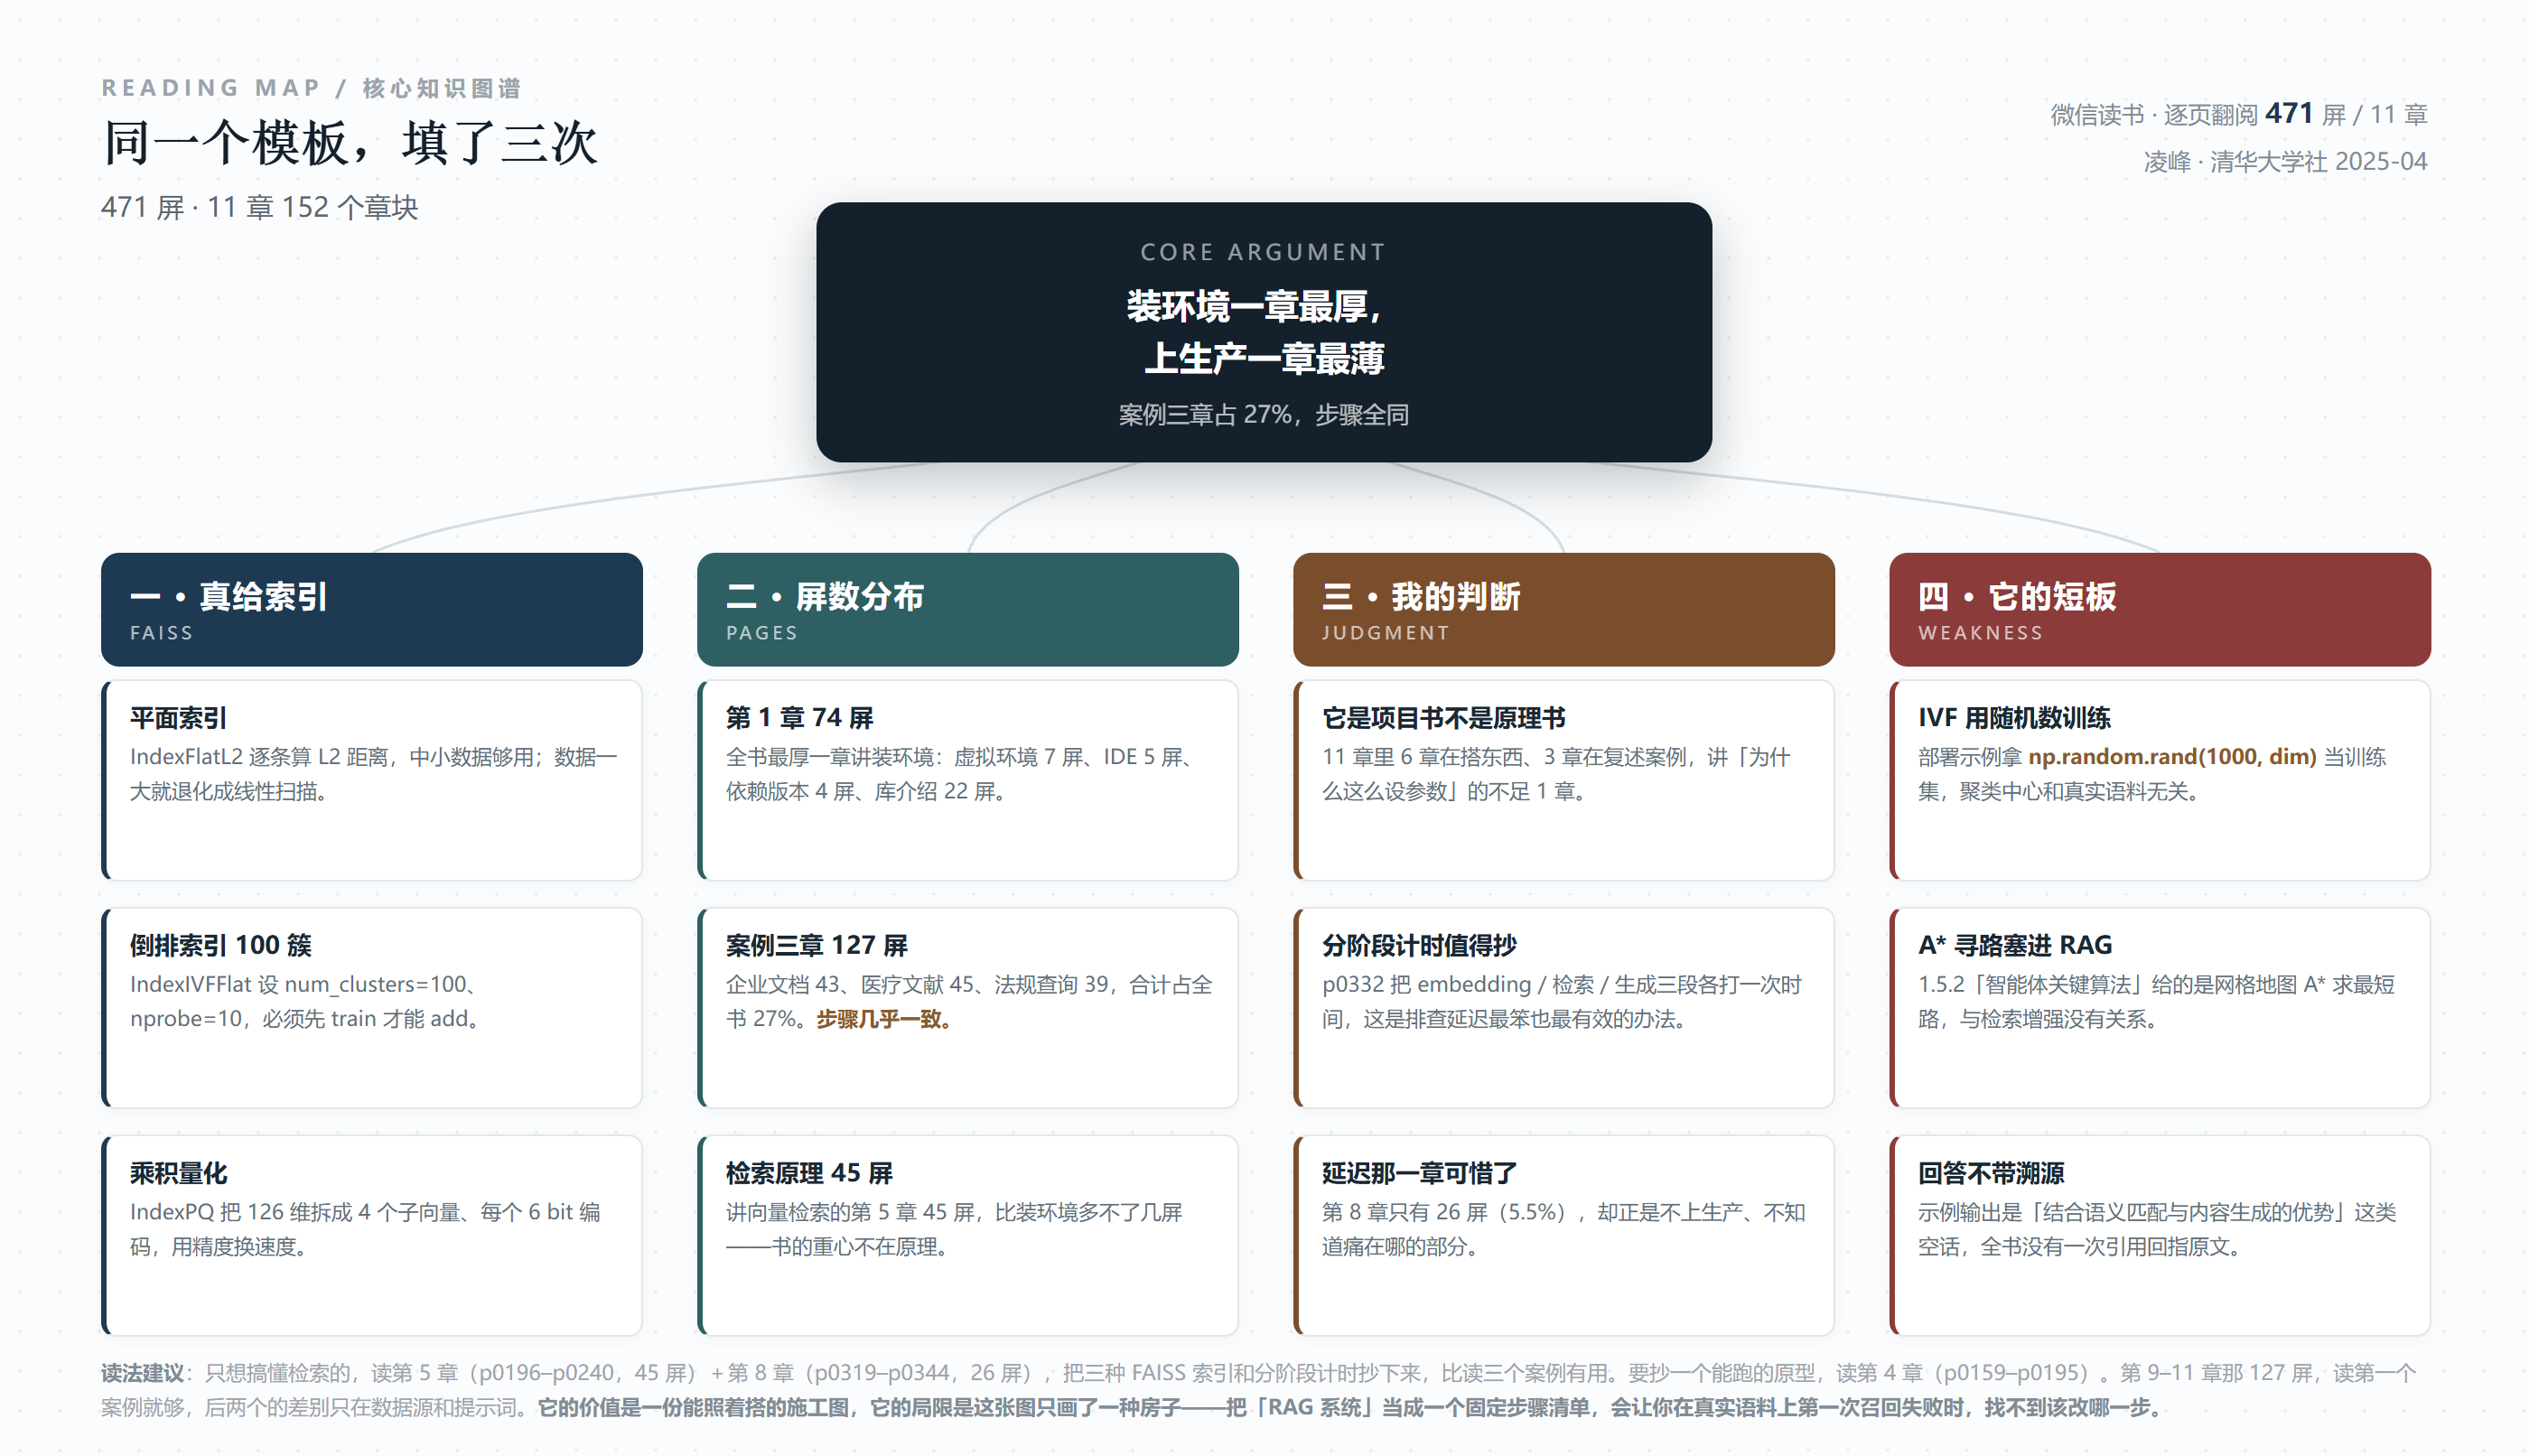
第 1 章搭建环境 74 屏(15.7%);第 2 章传统生成与 RAG 32 屏(6.8%);第 3 章 RAG 工作原理 47 屏(10.0%);第 4 章搭一个简单的 RAG 系统 38 屏(8.1%);第 5 章数据向量化与 FAISS 45 屏(9.6%);第 6 章文本检索增强与上下文构建 50 屏(10.6%);第 7 章构建检索向量数据库 28 屏(5.9%);第 8 章延迟与缓存调优 26 屏(5.5%);第 9 章企业文档问答 43 屏(9.1%);第 10 章医疗文献检索 45 屏(9.6%);第 11 章法律法规查询 39 屏(8.3%)。
最厚的一章是第 1 章,讲怎么装 Python 环境、选 IDE、装依赖库。74 屏。而讲「延迟与缓存调优」的第 8 章,全书写得最像生产经验的那一块,只有 26 屏,占 5.5%。
这三个案例加起来 127 屏,占全书 27%。它们确实是「实战案例」,但如果三个案例的步骤高度一致,那这 27% 里真正新增的信息量,大约只有三分之一。这一点我在第五节展开说。
反过来看第 2 章,32 屏,占 6.8%,讲的是生成式 AI 核心原理、检索增强与传统生成的区别、Transformer 崛起、从 BERT 到 GPT-4 的里程碑。这一章的内容在任何一本讲大模型的书里都能读到,而且通常讲得更细。一本 RAG 书用 32 屏复述一遍模型演进史,我理解是为了「照顾零基础读者」,但当第 1 章已经用 74 屏照顾过一遍零基础之后,这个照顾就有点重复了。
所以这本书的真实结构是这样的:照顾入门(第 1、2 章,106 屏,22.5%)+ 讲原理(第 3 章 47 屏)+ 教搭建(第 4–8 章,187 屏,39.7%)+ 三个案例(127 屏,27%)。四个模块里,只有「教搭建」这一块是真正无可替代的,而它占了不到四成。
二、74 屏装环境:这本书的真实重心在哪里
把第 1 章的 21 个章块拆开看,是这样的:虚拟环境的创建管理 7 屏、IDE 的选择与工作流 5 屏、依赖库安装与版本管理 4 屏;然后是一串库的介绍——Pandas 与 NumPy 5 屏、NLTK 与 spaCy 4 屏、FAISS 与 Transformers 6 屏、Requests 与 BeautifulSoup 6 屏、Multiprocessing 与 Asyncio 5 屏;再往后是智能体定义 4 屏、智能体类型 2 屏、开发环境 6 屏、关键算法 4 屏、性能评估与调试 5 屏。
我抽看了 p0028,那是 Pandas 那一节的运行结果:五条用户交互数据,user_id 从 101 到 105,response_time 是 3.4、2.2、5.6、3.1、3.4,question_length 是 11、21、13、20、22,最后算出 avg_response_time。同一页往下是 NumPy 算相似度,用户问题向量用的是 [[0.1, 0.8, 0.5], [0.7, 0.3, 0.6]...] 这种手写的小数。
这些内容本身没错,但它们是「学 Python 数据分析」的第一课,不是「学 RAG」的第一课。一个准备读 RAG 的人,大概率已经会开 conda 环境、已经用过 Pandas。用 74 屏、全书 15.7% 的篇幅去覆盖这些,代价是后面真正难的部分被压薄了。
最能说明问题的是 p0069。那一页在 1.5.2「智能体开发中的关键算法:搜索、优化与规划」下面,给了一段 A* 寻路算法的完整实现:起点 (0, 0)、终点 (5, 7)、障碍物是若干个网格坐标、启发函数用曼哈顿距离 abs(a[0]-b[0]) + abs(a[1]-b[1]),open_list 用 heapq 维护 f_score,最后回溯 came_from 得到路径。
A* 是很好的算法,写得也规范。但这本 RAG 书里为什么要教 A*?在网格地图上找最短路,和「把文档切片、转向量、按相似度召回」之间,没有一步是共通的。这段代码更像是「智能体里应该有规划算法,所以放一个规划算法的例子」,属于凑章节完整性,不属于解决 RAG 的问题。
三、第 5 章才是真本事:三种 FAISS 索引讲明白了
如果这本书只能留一章,我留第 5 章。它 45 屏,把向量检索从「距离度量」讲到「索引结构」,而且是真代码。
p0214 那一屏,三种索引连着摆:
num_clusters=100
index_ivf=faiss.IndexIVFFlat(faiss.IndexFlatL2(dimension), dimension, num_clusters)
index_ivf.train(data_vectors) # 必须先训练
index_ivf.add(data_vectors)
index_ivf.nprobe=10
……
subvector_size=4 # 126维被分成4个子向量,每个子向量4维
index_pq=faiss.IndexPQ(dimension, subvector_size, 6) # 6表示量化编码大小(p0214)
这段代码的价值在于它把三个东西拴在了一起:平面索引(IndexFlatL2)是暴力算,倒排索引(IVFFlat)是先聚类再只搜几个簇,乘积量化(PQ)是把向量压成更短的编码来省内存。再往下 p0214 的正文把话说得很直白:平面索引「适用于中小规模数据集,因为它会逐一遍历数据计算距离,数据量大时性能下降」。
而且它没漏掉那个最容易踩的坑:IVF 索引必须先 train 才能 add。那行注释「必须先训练」虽然只有五个字,但救了不知道多少人——新手直接 add 一个没训练过的 IVF 索引,FAISS 会直接报错,而报错信息对初学者并不友好。
nprobe=10 这个参数它也没放过。同一屏的注释写着「nprobe 参数来控制检索的分区数(nprobe 值越大,搜索精度越高,速度越慢)」。这句话把「精度换速度」这个权衡点说清楚了,虽然只有一句,但方向是对的。
我认为这三屏是全书信息密度最高的地方。因为它不只是给 API,它给了「什么时候用哪个」的判断依据:数据量小用 Flat、要快用 IVF、内存紧用 PQ。这种句子在全书里太少了。
同一章前面还有一段索引之外的干货。p0116 用了一个完整的检索示例:拿预训练的 MiniLM 把文本转向量(句子嵌入靠平均池化),存进 FAISS 的 L2 索引,然后查询「计算机如何理解文本?」,返回两条结果——
文档:自然语言处理使得计算机能够理解和生成文本。,相似度距离:0.0245
文档:人工智能是一种模仿人类智能的技术。,相似度距离:0.0357(p0116)
这两行数字带出了这本书一个有意思的细节问题。正文紧接着写「距离越小,说明两者越相似」,这句没错。但 0.0245 和 0.0357 之间只差 0.011,而书里没有任何一句讨论「多小的距离才算相关」。L2 距离的绝对值依赖向量维度和归一化方式,同一个数字在 e5 上是「很近」,换个模型可能就是「很远」。没有阈值,就没有拒答的能力;而没有拒答能力的检索,一定会把不相关的片段塞进上下文。
这一页往后紧跟着「【例 3-2】构建带有过滤条件的检索模块」,说明作者知道要过滤。但过滤和阈值的区别,书里没分清:过滤是「先按条件缩小范围」,阈值是「按相关度决定要不要」,前者解决精确性,后者解决「该不该答」。
四、计时那 4 屏,比整个第 8 章都有用
第 8 章讲延迟与缓存,26 屏。说实话我读之前期待很高——RAG 上生产,一半的抱怨是「太慢」,另一半是「答得不对」,而这本书对「慢」的处理最薄。
但第 8 章里有一段,我觉得可以抄进任何 RAG 项目。p0332 给了一个带计时的函数:
def retrieve_and_generate_with_timing(query, top_k=3, generate_length=50, temperature=0.7):
times={} # 用于存储各阶段时间
query_embedding_time / vector_search_time / generation_time(p0332)
它把一次问答拆成三段分别计时:查询向量化、向量检索、生成。top_k 设 3,生成长度 50,temperature 0.7。
这是排查延迟最笨、也最有效的办法。很多人的 RAG 慢,第一反应是换更小的模型,结果换了没用——因为瓶颈在 embedding 那一步(本地跑 e5 这类模型,单条查询 100 毫秒以上很常见,如果模型还留在 CPU 上就更久),或者在检索那一步(索引没建好,每次全量扫)。你不分段计时,就只能猜;分段计时之后,哪个数字大一眼就看出来。
可惜的是,这段代码没有配一组真实的数字。它告诉你怎么测,没告诉你「正常的 RAG 三段各该是多少毫秒」。这就回到了这本书的老问题:给了方法,不给标尺。读者测出来 embedding 80ms、检索 5ms、生成 3 秒,也不知道这算好还是算坏。
第 8 章的下一节还给了我一个更大的意外。8.2.2 讲「缓存与并行处理策略」,p0337 给了一段用 ThreadPoolExecutor 同时跑检索和生成的代码,大意是:
with ThreadPoolExecutor() as executor:
retrieve_future=executor.submit(retrieve)
context=retrieve_future.result()
generate_future=executor.submit(get_cached_generation, context)
generated_text=generate_future.result()(p0337)
这段代码有一个逻辑问题:它在 submit 之后立刻 .result() 阻塞等待,等于把并行退化成串行。更根本的是,生成必须拿到 context 才能开始,这两步天然有依赖关系,任何线程池都并行不了。
真正能并行的不是这两步,而是检索内部的多个子查询、或者多个候选答案的并行重排。而这本书把「并行」这件事,做成了一个看起来正确、实际上什么都没并行的示例,还在正文里写「使用 ThreadPoolExecutor 将检索和生成过程并行化」。这属于把概念贴上去,没把逻辑走通。一个照着抄的人,会得到一个「用了线程池但一点没变快」的系统,然后怀疑线程池没用。
同一节的缓存也有类似问题。它给两个字典:embed_cache 存查询的嵌入向量,generate_cache 存生成的响应文本,键都是查询原文。这本是正常做法,但键只用了 query 文本,没有带用户、文档版本、权限范围这些维度。在一个带权限的 RAG 系统里,这等于让 A 用户的检索结果被 B 用户命中。而「多租户」「权限」这两个词,全书没有出现。
五、三个案例,同一个模板填了三遍
第 9、10、11 章分别是企业文档问答、医疗文献检索、法律法规查询。127 屏。我把三章的章块结构并排摆了一下,是这样的:
第 9 章:9.1 需求分析与系统设计(2+2 屏)→ 9.2 搭建向量数据库与检索模块(4+4 屏)→ 9.3 生成模块集成与模型调优(3+4 屏)→ 9.4 系统测试、部署与优化(4+11 屏)→ 9.5 小结 → 9.6 思考题。
第 10 章:10.1 需求分析与数据准备(3+9 屏)→ 10.2 构建高效的检索模块(5+5 屏)→ 10.3 生成模块开发、集成和调优(3+12 屏)→ 10.4 小结 → 10.5 思考题。
第 11 章:11.1 需求分析与数据收集(2+1+5 屏)→ 11.2 法律法规检索模块的实现(3+4+4 屏)→ 11.3 生成模块开发与输出优化(3+3+7 屏)→ 11.4 小结 → 11.5 思考题。
四个步骤,三遍。换的是数据源,不换的是流程。而最费笔墨的那一节,三章都是「提示词调优」:第 9 章 4 屏、第 10 章 12 屏、第 11 章 7 屏,加起来 23 屏在讲同一件事。
p0398 是医疗案例的建库那几步:清洗后数据先 generate_embedding 生成向量,再用 faiss.IndexFlatL2(embedding_dim) 建索引,np.array(...).astype("float32") 转类型,然后 id_to_index=dict(zip(range(len(cleaned_df)), cleaned_df["id"])) 存一份 id 映射以便回指原文。步骤编号是 03、04,前面还有 01、02。
这套流程完全正确,问题在于它和企业案例的流程一字不差。如果你已经读懂第 9 章,第 10 章你只需要读 10.1.2(医学数据清洗 9 屏)和 10.3.2(12 屏提示词调优)里关于「专业性表述」的那部分,剩下的可以跳。第 11 章同理,重点只在 11.1.3 法规数据标准化 5 屏和 11.3.3 输出格式 3 屏。
再往细看一层,连「需求分析」这一步的写法都是同一个模子。p0350 是第 9 章的表 9-2「系统模块与任务分析表」,四个模块一排:数据预处理模块(文本清洗、分词、向量化,存储到数据库)、向量检索模块(检索嵌入向量,筛选与查询内容相关的文本片段)、生成模块(使用生成模型加工检索内容,生成准确且连贯的答案)、响应整合模块(格式化生成内容,确保符合用户预期的展示效果)。
这张表读起来很规整,但它只是四行文字。没有接口定义、没有数据结构、没有模块之间传的是什么。真做系统设计的人,会在这里写清楚「检索模块返回 Top-K 个 (doc_id, chunk, score) 三元组,生成模块的输入预算是多少 token,超出怎么截断」——这些一个都没有。同理,第 10 章的「生成内容的优化与提示词调优」12 屏,最后一屏的测试是这样的:
query="What are the latest treatments for cancer?"
answer=answer_medical_query_with_optimization(query)
print("\n优化后的回答:")(p0420)
输一个问题,看一眼回答,就算验证了「优化后」。没有一组测试问题,没有一次对比优化前后的差异,甚至提问用的还是英文。12 屏的「提示词调优」调了什么、凭什么说变好了,全凭读者自己相信。这是全书三个案例共同的验证方式,也是我最不能接受的一点:一本教人做系统的书,自己交付的系统没有验收标准。
所以 127 屏案例的真实增量,我估计不到 40 屏。这不是说案例没用——对一个从没做过 RAG 的人来说,跟着做一遍就是最大的价值。但对一个已经做过一遍的人,后两个案例是重复劳动。而书里没有给任何「跳过指引」,也没在开头说「三个案例结构相同,读一个即可」。
更可惜的是那个真正该展开的差别:三个场景的语料性质完全不同。企业文档是结构化加半结构化、医疗文献是长篇带术语和缩写、法律法规是条款编号加引用关系。这些差别会直接决定切片策略、要不要做实体识别、要不要保留条款层级——而书里三章用的都是同一套「清洗→嵌入→Flat 索引→提示词」,没有一屏讨论「为什么医疗场景不该用和企业场景一样的切片」。这才是案例章最该有的东西,也是它唯一没能给出的东西。
六、它的短板
列四条。
第一,部署示例用随机数训练 IVF 索引。第 9 章 9.4.2「企业环境的部署与上线」11 屏,是全章最像生产的一节。p0378 里给了一个 VectorDatabase 类,初始化时同时建了 IndexFlatL2 和 IndexIVFFlat:
self.index_ivf=faiss.IndexIVFFlat(self.index_flat, dim, nlist)
self.index_ivf.train(np.random.rand(1000, dim).astype("float32")) # 模型训练
self.index_ivf.add(np.random.rand(1000, dim).astype("float32")) # 添加数据(p0378)
问题就在 np.random.rand 这四个字。IVF 的训练是在真实向量上做 k-means 聚类,聚类中心必须来自你真实的语料分布;拿 1000 条随机数训练出来的聚类中心,跟你的文档毫无关系。这样建出来的索引能跑,检索也能返回结果,但召回质量会莫名其妙地差,而且你查不出原因——因为代码没报错。
我知道这是示例,作者可能只是想演示 API 用法。但这一节的小标题叫「企业环境的部署与上线」,读者拿它当模板改,就会把这个坑一起带走。一处注释、一句话(「实际使用时请用真实向量训练」)就能解决的事,书里没有。
第二,示例回答不带溯源。p0253 有一个「从检索到生成的优化路径」的输出示例,回答长这样:「生成模型通常基于大量数据训练,依赖模式匹配生成内容。检索增强生成结合了语义匹配和内容生成的优势。在复杂任务中,嵌入模型帮助生成模型获取更丰富的上下文信息。请提供详细回答。」
这段文字没有一处来自具体文档,也没有一句标注出处——它是「关于 RAG 的泛泛而谈」,不是「基于检索结果回答问题」。而这正是 RAG 最该被检验的地方:回答里的每一句,能不能回指到某个 chunk。全书 471 屏,我没有看到一次「按 [1][2] 标注引用来源」的实现,也没有一屏讨论「模型没检索到相关内容时该怎么拒答」。这两件事,是 RAG 从 demo 走向可用的门槛。
第三,A* 那一节与主题无关。前面已经说过,1.5.2 花了 4 屏讲网格地图上的 A* 寻路。这类内容在「智能体」书里勉强算相关(规划算法),在一本 RAG 书里是硬凑。同样的篇幅如果用来讲「查询改写」或者「HyDE」,价值会高得多——而这两个词,全书没有出现。
第四,第 7、8 两章太薄,且位置尴尬。第 7 章「构建检索向量数据库」28 屏,第 8 章「延迟与缓存调优」26 屏,加起来 54 屏,只占 11.5%。而这两章恰恰是「能跑」和「能用」之间的那道门。第 7 章的数据清洗只有 6 屏讲流程、5 屏讲标注,对一个真实项目来说,清洗通常要占掉一半以上的工作量;第 8 章讲缓存策略 5 屏,没有一屏讨论「缓存键怎么设计、什么内容不该被缓存」(比如带用户权限的检索结果,缓存了就会串号)。
顺便说一句,这本书的思考题设计得不错。每章末尾都有 3 到 4 屏思考题,题目是「为什么 IVF 需要训练」这类真问题,不是「请简述 RAG 的定义」。如果只把 152 个章块里的思考题抽出来做一遍,可能比通读全书收获更大。
七、怎么读它
想搞懂检索本身:读第 5 章(p0196–p0240,45 屏),把三种索引的代码和「什么时候用哪个」抄下来。这一章的密度值这个时间。
想搭一个能跑的原型:读第 4 章(p0159–p0195,38 屏),它把小向量库、公开模型、问答流程串成了一条完整链路,是全书最像「一节课」的一章。
已经搭过、想优化性能:读第 8 章(p0319–p0344,26 屏)里的 p0332 分段计时那 4 屏,然后把计时加进自己的项目,比读完整章有用。
三个案例:只读第 9 章(43 屏),再补第 10 章 10.1.2 的医学数据清洗 9 屏和第 11 章 11.1.3 的法规标准化 5 屏。剩下的重复内容可以跳。
第 1 章那 74 屏,如果你已经会 conda 和 Pandas,直接从 1.3.2「并行与异步处理」读起就行——那 5 屏至少和「批量入库要并行」这件事有关。
还有一个我建议的读法,可能比按章读更省时间:先把全书 11 章的「本章小结」和「思考题」抽出来读一遍,共 30 多屏。小结会告诉你每章想解决什么,思考题会告诉你哪些地方作者自己也知道是难点——比如「为什么 IVF 需要训练」「为什么块重叠不能太大」这类题,答不上来的就回去读对应小节。这样一轮下来大概两小时,能定位到你真正缺的那几块,再去补,比从头读到尾省一半时间。
再补一句关于版本时间的提醒。这本是 2025 年 4 月的第 1 版,书里用的嵌入模型是 MiniLM 和多语言 e5 那一代,检索结论都建立在「双塔 + 向量相似度」上。到你读到的时候,混合检索(BM25 + 向量)、重排模型、上下文压缩这些做法已经普及,而这本书里几乎没有涉及。这不是书的问题,是这一行的速度问题——拿它当施工图没问题,拿它当现状说明书会过时。
八、一句话
它把「搭一个 RAG」写成了可以照着做的工序单,却没写「这道工序为什么长这样」;于是你能造出一个能回答问题的系统,但回答错的时候,你不知道该拧哪颗螺丝。
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: