
Building AI Agents with LLMs, RAG, and Knowledge Graphs:189 屏讲强化学习,15 屏讲提示工程
微信读书《Building AI Agents with LLMs, RAG, and Knowledge Graphs》(Salvatore Raieli、Gabriele Iuculano 等多位作者合写,中英对照排版)· 逐页翻阅 1500 屏 · 抓取在第 1500 屏被上限截断(truncated=True,end_reason 为空),读到第 11 章末节「No clear superiority of multi-agents」,未到书尾 · 阅读器共记录 196 个章块,11 章、三个部分 · 抓取耗时 1443.2 秒。
抽样说明:我按"三部分各取典型"抽读——p0050 第 1 章词袋矩阵代码、p0060 Word2vec、p0110 训练前的预处理三步、p0140 RNN 的局限与 transformer 的由来、p0200 知识蒸馏的 KL 损失、p0450 第 5 章 RAG 流程与 span 抽取、p0900 强化学习的三类局限、p1030 第 9 章 HuggingGPT 的模型执行、p1150 SaaS/PaaS 部署、p1320 指令微调的数据要求、p1362 第 10 章的生产日志代码,共 18 张。
章屏数按阅读器章标签逐页归属计算,含章标题页。所有引文、代码、数值只来自上述页面;"篇幅按学科教科书排,不按工程优先级排"是我的判断,不是书里的自评。因为抓取在 1500 屏截断,第 11 章只读到 63 屏,我对全书完整性的评价仅限于此前的十章半。
先说结论:这是一本结构最完整、篇幅也最失控的 Agent 书。
完整到什么程度?它从"文本怎么变成向量"开始,一路讲到"怎么用 Docker 和 Kubernetes 部署",中间不跳步:one-hot → 词袋 → TF-IDF → word2vec → RNN/LSTM/GRU → transformer → 大模型 → Agent 的脑-感知-行动框架 → RAG → 高级 RAG → 知识图谱 → 强化学习 → 单/多智能体 → Streamlit 应用 → MLOps → 未来展望。11 章,196 个章块,我读了 1500 屏还没读到书尾。
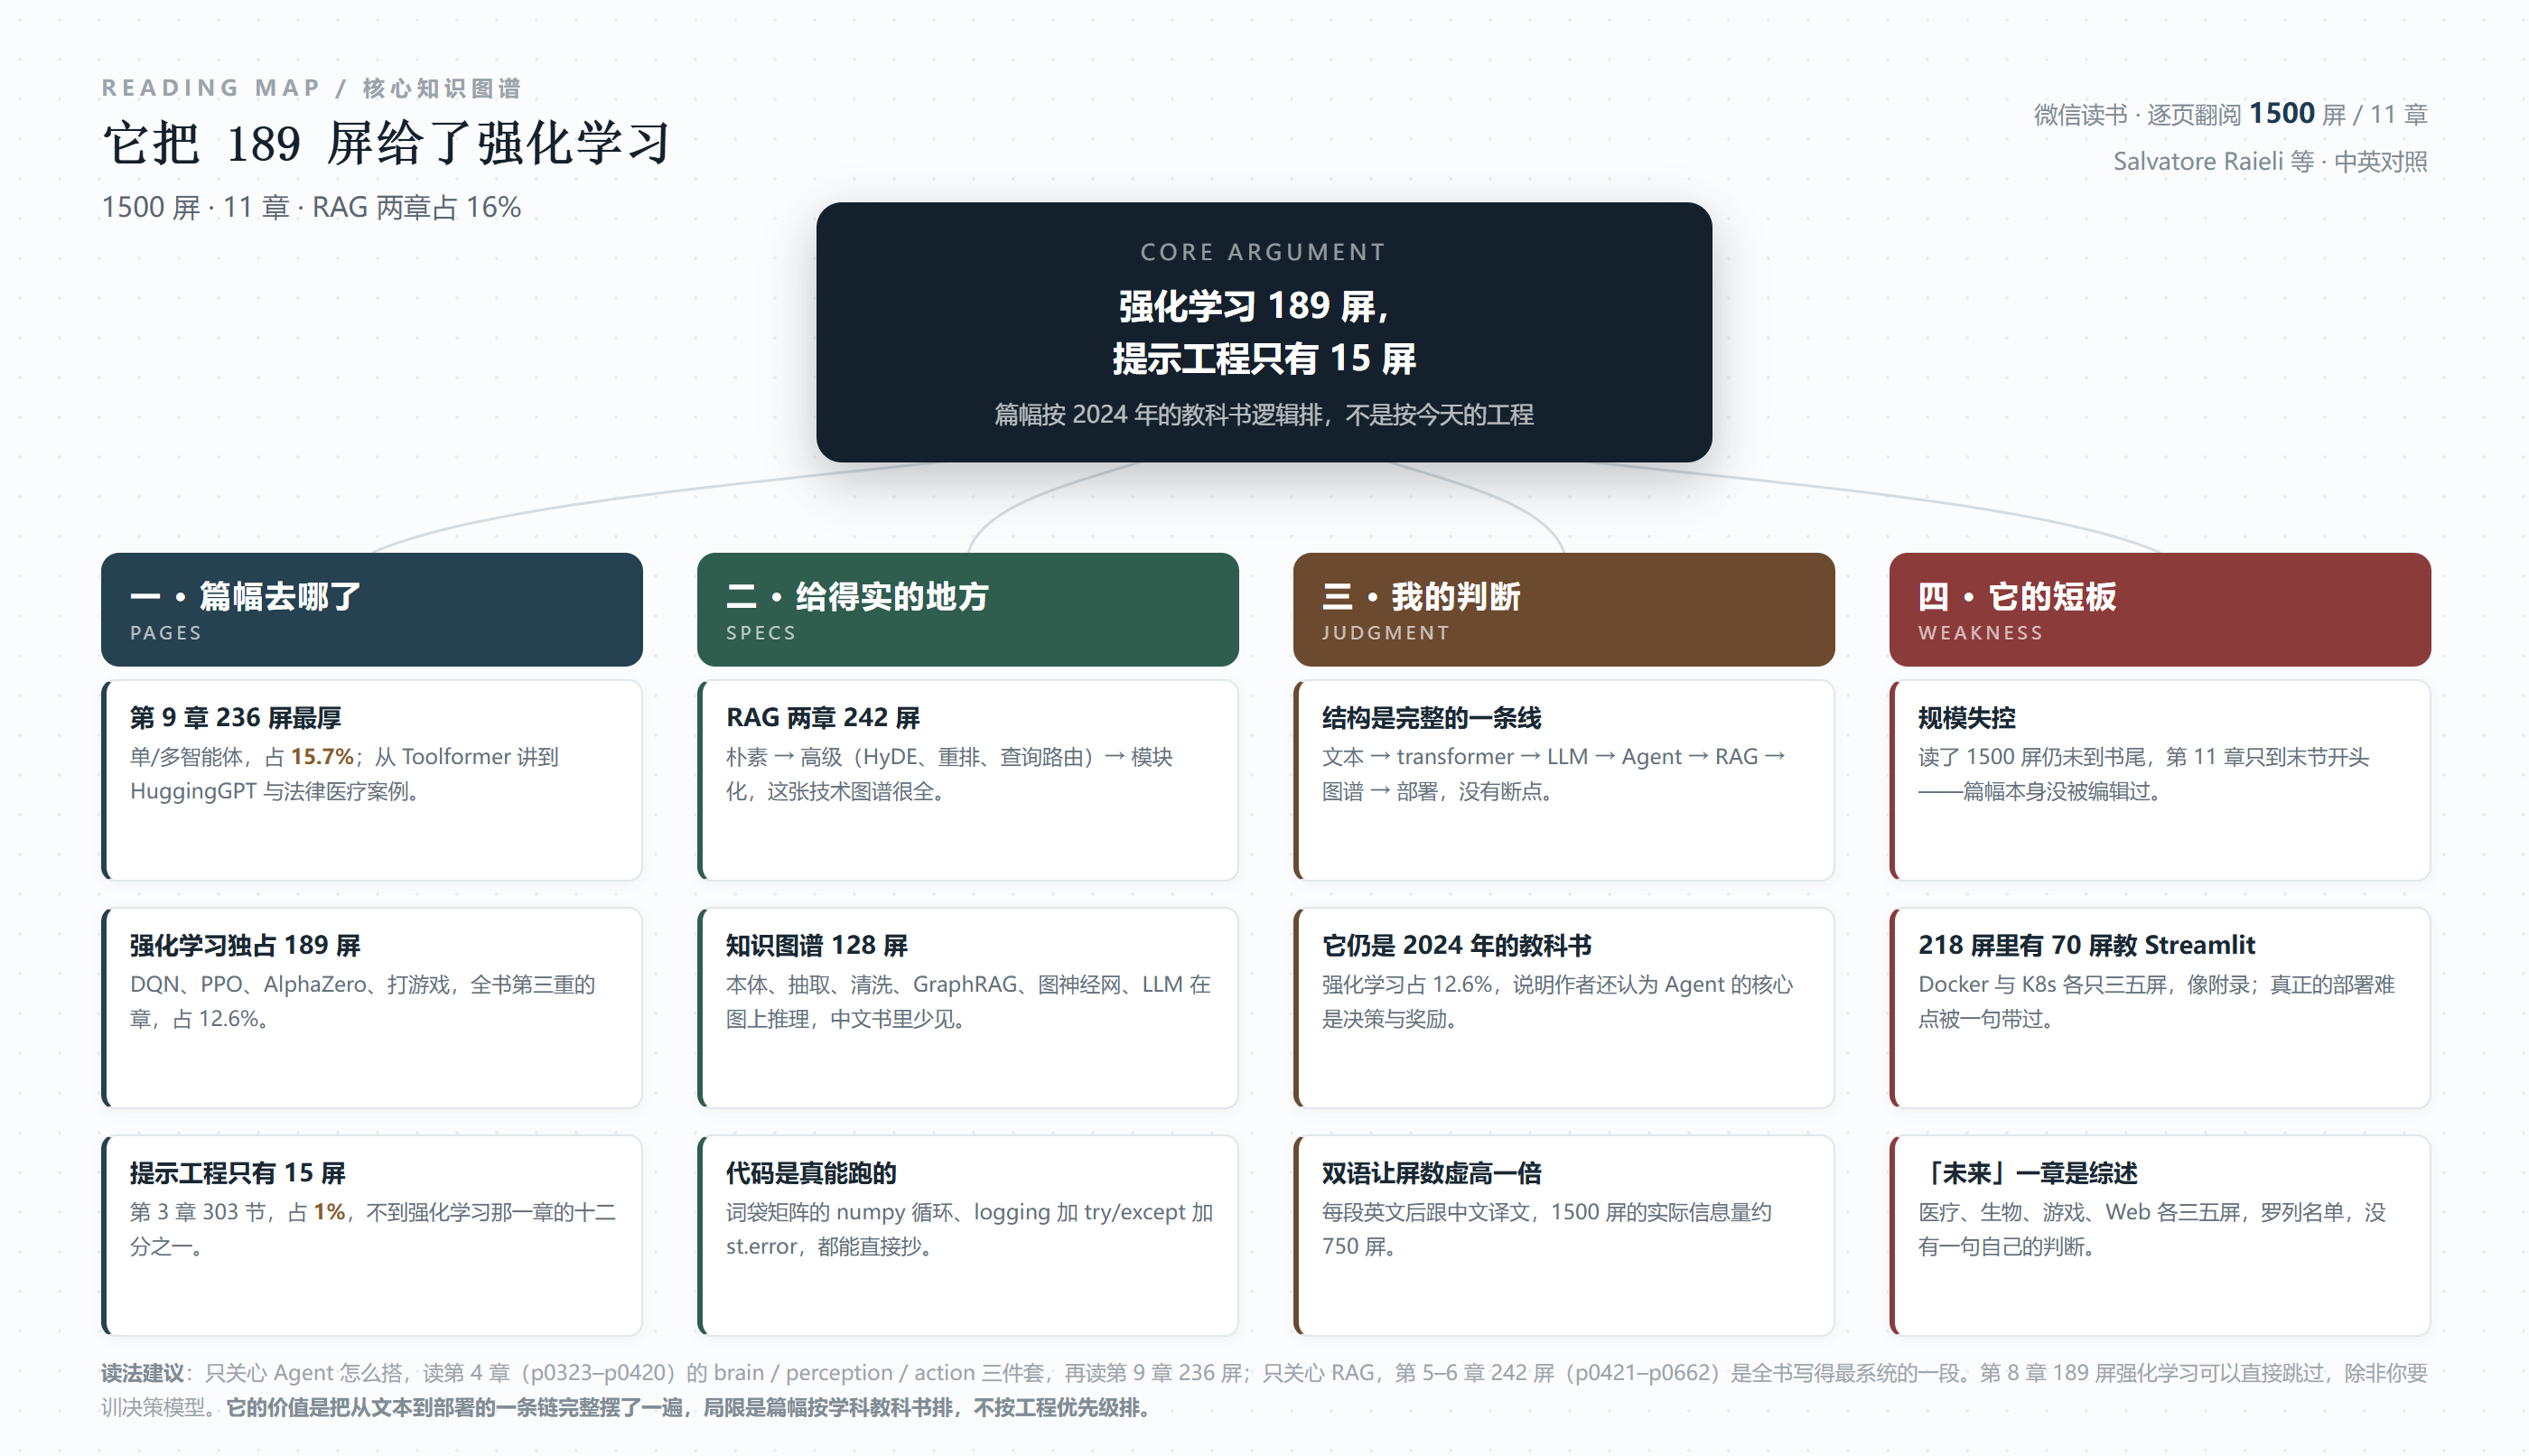
失控到什么程度?也是这 1500 屏。一本讲 Agent 的书,给了强化学习 189 屏(DQN、PPO、AlphaZero、教模型打游戏),给了提示工程 15 屏。这个比例不是排版失误,是作者的学科出身——他是按"智能体=决策智能体"的经典定义来搭这本书的。
三个部分的分配是:Part 1「AI Agent 引擎:从文本到大模型」288 屏,占 19.2%;Part 2「AI Agent 与知识检索」660 屏,占 44.0%;Part 3「构建复杂 AI 系统」520 屏,占 34.7%。前面加 33 屏版权、作者、前言。
把这三个数字放在一起看,你就知道该从哪读、该跳哪了。
一、先看骨架:288 / 660 / 520
Part 1 三章:第 1 章「用深度学习分析文本」85 屏,第 2 章「Transformer」88 屏,第 3 章「把大模型当作强大引擎」113 屏。
Part 2 五章:第 4 章「用 LLM 造一个网页抓取 Agent」98 屏,第 5 章「用 RAG 扩展你的 Agent」97 屏,第 6 章「高级 RAG 技术」145 屏,第 7 章「给 Agent 接上知识图谱」128 屏,第 8 章「强化学习与 AI Agent」189 屏。
Part 3 三章:第 9 章「单智能体与多智能体系统」236 屏(全书最厚的一章),第 10 章「构建一个 AI Agent 应用」218 屏,第 11 章「未来」63 屏(截断处)。
最厚的三章是 9、10、8,加起来 643 屏,占 43%。最薄的三章是 1、2、5,加起来 270 屏。注意这个排序:讲"怎么搭一个能跑的 Agent"的第 9 章最厚,讲"背后的数学"的第 1、2 章反而不厚。
这一点值得肯定。很多从零讲起的书会把基础部分写成大部头,读完三百页还在讲梯度下降,读者早就跑了。这本书把基础压在 173 屏(第 1、2 章),把篇幅让给"能跑起来的东西",这个取舍是对的。
问题出在 Part 2。660 屏里,RAG 占 242 屏(第 5、6 章),知识图谱 128 屏,强化学习 189 屏。RAG 和知识图谱加起来 370 屏,是真本事;强化学习 189 屏,是这本书最重的一块石头,也是它最大的时代错位。后面单独说。
二、Part 1 的 288 屏:从 one-hot 讲到 transformer,脚是站稳的
第 1 章 85 屏,脉络是标准的 NLP 教科书顺序:one-hot 编码(p0040)、词袋(p0045)、TF-IDF(p0052)、word2vec(p0060)、相似度(p0070)、RNN(p0083)、LSTM(p0090)、GRU(p0097)、CNN 做文本(p0102),最后落在一个情感分析实战(p0106–p0117)。
这套顺序我读着很熟,因为它是 2015 年前后所有 NLP 课的排法。它对不对?对。它够不够?不够。
说它对,是因为这本书真的给了可运行的代码。p0050 那段词袋矩阵,是一个完整的 numpy 双层循环:先把所有句子切成词、建词表、用 np.zeros((len(sentences), len(vocabulary)), dtype=int) 开矩阵,再逐词累加计数。这不是伪代码,是能直接跑出结果的实现。同类书里大量出现"我们可以这样实现"然后贴一段跑不通的示意,这本书没这么干。
p0110 的训练前三步也写得具体:预处理(去多余空格、特殊字符、标点)、分词(去停用词、去单字符词)、向量化(按词表转成索引)。中间有一句括号注得很实在——"对于每条评论,我们仅保留 1,000 个出现频率最高的单词——此步骤的目的是为了减少训练过程中的计算量"。这句话把"为什么只取 1000 个词"交代了,是工程思维,不是教科书思维。
说它不够,是因为 85 屏的代价。一个 2026 年想搭 Agent 的人,需要知道 one-hot 吗?严格说不需要——他调 API、写提示词、接工具,一辈子碰不到 one-hot。这本书花 85 屏讲这一套,等于向读者收了一笔"基础税"。它收得诚实(明说了这是给初学者的),但收得贵。
第 2 章 88 屏讲 transformer,写得比第 1 章利落。p0140 有一段交代了 transformer 的由来,我认为是全书叙事最好的一处:先列 RNN 的五条罪状(词表外词处理不了、代词与语法错误、长文本丢上下文、领域不匹配就失效、无法并行),然后一句话转折——"考虑到这些因素,2016 年谷歌的研究人员提出了一个全新的思路:干脆彻底摒弃循环神经网络,而非对其进行改进"。
这句话的分量在于它说清了 transformer 不是"更好的 RNN",是"不要 RNN"。很多科普把这两件事混着讲,读者以为 transformer 是 RNN 的升级版。这本书没混。
"Considering these points, Google researchers in 2016 came up with the idea of eliminating RNNs altogether rather than improving them… all you need is a model that is based on multi-head self-attention."
考虑到这些因素,2016 年谷歌的研究人员提出了一个全新的思路:干脆彻底摒弃循环神经网络,而非对其进行改进。
第 3 章 113 屏,是 Part 1 最厚的一章,讲"把大模型当作强大引擎"。它的分配很能说明问题:缩放定律 11 屏(p0212)、涌现能力 5 屏(p0223)、上下文长度 3 屏(p0228)、混合专家 5 屏(p0231)、指令微调与对齐 19 屏(p0236)、更小更高效的模型 11 屏(p0255)、多模态 26 屏(p0266)、幻觉与伦理法律问题 11 屏(p0292)、提示工程 15 屏(p0303)。
这组数字里藏着两个失衡。
第一个:多模态 26 屏,提示工程 15 屏。多模态确实重要,但一本讲 Agent 的书,用接近提示工程两倍的篇幅讲"模型还能看图",而提示工程只有 15 屏——这是在讲模型的能力,不是在讲怎么用它。读者要的是"我该怎么写指令让模型稳定输出 JSON",不是"VLM 能识别图片里的猫"。
第二个:上下文长度只有 3 屏。这是 2024 年之后 Agent 工程最核心的变量之一——上下文能放多长,直接决定了你能塞几个工具、几段检索结果、几轮对话历史,也直接决定了成本和延迟。3 屏,刚够说清"现在的模型支持几十万 token",说不清"上下文长了以后中间部分会被忽略"这类真正影响设计的事实。
反过来,对齐那 19 屏(p0236)写得还行。p1320 讲指令微调时的数据要求,列出了两条我认为很实在的标准:一是数据分布要覆盖多种任务、不同主题、不同上下文、不同长度、不同风格;二是数据质量要保证事实正确,还要保证任务执行正确且解释清楚。这两条是做过微调的人才会写的,不是抄论文摘要。
所以第 3 章的 113 屏,我的评价是"选材偏模型、偏研究,轻应用"。它更像一篇"大模型综述",不像一章"Agent 引擎使用手册"。
三、Part 2 的 660 屏:RAG 两章 242 屏,这是全书最值钱的地方
如果这本书只留一章,我留第 6 章。
第 5 章 97 屏讲朴素 RAG:流程(p0424)、分块策略(p0452)、嵌入策略(p0464)、向量库(p0480)、输出评估(p0489)、RAG 与微调的对比(p0499)。这是入门必需的骨架,写得规矩。
第 6 章 145 屏讲高级 RAG,是全书密度最高的一段。它的目录本身就是一张技术地图:朴素 RAG 的问题(p0522)→ 高级 RAG 流水线(p0528)→ 层级索引(p0531)→ 假设性问题与 HyDE(p0536)→ 上下文增强(p0542)→ 查询转换(p0545)→ 关键词检索与混合检索(p0548)→ 查询路由(p0551)→ 重排(p0558)→ 响应优化(p0572)→ 模块化 RAG(p0584)→ 训练与非训练方案(p0590)→ 实现(p0600)→ 可扩展性与性能(p0610:数据规模与预处理 p0612、并行处理 p0621、安全与隐私 p0630)。
这十四个手段,2024 年之后做 RAG 的人基本都要碰。难的是把它们排成一条有因果的链:先承认朴素 RAG 哪里不行(检索不准、上下文碎、答非所问),再逐个给补丁——检索不准就上混合检索和重排,上下文碎就上层级索引和上下文增强,答非所问就上查询转换和查询路由。这个排法是有逻辑的,不是名词罗列。
p0450 还有一段有意思的补充:除了"检索最相关的文本块",还有一种替代架构叫 span 抽取(span extraction)——不用语言模型去找最合适的块,而是让它直接在文本里标出能回答问题的那个片段(span labeling)。书里举的例子是维基百科 + "Who is the president of France?",抽取器会在页面上标出回答这个问题的段落。
这个区分很细,但很重要:检索是"找块",抽取是"找句"。前者粒度粗、召回高,后者精度高、但依赖标注能力。多数 RAG 教程只讲前者,这本书把后者也摆出来了,说明作者读过原始论文,不是二手转述。
"In this case, instead of finding the most appropriate chunks, we have a language model (usually also derived from BERT) that is used to find passages in the text that answer a query (span labeling)."
在这种方法中,我们不去寻找最合适的文本片段,而是使用语言模型(通常也是基于 BERT 模型开发的)来识别文本中能回答查询内容的段落。
四、知识图谱 128 屏:中文书里少见的一段
第 7 章 128 屏,从"什么是知识图谱"讲到"LLM 在图上怎么做推理",路径是:形式定义(p0673)→ 分类体系与本体(p0683)→ 知识创建(p0689)→ 用 LLM 建图(p0703)→ 知识评估(p0711)→ 清洗(p0714)→ 增强(p0717)→ 托管与部署(p0721)→ 用图检索(p0727:图索引 p0732、图引导检索 p0734)→ GraphRAG 应用(p0746)→ 图推理(p0754)→ 图嵌入(p0758)→ 图神经网络(p0763)→ LLM 在图上推理(p0767)→ 尚存挑战(p0776)。
这段的价值不在深度,在覆盖面。国内讲 RAG 的材料多,讲知识图谱的材料也多,但把两者接起来讲"GraphRAG 到底怎么做"的,成体系的不多。它把"建图—清洗—托管—检索—推理"这条链走完了,虽然每一环都只有几屏,但读者至少知道这一环存在、该去查什么。
我的判断是:这 128 屏是这本书对中文读者最不可替代的部分。RAG 那两章写得好,但市面上同类内容多;知识图谱 + GraphRAG 这一段,能替代它的少。
五、第 8 章 189 屏强化学习:全书最大的时代错位
现在说那块最重的石头。
第 8 章 189 屏,占全书 12.6%,是第三厚的章。它讲什么?多臂老虎机(p0810)、马尔可夫决策过程(p0831)、深度强化学习(p0848)、无模型与有模型(p0851)、同策略与异策略(p0857)、Q-learning 与 DQN(p0868)、REINFORCE(p0875)、PPO(p0882)、actor-critic(p0886)、AlphaZero(p0891)、深度 RL 的挑战(p0899),最后是一个完整项目:教模型打电子游戏(p0903–p0941:环境搭建、定义模型、训练、测试、串联组件),收尾讲 LLM 与 RL 的双向关系(p0942–p0968:RL 增强 LLM、LLM 增强 RL,四种角色——信息处理器、奖励设计者、决策者、生成器)。
写得不算差。p0900 列深度 RL 的三类局限,列得挺准:一是在未见环境中的泛化能力,二是奖励函数设计("奖励函数决定了智能体的行为、学习过程及其表现",在奖励稀疏且反馈延迟的环境里极难设计,还有制造偏见导致过拟合的风险),三是基于模型规划中的复合误差(预测越长,误差累积越大,偏离最优轨迹越远)。这三条是行家话。
"Reward function controls agent behavior, learning, and performance. Designing a reward function is difficult, especially in complex, scattered environments. In sparse reward settings, where there is limited feedback and it is often delayed, defining the reward function is complex but critical."
奖励函数决定了智能体的行为、学习过程及其表现。设计合适的奖励函数颇难度,尤其是在复杂且环境分布分散的情况下。在奖励信息稀少且反馈延迟严重的环境中,定义奖励函数虽然复杂,但却至关重要。
问题不在写得好不好,在该不该用 189 屏。
一个 2026 年做 Agent 应用的工程师,工作流是什么?写提示词、接工具、做 RAG、加护栏、评估、部署。这条链上用得到 PPO 吗?用不到。用得到 AlphaZero 吗?用不到。用得到 DQN 吗?只有在训一个下棋或者打游戏的策略模型时用得到,而那是另一个工种。
真正在 2025–2026 年改变 Agent 能力的东西是什么?是工具调用的稳定性、上下文工程、结构化输出、评估与回归测试、成本控制、多轮记忆管理。这本书给了它们多少屏?提示工程 15 屏(第 3 章 303 节,p0303–p0317),评估散在第 5 章 p0489 附近几屏,成本与延迟几乎没有专节。
189 比 15。12.6 倍。这就是我说的时代错位:它按 2020 年"智能体=强化学习智能体"的学科框架分配篇幅,而 2024 年之后"Agent"这个词的实际所指已经换成了"LLM + 工具 + 循环"。
我得公平一点:这本书不是没意识到。它把 RL 放在 Part 2 的末尾,把多智能体放在 Part 3 的开头,顺序上是"先把决策能力讲清,再讲系统"。而且 p0942 之后那 27 屏讲"LLM 与 RL 互相增强",确实是当前研究的热点(用 LLM 做奖励设计、做决策者),说明作者知道风往哪吹。
但知道风向不等于调过头。189 屏的 DQN 推导和游戏项目,对 95% 的读者是沉没成本。这不是"深度"的代价,是"完整"的代价——作者想让这本书成为一本"从零到一应俱全"的教材,于是把学科目录里该有的东西全塞了进来,包括那些已经不该出现在 Agent 书里的章节。
六、Part 3 的 520 屏:多智能体讲得认真,部署讲得潦草
第 9 章 236 屏,全书最厚,讲单/多智能体系统。它的做法是"论文案例串讲":Toolformer(p1009)、HuggingGPT(p1013,含任务规划 p1022、模型选择 p1026、模型执行 p1031、响应生成 p1034、局限 p1040)、ChemCrow(p1045)、SwiftDossier(p1051)、ChemAgent(p1054)、法律多智能体(p1060)、医疗多智能体(p1066),然后是两个实操(本地跑 HuggingGPT p1088、网页版 p1105)、多智能体系统搭建(p1118),最后 70 多屏讲 SaaS / MaaS / DaaS / RaaS 四种服务范式的对比(p1148–p1218)。
这部分我读得最有收获,也最困惑。
有收获的是 HuggingGPT 那一段。p1030 讲模型执行:一旦任务被分配给具体模型,模型必须被执行;这些模型只在推理时使用,通过 Hugging Face API 调用;为了加速,HuggingGPT 用了混合推理端点(hybrid inference endpoints);选中的模型以任务参数为输入,把结果回传给语言模型(ChatGPT);如果模型之间没有资源依赖,它们的推理可以并行——"换句话说,互不依赖的任务可以同时执行"。
这段把"LLM 当调度器、专用模型当执行器"的架构讲清楚了,而且点出了并行的前提条件(资源无依赖)。这是工程细节,不是概念复述。
困惑的是那 70 多屏的 SaaS/MaaS/DaaS/RaaS。p1150 讲 SaaS:应用常被设计为在云端运行("云原生应用"),开发公司可以自建基础设施托管,也可以用云服务商(Google Cloud、IBM Cloud、OVH、Aruba、AWS、Azure);需求增长催生了专门托管这类应用的"平台即服务"(PaaS);PaaS 里,供应商通过专用基础设施托管硬件和软件,开发者只管写代码,平台承载应用与数据、甚至承载模型训练。
这段内容本身没错,但它是云计算导论,不是 Agent 书该有的内容。一本讲"怎么搭 Agent"的书,用 70 屏讲 IaaS/PaaS/SaaS 的分类,等于用 70 页讲"什么是服务器"。这些知识在阿里云、腾讯云的官网上有更清楚、更新的版本,而且不需要读英文原著的中译。
第 10 章 218 屏讲"构建一个 Agent 应用",问题类似,但程度好一些。它的路径是:Streamlit 入门(p1225)、缓存结果(p1240)、文本元素(p1253)、插入图片(p1257)、做动态应用(p1260)、Streamlit + Agent(p1276)、MLOps 与 LLMOps(p1297:模型开发 p1307、训练 p1318、测试 p1328、推理优化 p1332)、并行(p1346 数据/流水线/张量并行)、生产错误处理(p1360)、生产安全(p1363:密钥管理 p1364、数据泄露防护 p1368、部署环境加固 p1370)、异步编程(p1375:asyncio p1393、异步与 ML p1401)、Docker(p1413)、Kubernetes(p1421)、Docker 与 ML(p1423)。
218 屏里,Streamlit 相关约 70 屏(p1225–p1296),这是"教你怎么用 Streamlit 画界面",不是"教你怎么搭 Agent"。真正的生产问题——并发、限流、重试、成本、可观测性——只占了 p1360 到 p1436 这七十来屏,其中 Docker 只给 8 屏(p1413–p1420)、Kubernetes 只给 2 屏(p1421–p1422)。
p1362 那段日志代码是全书少见的"能直接用"的片段:logging.basicConfig(level=logging.INFO)、logger = logging.getLogger(__name__)、try 里记 logger.info("Calling OpenAI API")、except 里 logger.exception("API call failed") 然后 st.error("Something went wrong.")。十几行,把"日志 + 异常 + 用户提示"三件事串起来了。这种代码比一百页架构图有用。
但它也就是十几行。整本书对"生产"的交代,基本就停在这个粒度:给你一个能跑的骨架,不给你在真实流量下会遇到的坑。
Part 3 还有一个内部矛盾,我觉得必须点出来。第 9 章用 236 屏讲多智能体,第 11 章的 p1484 却用一个小节标题说"No clear superiority of multi-agents"——多智能体没有明显优势。
这两件事放在一本书里,是打架的。如果多智能体没有明显优势,那 236 屏的 ChemCrow、SwiftDossier、ChemAgent、法律多智能体、医疗多智能体,讲的是什么?讲的是"有人做过"。做过不等于值得做,更不等于更优。
我倾向认为 p1484 那个判断是对的。这两年多智能体的实践反复证明一件事:把任务拆给多个 Agent,收益往往抵不过协调成本——角色设定互相污染、状态传递丢信息、token 消耗翻几倍、调试难度指数上升。真正有效的"多智能体",多半只是一个 Agent 加几个工具。
所以这本书的结构暴露了一个更深的问题:它把"研究上有人做过"当成了"工程上应该这么做"。第 9 章的 236 屏是按论文影响力排序的,不是按落地价值排序的。读者读完会以为多智能体是进阶方向,实际上多半会被它坑一遍——而作者自己已经在最后一章承认了这一点,只是没回头去改前面的篇幅。
七、它的短板
第一,篇幅完全失控。1500 屏还没读完,第 11 章只到 63 屏。这不是抓取的问题,是书本身的问题——一本技术书应该在编辑阶段被砍掉三分之一。190 屏的 RL、70 屏的 SaaS 分类、70 屏的 Streamlit 教学,这三块加起来 330 屏,占已读篇幅的 22%,砍掉不影响任何核心能力。作者显然没人帮他砍。
第二,篇幅按学科逻辑排,不按工程优先级排。这是全书最根本的问题。学科逻辑是:文本→词向量→序列模型→transformer→LLM→RL→Agent。工程逻辑是:能跑→能评→能控成本→能上线。这本书走的是前者,所以读者要读到第 900 屏才碰到"多智能体",而那才是他一开始想学的东西。
第三,双语对照让屏数虚高一倍。每段英文后面紧跟中文译文,同样的内容排两遍。1500 屏的实际信息量约等于 750 屏。这不影响内容质量,但影响判断——你看到"1500 屏的巨著",实际是一本 750 屏的书加了对照译文。对中文读者这是好事(能对照原文),但评价它的"厚度"时要打个对折。
第四,"未来"一章是综述,没有判断。第 11 章 63 屏(截断前),内容是医疗 Agent(p1440)、生物医学 Agent(p1446)、物理 Agent(p1461)、游戏 LLM Agent(p1467)、Web Agent(p1472)、人机沟通挑战(p1474)、多智能体的"没有明显优势"(p1484)。每一块三五屏,都是"某某团队做了什么"的罗列。p1484 那个小节标题其实很有意思——"No clear superiority of multi-agents",直译是"多智能体没有明显优势"——这是全书少见的、敢下判断的标题。可惜它出现在最后一章,而且只有几屏。
第五,没有失败复盘。全书有大量"我们这样做了,效果不错",几乎没有"我们这样做砸了,因为……"。RAG 部分讲了朴素 RAG 的问题(第 6 章 p0522),这是唯一的例外,也是全书最好的部分——因为它承认了不行。其余章节,包括那个打游戏的项目,都是顺利跑通的叙事。
第六,代码不成体系。书里有能跑的片段(词袋矩阵、日志、Streamlit),但它们散在各章,拼不成一个完整项目。前言提到可以下载示例代码(p0025 "Download the example code files"),但正文里的代码片段之间缺少衔接,读者很难跟着做出一个端到端的 Agent。
八、怎么读这本书
如果你只想搭一个能用的 Agent:读第 4 章(p0323–p0420)的脑-感知-行动框架,再读第 9 章的前 130 屏(p0983–p1117),把 HuggingGPT 的任务规划-模型选择-模型执行三段看懂。这两块加起来约 230 屏,是全书最"能落地"的部分。其余可以全跳。
如果你在做 RAG:第 5、6 章共 242 屏(p0421–p0662)必须逐页读。它的价值在于把十四个优化手段排成了一条有因果的链,你读完能自己判断"我的检索为什么不准、该上哪个补丁"。这一段我愿意给它打高分。
如果你要接知识图谱:第 7 章 128 屏(p0663–p0790)。重点看 p0727–p0746 的图引导检索和 GraphRAG 应用,前面建图的流程可以快读。
第 8 章 189 屏强化学习(p0791–p0979):除非你要训决策模型或打游戏,否则整章跳过。想做 RLHF 的,只看 p0942–p0968 那 27 屏"LLM 与 RL 互相增强",够用了。
第 1、2 章 173 屏(p0034–p0206):如果你已经知道 transformer 是什么,跳过。如果不知道,读第 2 章 p0140 那一段(RNN 五条罪状 + 2016 年谷歌的判断),比读完整章省时间。
第 10 章的 Streamlit 部分(p1225–p1296)可跳,你需要的是 p1297 之后的 MLOps 与生产安全,尤其是 p1360–p1374 那十几屏的日志、密钥管理、数据泄露防护——虽然浅,但方向对。
最后提醒:这本书是英文原著加中译对照,读到中文译文卡住时,回去看英文原句通常更清楚。技术术语的翻译质量参差,比如 "span extraction" 译成"段落提取方法"就不太准(它抽的是 span,不是段落)。
一句话:它把从文本处理到部署的一条链完整摆了一遍,RAG 与知识图谱两章有真东西,这份完整在中文可读的 Agent 书里少见;但它的篇幅是按学科教科书排的,不是按工程优先级排的——你想要的那 15 屏提示工程,它只给了 15 屏,而你可能一辈子用不上的 DQN,它给了 189 屏。
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: