
大模型工程师面试:面试官不问原理,问你那 80G 显存怎么分
微信读书《大模型工程师面试:算法原理、开发实践与系统部署》· 本次逐页翻阅 320 屏,读到第 5 章末(p0320,页面出现"下一章"按钮),抓取标记 reached_end=False(truncated=True,是抓取在半途停,不是书读完)。
说明:这是下篇,只写第 4 章「大模型部署与推理优化」与第 5 章「大模型微调技术」,对应 p0225–p0320,共 96 屏;第 1–3 章(发展史、岗位解析、数据集、预训练原理)已单独写过一篇,不在这里重复。引句页码为本次截图编号,与纸书页码无关;文中标"我的判断"处是评论,已与原文分开,凡是加引号的话都能在对应截图里逐字核对。
这本书的后半本,比前半本值钱。
前半本讲历史、讲岗位、讲数据集怎么清洗、讲 Transformer 的注意力怎么写,写得稳,但稳得像教科书——那种你在任何一本 NLP 教材里都能找到的稳。后半本不一样:它开始讲部署的四条路、讲延迟怎么拆、讲 KV-Cache 为什么能把生成时间变成常数、讲 LoRA 的两个矩阵怎么长出来。这些内容你在别处也能找到,但很少有人按"面试官会怎么追"的顺序排一遍。
所以这篇我不复述目录。我想干三件事:把它讲对的地方讲清楚为什么对,把它讲漏的地方一条条挑出来(尤其是那些"看着对、真上机会翻车"的地方),最后给它一个我认为诚实的定位。
先交个底:我看的这 96 屏里,没有一处可复现的实测数字。没有 token/s,没有显存占了多少 GB,没有"加速 3.2 倍"。全是"显著提升""明显上升""显著压缩"这类形容词。这对一本以面试为卖点的书,是硬伤——因为面试官最爱问的那句话,恰好是"你测出来多少"。
一、部署那章:它把"上云还是上机"讲成了一道算术题
第 4 章开篇的四小节,摆出四条路:本地部署与云端服务部署(4.1.1)、ONNX 与 TensorRT(4.1.2)、HuggingFace + FastAPI 组合(4.1.3)、Triton Inference Server(4.1.4)。
摆在目录上,这四条像四个并列的选项。但真读过就知道它们不是并列关系,而是三种不同层次的东西被平铺在了一起:本地/云端回答的是"机器归谁",ONNX+TensorRT 回答的是"用什么格式跑",FastAPI 和 Triton 回答的是"谁来接请求"。这三层是可以叠的——你完全可以在本地 A100 上,用 ONNX 导出、TensorRT 加速、Triton 调度、外面再套一层 FastAPI 做鉴权和限流。
我的判断是:这一节的真正价值,是它隐含了一个判断顺序,但它没把这个顺序挑明——先看数据能不能出机房(合规),再看 QPS 峰值有多高(吞吐),最后看团队有没有人会运维(Triton 的配置文件能把人劝退)。这个顺序比四小节本身重要,可惜作者把它写成了并列,读者很容易当成"四选一"。
ONNX 和 TensorRT 那一段(p0232)是全书少见的、可以直接背下来当答案的段落。它把链路讲清了:训练完先把模型转成 ONNX 这个"标准中间格式",再交给 TensorRT 做图优化、层融合、精度压缩、内存管理,最后生成一个针对目标硬件编译好的引擎文件,丢到生产环境里跑。
「TensorRT 作为 NVIDIA 推出的高性能推理引擎,可以在 GPU 平台上对 ONNX 模型进行图优化、层融合、精度压缩与内存管理等深度优化操作,从而显著提升推理速度与资源利用率。」
这句话是可以直接说给面试官听的。但它紧接着的那半句"显著提升",就是问题所在——显著是多少?在什么卡上?batch 多大?输入多长?一个都不给。
更关键的是,这一节没提 TensorRT 真正的坑。做过的人都知道,TensorRT 最疼的不是"怎么转",是转完之后对不上:动态 shape 要显式声明 profile 否则只认那一个尺寸;某些算子没有 plugin 实现,只能退回 ONNX Runtime;fp16 和 int8 之后输出和 PyTorch 有微小偏差,而这点偏差在生成任务里会被放大成完全不同的句子。这三件事,一个都没写。
所以这一节的性质是:它给了你一张能画在白板上的架构图,没给你一张会踩的坑清单。面试里够用,上机不够用。
二、延迟分析:它给了一个可执行的顺序,这比结论值钱
4.2.2「推理 Latency 瓶颈分析」是我认为全章第二值钱的一节,值钱的原因不是它给了答案,是它给了一个可执行的排查顺序。
它说延迟要从"输入—模型加载—计算执行—输出生成"这条全流程上逐段量,而不是笼统地说"服务慢"。然后点了三个特别容易踩的坑:批次大小设置不当、张量形状不对齐、推理引擎没启用优化路径。
第三条值得单独说一句:形状不对齐会导致引擎反复重编译。这件事很多人不知道,表现是"第一句话特别慢,后面就快了",或者"每隔一阵就卡一下"。你如果不知道原理,会以为是网络抖动,加机器、加副本,钱花了问题还在。
它给的动手方式是【例 4-2】:用 transformers 加载模型,用 torch.profiler 加 ProfilerActivity.CPU / CUDA,逐层打出执行时间和关键节点。这个动作是对的——先有 profile 再谈优化,跳过这一步的所有优化都是猜。
但代码一打开,问题就来了。模型是 bert-base-uncased,输入是一句 "Large language models are transforming AI capabilities.",跑的是 BERT 的前向。这是 110M 参数的编码器,一次前向,5 毫秒量级。
而面试官问你的是 7B 解码器、生成 500 个 token、并发 20 路、首 token 多少毫秒、每 token 多少毫秒。
这两件事的差别不是"大一点小一点",是瓶颈位置完全不同:BERT 一次前向是算力密集,7B 自回归生成是显存带宽密集,前者优化靠算子融合,后者优化靠减少搬运(KV-Cache、量化、paged attention)。你用 BERT 得出的 profile 结论,套到 7B 上会得出完全错误的优化方向。
我的判断:方法可以迁移,结论不能。例 4-2 作为"怎么用 profiler"的示范是合格的,作为"大模型延迟怎么分析"的答案是不合格的。而这恰恰又是全书反复出现的一个模式——我下面会专门说。
三、KV-Cache:全书密度最高的两页
如果这本书只让我留两页,我留 p0252–p0253。
图 4-9 并排放了两个结构:左边是多头注意力,Q、K、V 三个张量都是 batch × heads × time;右边是多查询注意力,Q 保留全部 heads,K 和 V 的 heads 维被压成了 1。图上的标注很直白,就是这几个立方体的厚度对比。
然后正文给了那句关键结论:每个新 token 的生成时间保持在常数,而不是随上下文长度线性增加。
这句话为什么重要?因为它解释了一个所有人都在用、但很少有人能说清的现象:为什么同样是 500 字,让模型生成比让它读要慢得多,而且慢得不成比例。读是并行的一次前向,生成是一个 token 一个 token 地串行,每步都要重算注意力——如果不缓存 K 和 V,第 500 个 token 就要把前面 499 个重算一遍。
它还给了一个更实用的东西:相同 Prompt 前缀可以跨请求共享 KV。书里的说法是"在处理相同 Prompt 前缀时可实现更高效的缓存命中率与跨请求共享效果"。这就是今天各家 API 的 prompt caching / prefix caching 的原型——你把系统提示词放在最前面且一字不改,第二次请求就能省掉那一整段的预填充。这件事在工程上的价值,比任何一句"显著提升"都实在。
再加上 p0253 给的 past_key_values 写法(手动把上一步的 K/V 传回去复用),这一节等于同时给了四样东西:结构图、机制解释、代码路径、适用场景(多轮对话、长文写作)。这是全书写得最"工程"的地方,没有之一。
但它漏了最贵的那笔账,而面试官恰恰最爱问这笔账:KV-Cache 自己也吃显存,而且随并发线性膨胀。
书里只轻描淡写地提了一句"压缩 Prompt 扩展带来的内存增长压力"。这句话太轻了。拿一个 7B 的常见配置自己算一遍:32 层、32 个注意力头、每头 128 维、fp16。每个 token 的 KV 是 2(K 和 V)× 32 层 × 32 头 × 128 维 × 2 字节 = 512 KB;4K 上下文就是 2 GB;20 路并发就是 40 GB。而 7B 的权重在 fp16 下才 14 GB——一张 80G 的卡,权重占 14,缓存占 40,剩下的才是 batch、激活值和框架开销。
这就是为什么线上真正的瓶颈往往不是算力不够,是能同时挂多少个请求。这也正是后来 paged attention、GQA、KV 量化这一整套东西存在的原因:它们优化的都不是"算得快一点",是"同一个 token 的缓存少占一点,好让并发多挂几路"。
一句话:这一节讲了"为什么快",没讲"快到哪儿为止"。前半句够你过面试,后半句才是你能不能上线的分界线。
四、量化:从 FP16 到 INT4,它把代价说清楚了
4.2.1 是全书写得最有"论文气味"的一节,这说明作者是真读过原始材料的,不是二手转述。
p0243 那张图 4-6「8 比特量化计算中不同累加精度与操作模式的门级资源占用对比」,横轴是 INT+FP×8、INT+FP16、E2+FP32 这类累加精度与操作模式的组合,纵轴是二输入门的数量,图例里分了 normacc、alignadd、mpy、fixed+12 acc、FP16 acc、FP32 acc 六条线。这张图出自 GPTQ 那篇论文——一本中文面试书愿意把门级资源对比图搬进来,是加分的。
它用这张图讲清了三件事:
第一,FP32 累加精度最高,但代价明显大于 FP16 和定点路径。这句话翻译成人话就是:混合精度不是一个开关,是一个花销表。
第二,INT8 不是简单地把浮点砍一半,它需要通过量化标定来解决非对称映射误差。所以 int8 的效果好坏,一半取决于你的校准集选得好不好,而不是算法本身。
第三,GPTQ 在编码过程中引入分组约束和误差补偿机制,用低精度定点累加(fixed+12 这类)换硬件门数。
这三点,足够你回答"int8 和 fp16 有什么区别"这类问题,而且答得比"int8 更快更省显存"高一个层次。
但这一节有一句话我不同意:
「GPTQ 进一步在编码过程中引入分组约束和误差补偿机制,从底层电路角度实现推理效率与资源使用的最优平衡。」
"最优平衡"是论文里的自我评价,不是工程事实。在你自己的卡上、你自己的任务上,AWQ、SmoothQuant、甚至直接上 FP8,都可能比 GPTQ 更好。把"某篇论文在某个基准上的最优"写成"最优",是这类书最常见的越界。
还有一个更要紧的缺口。4.5 的第 5 题问得极好:
「在部署一个 INT4 精度的量化模型后,用户反馈部分输出结果偏差较大。请结合本章所介绍的 FP16、INT8 和 GPTQ 量化方法,分析可能造成误差放大的原因……」
这题抓住了真问题:量化在指标上是掉 0.3 个点,在用户那里是"答非所问"。但正文没有给出可操作的排查路径。如果让我补,顺序应该是:先做逐层敏感度分析(看是哪几层一量化就崩,然后混合精度,只降不敏感的那部分);再看校准集是否覆盖了你的真实长尾输入(这一步最常被跳过,也最常是元凶);最后才去怀疑算法选型。这套顺序书里没有,而它比任何一句"显著压缩"都有用。
五、微调五层阶梯:可以直接当复习提纲
第 5 章开头 5.1 把微调的技术体系摆成了一排:全参数微调与冻结微调、Prompt Tuning 与 Prefix Tuning、Adapter 与 BitFit。这一排的价值不在于教会你哪一种,而在于让你在面试里能回答那个必问题——"为什么不全参微调"。
标准答案是三句话:显存不够(全参 7B 要存权重+梯度+优化器状态,fp16 下是十几倍权重的量级)、数据不够(几千条数据全参必过拟合)、场景不需要(你要的是改风格,不是改知识)。这本书把这三条隐含在技术罗列里,没明说,但你读完那一排自己就能推出来。
5.2 讲 LoRA,讲对了两个最关键的细节:
一是初始化。A 用随机初始化,B 置零。这样训练开始时旁路输出恒为零,等于在原始模型上"贴了一层透明胶",不会一上来就把预训练学到的东西打乱。这一步是所有 LoRA 面试题的核心,很多人只答得出"低秩分解",答不出"为什么 B 要置零"。
二是缩放。scale = alpha / r。书里的例 5-2 把这两个参数写清楚了:LoRALinear(in, out, r=4, alpha=8),前向是 x @ A.T @ B.T * scale。这个 alpha/r 的比值,才是你调 LoRA 时真正在调的东西——r 决定容量,alpha/r 决定这个旁路在总输出里的权重。
【例 5-2】是自己手写一个 LoRALinear,然后把它注入 BERT 第 0 层的 self.query。这个例子的好处是:你终于看见"旁路是怎么长出来的",而不是调一个 get_peft_model() 就完事。坏处有两个:r=4 只是演示值,实战里 8 到 64 更常见;而且它没讲该注入哪几层——选 q_proj/v_proj 和选全部线性层,是完全不同的两个世界(效果差一截,显存也差一截)。这个问题在面试里一问就露底。
5.2.2 提到 PEFT 这类库可以实现"模块化配置与快速注入,无须更改模型结构"。这句是对的,也是 LoRA 真正统治微调圈的原因——同一个基座,挂不同的适配器,就是不同的专家模型,切换只是换个文件。
然后是我认为这一章最需要补一句的地方:QLoRA。
p0306 的图 5-9 画得很清楚:左边是 4bit 的 Transformer,下面几层是参数更新和梯度流,右上角是 CPU,箭头标着 paging flow——优化器状态和中间缓存被卸载到主存。正文说这"使得在消费级 GPU 上也能完成大模型微调任务"。
这句话对,但它没说清 QLoRA 到底省的是什么:省的是位宽和优化器状态,不是省算力。4bit 权重每次前向都要反量化回计算精度,所以 QLoRA 训练更慢。它是拿时间换显存,不是白捡便宜。这个 trade-off 书里没写明白,而面试官问"你为什么选 QLoRA 不选 LoRA"时,你要是只答"省显存",会被追一句"那代价是什么"。
另外,实战里 QLoRA 的坑几乎全在工程侧:bitsandbytes 的版本和 CUDA 对不上、4bit 权重和 flash-attention 的兼容、gradient checkpointing 开着和 paged optimizer 抢内存。这些一句没提。
六、RLHF 与 PPO:讲得对,但只停在"知道"这一层
5.3 开头的图 5-10「RLHF 的三个阶段流程图」,是 OpenAI InstructGPT 那张经典图的复刻,画得没毛病:
步骤 1,收集示范数据,训练监督策略——标注员对着一个提示写出期望输出,这些数据用来做监督微调。步骤 2,收集比较数据,训练奖励模型——同一个提示让模型生成若干候选,标注员排序,这些数据训练一个打分模型。步骤 3,用强化学习在奖励模型上优化策略——策略生成输出,奖励模型打分,PPO 用这个分数更新策略。
配的例子也很具体:"Explain the moon landing to a 6 year old",几个候选里人选出"Serious people went to the moon"那条更合适的。这个例子选得好,因为它展示了比较数据的关键:不是判断对错,是判断哪个更好——这正是 RLHF 和 SFT 的根本区别。
【例 5-5】用 TRL 搭 PPO:PPOTrainer + PPOConfig(learning_rate=1e-5, batch_size=4, mini_batch_size=2, optimize_cuda_cache=True),奖励模型直接拿一个同构模型顶上。
这里我要说句公道话:书里明说是"模拟一个简化版的 PPO 训练流程",标了"简化",所以拿同构模型当奖励模型不算欺骗。但两个数字得提醒一句:batch_size = 4 在 PPO 里几乎一定训崩,因为 PPO 要靠一个 batch 内的回报来估计优势函数,4 条样本的方差大到没有意义;而 reward model 是个未训练的模型,等于在给随机信号。这段代码能跑通、能打印出 loss,但训不出东西。
真正让我觉得这一章有价值的是 p0320 那道面试题 5:
「若某 PPO 训练结果中模型输出质量不升反降,可能有哪些原因?如何定位问题?
答案:可能原因包括奖励模型评分误导、KL 系数过小策略更新幅度过大、生成样本分布偏离训练集、优势函数估计不准确等。应通过检查 Reward 分布、KL 散度、Loss 趋势进行分析,并动态调整策略参数。」
这个回答比前面所有原理段落都更像工程师说的话——四个原因,三个观测量,一个动作。你把这段背下来,比背 PPO 的目标函数有用得多。
但这一章有一个我认为不小的缺口,也是全书最"旧"的一句话:
「PPO 算法通过对策略变化范围的剪切限制,在大模型强化学习中提供了训练稳定性保障,是 RLHF 流程中连接奖励模型与语言模型的核心桥梁……已在 ChatGPT、Claude 等大模型中实现工程级部署。」
这句话在 2023 年是对的,写在 2026 年的书上就有点旧了。现在问对齐,DPO 是必问项(它把"训奖励模型 + PPO"两步压成一步,直接用一个偏好损失在策略上优化,工程复杂度低一个量级),ORPO、KTO 这些变体也在真实项目里用。而 Claude 这条线更接近 RLAIF / Constitutional AI 那一路——用 AI 反馈代替人类排序。这本书把 PPO 说成"核心桥梁",等于把三年前的结论当成了当下的现状。
当然,也可能后面几章补了 DPO——我只读到第 5 章。但就这一节的表述方式看,它没有给 DPO 留位置。
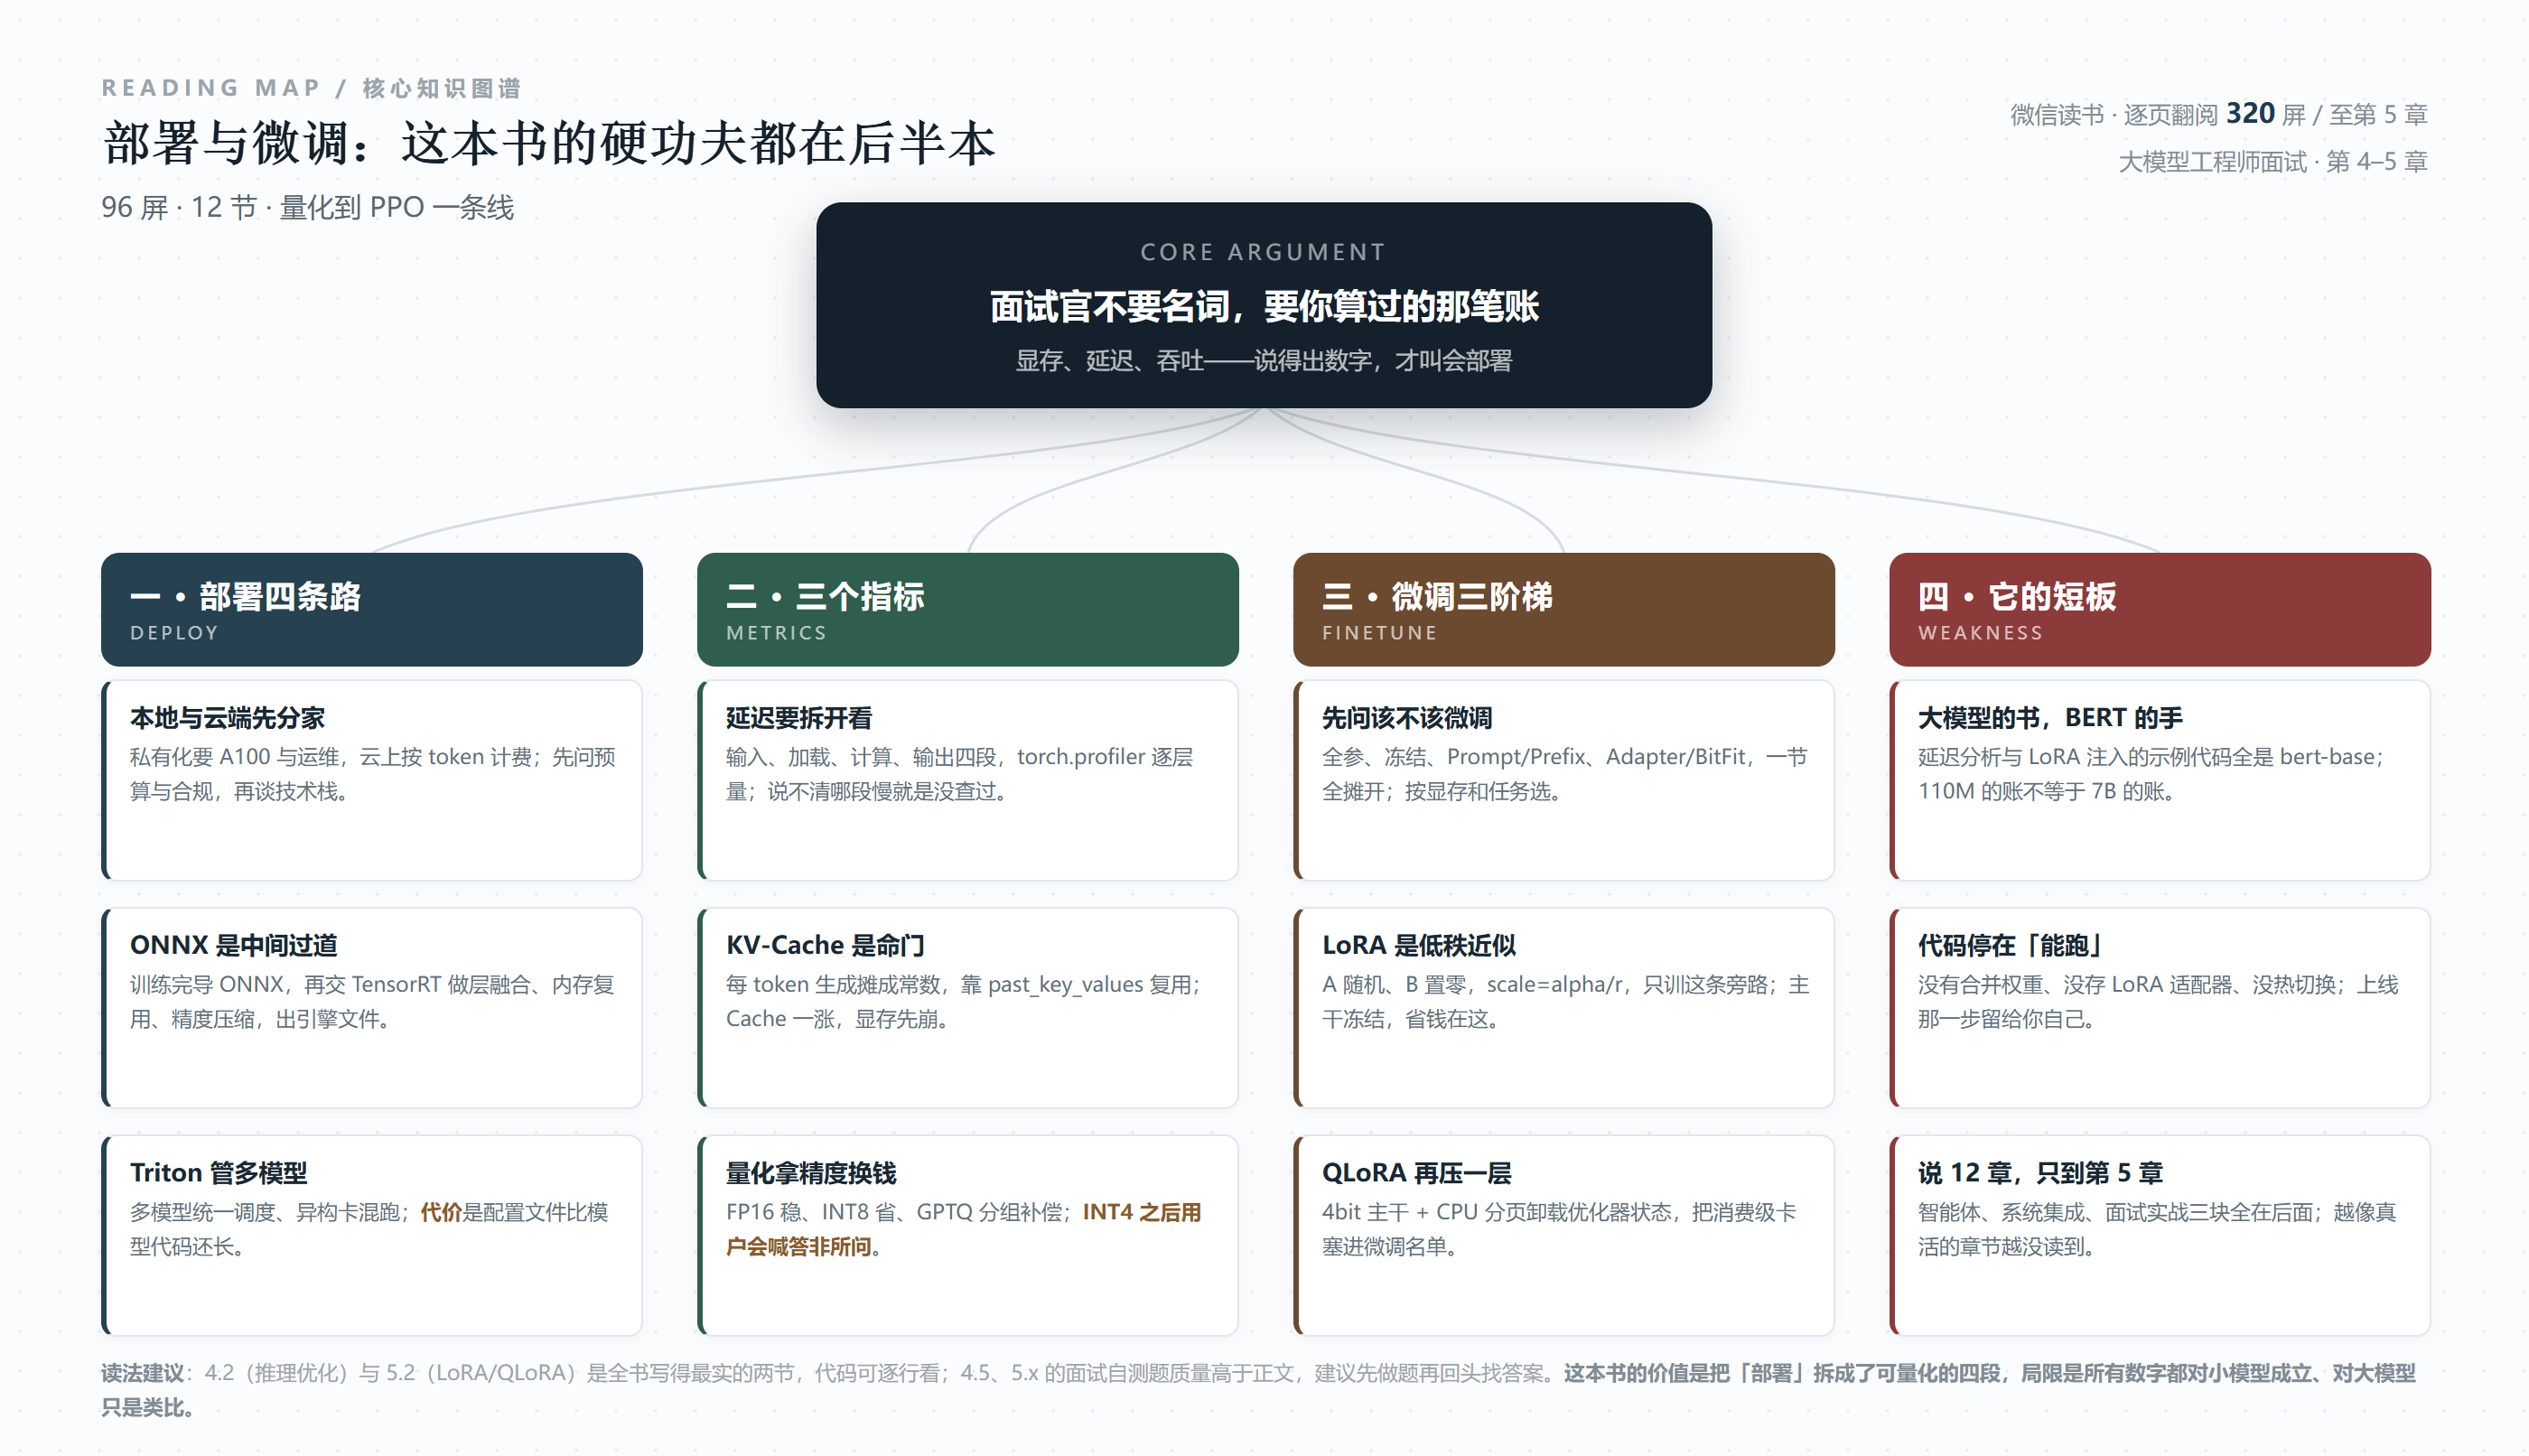
七、它的短板
我不打算客气,因为这本书值得被认真挑一次。五条:
第一,大模型的书,BERT 的手。延迟分析用 bert-base,LoRA 注入用 bert-base,蒸馏那一节更直接——老师 bert-base,学生 prajjwal1/bert-tiny,温度 2.0,损失 0.7×KD + 0.3×CE,一个 epoch。三个最该讲"大"的地方,全用 110M 的模型演示。方法能迁移,数字不能:110M 的显存账、通信账、并行策略,跟 7B 完全不是一个量级的事。读者照着抄,面试时一算数字就露怯。
第二,代码停在"能跑"。LoRA 那个例子止于"注入成功、能前向",而上线要用的三件事一件没写:合并权重(merge_and_unload,推理时把 BA 加回 W,省掉那点计算)、只存适配器(几十 MB 而不是几十 GB)、多适配器热切换(同一个基座服务多个客户)。QLoRA 那节也没提工程侧最烦的版本兼容。这本书的代码是用来"看懂原理"的,不是用来"交付"的。
第三,形容词代替数字。我翻的这 96 屏里,没有一个可复现的实测值:没有 token/s,没有显存 GB,没有加速倍数,没有 TTFT/TPOT。图表倒是有(图 4-6 那张门级资源对比就是),但那是论文里的图,不是作者测的数。一本面试书最该给出的东西,恰好是最缺的。
第四,题和答案不在一个地方。4.5 那五道自测题质量很高——企业内 BERT 系统并发涨到数千级怎么定位瓶颈、A100 上 PyTorch 模型怎么走 ONNX/TensorRT、Triton 怎么统一调度多模型、从 BERT 迁到 LLaMA 后为什么变慢、INT4 之后输出偏差为什么变大。每一道都能撑起二十分钟的面试。但正文里没有逐题对应的完整答案,只在 5.3 之后给了一段"热点面试题及答案"。题目在第 274 屏,答案在第 313 屏以后,中间隔了四十屏。作为练习册,这个编排是不合格的。
第五,也是最实的一条:我读到第 5 章就断了。前言(p0006)说"本书共 12 章,结构层层递进,内容从理论铺垫到工程实操,再到面试实战"。320 屏只到第 5 章,意味着智能体应用、系统集成、面试实战这些最像真活的章节,我一行没读到。这不是作者的锅,是这次抓取在半途停下(reached_end=False, truncated=True)。但它恰好说明了一件事:这本书的前半本是教材,后半本才是筹码,而大多数人读不到后半本。你要真拿它准备面试,从第 4 章开始读,别从第 1 章。
八、怎么用这本书
如果你两周后要面试:先做题,别先读书。翻到 4.5 和 5.x 的自测题,一道一道在纸上写答案,写不出来的再回去读对应小节。顺序反了就是白读——这本书的原理部分密度不低,但它是"查阅型"的,不是"通读型"的,从头读到尾你会记住很多名词,答不出一道题。
如果你要动手部署:4.1.2(ONNX+TensorRT)加 4.2.3(KV-Cache)这两节够你搭出一个能跑的服务。但 TensorRT 的动态 shape、算子不支持、精度对齐这三个坑它一个没提,你得回去翻 NVIDIA 的文档;KV-Cache 的显存估算它也没给,你得自己按"层数 × 2 × 头数 × 头维度 × 上下文长度 × 2 字节 × 并发数"算一遍——这个算式建议你手算一次,比读十页书有用。
如果你要微调:5.2 看完就能抄出一个 LoRA。但 target_modules 选哪几层、r 和 alpha 怎么配、什么时候该换 QLoRA,这本书给的是名词表,不是调参手册。这三件事只能靠你自己的实验记录——我的经验是先在 q_proj/v_proj 上跑 r=8、alpha=16 做基线,再往全线性层扩,每次只动一个变量。
谁不必读:想找一本"照着做就能上线"的人。这本书的每一节都停在 demo 的边界上,越过边界的那一步,它留给你自己。
但它仍然值得读,理由很简单:市面上讲"大模型原理"的书很多,讲"面试官会怎么一层层追着你问"的书很少。它把部署拆成四条路、把延迟拆成四段、把微调拆成五级阶梯,这个拆法本身就是一种训练——训练你把一个模糊的问题,切成能被追问、能被量化的小块。这项能力,比书里任何一个知识点都耐用。
一句话:它的前半本让你知道有哪些名词,后半本才教你把这些名词换成数字;而它最大的失手,是在最该给出数字的地方,全用了形容词。
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: