
让AI帮你炒股:系统是真的,业绩是空的
微信读书《让AI帮你炒股:从0到1搭建投研智能体(轻科技)》(唐奕波·王韦华·樊帅)· 本次逐页翻阅 126 屏,从版权页读到彩蛋问答,抓取标记为全书读完(书尾页)。
说明:这是一本访谈体的轻书,三位作者以对话推进,九章加一个彩蛋。本篇不复述目录,只写我真正看到证据的地方。引句页码为本次截图编号,与纸书页码无关;凡加引号的话都能在对应截图逐字核对,标"我的判断"处是评论,已与原文分开。
我自己每天在看盘,盯几只票,所以看到这个书名,第一反应是"终于有人把 AI 和 A 股拼到一块儿了",第二反应是"轻科技系列,八成是二十页 PPT 撑成的一本书"。
读完发现:第二个反应对了一半。它确实薄,126 屏,一个下午能翻完。但它薄得有东西——里面有三四个概念,是我翻完以后立刻想搬到自己机器上试的。
而它最厚的一页,恰恰不是讲怎么赚钱,是讲它自己没赚到的那个东西。
一、126 屏里,一半是对话,这也决定了它的全部优缺点
先说清楚这本书是什么形态。它不是专著,是一场三人访谈录,全书用"奕波""韦华""樊帅"三个名字轮流说话。开场白第一句就很直白——樊帅问奕波学什么专业,奕波答:"本科和硕士都是金融,没学过 C 语言,没学过 Python。"然后樊帅说:"这样我们心里压力就小很多了,也就是说奕波都能把 AI 用得这么好,那么我们大家都可以。"
这个开场设计得很好。绝大多数 AI 书死在前言:一上来就讲 token、讲注意力机制、讲 embedding,读者在第三页就跑了。这本书反过来,先花两屏把"我不是程序员"这个人设立住,再谈方法。你信了"他能做到我也能",才愿意跟着走。
但访谈体是有代价的,代价有三样。
第一,结构碎。126 屏里落了 64 个章节标记,平均两屏一节。第三、四、五、六章加起来不到 30 屏,每章被切成四五个小节,每一节刚起个头就换行。你读的时候一直在"进站出站",很难有连续推理的快感。
第二,观点靠重复加固,不靠论证推进。比如"文件夹结构是给人看的,md 文档是给人和 AI 看的"这一句,第四章说了一遍,第五章绕回来说一遍,第六章又提一次。访谈里这是自然的——聊天本来就会绕回去;印成书就成了赘肉。
第三,也是最要紧的一处:对话会把"没有验证"这件事藏起来。一个人写书,写到"这套方法让我少花了一半时间",编辑会问一句"怎么算的"。三个人聊天,一个人说"我从 2020 年就开始用了",另一个人接"那很久了",这一页就过去了。全书 126 屏,没有一个地方停下来算过账。
我不是说访谈体不好。访谈体适合装"手艺"——那种讲不清原理、但确实有效的操作细节。这本书里最值钱的部分,恰恰全是手艺。问题在于它也把该被追问的地方,一并聊过去了。
二、它真正给出来的东西:三个闭环
如果这本书只留一章,留第三章。第三章叫"理解基本原则,从零开始搭建投研智能体",开头两屏就给出全书的核心结构:
"第一,我想强调的是,一个系统,一定要形成闭环。我这里写了三个闭环。"
闭环一,假设验证:你提出一个假设——哪个行业发生什么事就可以买入——你让 AI 去扫,扫完它会有反馈(增强或反驳),你再回写这个假设。碰到改变决策的信息,要及时跟它反馈。
闭环二,知识沉淀:你投入的内容都要沉淀下来,比如它给你写的报告,都沉淀成未来可引用的知识库。
闭环三,规则晋升:经常发现一类股票涨了很多,你可以给 AI 设个自动提示,"这是第三只同类股票出现了,触发规则记录",你把它记入规则库,成为一条规则。
每一张闭环图下面还挂了具体的命令链,这三条链是全书密度最高的地方:
假设闭环是 hypothesis 设条件 → /today 每日扫 → /weekly 汇总 → certainty% 升降 → 回写假设。注意那个 certainty%——它把"我看好这家公司"这种模糊表态,压成了一个会被每天更新的数字。你昨天说七成把握,今天出了个消息,它得变成六成或者八成,不能装作没看见。
知识沉淀闭环是 外部来源 → /ingest → sources → 渗透到 entities/concepts → /research 引用 → explorations。这条链的意思是:资料不是存下来就完事,它得被拆成实体和概念,然后在你写研究的时候被真正引用到。引用不到的东西等于没存。
规则晋升闭环是 观察到模式 → 确认 3 次以上 → 晋升 rules.md;被推翻 → 移入 false-beliefs。这一条是全书最狠的。
我的判断:三个闭环里,前两个是知识管理圈子的常识,第三个才是这本书的原创。
双向链接、卡片盒、原子笔记那一套,讲"知识要沉淀、要能被引用",已经讲了二十年。假设带置信度、每天被信息修正,这套东西在量化圈也不新鲜。但"确认三次以上才能立为规则,被推翻的规则要进 false-beliefs"——这是个很少见的动作。它同时做成了两件事:一是防住"看到两只票涨了就以为找到规律"的过度归纳;二是给"我错了"留了一个正式的收纳位置。
绝大多数投研笔记是不收纳错误的。你判断错了,就把那页翻过去,下次重新想。这本书要求你把被推翻的那条写下来、移到一个专门的文件夹里。这个动作看着小,实际上是让系统具备"记忆自己的失败"的能力。我认为这是全书唯一别人抄不走的东西。
但这里必须插一句批评:"确认 3 次"这个 3,全书没有一个字的论证。为什么是三次,不是五次,不是"连续三个月且跨两个行业"?三次确认在统计上什么都不是——三只同类股票一起涨,在 A 股一周能遇到好几回,全是同一个板块轮动的产物。作者把一个凭手感定下的数字,写成了一条纪律。这跟我上一本读的 LangGraph 书里那个没人论证的 0.8 阈值是同一个毛病:用数字冒充标准,读者以为拿到了尺子,其实拿到的是别人的手感。
三、公文包式的系统:一个 md 加五个文件夹
第四章叫"先建一个 MVP(最小可运行架构)",是全书最可操作的一章。它没有讲任何框架,没有 LangChain,没有向量库,没有工作流引擎,只有一套文件夹。
作者给出的结构是:CLAUDE.md(他称之为"根入口",Claude Code 每次新建对话就会自动阅读该文档)、Inbox/(输入端,你把看到的 PDF 报告丢进去,让它转成 MD 自己读、读完写摘要)、kb/(知识库,把 inbox 里学完的资料结构化保存,构成智能体的长期记忆)、Output/(输出端,生成给你看的东西)、feedback/、long-term.md、weekly.md、templates/、scripts/。
然后是最关键的一句,在第四章末尾:
"因为这是人机协作的系统,文件夹是方便给人看的。……文件夹结构是给人看的,MD 文档是给 AI 和人看的。两个加起来构成你的系统,而且这个系统是可以迁移的。"
"这个系统就是一个 agent。一个极度简洁的结构。实际上可以完成各种各样的工作,都归结到这几层、这几个文件夹的内容调用。"
樊帅在旁边打了个比方,我觉得比作者自己的定义更准:"这就像我们是老板,下面有个研究员,我只跟他说一句'你去把 xxx 研究一下',他就好好干完给我。现在 AI 就相当于我的这个研究员了。"
我的判断:这套东西的全部价值,在"可迁移"三个字;它的全部天花板,也在"只是文件夹"三个字。
先说价值。2026 年市面上的 Agent 教程,八成是平台绑定的:某个工作流平台、某个可视化编排器、某个云厂商的智能体商店。你照着搭三个月,搭出一套很好看的东西,然后发现换模型就崩、平台涨价就崩、想搬到本机就崩。这本书的路径相反——它是文件系统 + 斜杠命令 + 一个每次都会被读的入口文件。这套资产的寿命不由任何厂商决定,你今天用 Claude Code,明天换别的模型,文件夹还在,md 还在,规则还在。
这不是技术选择,是资产观。作者反复强调"可以迁移",其实是在说:你要沉淀的是文本资产,不是工具链。我认同这个取向,而且我认为它比书里任何一句"AI First"的口号都更有分量。
再说天花板。文件系统不提供状态机。三个闭环里那个 certainty%,到底由谁维护?书里的答案是:靠 AI 自己在 md 里改。那么问题就来了——它改错了没人知道,改漏了没人知道,改得前后矛盾也没人知道。你今天看到它把某个假设的把握从七成调到六成五,你没有办法追溯它凭什么调的。
这就是纸面流程和真实系统的分界线。真正跑起来的投研系统,一定会有一天需要"可追溯":每条结论要能回答"依据是哪几份材料、哪一天进来的、谁改过"。文件夹能装这些,但它不会主动记。书里用"摩擦记录与反馈"(p56)这一节补了一小块,但只有两三屏,远远不够。
换句话说:这本书教你搭了一个能跑的东西,没教你搭一个能被审计的东西。对于个人研究者,这没问题;对于任何要对外交付研究结论的人,这是致命的。
四、"逐层展开":全书最像经验的一节
第三章里有一节叫"逐层展开原则",只有两屏,却是我在整本书里划得最多的地方。
"用 AI 的时候你一定要记住,所有任务都是'逐层展开'。不要一次性给它所有报告,或者把整个想法一股脑说给它听,要一步一步分步读取……"
"节省他的上下文空间。上下文空间可以理解成它的脑容量,超出它就处理不了。……AI 的窗口一旦到上限——原来是 20 万 tokens,现在 100 万——它会变得迟钝,开始忘记你之前给它的设定。"
"你要是一口气给它 100 个报告,它直接爆炸,没有任何智能;但你一篇一篇跟它讨论,或者批量处理、一篇一篇转换成摘要(摘要可以简单理解成索引,像图书馆的索引)……"
这段话,比市面上大部分"长上下文技术综述"都有用。因为它不是从论文里读来的,是从失败里长出来的——你一定被"给了 50 份 PDF 然后它开始胡说"坑过,坑完你不知道为什么,只知道下次少给点。这里给了因果:不是它不想记,是它的记性有物理上限,而且上限提高之后并不会变好,只会变得更迟钝。
那句"原来是 20 万,现在 100 万",作者是随口加的括号,但这句话是整本书里唯一一个有技术含量的判断。窗口从 20 万到 100 万,业界一片欢呼,真正天天用的人都知道另一面:上下文越长,注意力越稀。你在 100 万 token 里塞进去的那句"不要用市盈率判断周期股",它在第 30 万 token 的时候还记得,到第 80 万 token 就忘了。这不是 bug,这是注意力机制的算术。
同一节里还有个很具体的动作,叫"给 AI 加记忆":作者手动加了一个叫 Active Context 的东西,每当他跟 AI 说"今天先到这,明天继续",它就会把现在做的东西总结一下(大概写 50 字),存起来,第二天接上。
我的判断:这个 50 字的设计,是全书最聪明的工程决定,虽然作者没意识到它有多聪明。
因为记忆这件事,难点从来不是"存",是"取"和"压"。你存一万字的历史,第二天接不上;你存 50 字的摘要,第二天能接上,但会丢细节。作者选 50 字,是在赌"上下文接续只需要方向,不需要细节"——对投研这种"今天在追一个假设"的场景,这个赌是对的。方向对了,细节可以重新查;方向错了,细节全是噪音。
但这一节也有它的软处:这套"逐层展开"完全靠人守纪律,没有任何机制强制。书里没有一节讲"如果你违反了会怎样",也没有一节讲"怎么让系统在你偷懒的时候拦住你"。它默认读者是个自律的人。这个默认,在个人场景成立,在团队场景完全崩塌——团队里只要有一个人偷懒,把 200 页 PDF 直接丢进去,整条链的产出质量就一起掉下去。
五、英伟达那一问:全书写得最好的一页,也是它的自供状
第七章讲"进阶需要的两大思维",第一节是 AI First,中间插了一个 GitHub 的介绍,然后是"凯利公式的例子""从研究员到组合经理的例子",再往后是"AI 的局限:审美"。
但整本书最有分量的一段对话,不在这些标题下面,它夹在"AI 的局限"那几屏里,我翻到的时候停了一会儿。
奕波:我说"你帮我做一个年化收益率 50%、且最大回撤不超过 25% 的组合,假设你现在是在 2020 年"。我就想看它能不能把英伟达抓出来、一直拿着,不行。
韦华:英伟达回撤可不止 25%。
奕波:说的是整个组合的回撤。
奕波:我说"为什么英伟达拿不住?",它说"英伟达 xx 时候跌了,当时止损了",我再说"止损了后面有没有什么机制?你能不能把这个机制加上?"但它反复还是不行。
韦华:那我就放心了,咱们的工作还不会完全被 AI 替代。
奕波:我也想,如果他能干了,那咱就没用了。
这段话诚实得可爱。两个做投研的人,测出一个"AI 抓不住十倍股"的结果,第一反应是松了一口气——这种坦白,在 AI 书里几乎见不到。绝大多数作者会把这个结果包装成"AI 是助手不是替代",他们直接说"那咱就没用了",这是真话。
但我要指出一处推理错误,而且是全书最需要纠正的一处。
这个测试,测的根本不是"AI 能不能拿住股票",是"AI 在知道答案的情况下,会不会违反你给的止损纪律"。
"假设你现在是在 2020 年"——问题是,它并没有真的回到 2020 年。它知道 2020 年之后发生了什么:它知道英伟达后来涨了几十倍,也知道中间有过 60% 以上的回撤。所以你让它"年化 50%、回撤不超 25%",它面临的是一个矛盾任务:要拿到英伟达后面的涨幅,就必须穿过那几次超过 25% 的回撤;要守住 25% 的回撤,就必须在回撤时卖出,而卖出就吃不到后面的涨幅。
它说"英伟达跌了,当时止损了"——这不是它笨,这是它在严格执行你给的约束。你追问"止损了后面有没有什么机制",其实是在问"你能不能既止损又不踏空",这在逻辑上就是一个悖论:止损的定义就是放弃后续上涨的可能性。
所以这一段真正证明的是:这套系统的规则层太硬,硬到会把"我错了"和"我只是暂时难受"混为一谈。止损规则不知道什么叫"基本面没变、只是估值杀了"。而人知道——人靠的不是规则,是对这家公司生意本身的理解。
这就回到了三个闭环的那个空缺:假设闭环能沉淀置信度,规则闭环能沉淀纪律,但没有任何一个闭环负责沉淀"理解"。理解是非结构化的、是不可回写的、是不能写成 rules.md 的。作者的英伟达实验,无意中把这块空缺照得很亮,但他把结论写成了"AI 的局限",而不是"我的系统缺一层"。
这一字之差,价值差得很远。前者让你安心,后者让你继续做。
六、它的短板
这本书有真东西,但短板也很硬,而且不止一处。
短板一:全程没有一个业绩数字。
126 屏,九章,三个闭环,一套完整的方法论,没有一条回测曲线,没有一个收益率,没有一次归因分析,没有一次"这套系统让我少犯了几次错"的对照。它讲的是流程,不是业绩,而流程的价值恰恰只能由业绩来证明。
全书唯一接近"数据"的地方在第九章,作者说:"我公众号关注者里面,自己弄智能体投研系统的渗透率可能不到 5%;但 Alpha派在我认识的朋友里面,渗透率应该超过 50%。"——两个"可能"、一个"应该",这是感觉,不是统计。一本讲用 AI 做投研的书,最该被投研方法检验的,恰恰是它自己。
我知道这话有点苛刻。轻科技系列是普及读物,要求它带完整回测不现实。但至少可以给一个东西:同一份研究,用这套系统做一遍、不用它做一遍,把两份结论的差异摆出来。这个成本很低,两个人一个下午就能做,而且比任何"效率提升十倍"的说法都有说服力。书里没有做。
短板二:合规整节缺席。
我数了一遍目录:全书 64 个章节标记,没有一节谈投顾资质、荐股边界、数据来源合法性、AI 生成内容的对外责任。在 A 股语境下,这四件事不是可选项——没有牌照对外提供具体买卖建议是违法的,"我让 AI 帮我选股"和"我把 AI 选出来的股发给你"是两件法律性质完全不同的事,用未授权的行情与研报数据训练或喂给模型也是风险。
书里最接近风险提示的一句,是第九章说的"对 AI 要开放,不要说 AI 是泡沫就不看,是泡沫你也可以看一看"。那是劝人开放,不是讲风险。整本书的默认读者是"给自己做研究的个人",这个定位没问题,但它连一句"别把这套东西的输出直接当荐股发出去"都没有写。这是一个可以只用三行就补上的窟窿,作者没补。
短板三:引用习惯差。
第九章有一句:"你知道伯克希尔最近也增持了 100 亿股票谷歌吗?"——没有时间(哪个季度?),没有出处(13F 还是新闻?),没有口径(100 亿是美元还是人民币?是市值还是股数?)。在播客里这么说是闲聊,印成书就该有个脚注。
这不是个例。全书大量使用"我记得""我认识的朋友""据我了解,纯做 AI 投研这一块的应该有十几家了"这类表述。访谈体放大了这个毛病:口语本来就不带引用,而书是会被回头查的。
短板四:加法写 11 屏,减法只给 5 屏。而且那 5 屏里藏着全书最硬的一句。
第五章"从 MVP 开始做加法"从 p68 铺到 p78,十一屏,讲输入怎么拓、知识库怎么拓、输出怎么拓、反馈怎么做。第六章"给系统做减法"从 p79 到 p83,五屏。比例是 11 比 5。
而第五章第二节的标题就叫"拓展的原则:给人读的 vs 给 AI 读的",作者明明知道"给 AI 读的东西"和"给人读的东西"标准不同,却没有把这个区分贯彻到减法那一章。
减法的核心其实都在 p83 这一页,我把它抄下来:
"很简单,设置个垃圾箱。删除时丢进垃圾箱,30 天之内可以找回来。文件你都可以不用删,因为 MD 文档很小,一个 MD 文档可能才十几 KB,比起一个 PDF 就几兆,差 100 倍、上千倍。"
"那让他清理是什么意思呢?……不是删除,叫归档,按月归档、按年归档,或者直接放垃圾箱,可以随时回档。"
"那要清理的是什么?是那些项目路由文件,就是你每次让它读的。因为你肯定会给它加规则,加一条规则多一条,加一个月就 100 条。关键是,规则多了之后就减、减了之后再加,是一种动态的过程。"
"CLAUDE.md 和项目级路由 MD 文档很关键,因为它每次都要读,不修剪它就会变蠢。"
"不修剪它就会变蠢"——这一句值得单独一章。
因为它讲的是这套架构最本质的成本:入口文件是每次对话都要付的税。你每加一条规则,就是在每一次对话里多烧一点注意力。加到 100 条,它读得完,但读完之后真正"在场"的可能只有前 20 条。你以为你在教它,其实你在稀释它。
这条规律,跟前面"20 万到 100 万,窗口越大越迟钝"是同一个规律,作者在两个地方分别说了一遍,却没有把它们并成一条原则。如果并起来,这本书会多一句真正有分量的话:给 AI 的系统,扩张的成本不在存储,在注意力;所以设计的第一原则不是"加什么",是"删什么"。
这句话他没写出来。他把最硬的一页,给了三行,然后翻篇去讲闲聊和问答了。
短板五:访谈体的重复,读者要自己筛。
九章加彩蛋,真正有信息量的部分,我数下来不超过 35 屏:第三章的闭环与逐层展开(约 14 屏)、第四章的文件夹结构(约 8 屏)、第六章的减法(5 屏)、第七章英伟达那一段(2 屏)、第九章四大原则(3 屏)。剩下 90 屏是铺垫、重复、闲聊和作者的人生感慨。
考虑到它是轻科技系列、定价不高,这个信息密度算不上坑。但如果你时间紧,我可以明确告诉你哪几屏值得读——下面就说。
七、怎么读;以及一句我不太同意的话
读法建议,四段就够:
第一段,p45 到 p59,第三章"三个闭环"整章。这是全书唯一抄不走的东西,尤其 p47 的"规则晋升"图,把"确认三次才准升级、被推翻进 false-beliefs"这套纪律画得很清楚。看完这一段,你已经拿到了这本书 70% 的价值。
第二段,p60 到 p67,第四章"先建一个 MVP"。照着建一遍,一个下午能建完。建的时候注意 p64 那张文件夹结构图:CLAUDE.md 在根上,Inbox、kb、Output、feedback 四个夹子平铺,long-term.md 和 weekly.md 单独立着。这个布局不重要,重要的是"根上永远只有一个入口文件"这个约束。
第三段,p79 到 p83,第六章"给系统做减法"。五屏,但比前面五十屏都难做到。看的时候盯住"CLAUDE.md 不修剪它就会变蠢"这一句,然后回头看你自己那个已经长出 80 条规则的入口文件。
第四段,p90 到 p93,英伟达那一问。这一段要反复读,而且要读得比作者更狠一点——不要接受"AI 的局限"这个结论,去想"我的系统缺哪一层"。
其余部分:第五章的加法可以略读,第七章的 GitHub 介绍和凯利公式例子是给非技术读者的补课,第八章讲"研究员和 AI 的关系",观点温和、没有硬货,第九章前半是焦虑疏导,后半"开放与价值投资"值得看一眼,彩蛋是纯闲聊(Mac 和 Windows 有什么区别、每天消耗多少 token、用中转站还是直接账户)——彩蛋里那几个 token 账,其实比正文某些章节更有用。
最后说一句我不同意的话。
第九章"总结:四大原则",第三条是 AI First,书里对它的解释是:"想到就去干,先问 AI 能不能做,不要再用'我不懂、我不会'当借口。"紧接着正文里还有一句更狠的:"不要再说'我不懂、我不会、我不知道',你不懂、不知道的,AI 都知道,你问它就行了。"
这句话和同一本书 p33 那张卡片是打架的。那张卡片上写着:"AI 改模型假设秒出估值,人判断哪些假设合理。"
一边说"你不懂的 AI 都懂,问它就行",一边说"哪些假设合理要人来判断"。这两句放在一本书里,读者会记住哪一句?一定是前一句,因为它更爽、更像口号、更适合截图转发。
我的判断:这本书真正的价值,全部在后一句里;而它传播力最强的部分,全在前一句里。这是一个挺可惜的错位。如果把 AI First 改成"先问 AI 能不能做,再问自己能不能判",这本书会诚实得多,也会难卖得多。
至于那个书名——"让 AI 帮你炒股",我读完的感受是:它其实不叫这个。它叫《让 AI 帮你把研究做成文件夹》。这个书名不吸引人,但它准确:这本书教的不是怎么选股,是怎么把手艺沉淀成资产。
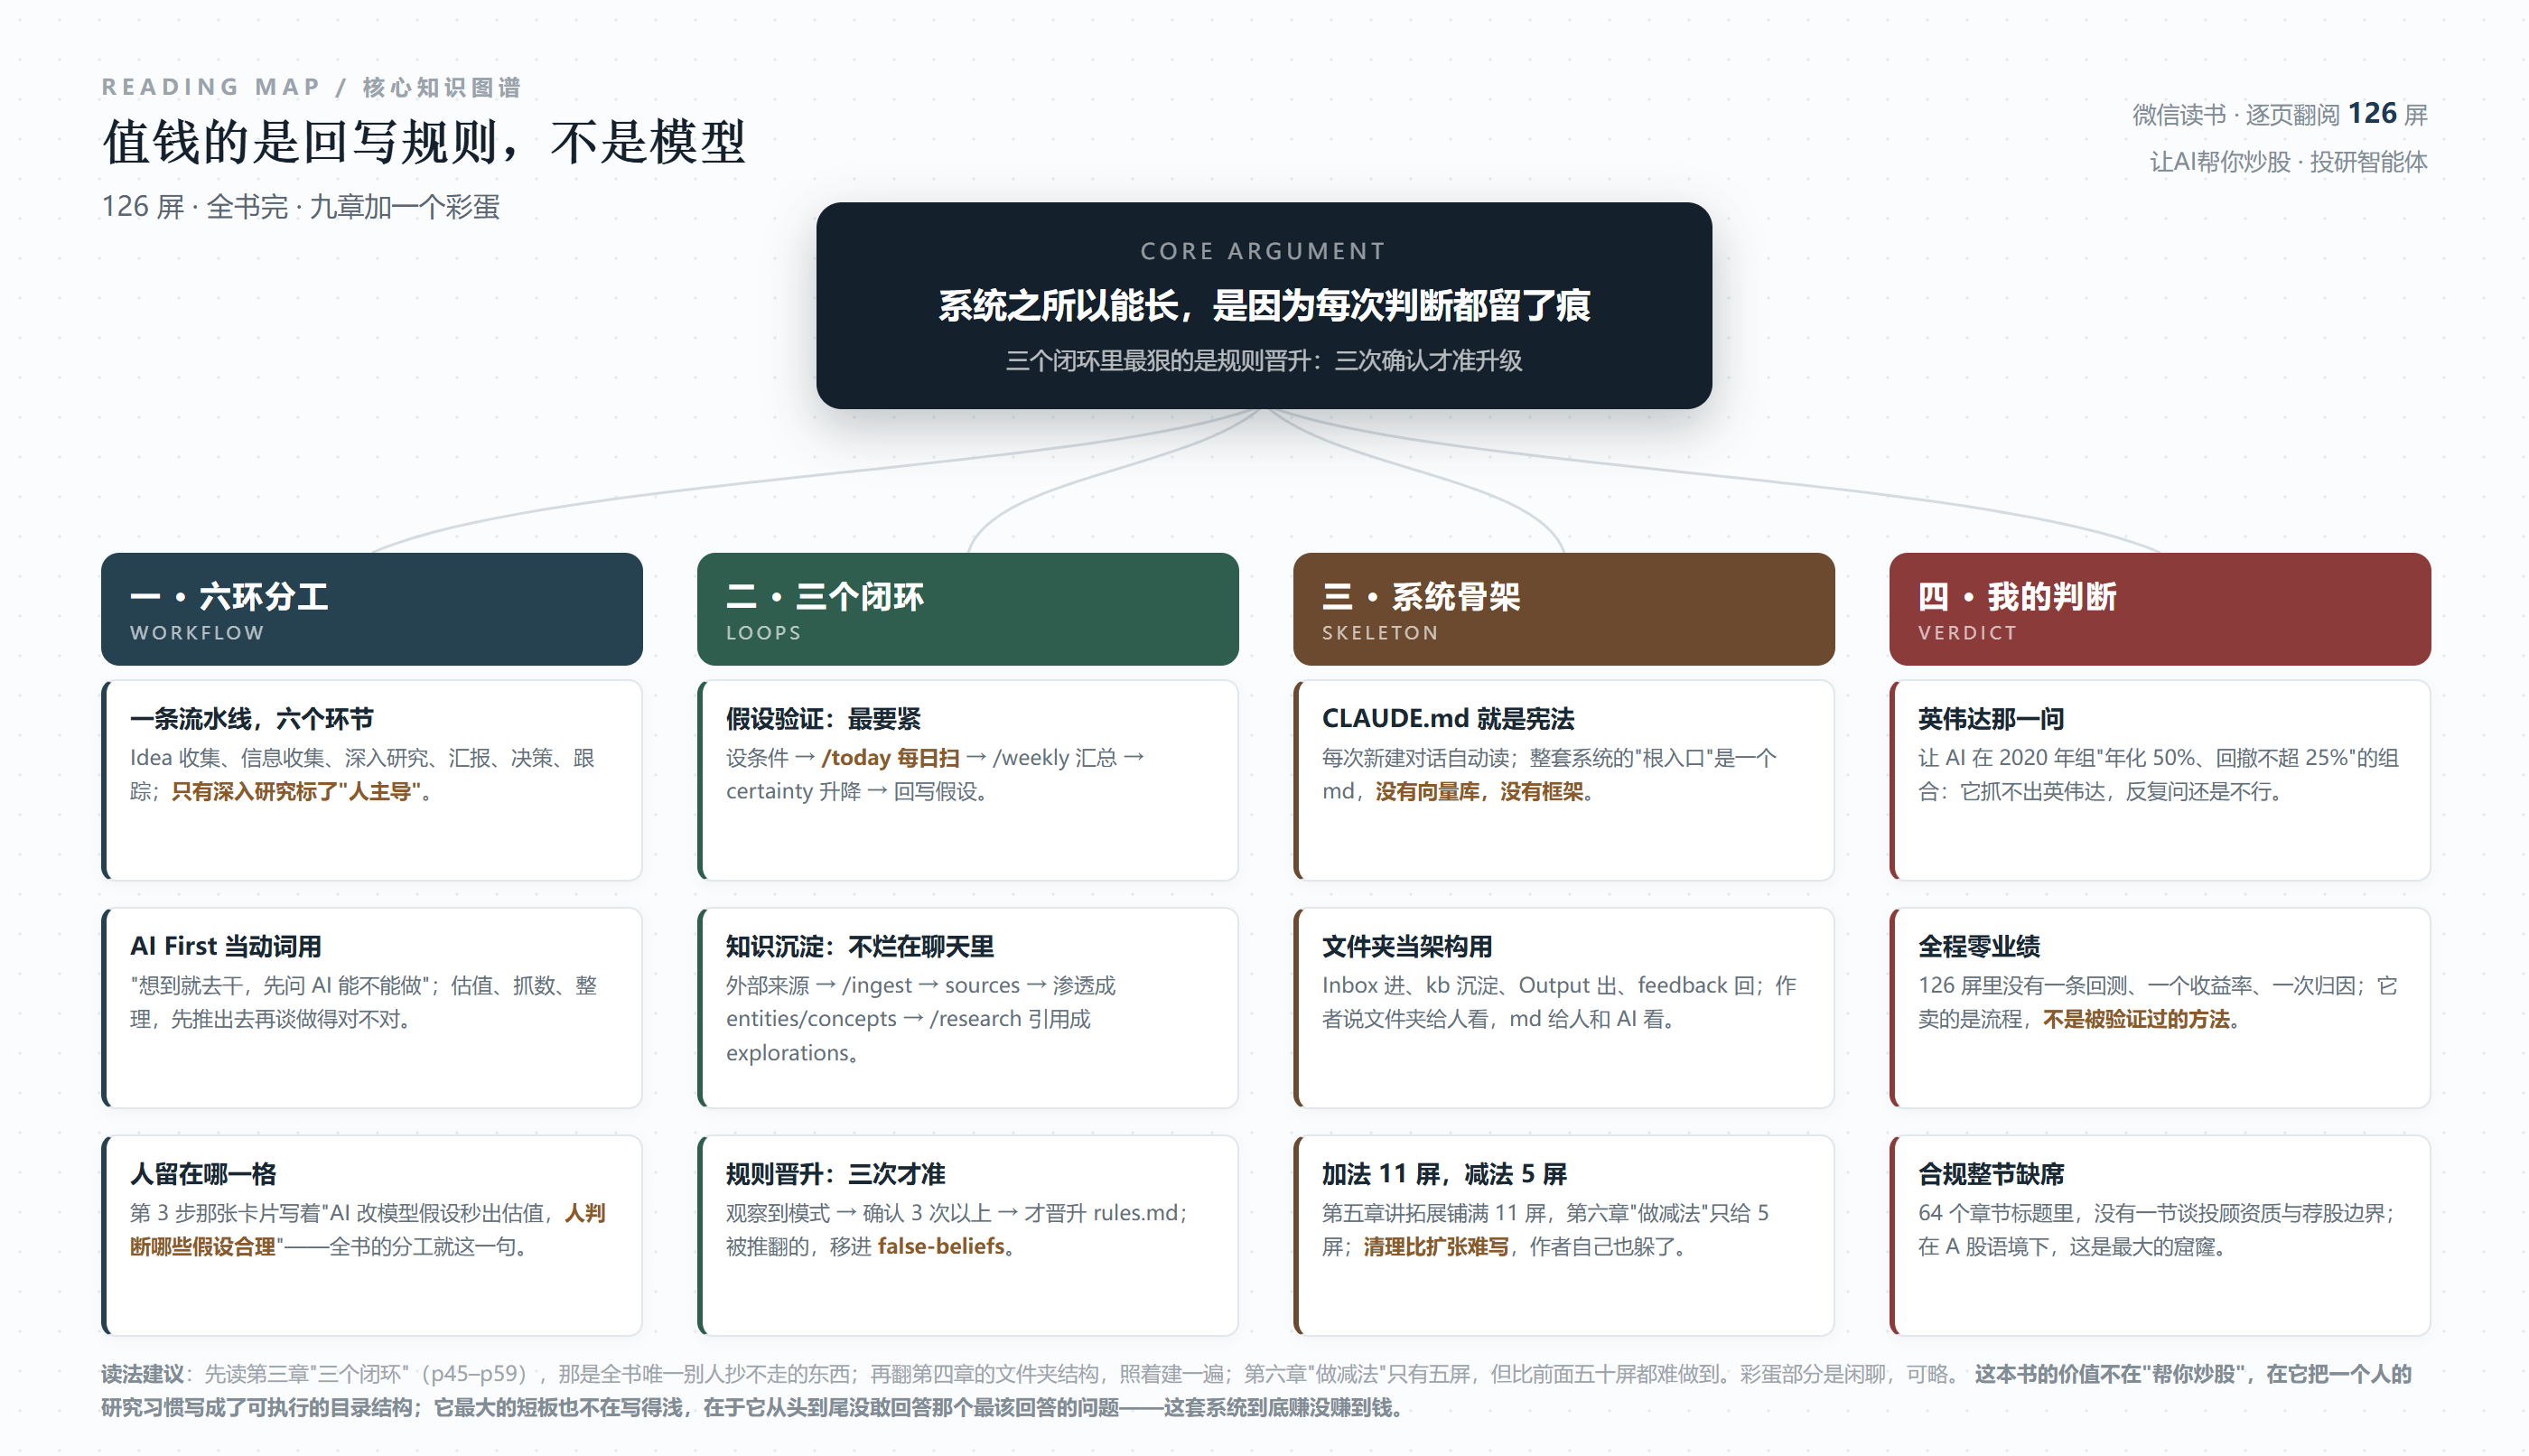
最后收一句:这本书薄,但它薄对了地方——它没有教你预测市场,它教你把每一次预测都留下痕迹;预测会错,痕迹不会白留。
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: