
大模型导论:书写得很规范,所以它最先过期
微信读书《大模型导论》(张成文)· 本次逐页翻阅 555 屏,从版权页读到第 12 章习题,204 个章节标记全部覆盖,抓取标记为全书读完(书尾页),耗时 505 秒。
说明:这是一本按课程体例写的教材,十二章,每章以"小结 + 课后习题"收尾。本篇不复述目录,只写我逐页读下来真正有判断的地方。引句页码为本次截图编号,与纸书页码无关;凡加引号的话都能在对应截图逐字核对,标"我的判断"处是评论。
这本书我是带着一个很具体的问题翻开的:一个完全不懂大模型的人,靠这一本能不能真的走完从数据到上线的全程?
翻完的答案是:能走完一半,而且是"能操作、不能判断"的那一半。
它编得很规范。规范到我一边读一边能想象出它的课堂:老师按章节讲,学生按习题练,期末考注意力机制的公式和 LoRA 的秩。也正因为太规范,它身上带着所有教材的通病——它假定世界是稳定的,而这个领域恰恰每周都在变。
一、先看骨架:它按工程生命周期排,这个决定没有错
十二章的顺序是这样的:大模型概述、数据预处理、Transformer、预训练、训练优化、模型微调、模型推理、PyTorch 框架、向量数据库、前端可视化工具、LangChain、常用开源模型的部署与微调。
这个顺序值得单独夸一句。绝大多数"大模型入门"书是按热点排的:先讲 ChatGPT 怎么火,再讲提示词,再讲应用案例,最后补一节原理。这本书反过来,它按一个模型从生到死的顺序排:先有数据,再有结构,再训练,再优化,再微调,再推理,最后才是怎么把它接进应用。这不是文笔问题,是世界观问题——按热点排的书,读者学到的是一堆并列的现象;按生命周期排的书,读者学到的是一条因果链。
而且它每一章都收成同一套动作:正文、小结、课后习题。204 个章节标记铺在 555 屏上,平均不到三屏一个小节,节奏整齐得像课程大纲。你要说它"不像一本书",这是实话;你要说它"不好用",这不成立——它作为教学材料,比我读过的多数 AI 书都好用。
但紧接着就是第一个不舒服的地方:推荐语占了八屏,前言只有四屏。
从 p3 到 p10 是连续八屏推荐语,署名包括潘毅(美国医学与生物工程院院士)、唐杰(清华计算机系)等八位。措辞高度一致:
"这本书在理论与实践结合方面做得非常好,使得读者的学习过程既不枯燥,又具有深度。"
"本书阐述了从理论到实践的全流程,是一份极具参考价值的资料。无论你是对大模型技术一无所知的新手,还是已经在该领域有一定研究的专家,这本书都能为你带来丰富的知识和深刻的见解。"
八屏推荐语,四屏前言,这个比例本身就是一种表态:这本书更相信背书,不太相信自己开口说话。
我把 555 屏翻完,确实没有找到作者本人明确的观点。他讲注意力机制,讲得清楚;他讲 LoRA,讲得准确;但你问他"你认为这条路会走向哪",全书没有答案。作为"导论"这是可以理解的——导论的任务是铺路,不是指路。但代价是:读者读完会知道很多事,但不知道作者怎么想。而一本书如果作者不表态,它就很难比官方文档更有价值,因为文档更新得更快。
二、篇幅表:六成在教怎么装库,预训练只给 19 屏
我把十二章各占多少屏,一屏一屏数出来了(按章节起始页相减):
第 1 章概述 50 屏;第 2 章数据预处理 89 屏;第 3 章 Transformer 48 屏;第 4 章预训练 19 屏;第 5 章训练优化 34 屏;第 6 章微调 35 屏;第 7 章推理 26 屏;第 8 章 PyTorch 47 屏;第 9 章向量数据库 26 屏;第 10 章前端可视化 32 屏;第 11 章 LangChain 65 屏;第 12 章开源模型部署与微调 70 屏。
把"工具与代码"那六章加起来——数据预处理、PyTorch、向量库、前端、LangChain、部署微调——一共 329 屏,占全书 59.3%。把"理论与方法"那六章加起来——概述、Transformer、预训练、训练优化、微调、推理——一共 212 屏。
六成讲工具,四成讲原理。这个比例本身不算错,市面上很多"实战"书是九成讲工具。真正让我停住的是另一组对比:
数据预处理 89 屏,预训练 19 屏。
89 屏是什么概念?它从 pandas 的 Series 讲起,讲怎么建索引、怎么按位置取值、怎么用 ndarray 初始化、怎么就地修改;讲图像去噪、重采样、增强;讲图文对;讲 HuggingFace 的 Datasets 库怎么加载怎么切分。这些内容没有一句是错的,但它们跟"大模型"的关系,跟"学会用 Excel"和"做财务分析"的关系差不多——是前置技能,不是核心知识。
而预训练 19 屏讲完了什么?p205 开头是这样的:
"在进行模型训练时,开发者常常面临标注数据稀缺的挑战。当某项任务只有极少量的标注数据时,模型往往难以从有限的标注样本中学习有用的知识。
预训练通过整合大量从低成本渠道获取的训练数据,并将这些数据传递给模型,由模型对这些数据的共性知识进行学习,从而形成一种通用的理解能力。……
· 通过有效利用海量的无标注语料,模型能够学习通用的语言表示,进而提升在下游任务中的表现。
· 预训练为模型提供了一个更好的起点,使得在处理下游任务时能够更快地收敛并获得更好的效果。"
这段话说得对,但它说的是"预训练是什么",不是"预训练怎么做"。后面的 4.2 讲预训练任务、4.3 讲迁移学习和微调、4.4 讲评判基准,整章结束。
我的判断:这 19 屏里,缺的恰恰是这五年最重要的一批知识。
缺数据配比——为什么中文语料要多给、代码语料为什么能提升推理、重复数据会怎么毁掉模型;缺 token 预算——一个 70B 模型到底要喂多少 token 才"喂饱",Chinchilla 那条最优点在哪;缺清洗管道——去重、去毒、质量打分、语言识别这一整套工业流程;缺 scaling law——参数量、数据量、算力三者的幂律关系,以及它为什么能用来预测下一个模型的 loss;缺 loss 曲线怎么读——什么形状叫发散、什么形状叫过拟合、什么形状叫"数据不够了"。
这些不是"进阶内容",这些是预训练这个动作的全部内容。一本叫《大模型导论》的书,把这一章压到 19 屏,等于把地基压成了目录。
我猜作者的选择有他的道理:预训练需要千卡集群,教材的读者大多是学生,一辈子也跑不了一次预训练,所以讲了也用不上。这个逻辑成立,但它推出的是"少讲",不是"只讲概念"。你跑不了预训练,但你一定需要判断别人预训练得怎么样——而判断的依据,就是上面那五样东西。
三、它真讲清楚的地方:注意力、LoRA、还有那本显存账
说完短板,得说它硬的地方,否则不公道。这本书有三处是真硬。
第一处,第 3 章 Transformer,48 屏,链条完整。
从 3.1 自注意力开始,多头、位置编码、整体结构,然后主动分叉:3.2.3 讲稀疏 Transformer(长文本的成本问题),3.3 讲 Visual Transformer 并与原版对比,3.4 讲 Q-Former(多模态的桥梁)。这个分叉选择得很有眼光——它没有停在 2017 年那篇论文上,而是把"注意力这套东西后来被用到了哪里"讲了两步。
p22 讲生成原理那一页,是我认为全书最会讲的一页:
"大模型的核心生成原理是将输入的语句以词向量的表征形式传递给神经网络,通过编码器/解码器、位置编码和自注意力机制建立单词(或字)之间的联系。从宏观的视角来看,输入的每个单词(或字)首先会与已经编码在模型中的单词(或字)进行相关性计算,然后把这种相关性以编码的形式叠加在每个单词(或字)中。如图 1-2 所示,经过计算后,'it' 与输入句子中的其他单词的相关性权重将会增加,颜色越深代表相关性越高。"
配的那张图,左边是 "The animal didn't cross the street because it" 逐词排列,右边是 "it" 连向 animal 和 street 的两条权重线——animal 那条明显更粗。
这个例子选得对。自注意力最反直觉的地方,就是"同一个词在不同句子里含义不同,而含义由它和谁相关决定",这一张图把这件事说完了,不用任何公式。很多书写到这儿会立刻上 QKV 矩阵,读者从第一段就掉队;这本书选择先给图,再给公式,顺序是对的。
第二处,第 6 章的 LoRA 与 QLoRA,公式给了、量级给了、代价给了。
p270 这一屏,是我在全书划得最多的地方:
"对于拥有 1750 亿个参数的 GPT-3 模型来说,全量微调的成本非常高,但在使用 LoRA 微调的情况下,只需对低秩矩阵进行微调。……W₁ = W₀ + ΔW = W₀ + BA"
"在秩 r 的选取上,一般选取 1、2、4、8。针对领域跨度较大的任务,可以适当增大秩 r 的数值。"
(QLoRA)"由华盛顿大学的研究者 Dettmers 等人在论文《QLoRA: Efficient Fine-tuning of Quantized LLMs》中提出。作为一种高效微调手段,QLoRA 能够将微调大模型时的显存占用降到极低水平,即使使用 48GB 显存的单台 GPU 设备,也能训练参数量高达 650 亿的庞大模型。"
三句话,把 LoRA 的经济学讲完了:为什么便宜(只训低秩矩阵)、便宜到什么程度(48G 单卡训 650 亿)、代价在哪(秩选小了学不动跨领域的东西)。这种"给公式、给量级、给代价"的写法,比一堆比喻有用得多。
第三处,第 7 章的显存账,全书写得最实的一屏。
p310 讲 PagedAttention 和 vLLM,中间那张图 7-8 直接给了一张 A100 40G 的显存分布:参数量 26GB,占 65%;KV Cache 超过 30%;剩下是其他数据。右边配两张曲线,一张是"现有系统 vs vLLM"的显存随批次增长(现有系统在批次 8 左右就顶到 40G 天花板,vLLM 线性缓升),一张是吞吐量随批次增长。
正文那句解释很短,但极准:
"原论文作者发现,除了模型权重参数(约占 60%)及部分其他数据之外,与注意力机制相关的 KV Cache 占据约 30% 的内存。"
我的判断:这一屏的价值,超过前面八十屏的数据预处理。因为它教的是一件可以立刻用来做判断的事:你部署一个模型,显存不够,第一反应是"换小模型",但按这张图,你有 30% 的空间是被 KV Cache 吃掉的,而 KV Cache 的大小取决于你的 batch 和上下文长度,不取决于模型——所以先降 batch、先砍上下文,比换模型便宜得多。这是一个决策,不是一条知识。
这类"能直接改决策"的段落,全书我只数出三处。其余五百多屏,讲的是"是什么"和"怎么调 API"。
四、它绕过去的地方:没有对齐,没有数据工程,没有 evaluation
第 6 章"模型微调"的目录是这样的:6.1 监督微调、6.2 PEFT 技术(Adapter、Prefix、Prompt、P-tuning v1、P-tuning v2、LoRA、QLoRA)、6.3 PEFT 库、6.4 小结、6.5 课后习题。
三十五屏,讲完了微调。
这里面没有 RLHF,没有 DPO,没有拒绝采样,没有 reward model,没有"对齐税",没有"安全微调会让模型变笨"这个已经被反复验证的现象。一个字都没有。
这个缺席在 2023 年就已经说不过去了。ChatGPT 之所以是 ChatGPT,不是因为它会做 SFT,是因为它做了 RLHF;一个模型"知道很多但满嘴胡话"和"知道很多且说话得体"之间的那道坎,就是对齐。而这本书把微调定义成"让模型学会某个任务",完全没有触碰"让模型学会怎么说话"这件事。
我可以理解教材的顾虑:RLHF 需要人类标注偏好、需要 PPO 那一套强化学习基础设施,学生做不了。但前面那个反驳同样成立——你做不了,但你天天在用它的结果,你必须知道它存在。至少要知道:你微调完的模型之所以变得又犟又啰嗦,很可能是 SFT 把它原来的对齐破坏了,这在业界叫 alignment tax,是一个真实存在的工程问题,而不是玄学。
同样缺席的还有数据工程。第 2 章 89 屏讲的是"怎么用 pandas 和 torchvision 处理数据",不是"怎么造一份能训模型的数据"。这两件事差得很远:前者是格式转换,后者是去重、去毒、质量分类、语言配比、合成数据、难例挖掘。第 2 章里连"去重"这个词我都没找到(我翻的是 p65 到 p153 这一整章的关键页,标题层面确实只有文本/图像/图文对/Datasets 四个小节)。
第三样缺席的是 evaluation。全书讲了不少"评判基准"(4.4 节、以及各章的测试),但没有一节讲怎么给自己的模型做评测集:怎么防污染、怎么设计难例、怎么处理"模型在 benchmark 上 90 分但一上生产就胡说"。这在 2026 年是比微调更值钱的技能,书里没有位置给它。
五、代码里的时间戳:这批代码写于 2023 年底
教材有个躲不掉的命运:它会被自己引用的库淘汰。这本书里,这个命运留下的痕迹非常清楚。
痕迹一,LangChain 那章的 Agents 示例。
p442 给的代码是这样的:
from langchain.agents import tool
@tool
def time(text: str) -> str:
"""Returns todays date, use this for any questions related to knowing todays date..."""
return str(date.today())
后面的输出是典型的 ReAct 文本解析:"Thought: I should use the calculator tool to subtract 3 from 5. Action: ```json {"action": "Calculator", "action_input": "5 - 3"}```",外面套一个 AgentExecutor。
这套写法在 2023 年是标准答案,在今天是历史。原因很简单:那时候模型不会原生的 tool calling,所以要在提示词里约定"你输出 Action: xxx 这种格式",再用正则去解析。现在模型自己就能返回结构化的工具调用,AgentExecutor 那一层解析逻辑成了纯粹的负担——它会因为模型少写一个反引号就整个崩掉。
我上一本读的是《LangGraph开发AI Agent实践》,那本书讲的就是这套东西的替代方案:把 Agent 画成一张图,节点是函数,边是条件,状态在节点之间显式传递。两本书对着看,正好能看到一代技术栈的更替——而更替的间隔,不到两年。
痕迹二,向量数据库那一章的 Milvus 用法。
p370 讲"Milvus 1.0 的基本操作",代码是 milvus.create_table(table_param),参数字典里塞 table_name、dimension、index_file_size、metric_type,还给了一张"表 mytable 的参数及其说明"的表格。
这是 Milvus 1.x 的 API。Milvus 2.0 之后是 Collection + Schema + Index 三件套,create_table 这个函数早就不在了。书里也很老实——它在 p373 另起一节讲"Milvus 2.0 的基本操作"。所以严格说作者没有骗人,他只是把两个版本并列摆着,让读者自己去分辨哪个该用。
但这就是教材的困境:它必须把"曾经正确"的东西也写进去,否则章节结构就断了;而写进去的每一个"曾经正确",都在消耗读者的注意力,也在缩短这本书的保质期。
痕迹三,第 12 章的三套手把手。
ChatGLM3、Baichuan2、LLaMA2,七十屏,从环境准备、载入模型、数据准备、定义模型、训练、保存、评估,一步一步走。写得确实细,细到可以照着敲。
问题是:这三个名字,在我今天打开任何一个模型广场的时候,都已经不在第一页了——它们各自都有了好几代后继,而书里讲的是最初的那一代。七十屏,占全书 12.6%,讲的是三个正在退场的模型。
我的判断:这一章不该以"模型"为单位写,该以"流程"为单位写。
因为流程是稳定的:准备环境 → 载入权重 → 构造数据集 → 套 LoRA → 训 → 存 → 评。模型是变量,流程是不变量。以模型为单位写,读者学到的是"ChatGLM3 怎么训";以流程为单位写,读者学到的是"任何一个开源模型怎么训"。前者两年过期,后者能用五年。
这本书在第 12 章选了前者,在第 5 章(训练优化)选了后者——第 5 章讲数据并行、模型并行、流水线并行、混合精度,讲 DeepSpeed、Megatron-LM、BMTrain,这一章到今天还基本没过期。同一本书里,两种写法并存,效果差得很明显。
把这三处痕迹叠起来看,会得到一个有点残酷的结论:这本书里最耐放的部分,是它讲结构和讲原理的那 212 屏;最容易碎的部分,是它讲工具的那 329 屏——而后者恰好也是写起来最省力的部分。
这不是张成文一个人的问题。所有 AI 教材都在同一个赌局里:写工具,两年后过期;写原理,两年后仍然成立但没人爱看;写判断,能活十年但要有真东西可说。绝大多数教材选第一条路,因为它是唯一一条"写完就能出版"的路。
六、它的短板
把上面的问题收一收,这本书的短板是四条。
短板一:篇幅与重要性倒挂,而且倒挂得很厉害。
数据预处理 89 屏,预训练 19 屏;前端可视化 32 屏,推理优化 26 屏。Gradio 和 Streamlit 各占十几屏,讲怎么摆按钮、怎么设布局、怎么存状态——这些内容官方文档一页就说完了,而且永远是最新版。教材把最容易被文档替代的部分写得最细,把最不能被替代的部分写得最薄。
这不是作者偷懒,这是教材的结构性困境:容易写的部分好写、好教、好评测,难写的部分(预训练、对齐、evaluation)要求作者有工业界的实战数据,而学术界作者往往没有。于是篇幅自然向"可教的东西"倾斜。
短板二:没有对齐,也没有作者自己的判断。
对齐的缺席,前面说过了。作者判断的缺席,更隐蔽也更致命:555 屏里,我没有找到一句"我认为"。它会告诉你 LoRA 秩一般取 1、2、4、8,但不会告诉你"我在实际项目里从来不用 1,因为 1 学不动中文的领域词";它会告诉你 QLoRA 能在 48G 单卡训 650 亿,但不会告诉你"训得动和训得好是两件事,4 位量化在长上下文任务上会掉点"。
这类"我踩过的坑",正是一本书相对文档的唯一优势。这本书主动放弃了这个优势,选择做一个准确的转述者。准确值得尊重,但准确是文档的职责,不是书的职责。
短板三:代码与库版本锁死在 2023 年底,且没有"版本提示"机制。
Milvus 1.0 与 2.0 并列、AgentExecutor 的 ReAct 解析、三套已停更的开源模型,这些都不是错误,是时间。但书里没有任何一处标注"以下写法仅适用于某版本"。读者按 p442 敲完代码跑不通,第一反应会是"我环境有问题",而不是"这书写于两年前"。
一个低成本的补救:给每段代码加一行版本注脚("LangChain 0.0.x"、"Milvus 1.1"、"transformers 4.3x")。这一行字几乎不增加成本,却能救掉读者几个小时的排查。书里没有做。这跟上一本《让AI帮你炒股》里"伯克希尔增持 100 亿"没给来源,是同一种粗糙——不是知识错,是交付不完整。
短板四:八屏推荐语,四屏前言,读者拿不到"这本书适合谁"的实话。
推荐语的措辞高度一致("理论实践结合""由浅入深""适合新手也适合专家"),八个人说的其实是同一句话。而真正该在前言里说清楚的三件事——这本书不覆盖什么、读到什么程度可以停、哪些章节可以跳——前言四屏里都没有。
我替它补上:它不覆盖对齐、不覆盖数据工程、不覆盖评测方法、不覆盖分布式训练的调度细节;读到第 7 章(推理)结束,你已经拿到了全书 70% 的价值;第 2、8、10 章可以整章跳过,除非你确实不会 pandas、不会 PyTorch、没写过前端。
七、谁该读;以及一句我给这本书的定位
该读的人:在校学生,需要一条被验证过的学习路径,需要课后习题逼自己动手,需要每章小结当复习提纲——这本书在这三件事上是合格的,甚至优秀。
不该读的人:已经在做工程的开发者。你需要的不是"顺序",是"最新"和"坑"。官方文档、模型卡、论文、别人的踩坑博客,这四样加起来比这本书有用,而且免费、实时。
怎么读(如果你决定读):
第一段,第 1 章 p19 到 p37,尤其 p22 那张 "it" 的注意力权重图和 p34 的关键术语表。术语表值得抄一遍,它是后面所有章节的公共语言。
第二段,第 3 章整章(p154–p201)。这是全书链条最完整的一章,从自注意力一路走到 ViT 和 Q-Former,48 屏读完,你对"大模型为什么长这样"会有一个结构性的理解。
第三段,第 6 章的 6.2.6 与 6.2.7 两节(p269–p272),LoRA 和 QLoRA。公式、秩的选法、48G 单卡训 650 亿,都在这里。这是全书技术密度最高的一段,四屏顶四十屏。
第四段,第 7 章整章(p290–p315),尤其 p310 的图 7-8。二十六屏,讲清"部署一个模型,显存到底被谁吃了"。这一段对任何要上线的人都直接有用。
第五段,第 12 章可以只读第一节的方法论部分,然后照着自己的模型改。三个模型的手把手不必挨个跑,跑一个就够,剩下两个是重复劳动。
最后给一个定位。
这本书最好的用法,不是"读",是"当目录用"。它把大模型这条链上的十二个环节排好了序,每个环节给了足够的入口和术语,你顺着它走一遍,就知道自己缺哪一块、下一步该去查什么。作为地图,它够用;作为疆域,它太薄。
而地图的价值,恰恰在于它不假装自己是疆域。这本书的遗憾是:它的八屏推荐语,让它看起来像疆域。
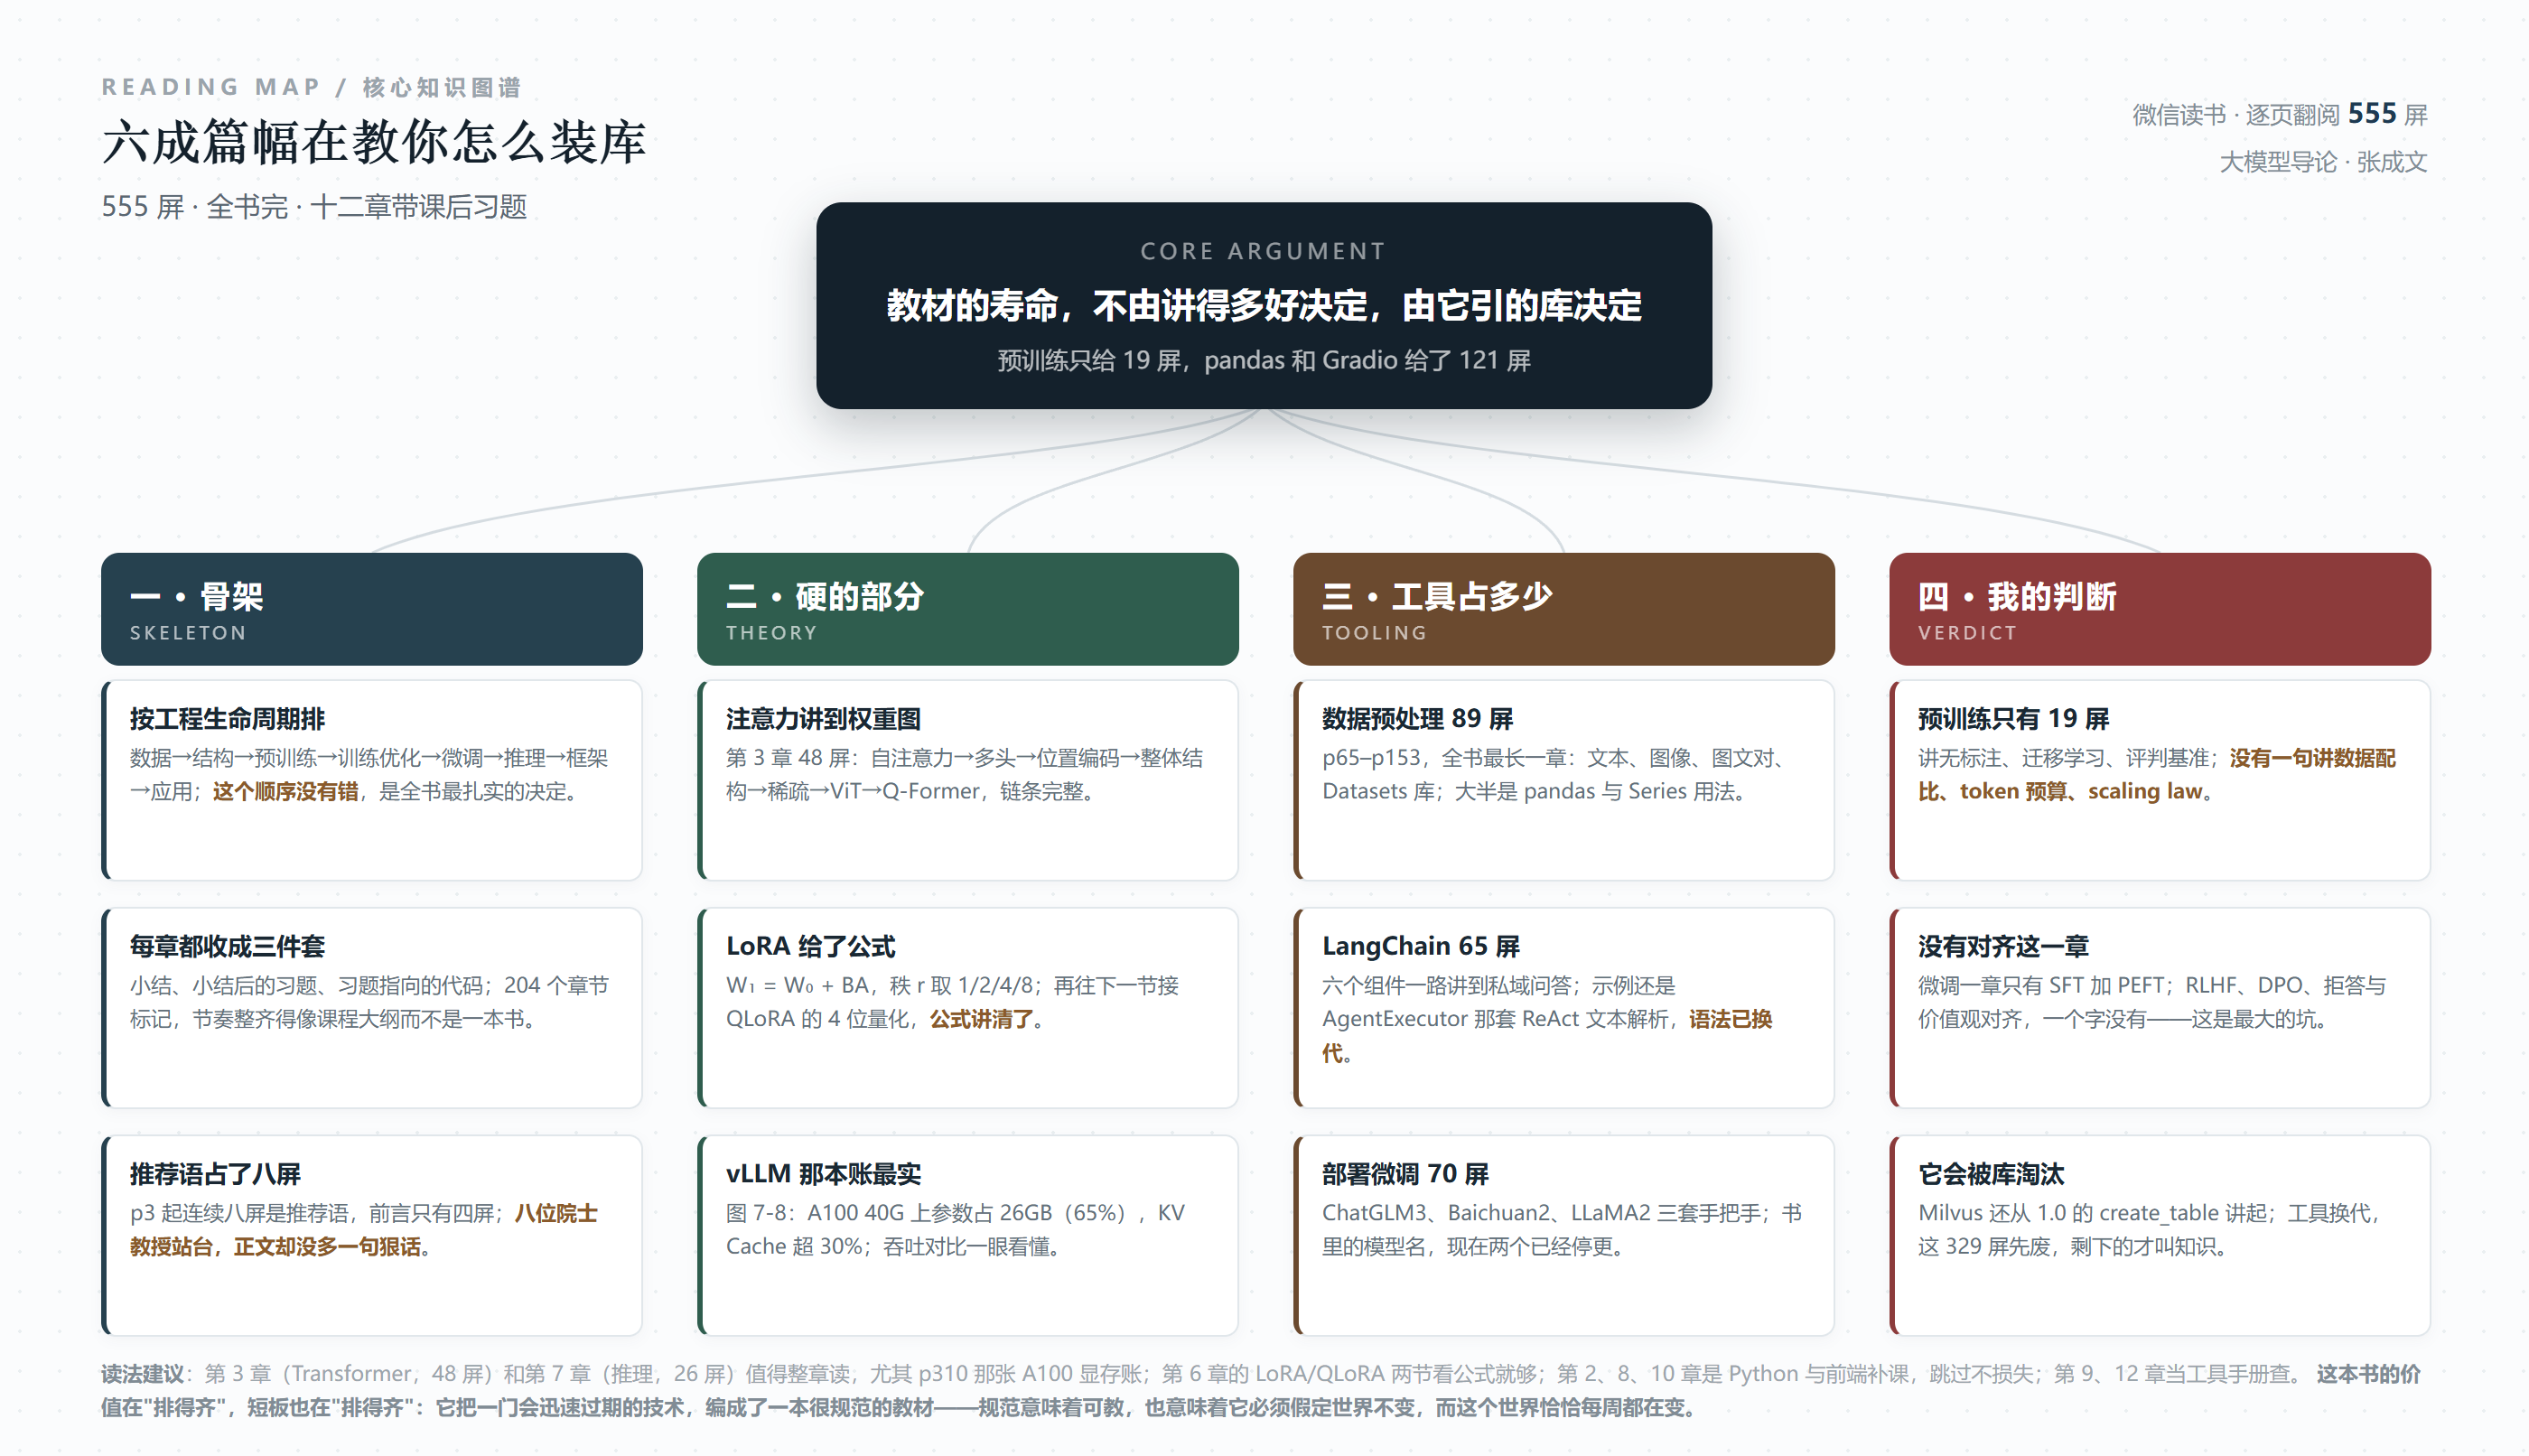
收一句:一本教材写得越规范,它教给你的越是"两年前的世界";真正没过期的部分,往往藏在它自己不重视的那十九屏里。
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: