
AI Agents in Practice:五个 Need 问对了,一个也没答到底
微信读书《AI Agents in Practice》(Valentina Alto,Packt 出版)· 本次逐页翻阅 554 屏,从版权页读到第七章《Multi-Agent Applications》中途,第 8 章起页面渲染卡死、未能继续,抓取标记为 end=probe_fail——这一条我如实写在这里,不冒充"读完"。
说明:这个版本是中英对照排版,每段英文后紧跟一段中文译文,所以 554 屏大约只对应原书 280 页。引句页码为本次截图编号,与纸书页码无关;凡加引号的话都能在截图里逐字核对,标"我的判断"处是评论。
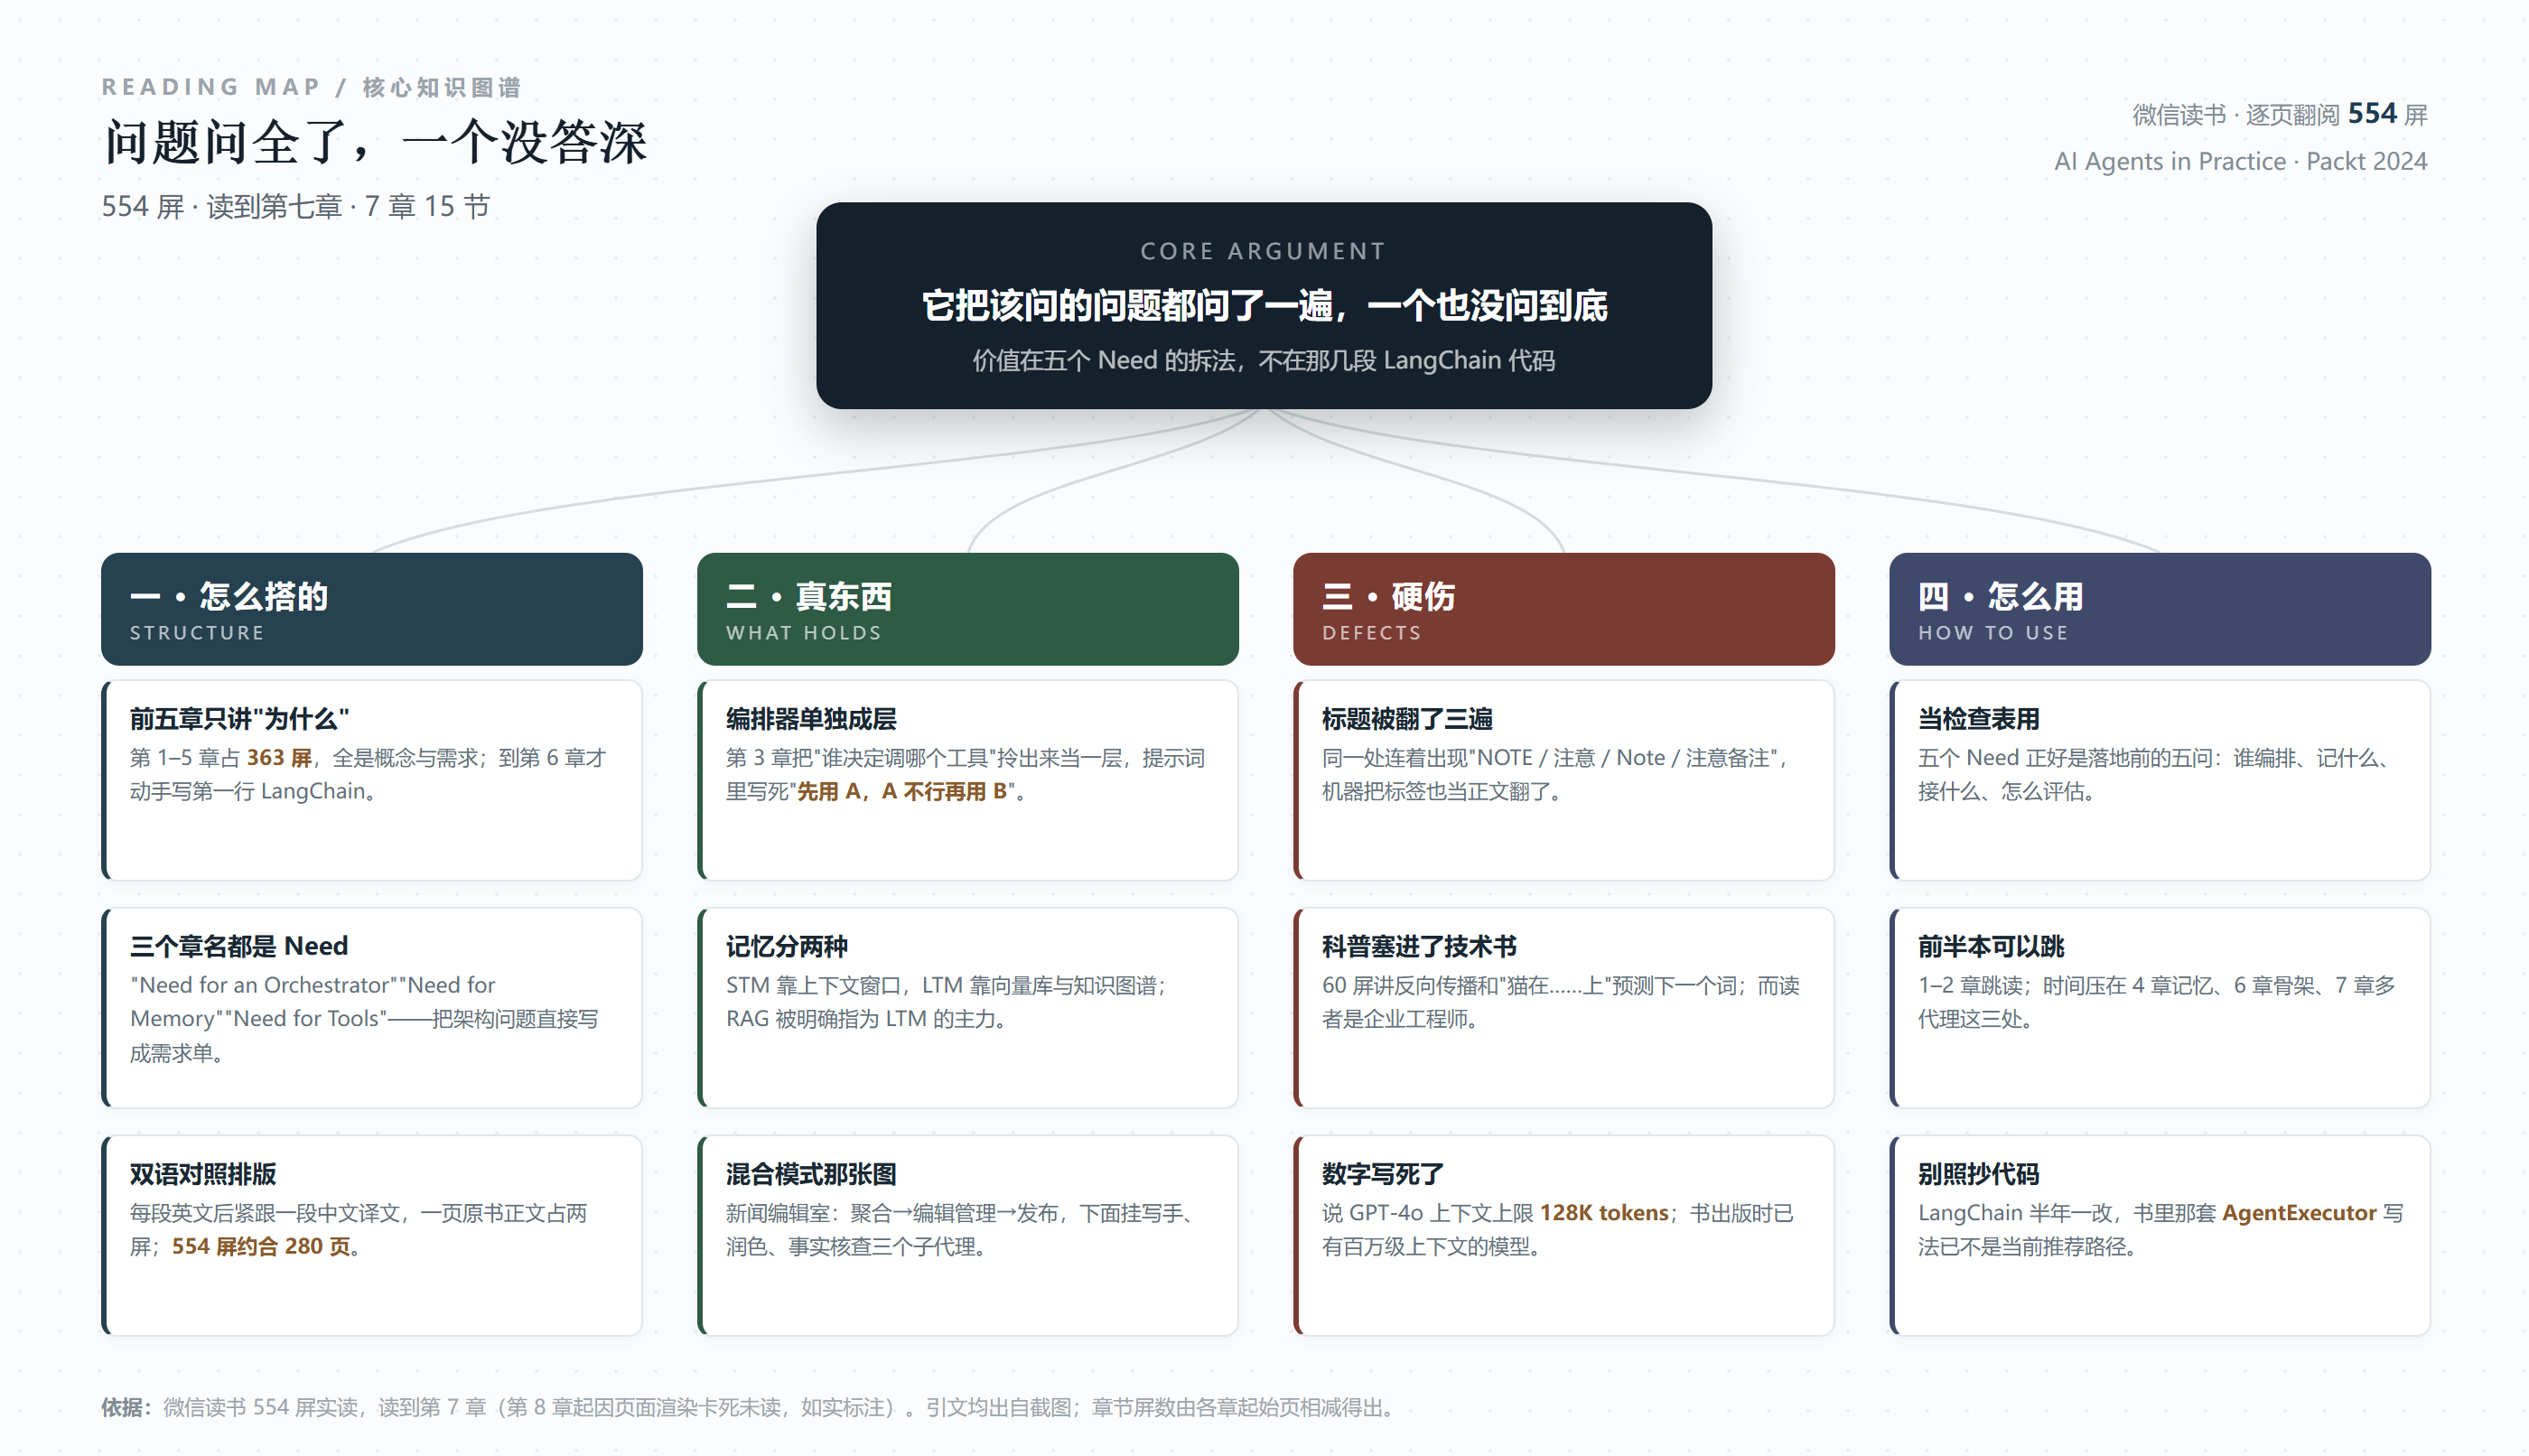
先说结论:这本书的结构比它的内容好。
它把"做一个 AI Agent 需要什么"拆成了五个 Need——需要一个编排器、需要记忆、需要工具、需要骨架、需要多代理协作。这五个问句,是我见过的同类书里最接近工程实际的目录。但它每一问都只答到"是什么"就收笔,没有一本技术书该有的"哪里会崩"。
我读它的时候一直在记一件事:这段话,一个真要上线的人用得上吗?下面按这个尺子说。
一、先算一笔账:554 屏里到底有多少正文
我按章节起始页相减,把这本书的量算了一遍:版权与前置信息(版权页、作者简介、审校者、订阅推广、前言)43 屏;第 1 章《Evolution of GenAI Workflows》71 屏;第 2 章《The Rise of AI Agents》54 屏;第 3 章《The Need for an AI Orchestrator》54 屏;第 4 章《The Need for Memory and Context Management》80 屏;第 5 章《The Need for Tools and External Integrations》55 屏;第 6 章《Building Your First AI Agent with LangChain》128 屏;第 7 章《Multi-Agent Applications》从我读到的位置算起已 63 屏。
这里面藏着一个必须先说清的事实:前五章(第 1 到第 5 章)合计 314 屏,占我已读部分的六成以上,全部是概念,没有一行能跑的代码。第一行真正动手的内容,要到第 6 章第 363 屏才出现。
而这 554 屏的物理长度,还被排版放大了一倍。这个微信读书版本做成中英对照:一段英文,紧跟一段中文译文,中间没有分栏、没有折叠。也就是说,同一页原书正文,在这块屏幕上要占两屏。554 屏除以二,约合原书 280 页——一本 Packt 的入门书正常的厚度。
我不认为这是作者的错,但读者需要知道:你在进度条上看到的"554 屏",实际的阅读量只有一半。我的判断:这种双语排版对"读懂"没帮助,对"读完"是负担。你不是在读两遍,是在同一句话上停两次,眼睛会不由自主地去比对照,注意力被切成两半。
前置那 43 屏也值得单说。版权信息、作者简介、审校者名单、"订阅即可免费获得电子书"的推广页,一路到第 12 屏才进前言。43 屏占了我这次阅读的 7.8%,而这个比例在同类引进版里算正常,换句话说:这不是这本书的问题,是这类书的通病。但既然我在逐页翻,这笔账就得记上——它意味着你买到的"厚度"里,有一块是印厂填的。
顺带一个观察:第 1 章的 71 屏里,真正讲"GenAI 工作流怎么演进"的部分并不长,大量篇幅花在给每个概念配一个类比上。类比是好东西,但一个概念配一个类比、配完就走的写法,会让读者产生"我懂了"的错觉。我读到第 5 章时回头翻,发现第 1 章那些类比一个都用不上——它们没有变成判据。
二、五个 Need 是全书最好的设计,也是它最深的坑
第 3、4、5 章的标题放在一起看,是一句话:The Need for an AI Orchestrator / The Need for Memory and Context Management / The Need for Tools and External Integrations。
连用三个 "Need for",粗暴,但有效。它把"Agent 架构"这个大词,拆成了三个可以单独回答的工程问题:谁来决定下一步调什么?它记得住什么?它能碰到什么?
这三个问句的价值,在于它们是可验收的。你可以拿着它们去盘自己的项目:编排逻辑现在是硬编码在 if-else 里,还是有一层独立的决策?记忆现在是每次把历史全塞进 prompt,还是分了短期长期?工具是从三个内网 API 起,还是要接二十个?盘完,缺哪块一目了然。
但坑也在这儿。"Need for X" 这种句式,天生只回答"为什么需要",不回答"做到什么程度算够"。我读到的七章里,没有一章给过验收标准:编排器的决策准确率怎么测?记忆召回错了怎么发现?工具调用失败的重试上限是多少?没有。整本书的语气始终是"你应该有这一层",而不是"这一层做成什么样才不算白做"。
这不是文风问题。我的判断:一本讲 Agent 的书,如果通篇不谈评估,那它讲的其实是"Agent 的形状",不是"Agent 的工程"。形状可以照着摆,工程必须自己踩坑。
再往深一层看,"Need for X" 这个句式其实还藏着一个假设:这些层是可以一个个加上去的。先做编排,再补记忆,再接工具,最后上多代理——像搭积木。但从工程上讲,顺序往往是反的:你先知道自己要碰哪些工具,才能决定记什么;你先知道记忆里有什么,才能设计编排的判据。这三层是互相锁死的,不是流水线上的三道工序。
书里把它们切成三章,是为了讲得清楚,这个取舍我理解。但它没有在切完之后把它们缝回去——没有一章讲"这三层之间的接口该长什么样"。而真实项目里,80% 的返工都发生在接口上:编排器以为记忆会返回摘要,记忆返回了原文;工具层以为编排器会重试,编排器一次失败就放弃。这些缝,书里没有。
三、第 3 章:编排器那一层,值一页纸
第 3 章里有一段,是我在整本书里划了线的。它给的例子是这样的:
"你是一个乐于助人的 AI 助手。你可以使用以下工具:Tool A / Tool B。收到用户的查询后,应始终使用工具 A 进行处理。如果无法用工具 A 完成任务,则再使用工具 B。请务必在尝试使用工具 A 之前,不要先使用工具 B。"
然后它补了一句关键的:"正如我们将在第 3 章看到的,这些策略是在协调器层面定义的。"
这句话看着平淡,其实点到了一个真问题:Agent 的"策略"到底写在提示词里,还是写在代码里?这段示例的做法是写在提示词里——用自然语言告诉模型"先用 A 再用 B,不许反过来"。
我的判断:这条路能走通,但走不远。两个工具时可以这么写,二十个工具时,这段提示词会变成一份没人维护的调度说明书,而且模型对它的遵守程度是不可测的——你不知道它是真的先试了 A 失败再调 B,还是看了 B 的描述觉得更像就直接调了 B。要可控,就得把"先 A 后 B"做成状态机,让代码管顺序,让模型只管"这一步 A 能不能干"。
第 3 章把这层单独立出来讲,方向是对的;但它停在了"可以这样写提示词",没有走到"这样写会在哪里失效"。一本书的价值,往往就在这最后一步。
四、第 4 章:记忆分成了两种,但"忘"这件事没写
第 4 章是全书最厚的一章,80 屏。它把记忆切成两块:短期记忆(STM)和长期记忆(LTM)。
STM 那块讲清楚了上下文窗口:"在 STM(即工作记忆)中,'上下文窗口'的概念至关重要。它指的是模型能够同时处理的文本范围——以标记数来衡量。"接着它给了失效场景:"当输入超过模型的上下文窗口时,模型可能难以保持连贯性和相关性,因为它无法访问文本的早期部分。"
LTM 那块写得更实:"LTM 通常由持久化存储系统支撑——向量数据库、知识图谱或结构化存储库。其中最有效的技术之一是检索增强生成(RAG),即智能体从存储库中提取相关知识来支撑其回应。"
这段话把"记忆"从玄学拉回了存储:记忆不是一个魔法抽屉,是向量库加检索引擎。这个说法我完全同意,它也顺带解释了一个常见误解——很多人以为"给 Agent 加记忆"是让模型自己记住,其实是让模型每次都去查。
但 80 屏讲完,没有一个字讲"遗忘"。而我认为记忆系统里最难、最容易出事的一半,恰恰是遗忘:什么时候把一条旧记忆判为过期?用户改了口径以后,旧的那条怎么压掉?如果两条记忆互相矛盾,谁赢?
向量库只会"越来越像就召回",它不会自己判断哪条更该信。我的判断:不做遗忘策略的记忆系统,三个月后一定开始胡说——不是因为它记错了,是因为它把过期的对的当成现在的对的。这本书给了记忆的入口,没给出口。
还有一个更隐蔽的问题,80 屏里也没提:记忆和"幻觉"之间是正相关还是负相关?直觉上,记得越多越准;但工程上,召回错了比没有记忆更糟——没有记忆时模型会说"我不知道",召回了一条不相干的旧记录时,它会把那条当成事实编进去,而且口吻比平时更确定。RAG 之所以在真实项目里翻车,多数不是检索不到,是检索到了不该检索的。
书里把 RAG 说成"LTM 最有效的技术之一",这个判断我同意;但它没说 RAG 的第一道门槛不是向量库,是切分:一段文档怎么切、按什么切、切完要不要留上下文标题。这些决定召回质量的东西,全在"最有效"这三个字后面藏着。一句话的结论,读者最容易记住,也最容易照着做错。
五、第 6 章:一百二十八屏的 LangChain,和一张看不清的图
第 6 章是全书最长的一章,128 屏,主题是"用 LangChain 做出你的第一个 Agent"。这是它从概念转向实操的地方,也是它最容易过期的地方。
我在这章抽到的页面,有一处体验问题值得单独说。第 6 章给了一张图(Figure 6.5),内容是两张食品认证文件的截图,用来演示"我们要拿来当知识库的材料长什么样"。图注写得很清楚,然后紧跟一句:
"小贴士:需要查看该图片的高分辨率版本吗?请在新一代 Packt Reader 中打开本书,或以 PDF/ePub 格式查看。"
这句话本身就说明了问题:作者知道这张图在电子书里看不清。而"把真实文档当知识库"这件事,关键信息恰恰全在图的细节里——表头是什么、字段怎么排、印章在哪。图糊了,这个例子就只剩下"有这么回事"。
我的判断:知识库章节用截图当素材,是一种偷懒。同样的内容,把字段列成一张表、把清洗步骤写成三条,信息量能翻三倍,而且不会随阅读器清晰度失效。它选了一张好看的图,代价是这一页读完等于没读。
六、第 7 章:混合模式那张图,是全书最强的一页
读到第 7 章,我终于看到一张能当图纸用的图(Figure 7.8,Hybrid pattern)。它画的是一个新闻编辑部:
最上面一条线是串行的三个阶段——News Aggregator(从通讯社、社交媒体收集数据)→ Editorial(管理一个代理团队)→ Publishing(把文章分发到各渠道)。中间那个 Editorial 往下挂三个子代理:Writer(生成初稿)、Style-refiner(把语气、语法、格式调对)、Fact-checker(交叉核对事实并给出修改)。
图下面那段解释是全书最有工程味的一句:这个混合结构给原本线性的流水线"增加了灵活性和质量控制",因为"由编辑管理器掌管的层级子结构允许专业化与健壮性,而不破坏整体的串行任务"。
顺着这段,书里把发布代理的职责也写清了:"负责将最终稿件准备好以便在线发布,添加标签和搜索引擎优化元数据,然后将其发布到新闻网站和社交媒体平台上。"
为什么我说这是全书最强的一页?因为它同时解决了三个真问题:一是分工——写、润、核是三件不同的事,不该塞进一个提示词;二是可控——事实核查单独成代理,就意味着它可以单独被拦下、被记录、被追责;三是结构——下面挂三个,上面仍然是一条直线,没有为了"多代理"把整条流程改成网状。
第 2 章讲抽象与模块化时,用了一个城市交通的比喻:"不同层级的代理处理不同层级的抽象,确保整体平稳运行,又不让任何单一实体过载。"这个比喻放在第 7 章这张图上才算落地。我的判断:如果这本书只留一章,留第 7 章。
不过这张图也埋了一个它自己没说的代价。三个子代理串在一条线上——写手出稿、润色改稿、核查挑错——每一道都要一次模型调用,而且后一道必须完整读前一道的输出。三段的流水线,延迟至少翻三倍,token 成本至少翻三倍,而质量提升的幅度是没被测量的。书里给的理由是"灵活性和质量控制",但没给任何一组对照:单代理直接写,和这条三人流水线,差别到底多大?
这不是吹毛求疵。多代理是这两年被吹得最狠的一块,也是最容易做了等于白做的一块——很多团队把一条提示词拆成三个代理,跑完发现效果差不多,维护成本涨了两倍,最后又合回去。这本书手里有最好的那张图,却没有配一句"什么时候不值得这么拆"。一张只讲好处的架构图,容易被当成标准答案抄走,而它本来只是一张示意图。
七、第 5 章讲清了"接什么",没讲"坏了怎么办"
第 5 章是全书最像工程文档的一章,55 屏。它把工具分成几类,我抽到的页面在处理"企业内部工具"这一类:
"许多组织的内部 API 都运行在防火墙后面或虚拟网络中。这些 API 支撑着各项核心业务系统,比如库存管理系统、客户数据库、预订系统以及人力资源平台等。"
"内部 API 通常需要安全的网络接入方式(如 VPN 或 VNet 集成)。"
同页上还点了 Microsoft Graph API 这条路径——用来跟 Outlook、Teams、OneDrive 打交道。
这段写得对,而且点到的地方很关键:Agent 真正有用的场景,八成在内网。公网 API 谁都能调,不值钱;值钱的是"我们公司那套库存系统"。而内网这条路要过的是鉴权、网络、审计三道关,书里只说了第一道(要 VPN 或 VNet),后面两道没展开。
但比这更缺的,是另一个问题:工具会坏。内网 API 会超时,会返回 500,会在半夜做数据库迁移的时候给你一段 HTML 错误页。Agent 拿到 HTML 错误页,会把它当数据继续往下算——这是最典型的生产事故,而且它不会报错,它只是错。
我的判断:工具层最该写的不是"有哪些工具",是"工具坏了以后,谁来判断它坏了"。这个判断不能交给模型,因为模型看到一段格式奇怪的返回,第一反应是"尽力理解",不是"报告异常"。所以工具层需要一个外挂的校验:返回体能不能通过 schema?延迟有没有超阈值?连续失败几次要熔断?这三条,书里一条都没写。
它讲了接什么,没讲接上之后怎么守着。这是"Need for Tools"这个标题的极限——"需要工具"是显然的,"工具需要被看管"才是知识。
八、它的短板
第一,深度和目标读者不匹配。第 1 章用了大量篇幅讲基础:反向传播是"将模型的预测结果与正确答案进行比较,计算出误差(即损失值),然后调整网络的内部参数(权重)以降低该误差";接着用"猫在……上"预测"mat/roof/sofa"来解释下一个词的概率分布。这些内容本身没错,问题是它出现在一本讲"企业级 Agent 编排"的书里。会买这本书的人,多半已经知道反向传播是什么;而不知道的人,看完这两段也做不出 Agent。这不是"照顾初学者",是没想清楚写给谁。
第二,机翻痕迹留在正文里,而且留在最不该出错的地方——标题。在讲企业 API 的那一页,同一个提示框连着出现四行:"NOTE/注意/Note/注意备注"。四行是同一个词。标题被当成正文翻了一遍,又被当成标签翻了一遍。这不像手误,是流程问题:机翻没有把标题样式从正文流里剥出来。读者碰到这种地方会本能地降低对全书的信任——如果标题都能重复三遍,那数字和结论呢?
第三,具体数字写死了,而且写的是当时的。第 4 章讲上下文窗口时给的上限是:"up to 128K tokens for models such as GPT-4o"。这个数字在书出版那会儿是对的,但上下文长度是这两年变化最快的一个指标,百万级上下文的模型已经商用。技术书里写具体型号的具体参数,等于给这本书印了一个保质期。更稳的写法是讲量级和它的后果——"上下文越长,中间段的信息越容易被忽略",这句到今天还成立,而"128K"已经过期。
第四,全篇没有评估,也没有失败案例。这一点我在第二节说过,这里补一句更狠的:一本讲 Agent 的书,读到最后你不知道它有没有真的跑通过一个 Agent。书里给的是流程图、提示词片段、示例截图,没有一处是"我们上线后准确率从 62% 到 81%,代价是延迟翻倍"。没有数字的工程书,只能当科普读。
第五,我这次没读完,这是书之外的短板,也得写。第 554 屏之后,页面渲染卡死,抓取脚本报 probe_fail 退出。目录显示全书还有第 8 章及之后的 Part 3,我没读到。所以上面所有判断,只覆盖前七章。如果后面的章节里补上了评估与失败案例,那我第四条的批评就要打折扣——这一点我留在这里,不装作读完了。
九、怎么读
如果你手上已经有这本书,我的建议很短:
1–2 章可以跳。讲 GenAI 工作流演进和 Agent 兴起的那 125 屏,信息密度最低,用一篇综述替代不会损失什么。
3、4、5 章当检查表读。不要顺着读,拿自己的项目去对:编排在哪、记忆在哪、工具在哪。对不上的地方,就是你要补的地方。
6 章别抄代码。LangChain 的 API 一年改几次,书里这套 AgentExecutor 的写法已经不是当前推荐路径。要看代码,去看官方文档的当日版本。
7 章那张混合模式的图,值得单独存下来。它把"多代理"从概念变成了可以照着画的框图,而且给了克制:只往下挂三个,主线不改。
最后说一句总评。这本书像一份写得很整齐的需求文档:它把该问的都问了,把该分层的都分了,然后每一层都只写到"你需要它"为止。对刚接手 Agent 项目、需要一张全景图的人来说,这 280 页值;对已经在坑里的人,它给不了你出坑的绳子。我的判断:把它当目录,别当手册。
如果让我给作者提一条修改建议,只有一条:把每一章末尾的"总结"换成"这一层做错时会怎样"。五个 Need,配五个失败案例——编排器把 B 排到 A 前面导致重复扣款;记忆把三个月前的价格当现价报出去;工具超时被当成空结果,流水线跑完产出一份全零报表。这些例子不需要真实数据,只需要作者亲手写过。有了它们,这本书会从"需求文档"变成"事故手册",而后者的价值高一个量级。
阅读记录:微信读书《AI Agents in Practice》(Valentina Alto)· 逐页截图 554 屏 · 读到第 7 章(第 8 章起渲染卡死,未读)· 抓取耗时 1102 秒 · 章节标记 15 个 · 中英对照版,实际对应原书约 280 页 · 本篇引句均出自本次截图,end=probe_fail
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: