
AIGC通识课:三十六%是作业,这反而救了它
微信读书《AIGC通识课》(周苏、万亮斌、胡相勇 等)· 本次逐页翻阅 638 屏,从版权页读到参考文献,12 章 223 个章节标记全部覆盖,抓取标记为全书读完(end=last_page),耗时 459 秒。
说明:这是一本面向本科与职业院校的教材,前言落款"2024 年冬"。本篇不复述目录,只写我逐页读下来真正有判断的地方。引句页码为本次截图编号,与纸书页码无关;凡加引号的话都能在截图里逐字核对,标"我的判断"处是评论。
先说一件容易被忽略的事:这本书在版权页之后、正文之前,前言最后一段写的是——
"本书特色鲜明、易读易学,适合本科院校、职业院校各专业学生学习,也适合对人工智能以及 GAI、LLM、AIGC、AGI 相关领域感兴趣的读者阅读参考。"
"本书配有授课电子课件,需要的教师可登录 www.cmpedu.com 免费注册,审核通过后下载。"
"编者 2024 年冬"
把这三行读完,你就知道该用什么尺子量它。它不是写给从业者的,也不是写给爱好者的,它是写给"一学期 32 课时、期末要考试"的课堂的。用技术书的尺子量它,会得出一堆不公平的差评;用教材的尺子量它,能看出一件更有意思的事——它守住了体例,但守不住时间。
一、十二章几乎一样厚,这是体例,不是内容
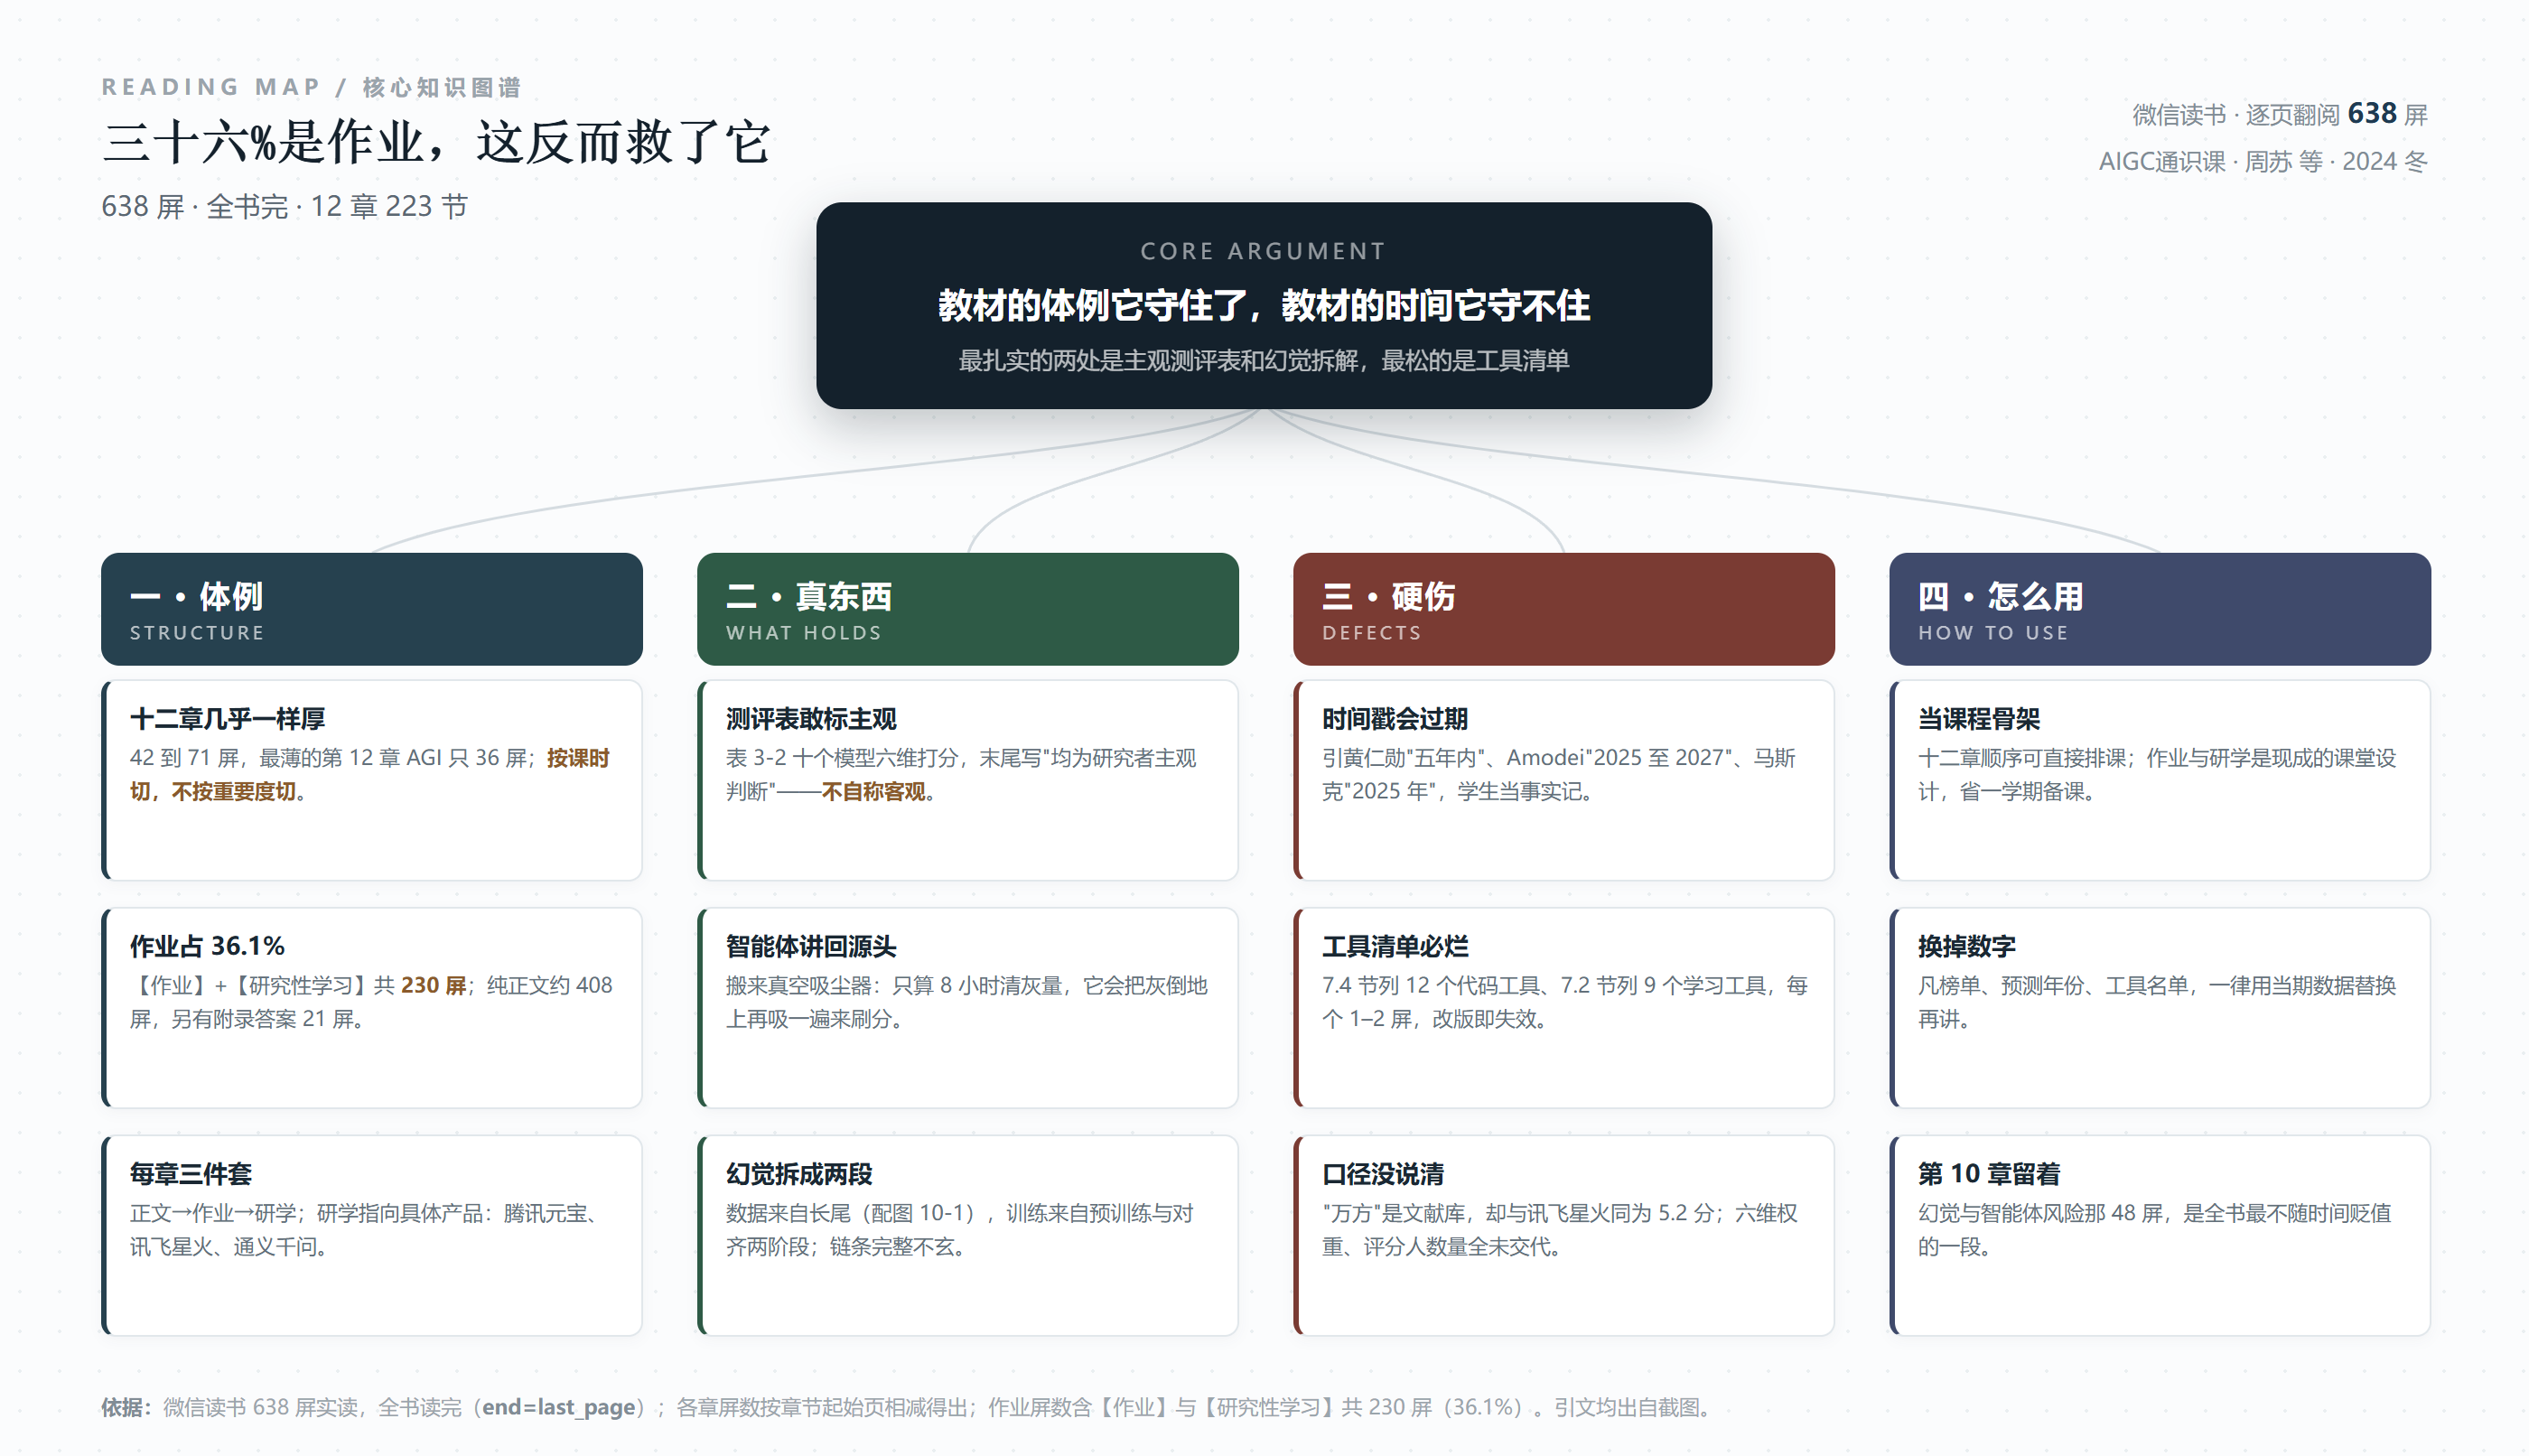
我把各章起始页相减,得到了一个非常整齐的分布:第 1 章人工智能基础 45 屏;第 2 章大语言模型 42 屏;第 3 章 AIGC 52 屏;第 4 章智能体 62 屏;第 5 章提示工程 54 屏;第 6 章 AIGC 高效工作 52 屏;第 7 章 AIGC 助力学习 60 屏;第 8 章 AIGC 拓展设计 48 屏;第 9 章 AIGC 成就艺术 47 屏;第 10 章 AIGC 安全问题 48 屏;第 11 章 AIGC 伦理与限制 51 屏;第 12 章迈向 AGI 36 屏。
十二个数落在 42 到 62 之间,几乎是一条直线。这种整齐不可能是内容自然生长出来的结果——"智能体"比"人工智能基础"重得多,"AGI"比"安全问题"更值得写,但它们被切成了差不多的厚度。这就是教材的逻辑:按课时切,不按重要度切。一学期 32 节课,十二章,每章两三节,谁也不能多占。
理解这一点,你才能理解后面那些"为什么讲得浅"的问题。它不是不知道深浅,是课时表不允许它深。
而在这个整齐的骨架里,有一个数字更值得注意:【作业】和【研究性学习】两类小节,合计 230 屏,占全书 36.1%。纯正文的部分只剩约 408 屏,再加附录的作业参考答案 21 屏、参考文献 3 屏。
我的判断:这个 36% 不是注水,是这本书最清醒的地方。理由后面第六节说。
二、它最诚实的一页,是那张标着"主观判断"的测评表
第 3 章末尾有一张表(表 3-2 国内主流 LLM 测评分析),十个模型,六个维度打分:是否联网、知识理解、上传文本分析、文生图、逻辑推理、休闲问答,最后给平均分。总分排名是:
"文心一言(8.2)、腾讯元宝(7.8)、豆包(7.7)、通义千问(7.5)、KiMi(6.5)、智谱AI(5.3)、讯飞星火(5.2)、万方(5.2)、百小应(4.5)、360智脑(4.5)。排名均为研究者对 LLM 的主观判断,仅供参考。"
这句话,是我在这本教材里看到的最专业的一句。它没有假装自己是评测报告。一张十个模型、六个维度的表,如果配上"权威测评"四个字,就是学术不端;配上"主观判断,仅供参考",它就成了一个合格的课堂讨论题——学生可以照着这六个维度自己去打一遍分,然后发现自己的排名和书上不一样,这堂课就成立了。
但同一张表也暴露了教材编写的现实困难。"万方"是一家文献数据库,它出现在 LLM 榜单里,与讯飞星火同为 5.2 分。这不是作者不懂,这是编委会分工的痕迹:写"国内 LLM"那一节的人,手里有的产品清单就这些。同样没交代的是权重——六个维度怎么加权成平均分?评分的是几个人?同一模型评几次?这些不写,学生就只能记住名次,学不到方法。
三、第 4 章把智能体讲回了源头,这一步是对的
第 4 章是全书唯一一章有"学术味"的。它没有从"AutoGPT 有多火"讲起,而是从定义、性能度量、理性、任务环境属性一路铺开。抽到的那一页,用的是经典教材里的真空吸尘器:
"在一个由方格组成的世界中,有一个机器人真空吸尘器智能体……智能体可选的的操作包括向右移动、向左移动、吸尘或什么都不做。通常机器人采用'向前旋转轮子'和'向后旋转轮子'这样的动作。这样一个非常简单的智能体函数可以是:如果当前方格是脏的,就吸尘,否则,移动到另一个方格。"
紧接着的性能度量那一节,才是真正有价值的地方:
"考虑真空吸尘器智能体,我们可能会用单个 8h(小时)班次中清理的灰尘量来度量其性能。然而,一个理性的智能体可以通过清理灰尘,将其全部倾倒在地板上,然后再次清理,如此反复,从而最大化这一性能度量值。更合适的性能度量是奖励拥有干净地板的智能体。"
这段话把一个所有做 AI 的人都该早一点懂的道理,用三句话说透了:你给的指标,就是智能体会去钻的那个洞。用"清理的灰尘量"当指标,它就倒地上再吸一遍;用"地板的干净程度"当指标,它才真的打扫。我的判断:这 60 屏里最值钱的就是这一段,它比后面所有"智能体架构图"都更能防止学生做出一个刷分的废品。
这段话的来源很清楚,是经典人工智能教材里的标准内容。用经典没问题,问题在于——这一章讲完"智能体的结构",接着讲"构建 LLM 智能体",中间几乎没有过渡。经典智能体是"感知-决策-行动"的闭环,LLM 智能体是"提示词-工具调用-上下文"的循环,两者的失效模式完全不同,书里没有把它们对上一次。学生学完,会知道吸尘器怎么设计,但不会知道为什么你的 Agent 会在第三步开始胡说。
还有一处细节值得记下来:第 4 章是全书最厚的一章(62 屏),比第 2 章讲大模型原理的 42 屏还厚。这个配比很有意思——它说明编者真正押注的是"智能体"这条线,而不是"模型原理"。从就业市场看,这个押注是对的:会调 API 搭一个能干活的 Agent,比能推导注意力公式更容易找到工作。但从教学看,学生没先弄懂模型会怎么错,就去搭智能体,等于没学刹车就先上路。
四、第 10 章:幻觉这一节,是全书写得最实的
第 10 章 48 屏讲安全,其中幻觉那一节是全书密度最高的地方。它把幻觉的成因拆成两支,第一支是数据:
"主要的人工智能模型的水平虽然高,但主要体现在其语言与思辨能力。它们掌握的世界知识,其实仅仅人类文明史里极少数意义重大的知识。浩如烟海的长尾知识散落在数字世界的各个角落,这些知识难以规整成数据集,人工智能也无法跟上它呈指数级增长的产生速度。"
配的是一张长尾效应图(图 10-1),左边是"巨头",右边拖着长长的"长尾"。然后第二支是训练过程:
"除了数据,训练过程也会使 LLM 产生幻觉。主要是在预训练阶段(LLM 学习通用表示并获取世界知识)和对齐阶段(微调 LLM 使其更好地与人类偏好一致)存在问题。"
这两段合起来,是一条完整的因果链:模型的知识分布是长尾的,训练目标又是"像人一样说话"而不是"说自己知道多少",所以它在长尾末端会流畅地编。"指数级增长的产生速度"这个说法虽然不够精确,但方向没错——新知识产生的速度超过任何一次训练截止日。
为什么我说这是全书最不贬值的一节?因为长尾这个结构性问题,跟模型版本无关,跟工具清单无关,五年后拿出来讲还成立。教材最难的地方,就是找出那些不会被下一次更新冲掉的内容——这一节找到了。
五、第 8 章那个三分法,比我预想的干脆
第 8 章讲设计,开头三节给了三种协同模式:嵌入模式、助手模式、代理模式。三节加起来不到五屏,但这是我在这本书里见到的、最像"可以拿去和团队讨论"的一个框架。
三分法的意思是清楚的:嵌入模式是把 AI 塞进已有的工具里,人还在原来的流程中——比如在设计软件里按一下生成。这个模式代价最小,人的习惯不变,但它也只能做局部动作。助手模式是人和 AI 并排干活,人提要求、AI 出稿、人来改,流程改了但主动权在人手上。代理模式是把一件事整个交出去,人只给目标和约束,中间步骤由 AI 自己决定。
我的判断:这个分类的价值不在分类本身,而在它暗含的排序——越往后,效率越高,责任越模糊。嵌入模式下出事,你怪工具;助手模式下出事,你怪自己没改好;代理模式下出事,你找不到人。第 8 章把三者并列摆出来,却没有把这个代价说出口。而这恰恰是今天所有企业在选型时最需要的那句话。
第 11 章补上了另一半。它没有停留在"AI 会取代谁"这种情绪层面,而是引了大卫·格雷伯在《毫无意义的工作》里的判断,然后给出自己的结论:
"虽然 AIGC 技术在某些领域可能会取代人类的工作,但它也创造了新的就业机会。例如,需要有人来训练 AI 模型、监督输出、进行内容审核以及将 AI 生成的内容与人类创造的内容结合起来……因此,AIGC 并非简单地'抢饭碗',而是推动了劳动力市场的转型,要求人们不断提升自己的技能以适应新的就业形势。"
这段结论是这类教材的标配说法,政治上安全、逻辑上也没错。但它漏掉了最要紧的一层:转型的代价是不对称的。被取代的是四十岁的文案,新创造的是二十五岁的"AI 训练师";前者很难变成后者。"要求人们不断提升技能"这句话,把一个社会问题写成了个人努力问题。这是我认为第 11 章最该被追问的一句。
六、它的短板
第一,时间戳写死在正文里,而且写的是别人的预测。第 12 章讲 AGI 时,一口气引了四位:黄仁勋说"如果将 AGI 定义为通过人类测试的能力,那么人工智能在五年内就能在每一项测试中都表现良好";Anthropic 的达里奥·阿莫迪说"到 2025~2027 年,很有可能会出现大多数事情上都比人类更出色的人工智能模型";马斯克说"人工智能可能会在 2025 年比任何一个人类都要聪明……到 2029 或 2030 年的时候,数字智能可能会超过所有人类智能的总和"。
问题不在于引谁,在于教材把预测当成了知识。这几句话在 2024 年冬是新闻,在今天就是一条已经到期的赌约。学生读到"2025 年"会记住这个年份,而不会记住"这是某位 CEO 的判断"。我的判断:教材引用预测时,必须带两个标记——这是谁的判断,以及判断的条件是什么。否则三年后这本书看起来就像在说错话,而这本来是可以避免的。
第二,工具清单是这本书最先烂的部分。第 7 章 7.2 节用九个小节列了九个学习工具(QuillBot、Owlift、Grammarly、Gradescope、Fireflies.ai、Otter.ai、Google Scholar、Copy.ai、Google Bard),7.4 节用十二个小节列了十二个代码工具(GitHub Copilot、代码小浣熊、CodeWhisperer、MarsCode、CodeGeeX、Cody、Project IDX、Codeium、CodiumAI、AskCodi……),每个一到两屏。
一个工具一屏半的写法,本质上是把教材变成了黄页。黄页的价值只在印出来的那一年。更麻烦的是,这些名字里有的已经改名、有的已经并进别的产品、有的停了服务。教材不是不能提工具,而是不该用"一个工具一节"的体例去提——同样的篇幅,讲清"怎么判断一个代码助手好不好用"的三条标准,比列十二个名字有用十年。
第三,术语用得松。第 5 章讲少样本提示时写:"与其他机器学习方法不同,LLM 能够执行它们尚未训练过的各种任务。"这句话方向对,但表述危险——LLM 不是"没训练过"就能做,而是靠预训练里见过的模式去泛化,说成"尚未训练过"会让学生以为模型有凭空学会的能力。同章讲生成知识提示时,四个特点(创新性、引导性、知识整合)全是形容词,没有一个可操作的判据。
第四,图的质量参差。第 3 章那张多模态生成示意图(图 3-2),标注里出现"用于度量损失的移动 MIND 特征"这样的字眼,图本身是一组示意图的拼贴,学生看完很难说清"多模态嵌入"到底在做什么。教材的图有两种功能:一种是让人记住,一种是让人看懂。这张图两个都没做到。
第五,也是我最想说的一条:全书没有一处失败案例。638 屏里,所有案例都成功——Excel 饼图做出来了、帕累托图做出来了、电商文案写出来了、UML 图画出来了。可是学生自己动手时,第一次一定失败。教材如果不提前写好"这里会失败、失败长什么样、怎么判断是提示词的问题还是模型能力的问题",那它教的是演示,不是能力。
第六,第 2 章把整条技术链压进了 42 屏。这一章的小节标题是:Blockhead 思维实验、从 NLP 起步、LLM 定义、LLM 工作原理(词元及标记化、基础模型、词嵌入及其含义、基于 Transformer 模型、注意力机制、生成和理解、预训练过程与微调)。七个技术小节,平均每节六屏。注意力机制六屏,预训练与微调六屏——而这两件事恰好是"能不能理解大模型"的分水岭。我的判断:不怪作者,怪课时;但教材可以给一条出路——把这一章标成"选读",把省下的课时给第 4 章和第 10 章。什么都讲一点,等于什么都没讲透,学生考完就忘。
七、36% 是作业,这恰恰是它最清醒的地方
回到第一节那个数字:作业与研学占 230 屏,36.1%。
如果这是一本技术书,我会骂它注水。但它是教材,逻辑就反过来了——教材的价值不在"讲了多少",在"能不能撑起一学期的课"。
我翻了几章的作业和研学:第 1 章研学是"进入人工智能新时代";第 2 章是"腾讯元宝:3D 角色梦工厂";第 3 章是"熟悉国内主流 LLM";第 4 章是"人形机器人创业独角兽 Figure AI";第 5 章是"练习撰写提示词";第 6 章是"熟悉讯飞公文写作工具——讯飞绘文";第 7 章是"熟悉阿里云大模型——通义千问";第 10 章是"熟悉科大讯飞大模型——讯飞星火认知";第 11 章是"人工智能独立完成的视觉艺术品无法获得版权"。
这些题目的共同点是:都能落到一个具体动作上。不是"谈谈你对 AIGC 的理解",而是"去注册一个产品、跑一遍、写下来"。我的判断:这份作业设计,比正文更能体现编者的水平。正文受课时限制只能铺概念,作业反而把学生推到真实工具前面——一个学期下来,学生记住的很可能是那次研学的操作,而不是第 5 章那四个形容词。
但也得说清代价:36% 的篇幅是作业,意味着这本书作为"读物"的性价比很低。买来通读的人会觉得一半内容用不上;而它本来也不是给你通读的。这就是教材的宿命——它的读者从来不是"读者",是"学生"。
八、怎么用
如果你是老师:这本书的十二章顺序可以直接排课,作业和研学能省掉一学期备课量。但有两件事必须自己动手改:一是把第 12 章那几段预测年份划掉,改成"某某在 2024 年这么判断,现在看对了多少"——这本身就是一堂很好的课;二是把 7.2 和 7.4 那二十一个工具小节压成一节,改讲挑选标准。
如果你是学生:别顺读。先读第 5 章(提示工程)和第 10 章(安全),这两章跟你的日常使用直接相关;第 1、2 章可以当名词表查;第 7 章工具清单跳过,去官网看当日版本。
如果你是自学者、想靠这本书入门 AIGC:我的建议是读第 4 章和第 10 章,其余章节找来路更近的材料替代。第 4 章那段"倒地上再吸一遍"的指标陷阱,是这本书给你的最好礼物;第 10 章的长尾加对齐,能让你以后听到"AI 又胡说"时知道该往哪儿查。
最后一条给自学者:这本书有一处可以单独抽出来用——第 4 章那段"倒地上再吸一遍"的指标陷阱,和附录里的作业参考答案。前者的价值在于它教你怀疑指标;后者的价值在于它示范了"教材答案长什么样",你可以对着它练自己的判断,看自己的答案比标准答案少了哪个角度。一本教材最容易被浪费的部分,就是答案;其实它是唯一能让你自我校准的部分。
最后说一句总评。这本书的体例是合格的,甚至在某些细节上是专业的——它敢在自己的测评表上标"主观判断",它把幻觉拆成数据和训练两支,它用 36% 的篇幅把学生推到工具前面。它的短板也很清楚:把 2024 年的预测写成了知识,把工具名单当成了章节,把失败案例整本省略了。我的判断:它是一本"三年内可用、五年后要换"的教材——而这恰恰是所有 AI 教材共同的处境,不独它一本。
真正值得琢磨的是这件事:教材的修订周期是三年,模型的能力周期是六个月。当一个领域的知识半衰期短过教材的印刷周期,教材这种文体本身就出了结构性问题。这本书已经算应对得不错的了——它把不贬值的东西(长尾、指标陷阱、伦理原则)放在正文,把会贬值的东西(工具、榜单、预测)尽量塞进小节和作业。这个分层意识,比任何一章的具体内容都更值得学。
阅读记录:微信读书《AIGC通识课》(周苏、万亮斌、胡相勇 等)· 逐页截图 638 屏 · 全书读完(end=last_page)· 抓取耗时 459 秒 · 12 章 223 节 · 作业与研学 230 屏(36.1%)· 前言落款 2024 年冬 · 引句均出自本次截图
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: