
Agent Skills开发实战:347 屏讲架构,成败在一百个 token
微信读书《Agent Skills开发实战》(未来智能实验室 代晶 著,人民邮电出版社 2026 年 8 月)· 本次逐页翻阅 347 屏,从版权页读到第 11 章末,抓取标记为全书读完(end=last_page),耗时 241 秒。
说明:这是一本写给开发者看的工程书。我自己写过几个 Skill,踩过"写完根本不被调用"的坑,所以读的时候专门盯着它有没有回答这个问题。本篇不复述目录,只写我逐页读下来真正有判断的地方。引句页码为本次截图编号,与纸书页码无关;加引号的话都能在截图里逐字核对。
我写第一个 Skill 的时候,犯的错很蠢:我把 SKILL.md 写了三千字,步骤一二三四五,写得跟操作手册一样详细。然后它一次都没被调用过。
后来我才搞明白:模型根本看不到那三千字。它在启动时只加载每个技能的名字和一句描述,等判断"这个请求该不该用它"的时候,手里只有这句话。描述写得含糊,后面写得再好也是白搭——那三千字压根没进过上下文。
这本书第 6 章第一节和第 8 章第一节,讲的正是这件事。而且它给了一个我没见过的具体数据。347 屏里,真正解决我那个问题的,只有几页。这就是我对这本书的总体判断:一本结构规整的工程手册,但它最值钱的部分被埋在了中后段。
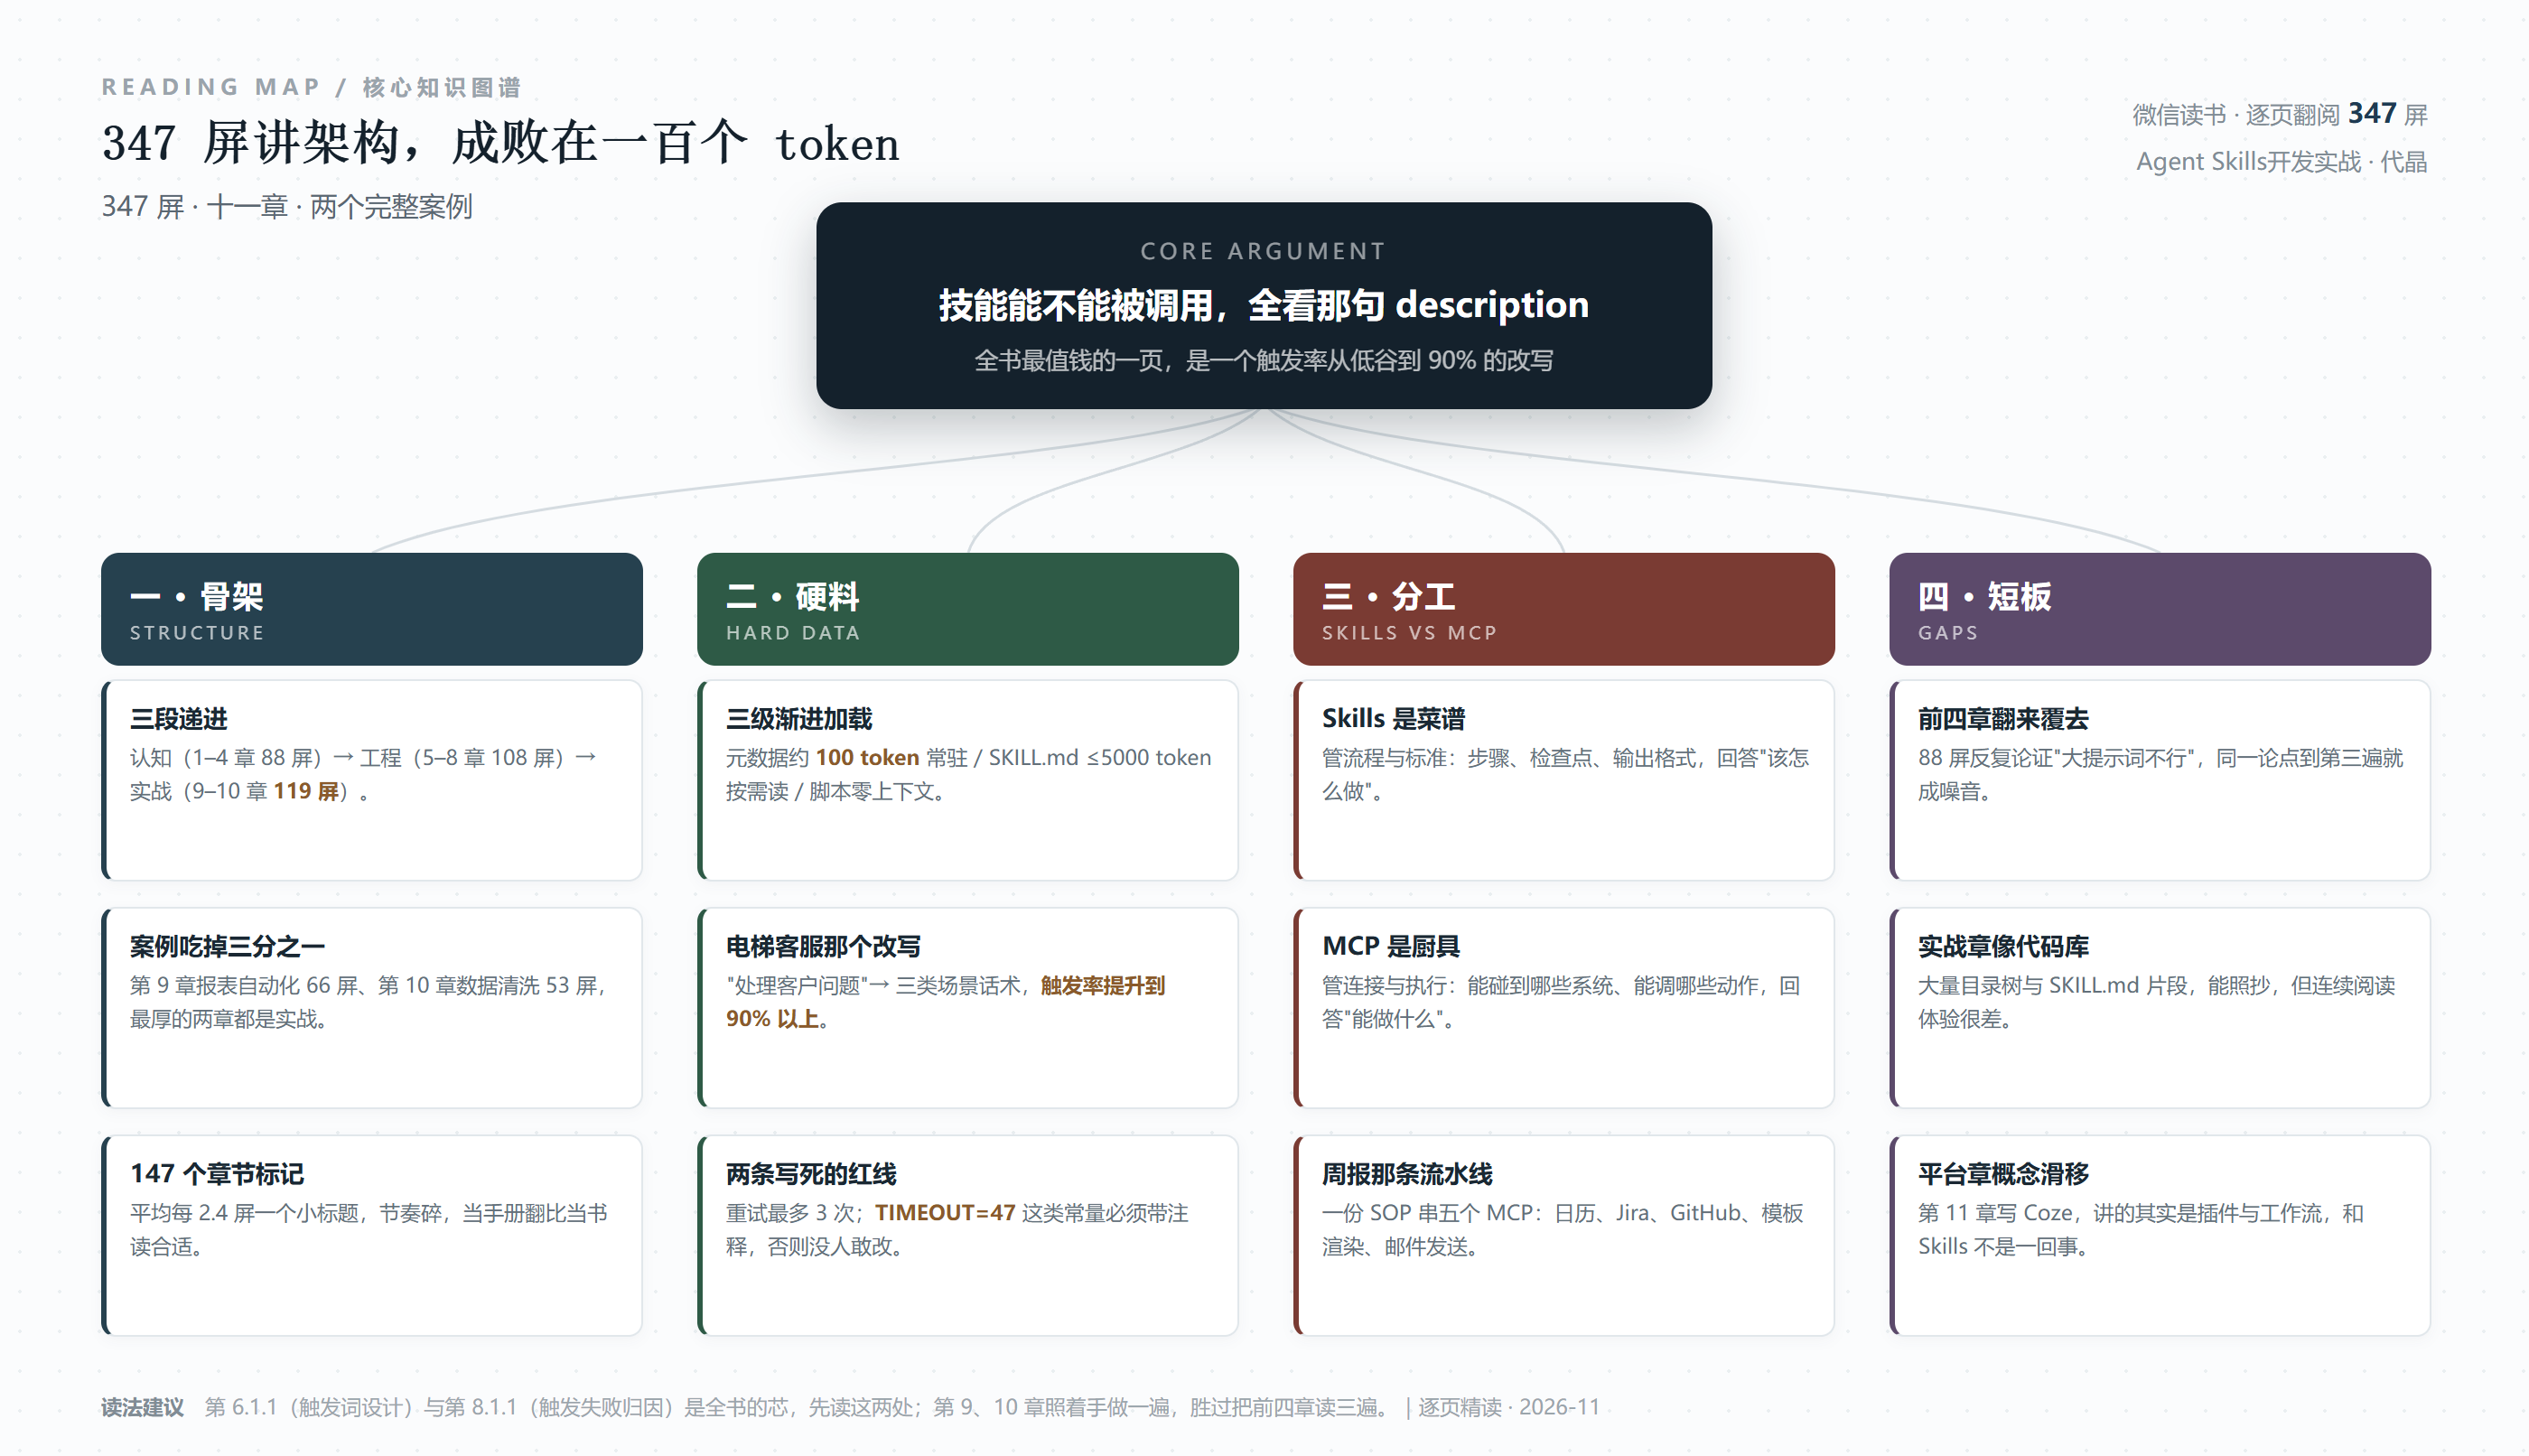
一、先算一笔账:347 屏,三段,两个案例吃掉三分之一
按每章起始页相减,这本书的骨架是:第 1 章 AI Agent 的进化 19 屏;第 2 章 初识 Skills 23 屏;第 3 章 技术架构解析 27 屏;第 4 章 Skills 与 MCP 19 屏;第 5 章 构建开发环境 29 屏;第 6 章 构建高质量的 Skills 21 屏;第 7 章 能力扩展 23 屏;第 8 章 交付保障 35 屏;第 9 章 自动化文档与报表生成 66 屏;第 10 章 端到端自动化数据清洗 53 屏;第 11 章 其他平台中的实践 24 屏。
作者在前言里把结构说成"理论—架构—实践"三层。按屏数算,这三层是:理论(1—4 章)88 屏,架构与工程(5—8 章)108 屏,实践(9—10 章)119 屏,再加第 11 章的 24 屏平台实践。
这个配比是我读过的技术书里比较健康的:实战占到三分之一以上。大部分"XX 实战"的书,实战部分其实是三五个截图拼起来的小例子,只占两成。这本不一样,第 9、10 章各是一个完整到能直接照抄的项目:一个是电商季度经营分析报告的自动化生成,一个是医疗电子病历数据清洗。
还有一个数字值得注意:全书 147 个章节标记,347 屏,平均每 2.4 屏一个小标题。这个密度说明它本质上是"手册体"而不是"论述体"——你不太可能一口气读完,但你能很快翻到你要的那一节。这是优点也是缺点,后面讲短板时我会展开。
二、它把"为什么"讲了三遍,这是全书最该压缩的部分
第 1 章到第 4 章,88 屏,这四章其实在反复论证同一件事:大而全的提示词不行了,要把能力拆成可组合的模块。
第 1 章的路径是从系统提示词讲到工具调用,再到 MCP,最后落到 Skills 的角色。第 1.2 节专门列了"大而全的提示词"的三个毛病:可维护性灾难、可复用性差(团队无法积累知识资产)、上下文膨胀带来的整体可靠性下降。
第 2 章重新讲一遍 Skills 的价值:省 token、可复用、可治理。其中"省 token"这一节用了一个我很喜欢的类比——把 Skills 比作大学教授的记忆方式:教授不会把每门课的完整讲义都装在脑子里,他只记住"课程目录"和"讲义放在图书馆哪个书架"。这个比喻精准,因为它点出了渐进式披露的本质不是"少写",是"分层"。
第 4 章又讲一遍,这次换成"菜谱与厨具":Skills 负责流程与标准(该怎么做),MCP 负责连接与执行(能做什么)。
三个比喻都对,都很好懂。但读到第三遍的时候,我已经有点不耐烦了。88 屏的篇幅,如果压到 40 屏,信息量一点不少。第 4 章的 Skills 与 MCP 之分,其实在第 1 章 1.1.5 节提到 MCP 的时候就该讲清楚,放在第 4 章单独成章,读者要多翻 20 屏才能把它和第 1 章接上。
这不是吹毛求疵。一本讲"如何组织能力、避免重复"的书,自己在结构上出现了明显的重复,说明作者是按"知识点清单"来切章节的,不是按"读者的认知路径"来切的。清单式切法的问题在于:它保证每个知识点都被覆盖,但不保证它们以最省力的顺序出现。
三、三级加载:全书最硬的一段技术
第 3 章是全书技术密度最高的一章,27 屏。它讲清了一个很多人没想明白的问题:几百个技能,怎么可能同时"存在"于一个模型里?
答案是把加载拆成三级:
(1)Level-1:元数据层(始终加载)。仅包含 YAML 中的 name 和 description。这是 Agent 的"技能菜单"。模型仅通过约 100token 的简短描述来判断是否存在能解决用户问题的工具。该层常驻于系统提示词中。
(2)Level-2:指令层(按需触发)。SKILL.md 的 Markdown 正文(包含执行步骤、注意事项)。当用户的 Prompt 与 Level 1 的描述语义匹配时,Agent 主动发起 read 命令读取该文件(通常控制在 5000token 以内)。此时,具体的"操作手册"才正式进入上下文窗口。
(3)Level-3:资源与代码层(零上下文执行)。外部引用的 REFERENCE.md、数据文件或 scripts/ 目录下的 Python 脚本,仅在需要运行时被调用,其代码本身完全不进入上下文。这是 Claude Code 的核心优势所在。
这三行字的架构描述,解释了我开头那个失败的真正原因。我写的三千字在 Level-2,它压根没被加载过——因为 Level-1 那句描述没让模型觉得"这跟我有关"。
更值得注意的是它对上下文预算的处理方式。第 3.2.1 节讨论了"为什么不能一次性将所有技能塞进上下文",列了三条后果:紧耦合架构下,任何技能的增加、删除、修改都需要重新部署整个系统提示;系统能承载的技能数量存在硬性上限,受限于上下文窗口的总长度;以及随之而来的整体可靠性下降。
这三条其实说的是同一个意思:上下文不是"越大越好"的资源,是一笔要做预算的钱。花在技能描述上的每个 token,都是从"理解用户请求"的额度里扣的。所以 Level-1 只给 100 token,Level-2 卡在 5000 以内,Level-3 干脆零占用。
我在别的地方没见过这个思路被讲得这么清楚。大部分教程在教"怎么写出好提示词",这本书在教"怎么管住上下文这笔账"。前者是技巧,后者是工程。一个技能好不好用,八成取决于你有没有把它当成预算问题来设计。
四、成败在一百个 token:那句话是怎么写的
全书的芯在这里。第 6.1.1 节"路由优化设计:触发词与'短入口'技巧",加上第 8.1.1 节"触发失败归因",两节合起来不到十屏,但它们回答的是同一个问题:为什么你的技能不被调用。
作者给了一份可以直接对号入座的诊断:
模型在检索阶段仅扫描 Skills 的名称和简短描述。若描述过于抽象(如"数据分析工具"),则会被淹没在众多类似描述中;若描述过于具体(如"仅处理.xlsx 格式的第三季度报表"),则难以全面覆盖真实场景。
然后是一个我认为全书最有价值的案例:
以下介绍一个生活中的案例:某电商客服 Skills,原描述为"处理客户问题",响应率极低。经分析发现用户常问"物流到哪了""如何申请退款""售后电话多少"。将描述改为"查询订单物流状态、处理退款申请、提供售后联系方式"后,触发率提升至 90% 以上。
这个案例的价值不在于"90%"这个数字,而在于它给出了改写的方向:不是把描述写得更"专业",而是写得更"像用户会说的话"。
作者把方法总结成一个"场景化描述公式":核心功能 + 典型场景 + 用户话术。同一节里还给了三个例子,我最喜欢会议纪要那个——描述里要预判用户可能的请求方式,把"meeting minutes""summarize the call""会议记录""提取行动项""生成会谈摘要"都放进去,这样"无论是中文、英文,还是正式或口语化的请求,技能均可被准确触发"。
他还把 description 称为"一份面向模型的'意图翻译词典'"。这个说法很准。你写描述的时候,脑子里想的不是"我这个技能有多厉害",而是"用户会用多少种说法表达同一个需求"。
另一个实用技巧叫"短入口":Metadata(特别是 description 字段)里,严禁写入具体的操作步骤、实现细节或长——后面被截断了,但意思很清楚:路由层只放"我是什么、什么时候用我",操作细节全部下沉到 Level-2。这和我一开始犯的错正好相反。我把操作步骤全堆在了 skill 里(甚至想让描述承担一部分说明功能),结果两头都不对。
还有一个坑我踩过,书里也讲了——冲突消歧。当两个技能的描述都提到"数据分析"时,模型会困惑或随机选择。书里的解法是"物理隔离":不同技能的描述必须通过具体的领域限定来区隔,比如"处理Excel格式的销售数据"对"分析Log格式的系统日志"。如果同名,则按 Managed > Personal > Project 的优先级覆盖。
这段看完,我回想自己那三千字的 SKILL.md,明白了两件事:第一,描述里应该塞的是"用户的所有说法",不是"我的所有步骤";第二,如果我有两个技能都跟"文章排版"有关,我必须让它们的描述在第一句话就分出彼此。
五、约束模型按流程做事:清单、红线与熔断
第 3.3 节和第 6.3.2 节是这本书的"工程纪律"部分,我觉得比架构讲得更好,因为它不依赖任何模型能力的假设。
第 3.3 节的切入点是:大模型在处理开放式创作任务时能产出好句子,但在执行结构化、多步骤的确定性任务时,会出现注意力偏移、步骤遗漏或过度自由发挥。解法是引入流程约束。作者用了一个特别好懂的例子——教新手做佛跳墙,只说"做个佛跳墙"对方会手忙脚乱,但给一份任务清单就一目了然:
今天的任务清单:
1. 把干鲍鱼、海参泡发(需要8小时)
2. 将鸡肉、猪骨焯水去腥
3. 把食材按顺序放入炖盅
4. 小火慢炖6小时
5. 最后10分钟加入花胶
落地的技巧是"进度可视化":要求模型在执行任务前先显式列出执行步骤清单,并在每完成一步后在对话中标记该步骤为已完成状态(用 [√] 表示),使用户能够实时掌握任务进展。这个建议看起来很轻,但我在实际用的时候发现它改变的是"出错后能不能定位"——有清单,你一眼能看出卡在第 4 步;没清单,你只知道结果不对。
第 6.3.2 节的"反模式"两页,是我在全书上划得最重的地方。第一个反模式是无限重试:
❌ 反模式场景:指令设定为"如果脚本报错,请自动修正参数并重试"。若遇到的是 API 服务宕机等不可修复的错误,模型会陷入"报错-重试-报错"的无限循环,短短几分钟内即可耗尽账户余额或达到 token 使用上限。
✅ 规范对策:必须设置明确的熔断机制。例如"尝试修正参数并重试,最多重试3次。若第3次仍失败,必须停止执行,并向用户输出具体错误日志"。这相当于给模型安装了一个"保险丝",防止意外情况下的资源失控。
这段话值得背下来。因为"自动重试"是所有人写自动化脚本时的第一直觉,而它在 agent 场景里是纯粹的烧钱行为。模型不会"觉得该停了"——它只会照着你的指令再试一次。
第二个反模式是硬编码常量与模糊指令。书里举了两个例子:一是 `TIMEOUT=47` 不加注释,维护者不知道这 47 秒是基于网络延迟测算还是开发者随手定的;二是"请恰当地处理大文件"这类指令。
类似"请恰当地处理大文件"的模糊指令同样危险,这种指令对于逻辑严密的计算机系统而言,"恰当"是一个无法量化的概念,可能导致模型在删除文件与压缩文件之间产生不可控的随机行为。
"不可控的随机行为"这七个字很重。它说的不是"效果差一点",是"同一份指令,今天删文件、明天压文件"。在个人玩具项目里这最多是烦人,在生产流水线里这就是事故。
六、Skills 与 MCP:一个比喻讲清了,花了 19 屏
第 4 章的核心就一句话:Skills 是菜谱,MCP 是厨具。菜谱管"该怎么做",厨具管"能做什么"。
这个分工一旦想通,很多设计问题就迎刃而解。书里给了个周报自动化的例子,把两者串成一条线:Skills 按预定义 SOP 依次调用 GoogleCalendar:read_events 读本周日程、Jira:search_issues 查已关闭任务单、GitHub:list_commits 取提交记录、TemplateEngine:render 填进固定模板、最后 Email:send 发给团队。
五个 MCP 工具,一个 Skills 编排。工具是可替换的(换成飞书日历也行),流程是资产(是你们团队的工作方式)。这才是"SOP 说明书 + 万能工具箱"这个比喻真正想说的话:能被复用的是流程,不是工具。
但这一章花了 19 屏。说实话,一页纸就够。它甚至专门用一节(4.1.3)解释"为什么两者会被混淆"——原因大家都知道,因为名字都带点"能力"的意思,且都是给模型扩展功能的手段。这个解释有价值,但它不需要三屏。
七、实战两章:119 屏,能照抄的比能读懂的多
第 9、10 章是这本书区别于"概念书"的地方。我挑两处说。
第一处是"确定性计算"的思路。第 9.2.2 节讲为什么要给 agent 装一个"业务计算插件"——也就是把计算逻辑固化成脚本,而不是让模型自己算。理由有三条:
(1)精度隔离:Agent 在处理数值计算时,常出现"百分点"和"百分比"的混淆、分母为零的情况,以及四舍五入不规范等问题,直接影响财务报告的严谨性。通过将计算逻辑固化于脚本,可确保数值处理的精确性与一致性。
(2)逻辑复用:增长率(Growth Rate)和偏离度(Gap Analysis)相关的算法在损益分析、用户留存等不同场景中具有通用性。将计算逻辑封装成独立模块可避免重复实现,提升开发效率。
(3)上下文负载优化:复杂的计算过程(如加权平均、多级分摊)在脚本内部静默完成。Agent 只需要接收最终的结构化结果(JSON),这极大地降低了 token 消耗量,避免了长文本带来的推理疲劳和逻辑错乱,显著提升了报告生成的响应速度。
第二条和第三条我完全同意,第一条是我认为最容易被忽略、后果最严重的一条。"百分点"和"百分比"的混淆,是所有 AI 做财务分析的死穴。一篇经营分析报告里如果出现了"毛利率提升了 3%",你需要判断这是 3 个百分点还是 3% 的相对增幅——这两者在业务上差着一个量级。而模型不知道你关心哪个,它会选读起来更顺的那个。
把这个逻辑写成脚本,等于把"我不会算错"这件事从"希望"变成了"保证"。这是这本书里最工程师的一个判断,也是最该被抄走的一条。
第二处是测试用例的写法。第 8.3.1 节讲单元测试集,给了三个用例类型:正常路径、边界条件、资源缺失。我最欣赏的是它对"预期输出"的写法——不写"应该正确处理",而是写出具体的、可核对的话术:
用例A(无效输入):输入"处理这个名为 'test.xyz' 的文件。"(提供不支持的格式)。预期:Skills 返回明确的错误信息(如"抱歉,目前仅支持处理 .pdf、.docx 和 .csv 格式的文件。暂不支持您提供的 '.xyz' 格式。"),而非 Python 的 UnsupportedFormatError 堆栈痕迹。
用例B(问题数据):输入"分析这份财务报表,其中有些数字是乱码。"预期:Skills 应能识别数据质量问题,并输出提示(如"检测到第5行 'Revenue' 列存在非数字字符 'N/A',已跳过该行进行计算。建议清理数据源以获取更准确的结果。")。
这两个预期写得非常好,因为它们定义了"用户体验"而不是"功能正确"。同样报错,一个给 Python 堆栈,一个给"暂不支持 .xyz 格式",用户的感受完全不同。"错误提示是产品的一部分"这个道理,在 agent 时代被重新提了一次。
第 10 章的"金标准验证集"也有价值,尤其它讲了一个别人很少讲的点:验证集不能是静态的死数据,必须建动态演进机制——把 tests/gold_standard/ 纳入 Git 版本管理,每次评估报告可追溯至具体标准版本;定期从生产环境的"低置信度"数据中筛选新写法、新术语或罕见病案,经专家标注后追加;当临床指南变更(如高血压诊断阈值调整)时,优先更新规则文件与金标准,再触发全量回归测试。
这段是医疗场景的写法,但方法论可以搬到任何领域:标准会变,所以标准本身要有版本。很多人的评测集建完就不动了,半年后它测的是半年前的世界。
八、它的短板
这本书的短板,我认为集中在五处。
第一,前四章该砍一半。88 屏反复论证"大提示词不行",一个论点到第三遍就成了噪音。第 4 章完全可以并进第 1 章,第 2 章的"省 token、可复用、可治理"在第 1 章已经埋了伏笔。如果按"读者最省力的认知顺序"重排,前四章压到 40 屏是能做到的,省下来的 48 屏可以给第 11 章——那一章更需要篇幅(后面会说)。
第二,实战章像代码库,不像教程。第 9、10 章 119 屏里,有大量目录树、SKILL.md 全文、脚本片段。这些内容作为"可抄的素材"很有价值,但作为"连续阅读"体验很差——你可能连着翻五六屏都在看一段 YAML。更麻烦的是,这些片段之间的"为什么这么改"讲得不够。比如同一个 SKILL.md,如果先给一个错误版本、再给正确版本、再解释差在哪,学到的东西会比"直接给正确版本"多一倍。
第三,第 11 章存在概念滑移。24 屏讲 Trae、Cursor、Coze 三个平台。前两个没问题,它们确实支持 Skills 机制。但 Coze 那一节(11.3,大约 6 屏)讲的其实是"插件"与"工作流",这是 Coze 自己的概念体系,和 Claude Code 那套 SKILL.md + 渐进式披露不是一回事。把它们并称为"Skills 在其他平台的实践",会让读者误以为这是同一套标准。实际上到目前为止,Skills 更像一个厂商定义的机制,还不是跨平台的通用规范。
第四,缺失败复盘。全书有大量的"应该这样做",但只有电梯客服那一个"改前 / 改后"的对比。读者最想知道的其实是另一半:那些写了却没被调用的技能,到底错在哪?我在第 8 章看到一张日志截图(图 8-1),上面清清楚楚写着"Claude code 未使用 Skill"——这说明作者手里是有真实失败记录的。但他只用了这一张,没有把它展开成一个完整的归因案例。
如果有一节叫"我写了 30 个技能,18 个从没被触发过",把 18 个失败描述逐个剖开,那会是全书最有价值的一节。没有。
第五,全书几乎没有成本数据。Level-3 沙箱、批处理流水线、回归测试、全量评估——这些都要花钱。但书里几乎没有"跑一次要多少钱 / 多少 token / 多少分钟"的数字。只有 Level-1 那句"约 100token"和 Level-2 的"5000token 以内"给了量化。对一个要在企业里落地这套东西的读者来说,成本是最先要回答的问题,而这本书把它留白了。
九、这本书该怎么用
我给三种用法,按投入时间从少到多排。
第一种,只读四节,两小时。第 3.2 节(渐进式披露三级加载)、第 6.1.1 节(触发词与短入口)、第 8.1.1 节(触发失败归因)、第 6.3.2 节(反模式)。这四节加起来不到 20 屏,但它们覆盖了 90% 的实战问题:怎么让技能被看到、怎么让它被选中、怎么在没被选中时查原因、怎么不让它闯祸。如果你只是想在 Claude Code 里写几个自用技能,读完这四节就可以动手了。
第二种,照抄一遍第 9 章,一个周末。挑一个你自己每周都要做的重复劳动(周报、月报、数据汇总、竞品抓取),按第 9 章的顺序走一遍:先定义数据源全景,再定指标口径,然后把计算固化成脚本,再用 SOP 编排,最后模板渲染。走完这一遍,你对 Skills 的理解会超过读十遍前四章。
第三种,把第 8 章当上线检查表。如果你要把技能推到团队里用,第 8 章那 35 屏(调试、安全红线、测试评测)是唯一的"上线前必查项"清单。特别是 8.2 节的安全部分:防御性提示词、敏感信息脱敏与权限隔离、输入输出审核——这三样在个人使用时可以忽略,在团队使用时一样都不能少。
最后说一句我读完最真实的感受。这本书教我最重要的东西,不是"怎么写 SKILL.md",而是"把能力当资产来管理"这个视角。
提示词是一次性的:你写完、用完、下次重写。技能是可积累的:你写一次,团队里所有人都在用;你改一次,所有人下次都用新的。前者的天花板是你的打字速度,后者的天花板是团队的认知水平。而这两者的分界线,就是那句一百个 token 的描述——写清楚了,你的经验就成了资产;写含糊了,它就只是一堆没人调用的文件。
阅读记录
书名:Agent Skills开发实战
作者:未来智能实验室 代晶 出版社:人民邮电出版社 出版时间:2026-08-01 ISBN:9787115699008
本次阅读:微信读书逐页截图 347 屏,覆盖版权页至第 11 章末(147 个章节标记,含 11 章正文与全部小节),抓取标记为全书读完(end=last_page),耗时 241 秒
说明:本文字数与引句均来自实际截图;凡标"我的判断/我认为"的段落为主观评论,与书中观点无关
逐页精读系列 · 2026 年 11 月
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: