
《全员动手》:讲的是技术平权,写的是 IT 治理
微信读书《全员动手:AI 时代的组织再造与技术平权》(托马斯·H. 达文波特、伊恩·巴尔金、蔡斯·达文波特 著)· 本次逐页翻阅 326 屏,从版权页读到致谢,五部分 17 章加三个附录全部覆盖,抓取标记为全书读完(end=last_page),耗时 773 秒。
说明:这是一本写给企业管理者的书,核心概念是「公民开发者」——不靠 IT 部门、自己动手做技术工具的业务人员。我读它不是为了学怎么推行这套东西,是想看它怎么论证「技术平权」这四个字。本篇不复述目录,只写我逐页读下来的判断;加引号的话都能在截图里逐字核对。
这本书有一句话,我看的时候在页边画了个圈,看完之后又回来划掉了半个圈。
它在第 8 章,「公民开发倡导者与高层支持」,原文是这样:
公民开发倡导者应努力争取高层支持,即便暂时无法获得支持,也不应轻易放弃。虽然我们尚未进行统计分析,但从实际情况来看,高层管理人员如果能提供资源和精神支持,公民开发项目的成功概率会大得多。
「虽然我们尚未进行统计分析,但从实际情况来看」——这句话,是一本管理咨询书的诚实,也是它的天花板。
诚实在于:三位作者(其中托马斯·H. 达文波特是管理学领域引用量极高的学者)完全可以写「研究表明」,但他们没有,他们老实说了自己没做统计。
天花板在于:一本 326 屏、讲「组织再造」的书,核心论断之一居然停在「从实际情况来看」。也就是说,这本书的论证方式,本质上是三位资深顾问把他们见过的几十家企业归纳了一遍,然后请你相信他们的归纳。
这不是一本坏书。它有真材料、有真案例、有几段写得相当漂亮。但它是一本「顾问之书」,不是一本「研究者之书」——这个区别,决定了你该怎么读它。
一、先量一下这 326 屏:它是怎么分配的
我按每章起始页相减,把全书 326 屏的分配算了一遍:
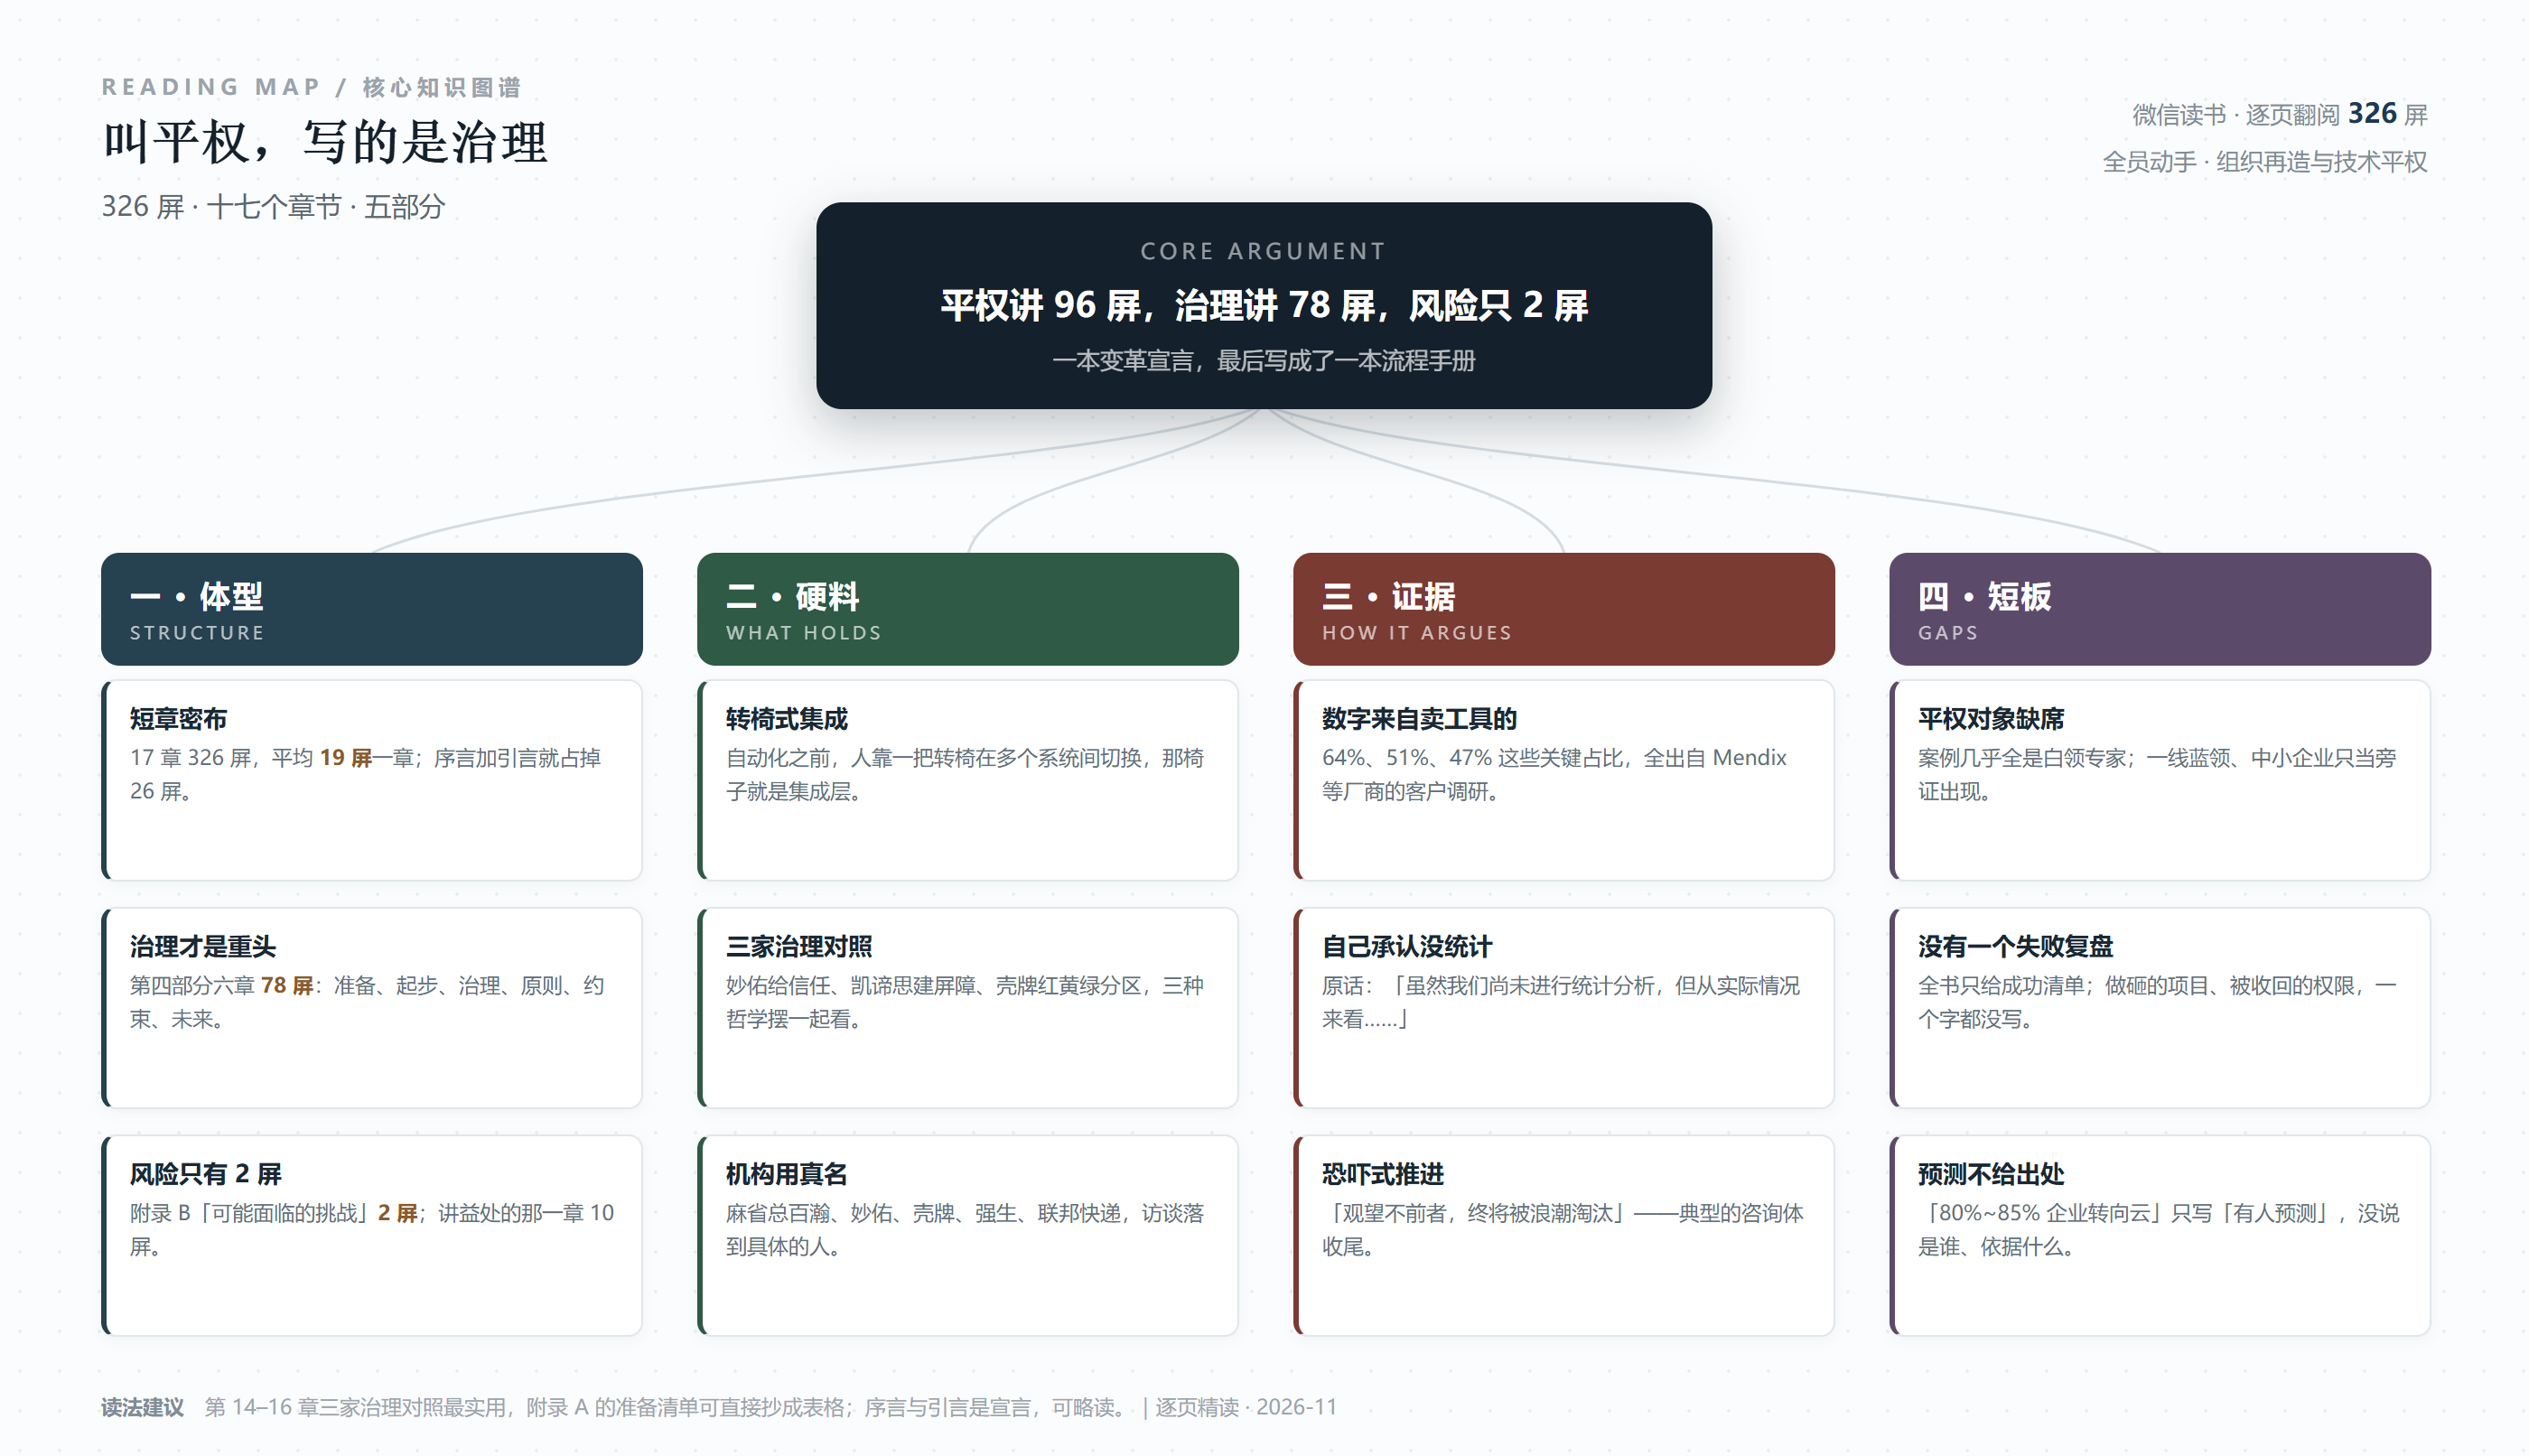
前置部分(版权、序言、引言)28 屏,占 8.6%;第一部分「背景、历史和发展脉络」3 章 54 屏,占 16.6%;第二部分「公民参与」5 章 96 屏,占 29.4%;第三部分「着手实践」3 章 48 屏,占 14.7%;第四部分「扬帆起航」6 章 78 屏,占 23.9%;第五部分「附录」21 屏,占 6.4%。
17 章摊在 326 屏上,平均一章 19 屏。这个体量很说明问题:一章 19 屏,按一屏 600 字算,一万一千字左右。一万字讲一个管理主题——「公民自动化」「公民数据科学」「治理」——刚好够把框架摆出来加两三个案例,不够把一个机制拆开揉碎。
还有两个数字我特意数了:
第一,讲益处的那一章 10 屏,讲风险的附录 2 屏。第 10 章「公民开发的益处」201 页起,10 屏;而「附录 B 企业可能面临的公民开发挑战」318 页起,2 屏——其中还包括一个章节扉页。
第二,治理三章加起来 35 屏,占 10.7%。第 14 章治理 15 屏、第 15 章指导原则 12 屏、第 16 章约束机制 8 屏。「约束机制」是全书最短的正文章节,8 屏。
这两个数字摆在一起,就是这本书的真实优先级:它更愿意讲这套东西多有用,不太愿意讲它会怎么坏。
二、它真正在讲的东西:三种「公民」
先把概念说清楚,因为这本书的整个论证都架在这个词上。
「公民开发者」(citizen developer)指的是:不在 IT 部门、没有受过正规软件开发训练,但借助低代码/无代码工具、自动化平台或数据分析工具,自己动手解决业务问题的员工。书里把它拆成三种形态,分别对应第 4、5、6 章:
公民开发——用低代码/无代码工具搭应用。作者引了西门子 Mendix 的调研数据:64% 的 IT 专业人员认可低代码作为开发解决方案,33% 的人曾用它构建关键业务应用,并估计超过一半(51%)的日常工作开发可通过低代码平台完成;参与调研的 IT 专业人员表示,59% 的低代码项目由 IT 部门和业务部门协作完成。2023 年的用户调研里,85% 的用户在 IT 部门的团队中工作,47% 参与「融合团队」。
公民自动化——用 RPA 一类的工具把重复流程自动化。这一章的历史讲得不错,我下面单独说。
公民数据科学——业务人员自己建模、自己分析。这一章有一段访谈,是我在全书里最认同的一段。
第 125 屏,作者引了一位大型银行投资组合管理与信贷策略总监的话:
我们把技术交予业务人员——那些真正理解客户行为动机的人。以往我常招聘本科毕业生并培养他们的数据科学技能。但有了自动化机器学习,你并不需要深入了解技术或编程,它为具备一定定量化思维的人赋予了超能力。我倾向于技术民主化,因此我为非专业数据科学家开发的系统设立了严格的治理和审批流程。我鼓励全员探索,但对部署实行严格管控。
这段话里有一组我认为全书最有价值的张力:「技术民主化」和「严格管控」被同一个人、在同一段话里同时主张,而且他自己不觉得矛盾。
为什么不矛盾?因为他讲的是「探索民主化、部署集权化」——谁都可以动手试,但上线必须过我这一关。这个区分我认为是对的,而且是这本书最实用的一条经验。可惜的是,作者没有把它提炼成原则,只是把它当成一段访谈放在那里。
这位总监还补了一句很硬的判断:「银行的其他部门正在努力招聘数据科学家,但由于缺乏业务理解能力,这些人才并未产生预期价值。所以我坚定地站在公民数据科学家这一边。我称他们为『跨界人才』,因为他们具备深厚的业务认知与足够的技术和统计素养。」
这句话如果被 HR 部门看到,可能会不太舒服。但它说出了「公民开发」真正的竞争力所在:不是技术便宜,是业务理解贵。
第 2 章还做了一件事:把「公民开发」和「开源软件」摆在一起比。作者列了四条区别——开源开发者通常是专业人士,公民开发者恰恰是业余的;开源代码面向更广阔的世界,公民开发的成果仅供组织内部使用;开源代码常在远离创建者的地方使用,所以必须有完善的文档,而公民开发多供本地同事使用,「因此即使文档不完善,仍然可以发挥作用」。
然后作者下了一个结论:「既然组织能接受难以联系的外部人员开发的开源软件,那么采用自家员工(即便不是专职 IT 人员)开发的技术,风险显然更可控。我们认为确实如此。」
这个推论我不认同,而且我认为它的方向是反的。
开源之所以「风险可接受」,不是因为它来自内部,恰恰因为它来自外部——它被无数陌生人读过、fork 过、在生产环境里跑过、漏洞被公开披露过。它的安全性来自外部审查者的数量,不来自管理者对开发者的信任。而公民开发的应用正好相反:只服务本地同事,没有外部读者,文档可以不完善,出了问题也没人会写一篇 CVE 通报。
所以「内部人员开发,所以更可控」这句话,把「可控」和「可信」混为一谈了。管理者能看见它,不代表它能被检验。这本书后面花了 35 屏讲治理,其实就是在补这个洞——但它没有回头修正第 2 章那个太顺的类比。
三、全书最漂亮的一段:转椅式集成
如果这本书只能留一段,我留第 5 章讲「公民自动化」前史的那几屏。
它先讲自动化的来历:交付中心为了效率,在物理环境上做了很多优化——多加几台显示器、换更好的椅子、优化平面布局。然后给出了一个我读完之后反复回味的说法:
外包工作几乎都是重复性的,需要人员在众多系统间来回操作。在访问、复制、粘贴及执行交易的过程中,反复启闭客户应用程序构成了任务主体……每位操作员配备多台显示器,正是为了尽可能高效地在应用程序间切换。
而转椅象征了在多个系统间切换、同时查看多块屏幕的工作方式。这种由托马斯·杰斐逊于 1775 年发明的简单办公椅,其旋转功能让人可以快速转动视线而无须扭动颈部。转椅已深深融入操作传统,以至于交付中心的工作获得了「转椅式集成」的称号——通过屏幕和转椅「自动化」地连接各个孤立系统。
「转椅式集成」——这个词是全书最好的一处洞察。
它说明了一件事:在软件能互相说话之前,人类自己就是那个集成层。系统之间不连通,于是雇一个人,配两块屏、一把能转的椅子,让他每天在系统之间搬运数据。所谓「数字化转型」,很多时候就是把这件事交给机器去做。
我喜欢这段,是因为它把「自动化」从一个技术词变成了一个人力词:自动化不是让机器变聪明,是把人从「人肉接口」的位置上换下来。这个视角比任何一张 RPA 架构图都有解释力。
顺着这条线,书里还给了时间锚点:直到 2012 年,大规模自动化能补充甚至取代这类交付中心的理念才真正出现——HFS Research 与早期 RPA 供应商 Blue Prism 联合发布的白皮书《来自 Robotistan 的问候》。
顺便说一句:这本书引的关键文献,不少是「某某厂商 + 某某研究机构」的联合白皮书。这一点我在短板里还会说。
四、第四部分才是这本书的骨头:三种治理哲学
如果让我给这本书排一个「值得读的顺序」,第四部分排第一,第二部分排第二,序言排最后。
第四部分 78 屏,六章:准备启航、起步、治理、指导原则、约束机制、未来。其中第 14–16 章是全书的实用核心。它做的事很聪明:不是给一套标准答案,而是摆了三种截然不同的治理哲学,让你自己对照。
第一种,信任型:妙佑医疗国际(Mayo Clinic)。书里写他们的「AI 赋能计划」从严格的数据素养课程起步,为业务领域专家提供咨询服务、法律支持,业务领域专家最终甚至可获得医学人工智能学位。公民开发者要构建解决方案,得先与 AI 赋能团队沟通,团队会在工具使用、数据处理和合规要求方面全程指导。妙佑也有自动化机制——公民开发者使用受监管数据时会触发警报——但主要依靠公民开发者自身的判断与管理能力。
书里引了阿贾伊·塞加尔的一句话,我认为是全书对「数据风险」说得最狠的一句:「即使你用 AI 来总结电子邮件都可能让你惹上麻烦。」
第二种,屏障型:凯谛思。书里把它叫「保护者」,做法是建「保护性屏障」——几乎不设融合团队的概念,公民开发者需要相对独立地开展工作,但同时被屏障圈在安全边界内。作者说这种东西会在第 15 章「指导原则」里重点介绍。
第三种,分区型:壳牌。用「红、黄、绿」三色给公民开发的应用分类治理:绿灯放行、黄灯需审批、红灯禁止。作者对这个模式评价很高,说「很不错」,并在第 14–16 章反复引用。
这三种摆在一起,价值就出来了:治理不是一个「严不严」的刻度,是一个「你把信任放在哪儿」的选择。妙佑把信任放在人的专业素养上(所以配学位课程),凯谛思把信任放在边界上(所以建屏障),壳牌把信任放在分类规则上(所以分红黄绿)。三种都能跑,前提是组织的文化与它匹配。
这一段是我认为这本书真正超过一般「数字化转型」读物的地方:它承认没有唯一答案,并且用具体机构把三种答案摆出来了。
不过第 7 章值得单独说一句,因为它是全书最长的一章(26 屏,占 8%),标题叫「公民开发者的技能与特质」。我原以为会读到一套能力模型——什么人适合做公民开发者、怎么识别、怎么培养。实际读到的更多是「怎么把这件事推动起来」:努力争取高层支持、建立应用分类体系、从经济效益角度展示价值、把倡导者当成「邮轮上的社交主管」——通过面对面活动、网络研讨会、黑客马拉松、新闻通讯、Slack 频道、一对一交流,让公民开发者互相认识、交换想法。
「邮轮上的社交主管」这个比喻很传神,但它讲的是推动者的角色,不是开发者的能力。一章 26 屏,关于「什么样的人学得会」着墨很少,关于「怎么搞活动、怎么向上汇报」着墨很多。这又一次印证了这本书的底色:它是一本写给「要推动这件事的人」的书,不是写给「要成为这种人的人」的书。
五、「平权」这个词,在书里指的其实是一批白领专家
现在说这本书最让我不舒服的地方。
书名叫《全员动手:AI 时代的组织再造与技术平权》。「全员」和「平权」两个词,许诺的是一种扩散:技术能力从少数专家手里流动到更多人手里,那些原本没有资格碰技术的人,也能自己解决问题。
但我把书里的案例人物列了一遍:
杰伊·克罗茨——能源巨头的管理者,推动自主开发项目,「我们已在全球范围内取得了多点突破」;本杰明·伯科威茨——波士顿儿童医院财务分析师出身,后转至麻省总百瀚(年营收近 190 亿美元),本科主修历史与心理学,MBA,正在攻读管理与组织行为学博士;大型银行的投资组合管理与信贷策略总监;妙佑医疗国际的业务领域专家(可获得医学人工智能学位);强生、壳牌、联邦快递……
这些人不是「被平权」的人,他们本来就是组织里的精英。他们有 MBA、有博士学位、有预算权、有跨部门话语权,其中好几位还专门去修了数据科学的课程。他们缺的从来不是能力,是 IT 部门的排期。
书里第 1 章讲得很清楚,公民开发之所以兴起,一半靠工具变简单,一半靠「业务部门对 IT 项目积压和开发效率低下的不满」——2021 年某公民技术供应商对约 1000 名业务决策者的调查显示,IT 项目的平均积压周期达 3~12 个月。所以这批人绕过 IT 自己干,本质上是一次组织内部的效率越权,不是一次能力平权。
真正的「平权」应该长什么样?我想看到的是:工厂的班组长、门店的店长、仓库的调度员、小公司的会计——那些既没有 MBA 也没有数据分析学位、但在自己的岗位上比谁都懂业务的人,用工具把自己手上的活变轻了。
这本书里有这样的人吗?我翻完 326 屏,找不到一个具体的一线蓝领案例。所有有名有姓的人,头衔都在「总监」「首席」「负责人」这一层。
这不是吹毛求疵。「平权」如果只发生在已经有权的人身上,它的名字应该叫「授权」。而授权和赋权是两件不同的事:授权是把权力往下发一层,赋权是让原本没有权力的人长出权力。这本书讲的是前者,书名写的是后者。
六、它的短板
四条,按我认为的严重程度排。
第一,证据链的上游是卖工具的人。这本书里几乎所有量化结论都来自厂商调研:Mendix 的 64%、51%、59%,Unqork 的定位,Blue Prism 与 HFS Research 的联合白皮书。厂商做的客户调研有一个天然偏差:受访者是已经在用(或准备用)该厂商产品的人,他们本来就更认可这套东西。作者引用时没有讨论这个偏差,也没有给出任何一组独立第三方的对照数据。加上前面那句「虽然我们尚未进行统计分析」,这本书的实证基础可以说是「案例归纳 + 厂商数据」,而不是「研究证据」。
第二,风险被放进了附录的角落。第 10 章「公民开发的益处」10 屏,附录 B「企业可能面临的公民开发挑战」2 屏——还包括扉页。这个比例不用多解释。更关键的是,那 2 屏讲的挑战是清单式的(影子 IT、数据泄露、维护负担、供应商锁定之类),没有一个是带着案例展开的。一本讲「全员动手」的书,最该写厚的一章是「动手之后怎么收拾」,它写成了两页纸。
第三,没有一个失败复盘。我数了一下,书里出现的机构全部是「做成了」的:麻省总百瀚做成了,妙佑做成了,壳牌做成了,强生试过评估价值,也做成了。没有一家企业被写到「我们推了两年,最后收回了所有人的开发权限」。而这个结局在现实里极其常见——公民开发最大的问题从来不是做不出来,是做出来一堆没人维护、没人知道、辞职就失传的小应用。这本书对这个结局一个字都没写。
第四,预测不给出处,而且有点旧。第 17 章「公民开发的未来」里写:「有人员预测,到 2025 年,80%~85% 的企业将……转移到云端。」——「有人员预测」,没说是谁、什么机构、基于什么样本。同一章还预测 IT 部门人数将大幅减少、留存员工「从开发转向辅导与评估」。这些判断方向也许对,但论证强度跟前面那 300 页一样:靠三位作者的阅历。
顺带说一句,第 17 章有一处自嘲我挺喜欢。作者写「如果我们是 CIO(不过我们并不是,毕竟该职位责任重大且面临诸多挑战),我们将着手规划一个员工数量大幅减少的 IT 部门」——这句括号里的坦白,是全书最有人味的地方。它至少承认了:说别人该怎么干,比自己干容易。
还有一点必须提:书名叫「AI 时代」,但书的主体是低代码 + RPA + 自助分析,生成式 AI 基本只作背景出现(第 1 章提到 2022 年底生成式 AI 的爆发加速了技术民主化;第 17 章提到 AI 可能辅助 IT 支持服务)。如果你是想找「大模型怎么改变企业开发」,这本书给不了。它的时间坐标更像是 2019–2022 年。
七、怎么读这本书
三种读法。
第一种,你是要落地的人(IT 负责人、数字化负责人、业务线主管)。直接读第 14–16 章,35 屏,看三家治理哲学怎么摆。然后把附录 A「公民开发准备清单」11 屏抄成一张表,改成你公司的版本——那是全书最可以直接用的东西。序言和引言可以跳过,它们是写给还没被说服的人看的。
第二种,你是被这套东西推着走的人(业务骨干、被要求「自己做个工具」的员工)。读第 5 章「转椅式集成」那几屏,再读第 6 章那位银行总监的访谈。前者让你明白自动化到底在替代什么,后者给你一句可以拿去跟老板谈条件的话:探索可以放开,部署必须过审。
第三种,你是研究者或者想认真评估这套说法的人。把这本书当成一份「业界观点样本」读,而不是「证据」。它的价值在于告诉你大企业在想什么、顾问在卖什么;它的局限在于所有数据都来自生态内部。要判断「公民开发到底有没有效」,这本书给不了答案,只能给你一套假设。
最后说一句我的整体判断。
这本书我读得比预期慢,因为它不难读,但需要不断在心里做减法:把「我们认为」减掉,把厂商数据减掉,把成功案例的幸存者偏差减掉,剩下的东西才是真的。减完之后,我认为它剩下三样:
一是「转椅式集成」这个洞察——它把自动化讲成了人的位置问题,这个说法我能记很久。
二是「探索民主化、部署集权化」这条经验——虽然作者没提炼,但那位银行总监一句话就把它说透了。
三是三种治理哲学并置的写法——不给你标准答案,给你三个已经跑起来的样本。这在管理书里是难得的克制。
至于「技术平权」——这本书证明了大企业里的一批聪明人可以绕过 IT 自己干活,但它没有证明「全员」能动上手。前者是效率问题,后者是权力问题。一本书把效率问题写透了,就已经有用;但如果它用「平权」这个词来卖,读者有权要求它把权力那部分也写出来。
它没写。这是这本书最大的空白,也是它最值得被批评的地方。
阅读记录
书名:全员动手:AI 时代的组织再造与技术平权
作者:托马斯·H. 达文波特、伊恩·巴尔金、蔡斯·达文波特
本次阅读:微信读书逐页截图 326 屏,覆盖版权页至致谢,五部分 17 章 + 附录 A/B/C 全部覆盖,抓取标记为全书读完(end=last_page),耗时 773 秒
篇幅分配(按起始页相减):前置 28 屏 / 第一部分 54 屏 / 第二部分 96 屏 / 第三部分 48 屏 / 第四部分 78 屏 / 附录 21 屏;17 章平均 19 屏一章
说明:本文引句均来自本次截图,可逐字核对;书中数据(64%、51%、47%、80%~85% 等)为原文引用,我未做二次核实,其来源偏差正是本文指出的问题之一
逐页精读系列 · 2026 年 11 月
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: