
《心智的10大模型》:故事在前,方程在后,中间没有路
微信读书《心智的 10 大模型》([美] 格蕾丝·林赛 著)· 本次逐页翻阅 411 屏,从版权页读到译者后记,两篇推荐序、引言、10 章、结语、附录全部覆盖,抓取标记为全书读完(end=last_page),耗时 310 秒。
说明:这是一本讲计算神经科学的书——用数学和工程模型去解释大脑怎么工作。我读它不是为了学会建模,是想看它有没有把「模型」和「大脑」的关系讲清楚。本篇不复述目录,只写我逐页读下来的判断;加引号的话都能在截图里核对。
这本书有一种很少见的诚实,藏在一个位置上:附录。
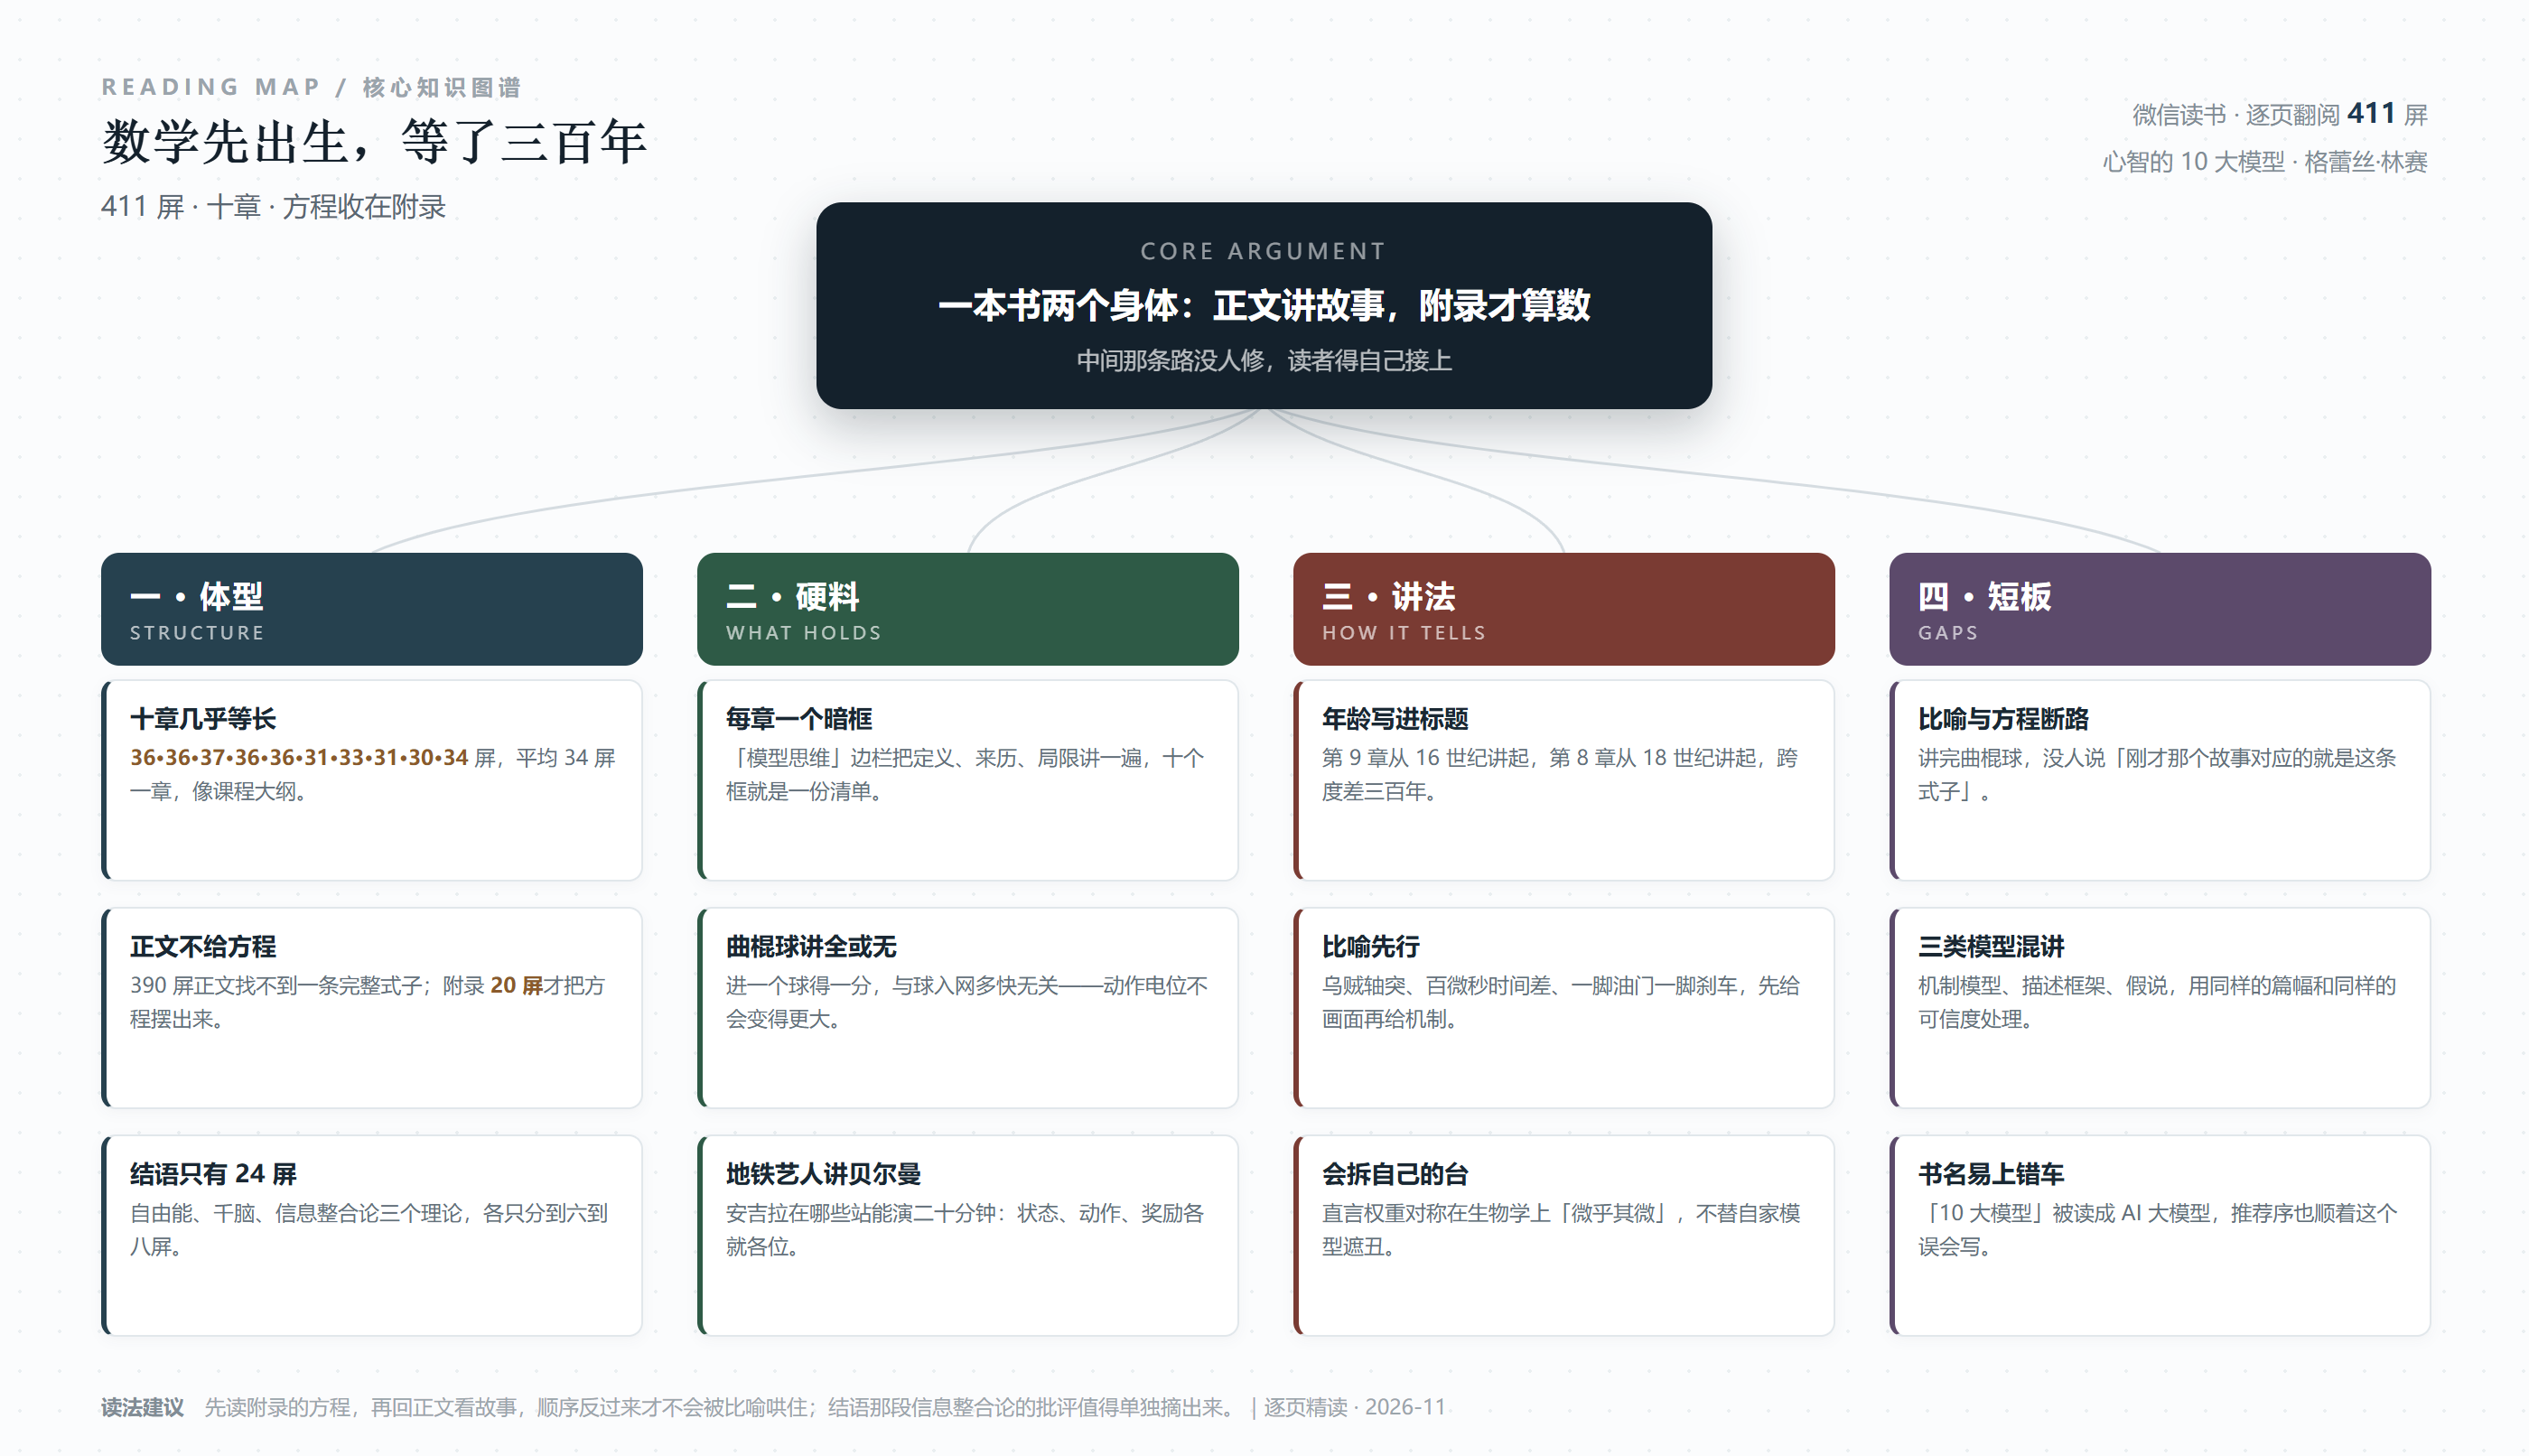
正文 390 屏,几乎没有一条完整的方程式。作者讲「带泄漏整合发放模型」的时候,用的是曲棍球:神经元要么发放动作电位,要么不发放,「不管我们怎样猛烈地刺激神经元,动作电位都不可能变得更大更强,这就像是在曲棍球比赛中,进一个球就得一分,而无关球入网时的速度有多快」。讲贝尔曼方程的时候,用的是纽约地铁里拉小提琴的街头艺人安吉拉——她在哪一站演、下一步去哪、哪站城管会来赶她。
然后到第 391 屏,附录开头,第一条方程就出来了:细胞膜电压 V(t) 由电阻 R 和电容 C 共同决定,时间常数 τ=RC;当电压达到阈值时重置为静息电位,V(t)=V_rest。
读到这里我愣了一下。原来正文那些漂亮的比喻,背后都站着一个可以算的式子,只是作者把它们全锁在了最后二十页。
这个安排不是偷懒,是一个取舍。但我要说,它是这本书最值得讨论的地方——因为它决定了一件事:你读完正文,会觉得自己懂了;等你翻到附录,才知道自己懂的是比喻。
一、一本书的两个身体:390 屏故事,20 屏方程
先给数据。411 屏的分配是这样的:两篇推荐序 8 屏,引言 12 屏,10 章正文 340 屏,结语 24 屏,附录 20 屏,其余版权与后记 7 屏。
十章的长度几乎是量产的:36、36、37、36、36、31、33、31、30、34 屏。平均数 34,最大最小差 7 屏。这个整齐度说明它有一个严格的课程结构——每章 6 个小节,每节 5 到 6 屏,最后收在一个「模型思维」的框里。
那个框是全书最稳定的设计:每章都有一处深色底的边栏,标题就叫「模型思维」,用几百字把这个模型的定义、来历、局限说一遍。第 1 章讲 LIF 的那个框,把「带泄漏」「整合」「发放」三个词拆开解释——「带泄漏」是指模型中存在电阻,所以有一部分电流漏走了;「整合」是指神经元类似电容器,整合了剩下的输入电流;「发放」是因为跨膜电压达到阈值时会「放出」一个动作电位。
这是全书最好用的部分。你只要把这十个框抄下来,就能得到一张计算神经科学的模型清单。不夸张地说,这十个框的价值超过正文。
顺带说一个我觉得不太舒服的地方:正文前面的两篇推荐序,读起来跟正文不是一个立场。推荐序一的标题叫「如何再造一个硅基大脑」,内容是把书里的模型挨个翻译成 AI 视角——多层前向神经网络是「感知机」,卷积网络是「模仿视觉大脑」,循环网络是「模仿海马体」,最后给了「顶天立地的英雄」这种评价。
这个框架当然没错,AI 确实从这些模型里借了很多东西。但它跟作者本人的谨慎正好相反:作者在结语里反复说「不存在一个有关大脑功能的大统一理论」,推荐序却在暗示「把这些模型凑齐就能造一个大脑」。两篇推荐序 8 屏,是这本书里唯一一处把「模型」说得比作者自己更硬的地方。读的时候建议先跳过,读完结语再回来看,你会看出那个缝隙。
而附录二十屏做的事更直接:把十个模型的方程逐个写出来。第 2 章感知机的分类方程、权重更新规则 w_n ← w_n + λ(y*−y(x))x_n,第 1 章的 LIF 方程,都在这里。附录是这本书的第二个身体:正文那个会讲故事,附录这个会算数。
问题是,两个身体之间没有血管。正文的曲棍球和附录的 τ=RC 之间,隔了三百多屏,中间没有任何一处说「刚才那个比喻,写成公式就是这样」。读者要自己把这两件事接上。
二、它凭什么值得读:每章都是一次两个领域的对撞
这本书真正的写法,是拿一个数学工具和一个脑科学发现对撞,看能撞出什么。
第 1 章的对撞是电路学 × 神经元。故事从莱顿瓶和青蛙腿讲起,讲欧姆定律怎么被搬到细胞膜上,讲乌贼的巨大轴突为什么成了最好的实验材料(因为它的轴突粗到可以把电极插进去)。然后是霍奇金和赫胥黎的动作电位模型,再往后是电缆理论——树突不是被动的导线,它是一枚有用的齿轮。
这一章的漂亮之处在于它承认了一件事:神经科学最早的方法论,是从电报和电路那儿借来的。19 世纪研究神经的人,手边能用的最好模型就是电报线缆。所以「神经元是一段带电容的电缆」这个说法,一半是发现,一半是时代的技术隐喻。
还有一个细节我读的时候留意到了:每章标题后面都跟着一个年代区间,而这些区间长得很不整齐。第 1 章「19 世纪 20 年代至 21 世纪 10 年代」,第 2 章「17 世纪 70 年代至 20 世纪 70 年代」,第 8 章图论「18 世纪 30 年代至 21 世纪 10 年代」,第 9 章贝叶斯「16 世纪至 19 世纪 10 年代」,第 10 章强化学习「20 世纪 50 年代至 20 世纪 70 年代」。
这些数字合起来,其实藏了一条全书没说出口的隐线:数学总是先出生,然后等上几十年到几百年,才等到一个能用的地方。概率论 16 世纪就在算骰子,等了三百年才等到「大脑是一台推理机」这个说法;图论从 18 世纪 30 年代的柯尼斯堡七桥开始,等到 21 世纪才被用来分析连接组。反过来,强化学习这种 20 世纪 50 年代才有的东西,几十年内就撞上了多巴胺。
这条隐线如果被明确写出来,这本书会更有骨头——它说明的不是「数学很有用」,而是「工具的命运取决于它等到了什么问题」。可惜作者把这个信息编进了副标题,没有在正文里展开。
第 2 章的对撞是逻辑学 × 神经元。麦卡洛克和皮茨把神经元当成逻辑门——一个神经元要么被激活要么不被激活,正好对应二值逻辑。这就是「大脑是一台遵循逻辑规则的计算设备」这个说法的来历。
第 6 章的对撞是信息论 × 神经编码。这一章讲了一件我原来不知道的事:双耳定位靠的是时间差。两只耳朵之间有距离,来自左侧的声音会先到左耳,内侧上橄榄核(MSO)那一小群细胞负责比较两个输入的相对时间——「某个细胞的任务可能会被设置成检测同时到达双耳的声音,为此,来自两只耳朵的信号到达该 MSO 细胞所需的时间都必须完全相同」。1948 年心理学家劳埃德·杰弗里斯提出了这个回路模型,后来的实验支持了它。
一个细胞靠「两个信号同时到达」来判断方位,精度到百微秒级。这个设计精巧得不像生物,它就是一台延迟线比较器。读完这一节,你会理解为什么计算神经科学的人总说「大脑在算」,他们不是比喻,是真的在找那个电路。
第 10 章的对撞是动态规划 × 多巴胺。这一章开头就是那位地铁艺人安吉拉:她知道自己只能在某些站演二十分钟,城管来了就得走,而且回不去;不同站收入不同,旅游景点可能赚得多,本地人通勤的站可能颗粒无收。她要从布鲁克林绿点大道的家出发,在去往目的地的路上决定走哪条路线,才能赚到最多的钱。
然后作者把这件小事翻译成三个词:状态(她在哪个站)、动作(从 A 站去 B 站)、奖励(她演出的收入)。「状态就决定了哪些动作是可能的,而动作又决定下一个状态是什么。」贝尔曼做的事,是把这三个东西接起来,不去算一整串动作的预期奖励,而是算「任意状态所具有的价值」。
从地铁艺人到贝尔曼方程,中间没有跳步。这是全书最好的一处教学示范:先用一个你完全能想象的小生意,把三个抽象词各自按上一个具体的东西,再告诉你这三个词之间有递推关系。
三、它最诚实的地方:从不说「这就是大脑」
计算神经科学有一个天然的危险:模型拟合了数据,人就以为模型解释了大脑。这本书在这件事上很克制,克制得几乎有点刻意。
证据在引言里。作者讲「外延认知」:数学是一种外延认知,科学家写下方程式,就是在拓展自己的脑力,「他们把自己对复杂关系的认识输出到了纸上,而这些符号留下了他们对世界的思考」。然后引了怀特海一句话:「数学的终极目标就是免去一切思考之必要。」
这句话放在一本讲大脑的书里,意味深长。它等于在说:数学是我们挂在脑外的支架,不是脑本身。所以后面所有的模型,都是支架,不是器官。
这个立场在结语里被推到极致。结语只有二十四屏,标题是「有没有一个简明的大统一理论能解释大脑?」作者引了心理学家迈克尔·安德森和托尼·切梅罗的话:
我们完全有理由认为,不存在一个有关大脑功能的大统一理论,因为我们完全有理由认为,像大脑这样复杂的器官,其运作原理五花八门。
接着她说,大统一理论「听起来很棒,但许多人都认为这只不过是一种幻想」。然后笔锋一转,讲了一件更狠的事:
在大脑中寻找大统一理论是一项高风险高回报的工作,因此,它通常需要一个「大人物」来领导。……一个成功的大统一理论还讲求奉献精神,为了完善理论,理论的支持者需要为此付出数年甚至数十年的光阴。……同样重要的还有宣传,如果保持默默无闻,那么哪怕是最伟大的大统一理论也难以广为人知。因此,人们编写了各种论文、文章以及图书,为的就是将大统一理论不仅传达到科学界,也传达到整个世界。
这段话是全书最有骨气的部分。它把「科学理论如何被接受」这件事,从认识论拉到了社会学:一个大理论能不能立住,不只取决于它对不对,还取决于有没有一个大人物扛旗、有没有人愿意花几十年、有没有人写书宣传。
一个作者能在一本科普书里写下这段,说明她对自己这本书在做什么,是有清醒认识的:她也在做「传达」这件事。
四、它最难得的地方:肯拆自己模型的台
一本讲模型的书最怕什么?怕它把模型讲得太顺。这本书有几处反着来,主动指出「这个模型为了成立,必须假设一件生物学上不可能的事」。
第 3 章讲霍普菲尔德网络,先说它怎么记住东西:一次经历里,两个神经元同时激发或同时不激发,它们之间的连接就加强,一激发一不激发就削弱——这就是赫布型学习,经历怎么变成权重。讲到这里一切都很顺。然后作者自己揭了底:
为了确保网络中会形成这些正确的吸引子,霍普菲尔德必须做出一个十分离奇的假设,即霍普菲尔德网络中的权重是对称的。这意味着从 A 神经元到 B 神经元的连接强度始终和从 B 神经元到 A 神经元的连接强度相同。这条规则在数学上确保了网络中会形成吸引子。但问题在于,在大脑中找到这样一组神经元的可能性微乎其微,这要求 A 神经元轴突与 B 神经元之间形成的突触,必须跟 B 神经元轴突与 A 神经元之间形成的突触保持完全一模一样的强度,生物学现象可没有这么规整。
这段话的分量在读完之后才显出来:模型最漂亮的那个性质(能收敛到吸引子),是靠一个生物上几乎不成立的前提换来的。作者没有回避,她把这笔账明明白白摆给你看。
第 4 章更进一层,讲的是模型怎么被实验检验。2003 年,冷泉港实验室的迈克·韦尔和安东尼·泽多尔给大鼠听不同的声音,同时记录听觉皮质神经元的反应。特别之处在于他们没用常规做法——常规是记神经元的输出,也就是动作电位;他们用了另一种技术去「监听」输入,想看兴奋性和抑制性的输入是否相互平衡。
结果是:声音一响,先涌进来一批强烈的兴奋性输入,紧接着涌进来一批同样强烈的抑制性输入——「这好比是加一脚油门后踩的那一脚刹车」,而且声音更响时,兴奋增强,抑制也同步增强,两者始终旗鼓相当。
作者对这个结果的评价,是我认为全书方法论上最清醒的一句:「知道在数学上行得通当然是给我们喂下了一颗定心丸,但想要真正地检验一个理论还得靠真实的神经元。」
一颗定心丸,不等于一个证据。这句话应该印在所有计算模型的扉页上。
五、结语里那段关于「意识理论」的批评,值得单独说
结语讨论了三个候选的大统一理论:自由能理论、千脑智能理论、信息整合论(IIT)。二十四屏分给三个,每个大约六到八屏。
其中对信息整合论的批评,是我在这类书里见过最不留情面的。作者先讲了一个 2018 年的调查:意识科学家们被问「你支持哪个理论」,整合信息论名列第四,排名前三的是另外两种理论以及各式理论的「其他」选项。但同一项调查里,非专业人士中整合信息论排名第一。
然后她给了一个解释,这个解释我认为是全书最锋利的一句:
一些开展该调查的人猜测这可能是整合信息论公关的结果。在外界看来,仅仅是因为理论背靠着硬核的数学,它看起来就很权威很合理。而相较于大多数关于意识的科学理论,整合信息论在大众媒体上受到了更多关注。
「仅仅是因为理论背靠着硬核的数学,它看起来就很权威很合理。」
这句话打的不只是 IIT,它打的是所有「因为公式多所以可信」的直觉。而这恰好是这本书自己的风险:一本满是模型的书,天然带着这种权威感。所以作者这句话,某种意义上是在给自己的书消毒。
她还补了一句对同行的评价:著名神经科学家科赫那本《意识与脑:一个还原论者的浪漫自白》,「这种通俗的读物或许能行之有效地将理论传播给更广的受众,却不一定能使懂行的科学家心服口服」。
这句话有两层。第一层是在说科赫:书写得好,不等于论证成立。第二层是在说所有科普作者,包括她自己:一本书的说服力和它的正确性,是两条独立的线。能在一本讲「10 大模型」的书的结尾处提醒读者这件事,我认为是这本书的品格所在。
六、它的短板
四条,按我认为的严重程度排。
第一,公式与比喻之间没有桥。这是我最不满的一点,也是我一开始说的那件事。正文用曲棍球讲「全或无」,用乌贼讲电缆,用地铁艺人讲贝尔曼方程,讲得都很漂亮;但整本正文里,你找不到一条能照着算的式子。附录二十屏把方程全给了,却没有一句「回看第 1 章那个曲棍球比喻,它对应的就是这条式子」。结果是:读者得到的是十个能复述的故事,不是一个能上手的方法。对一本定位在「科普」的书,这或许可以接受;但它用了「模型」这个词做书名,读者有权期待更多。
第二,最该慢的地方最快。正文每章 34 屏,讲一个模型;结语 24 屏,讲三个大统一理论加一个大判断。自由能理论、千脑智能、信息整合论,每一个都是几十年、几十个团队、上百篇论文的东西,在这里各分到六到八屏。这个配比是反的:越是难、越是有争议、越容易被误读的部分,给的篇幅越少。我读完结语的感觉是「知道有三个候选」,而不是「理解它们各自在争什么」。
第三,十种「模型」不是同一种东西,书里没区分。这十章摆在一起,看上去很整齐,但它们其实是三类完全不同的东西:一类是能算出具体数值的机制模型(LIF、卷积网络、时间差分学习);一类是描述数据组织方式的框架(降维、图论、平衡网络);还有一类只是假说(贝叶斯大脑假说——书里那一节标题就叫「灵活与挑战并存的探索之路」,作者自己也没把它当定论)。
这三类的证据强度差着一个数量级,但书里用同样的篇幅、同样的「模型思维」框去处理它们。后果是读者会把它们放在同一个可信度上。如果这本书肯花两屏说明「我们接下来要讲的十种东西,其实分三类,可信度依次递减」,它的价值会高出一截。
第四,中文书名容易误导。《心智的 10 大模型》——2026 年看到这个书名,十个人里有八个会以为是「十个 AI 大模型」。实际上它讲的是十个解释大脑的数学模型,其中只有人工神经网络、卷积网络这两个跟当下的大模型沾边。推荐序一的标题也顺着这个误会写:「如何再造一个硅基大脑」。
这不是内容的错,是包装的选择。但它会造成一个具体的损失:该读它的人(想理解大脑怎么工作的人)可能因为以为是 AI 书而跳过,想找 AI 书的人则会在第 3 章之后发现自己上错了车。
七、怎么读这本书
三种读法。
第一种,你只是想搞懂「大脑在算什么」。读引言 + 第 1、2、5、10 章。这四章是「电路—逻辑—视觉—奖励」这条主线,讲得最实,比喻最好,读完你能跟人聊清楚三件事:神经元为什么是「全或无」的、卷积网络的眼睛是从猫的视觉皮层借来的、多巴胺干的事本质上是「预测误差」。加起来约 150 屏。
第二种,你想知道这门学科现在的争议在哪。直接翻结语(24 屏),再回头读第 9 章贝叶斯那部分。结语里那段 IIT 的批评,是这本书最值得单独摘出来的一节——尤其是「因为背靠硬核的数学,它看起来就很权威」这句话,可以拿去衡量任何一个自称有数学基础的理论。
第三种,你想真的动手算。先读附录,再回正文。这是我建议的顺序,跟书的设计正好相反。附录二十屏把十个模型的方程给全了,你先看方程,知道每个模型到底在算什么;再回正文看作者怎么用故事解释它,这时候故事才是有用的。反过来读,故事会让你以为自己懂了;先读方程,故事才会变成理解的工具。
最后说一句我的整体判断。
这本书我读得很愉快。它的写法是「一个数学工具 + 一段科学史 + 一个生活比喻」,节奏稳定,材料扎实,作者对「模型不等于大脑」这件事保持了一贯的警惕,甚至在结语里亲手拆了「数学多就权威」这个幻觉。
但它有一个结构性的遗憾:它把最难的东西(方程)放到了最后,把最好看的东西(故事)放到了前面,然后没有在两者之间修一条路。
大多数读者会停在前面那 390 屏,带着十个好故事离开,以为自己认识了大脑。而认知科学这四百年真正的教训恰恰是:感觉懂了,和能算出来,是两件完全不同的事。
这本书自己也说了这件事——在引言里,借怀特海的口:「数学的终极目标就是免去一切思考之必要。」可惜它把这句话放在了最前面,而把数学放在了最后面。
阅读记录
书名:心智的 10 大模型
作者:[美] 格蕾丝·林赛(Grace Lindsay)
本次阅读:微信读书逐页截图 411 屏,覆盖版权页至译者后记,两篇推荐序、引言、10 章、结语、附录全部覆盖,抓取标记为全书读完(end=last_page),耗时 310 秒
篇幅分配(按起始页相减):推荐序 8 屏 / 引言 12 屏 / 10 章 340 屏(36·36·37·36·36·31·33·31·30·34)/ 结语 24 屏 / 附录 20 屏
说明:本文引句均来自本次截图,可逐字核对;书中方程我只确认了附录收录(LIF、感知机及其权重更新规则等),未做推导验算
逐页精读系列 · 2026 年 11 月
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: