
《AI全球商业版图》:283 屏记事,15 屏判断
微信读书《AI 全球商业版图》(吴琼 著)· 本次逐页翻阅 298 屏,从版权页读到参考文献末页,两篇推荐序、序言、海外篇 4 章、中国篇 3 章、未来篇、结语、参考文献全部覆盖,抓取标记为全书读完(end=last_page),耗时 308 秒。
说明:这是一本产业地图式的书——把人形机器人、算力芯片、大模型公司按地域和赛道排一遍。我读它不是为了查资料,是想看它有没有给出判断。本篇不复述目录,只写我逐页读下来的判断;加引号的话都能在截图里核对,页码为本次截图编号。
我先算了一笔账,因为这本书的毛病和优点,都写在这笔账里。
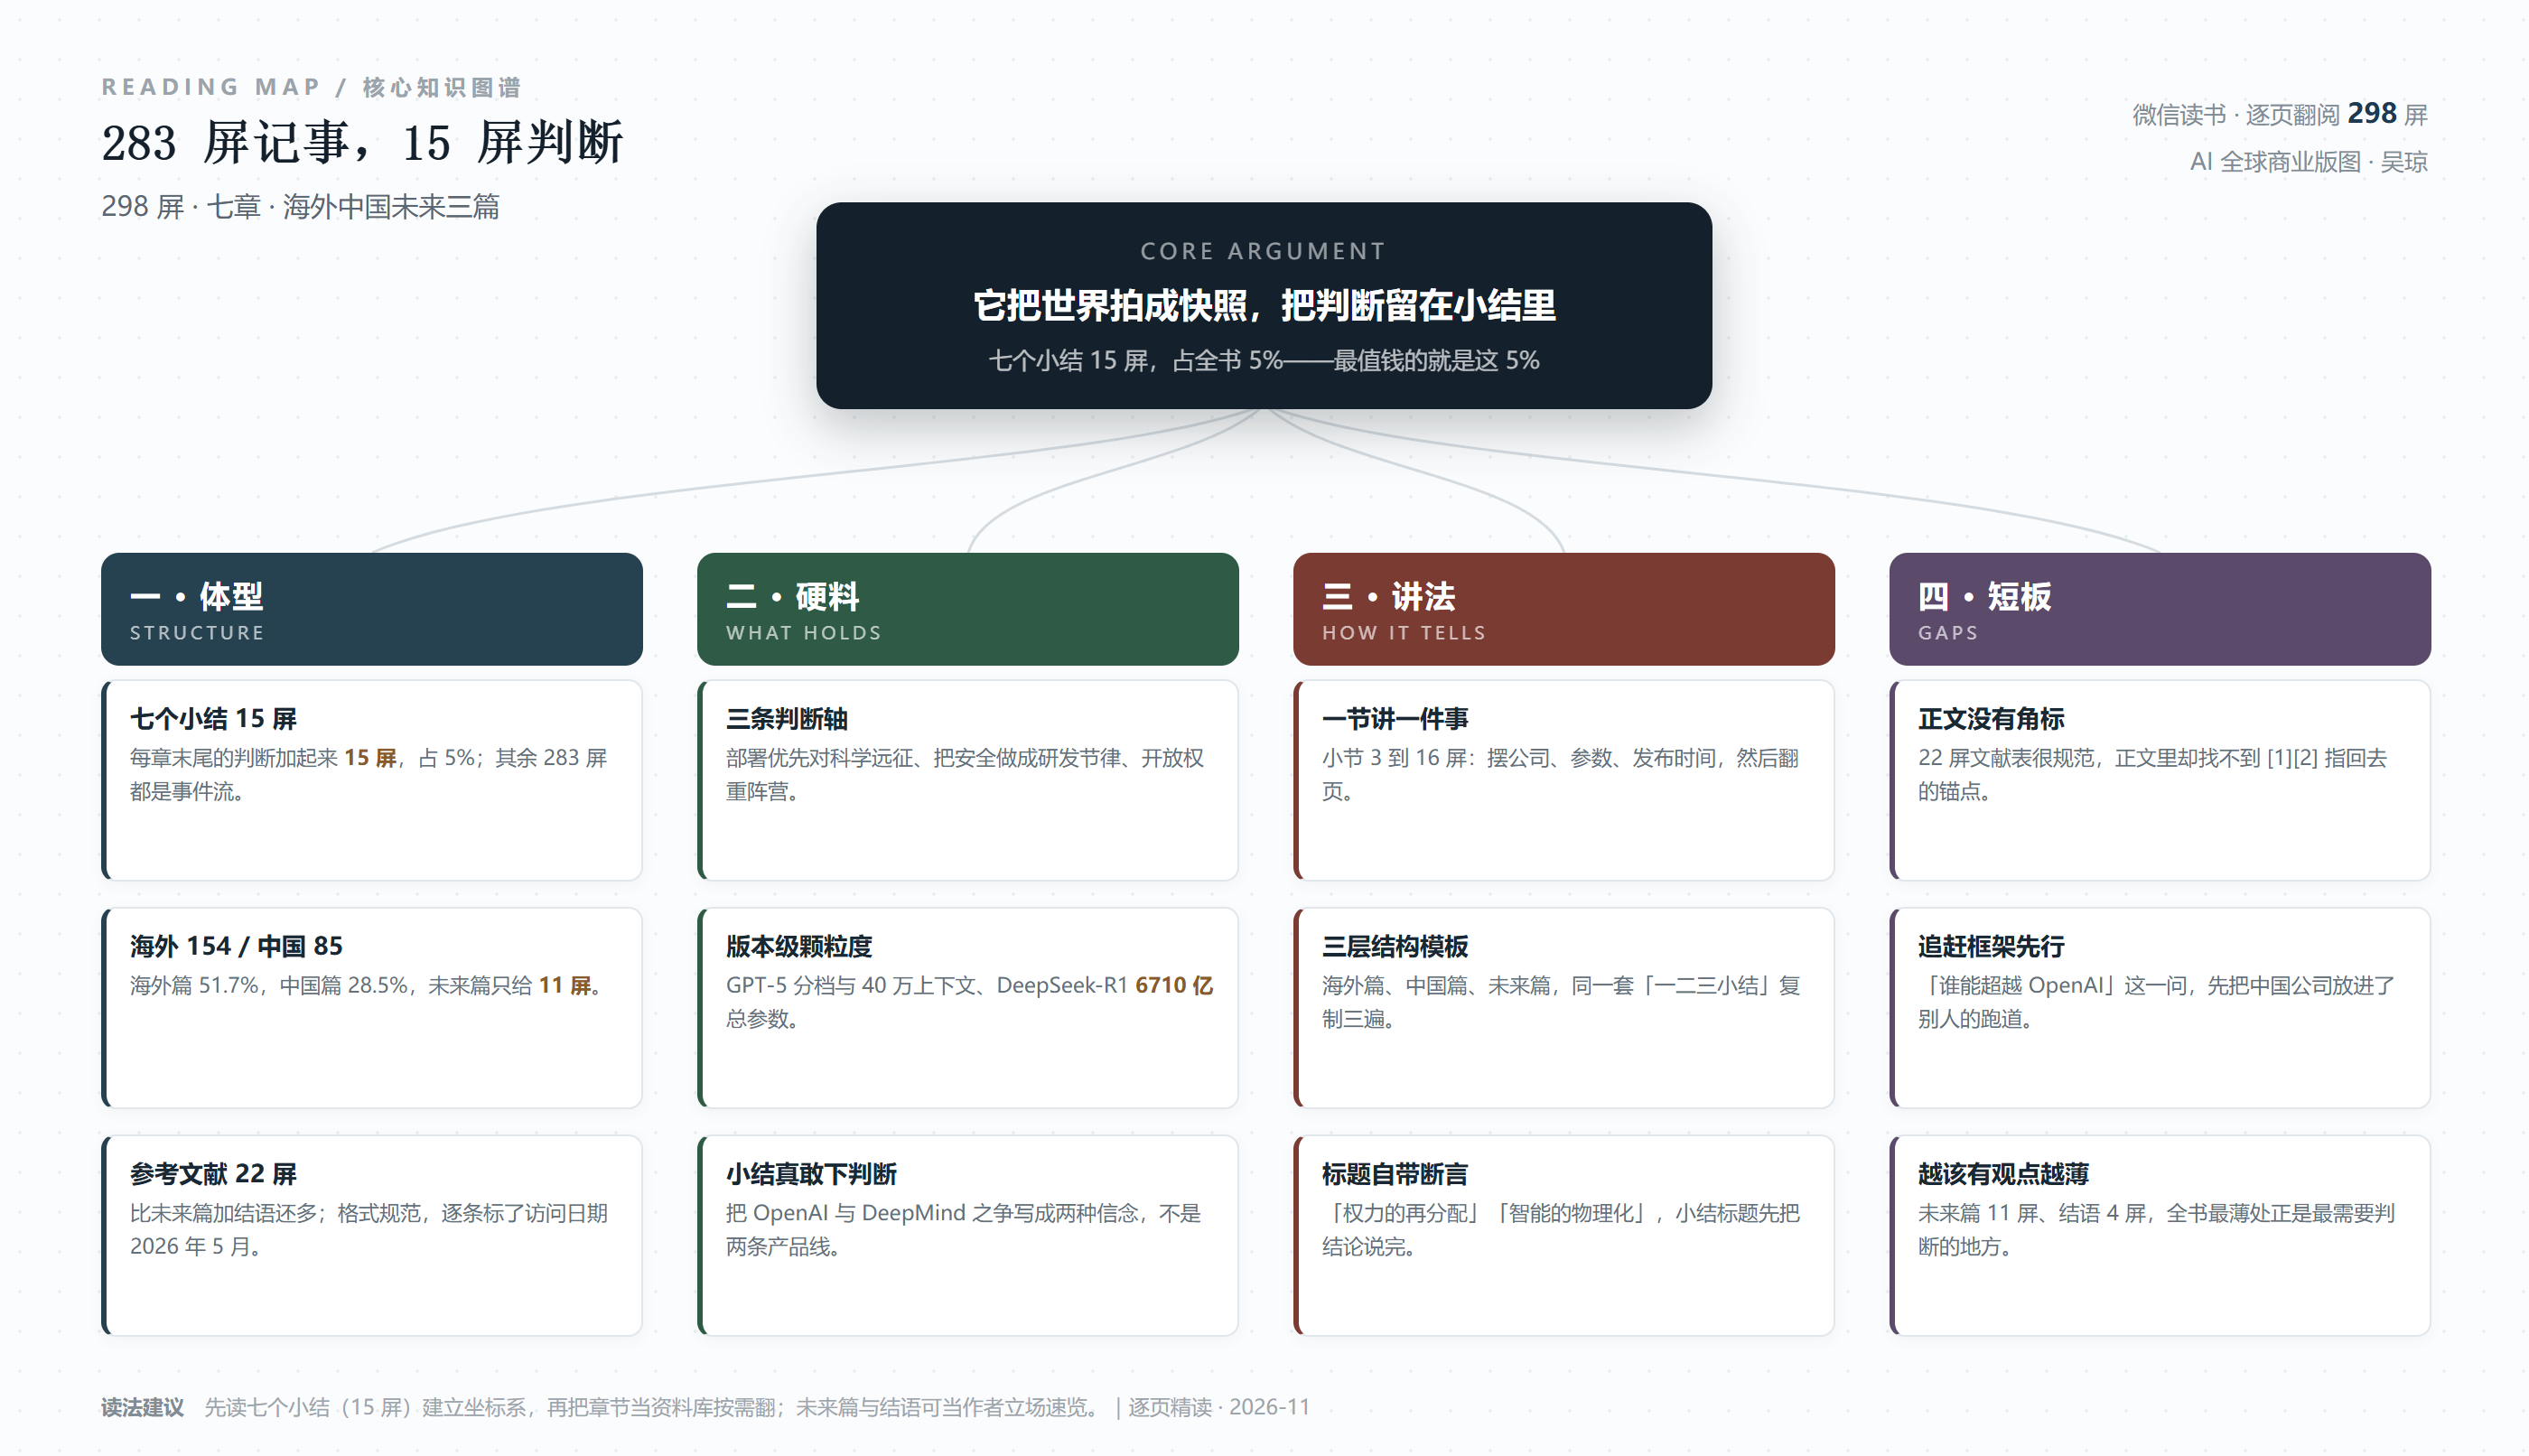
298 屏,七章。每章最后都有一个「小结」。我把七个小结的篇幅逐个加了一遍:2 屏、2 屏、3 屏、2 屏、2 屏、3 屏、1 屏——合计 15 屏,占全书 5.0%。
也就是说,这本书用了 283 屏告诉你「发生了什么」,用了 15 屏告诉你「这意味着什么」。
这个比例本身不是罪。产业地图的第一职能就是记录,读者买它也是想知道谁在做什么、做到哪一步了。但问题在于:这 15 屏写得太好了,好到把前面 283 屏衬成了素材。
我读完第一章的小结时,在页边写了一行字:「这才是这本书真正想说的话。」
一、先看结构:51.7% 海外,28.5% 中国,3.7% 未来
按章节起始页相减,298 屏的分配是这样的:
前置(版权、两篇推荐序、序言)22 屏,占 7.4%;海外篇 4 章 154 屏,占 51.7%;中国篇 3 章 85 屏,占 28.5%;未来篇 11 屏,占 3.7%;结语 4 屏,占 1.3%;参考文献 22 屏,占 7.4%。
七章各自的体量是:第一章 49 屏、第二章 38 屏、第三章 31 屏、第四章 35 屏、第五章 28 屏、第六章 21 屏、第七章 36 屏。
三个信号从这张表里直接跳出来。
第一,参考文献 22 屏,比未来篇加结语(15 屏)还多。这不是坏事,我在后面会专门讲——这本书的引用规范程度,在同类书里算上等。
第二,「全球」的重心在海外。海外篇占一半以上,中国篇不到三成。书名是「全球商业版图」,实际的结构是「先看美国,再看中国」。这个安排本身没错——目前前沿模型确实主要在美国——但它意味着中国篇天然处在「对照」的位置,而不是「并列」的位置。
第三,越往后越薄。未来篇 11 屏、结语 4 屏。全书最需要作者下判断的两个地方,加起来是 15 屏,跟七个小结的总量一样。
二、它新得罕见:读到 GPT-5.2 和 2026 年 5 月的引用日期
先说这本书最大的优点,因为它确实难得:时效性。
我在书里读到的模型版本,已经到了很细的颗粒度。第 30 屏讲 GPT-5:多种档位的模型(包括 mini、nano),上下文窗口扩展到 40 万 tokens,最大输出长度 12.8 万 tokens,API 端首次把 GPT-5 按功能分化为多个接口,分别是 Instant、Thinking、Pro,允许开发者按任务精度选型,并借缓存机制降低高频调用成本。接着讲 GPT-5 在 ChatGPT 里直接替换 GPT-4o 引发的适应性问题——「尤其在发布初期,GPT-5 的智能路由机制仍处于动态学习与调优阶段,处理复杂任务时出现响应不稳定、生成重复等问题」,部分专业用户指出它在轻量级任务中「推理过度」或「理解过深」,反而影响效率。然后写 OpenAI 于 2025 年 11 月推出 GPT-5.1、同年 12 月推出 GPT-5.2。
参考文献里也能看出这个时间刻度:Gemini 3.1 Pro 标注为 2025-11-18,Genie 3 为 2025-08-05,Anthropic 的 ASL-3 保护措施为 2025-05-22,每条的访问日期都写着 2026-05-18。
一本讲产业的书,能把版本推到 2025 年底、引用日期落到 2026 年 5 月,这是要下功夫的。同期大部分同类书还在讲 GPT-4。
但时效性是一把双刃剑,这本书自己也知道。推荐序二的标题就叫「在 AI 的『流沙时代』,寻找通向未来的坐标」——「流沙」两个字用得很准:脚下一直在动。所以我读它的时候一直有个疑问:如果三年后这本书里的参数、版本、榜单全部过期,它还剩什么?
我的答案是:还剩那 15 屏小结。
推荐序一里有一句话,我觉得比正文很多段落都清醒。北大光华管理学院院长田轩写:「相较于被单一工具取代,更值得我们警惕的是个体在技术发展中失去独立性,沦为技术的附庸。」
这句话跟这本书的主要内容其实是两回事——书里讲的是公司、算力、赛道,是个宏观视角;而这句话讲的是个体在其中的位置。但把它放在书前,恰好构成一个提醒:读产业地图的时候容易忘掉,图上的那些地块,最后是由一个个具体的人去站位的。
三、最值钱的 15 屏:三条判断轴
第 69 屏,第一章的小结,标题是「通用人工智能的战略分野与发展路径」。这一屏半的文字,我认为是全书的核心。它把海外几家公司的差别,归成了三条轴,而不是三条产品线。
第一条轴:路径论之争——部署优先,还是科学远征。
OpenAI 是前者的典型代表,它始终坚持「部署优先」的战略逻辑,强调通过大模型、大数据与大算力的不断叠加,实现能力涌现与平台闭环。其产品体系从 ChatGPT 向 API、智能体平台扩展,试图通过产品化规模效应压缩技术演进周期。而谷歌 DeepMind 则代表另一种信念:通用人工智能不应只是参数堆叠的产物,还应从「通用学习机制」出发,逐步构建具备迁移性与可解释性的智能体。
这个二分法不算新,但作者补了一句让它变锋利:「Gato、Gemini 与 Alpha 系列背后的共通逻辑,是将『智能』视作尚未被完全理解的自然现象,必须以科学研究为根基、以复杂任务为牵引,走一条更长但可能更稳健的远征之路。」
「尚未被完全理解的自然现象」——这个说法把两家公司的差别从商业策略拉到了本体论:一家认为智能是可以被工程堆出来的产品,一家认为智能是需要被研究清楚的现象。前者必然追求发布节奏,后者必然容忍慢。这不是谁对谁错,是两种世界观在抢同一块地盘。
第二条轴:价值观的张力——自由能力的释放,还是可控系统的构建。
作者把 Anthropic 单独拎出来,说它标志着「另一条路线的崛起——不再将『AI 安全』视为合规项或附加限制,而是作为组织结构、研发节奏乃至产品形态的首要驱动力」。具体做法是设定分级发布政策(如 ASL 安全等级)、引入长远治理机制,把「对齐」与「可控」系统性嵌入整个模型开发流程。
这句话值得多想一层。大多数公司把安全当刹车,Anthropic 把安全当发动机的节律器——它不阻止你加速,它决定你什么时候可以换档。这个区别在组织设计上是本质的:安全如果是合规部门,那它就是审批;安全如果是研发节律,那它就是路线图。
第三条轴:开放权重阵营的复兴。
作者在这里点了一串名字,而且点得很准:「真正丰富通用人工智能战略图景的,并不止 OpenAI、谷歌 DeepMind、Anthropic 这 3 家公司。在主权部署需求日益上升的背景下,人工智能初创公司 Mistral AI、Aleph Alpha 等的崛起凸显了『开放权重』路线的强势复兴:押注开放模型、轻量化训练与本地部署生态,试图以技术民主化对抗封闭巨头。」
然后是企业侧:Databricks(模型为 DBRX)、Snowflake(Arctic)、Cohere(Command)。这一段的判断我认为是全书写得最到位的:开放权重不是一个技术选择,是一个政治选择——「主权部署」这四个字,说的就是「我不想让我的数据经过你的服务器」。
三条轴摆完,这本书的骨架就清楚了:它真正在讲的不是「谁的技术强」,是「三种关于智能的信念怎么在商业上互相挤压」。可惜的是,这三条轴只在 15 屏里出现过,正文 283 屏基本没有回头去用它们解释具体事件。
补一个例子,说明这本书的材料能扎实到什么程度。第 80 屏讲算力垄断:英伟达在 AI 训练 GPU 市场的份额已超过 80%,在高端训练卡(如 H100、H200)维度甚至逼近 90%;作者把这道墙拆成三块砖——GPU 设计的极端复杂性与制造所需的高资本门槛、CUDA 建立的高度绑定低迁移开发生态、多年积累的品牌信任与客户黏性。然后是 2025 年 9 月 22 日那笔交易:英伟达与 OpenAI 达成合作意向,为「星际之门」项目提供不低于 10GW 的系统部署能力,对应「百万级 GPU」规模的异构算力集群,投资总额最高可达 1000 亿美元,首个 1GW 的 Vera Rubin 训练平台预计 2026 年下半年量产。
紧接着它写了反面:2025 年 12 月美国虽局部放宽 H200 对华出口限制,但附加了费用高昂且复杂的合规条款,同时仍对 Blackwell 系列保持禁运。这一段的价值不在数字,在于它把「垄断」写成了一个有裂缝的结构:技术墙、生态墙、政策墙,三堵墙的高度不一样。
四、中国篇:85 屏,一个已经设定好的问题
第五章的标题是「中坚力量:谁能超越 OpenAI」。
这个标题我看的时候停了一下。它把整章的问题预先设定成了「追赶」——不是「中国公司在解决什么问题」,而是「谁先追上那个人」。这个框架当然有现实依据(前沿模型确实领先),但它会带来一个副作用:读完之后你知道谁离 OpenAI 近,却不太知道这些公司各自在赌什么。
不过这一章的正文材料是扎实的。第 182 屏讲 DeepSeek 的两条训练路线,写得比很多技术分析都清楚:
在实践路径上,DeepSeek 提出了 DeepSeek-R1-Zero 与 DeepSeek-R1 两种不同的训练范式。DeepSeek-R1-Zero 基本不依赖传统监督微调数据,而是通过设计特定奖励函数,引导模型在强化学习过程中自主探索更优的推理路径。这一方法在数学推导与代码生成等任务上展现出一定的成效,但也暴露出输出可读性下降、推理路径不确定性增强等问题。DeepSeek-R1 引入了少量冷启动样本与结构性约束机制,以在提升推理性能的同时改善输出质量,增强实际应用的适应性。
接着给了关键数字:混合专家架构,总参数约 6710 亿,每 token 激活约 370 亿,通过「从稠密到蒸馏」(Dense-to-Distill)机制实现推理能力的有效压缩。作者的评价是:「从而对行业中『规模即能力』的主流共识构成了有力挑战。」
「规模即能力」这五个字,是这本书里我最认同的一处概括。它把过去三年行业的默认前提说穿了:大家都在赌更大更强。而 R1 这条路线的意义,不在于它便宜,在于它证明了「同样的能力可以用更少的激活参数换到」——这在商业上意味着成本结构可以被改写,在认知上意味着「规模定律」不是唯一的路。
中国篇另外两章(第六章算力、第七章具身智能)结构一样:先摆玩家,再摆参数,再用小结收一句判断。第六章的小结叫「自主之路——中国算力生态的系统性突围」,第七章叫「中国具身智能——从实验室走向产业化」。这两个标题里有同一个词:突围。加上第五章的「超越」,中国篇的三章其实共享一个叙事:在被限制的条件下找出路。
这个叙事是真实的,我不认为它是套话。但它也让中国篇变成了一个「回应式」的部分——回应的对象在海外篇。这就是为什么我说中国篇处在「对照」位置:它的问题不是自己提出的。
五、第三章那个「思考」框:这本书最好的写法
我原以为这本书的判断只集中在那 15 屏小结里,读到第三章才发现不止——正文里还有一些独立的「思考」边栏,用深色底框出来,专门放作者的判断。第 116 屏那个框,标题叫「路径固守的沉淀成本与社会规则的『接口』」,是我认为全书写法最好的地方。
它讨论的是 Waymo。前面正文刚肯定完 Waymo:正在从「工程样本」向「规模化运营平台」过渡,长期优势体现在技术积累、落地组织能力、监管适配能力与稳定的安全信誉上。然后框里立刻泼了一盆冷水,两条:
(1)技术路径的坚守与窗口期的风险。Waymo 秉持的「工程师理性」路径,强调通过系统验证和严格测试来构建可信赖的自动驾驶系统。虽然这种模式增强了技术的确定性与安全性,但在快速变化的市场环境中,也可能面临窗口期压缩的风险。当自动驾驶从实验阶段步入产业化阶段时,市场对「完美系统」的耐心能否持续,将是 Waymo 未来需要纳入考量的重要变量。
(2)技术与规则的磨合机制。……2025 年 9 月,加利福尼亚州发生「警察拦截违规 Waymo 但无人可罚」的事件,引发了立法机构对自动驾驶执法责任机制的重新思考。如何在现行法律框架下实现技术责任的有效界定,将成为 Waymo 规模化进程中不可回避的核心课题。
「警察拦截违规 Waymo 但无人可罚」——这一个细节,比前面十屏的技术介绍都值钱。
因为它指出了一个真问题:自动驾驶最难的不是把车开对,是当它开错时,罚谁。技术公司习惯了「提升正确率」这条曲线,但社会需要的是一条「责任归属」的曲线,两条曲线的斜率完全不同。Waymo 可以继续把事故率压低,但只要「无人可罚」这个漏洞在,监管迟早会以另一种方式把成本收回去。
这个框的存在,让我对这本书的评价要往上调一格。它说明作者不是不会判断,而是把判断放在了边栏里——正文走事实,边栏放锋芒。这是一种克制的编辑策略,我甚至觉得它比把所有观点揉进正文更清晰。可惜的是,这样的「思考」框在全书里出现得太少,我没有在每一章都遇到。
六、未来篇 11 屏:最薄的地方,最重的修辞
第 272 屏是未来篇的收尾,我把它整段抄下来了,因为它是这本书文风的一个样本:
未来几年,我们极有可能见证「基础世界模型」的诞生。就像 GPT 系列重塑了自然语言处理的范式,基础世界模型有望成为物理世界的通用模拟器。未来的 AI 也许将不再是单一的「大脑」,而是一个双脑协同的系统——顶层的「语言大脑」负责抽象指令和逻辑推理,底层的「世界小脑」负责物理感知和行动推演。当 AI 既读过「万卷书」(通过大语言模型)又行过「万里路」(借助世界模型)时,它将不再是那个只会纸上谈兵的聊天机器人,而是真正具备了在复杂的物理世界中生存、交互和创造的实体智能。这,才是通用人工智能真正的黎明。
写得好,画面感强,「双脑协同」这个提法也有解释力——语言大脑管抽象,世界小脑管物理,比笼统说「多模态」要清楚。
但我要指出一个问题:这 11 屏是全书修辞密度最高的地方,也是证据密度最低的地方。
前面讲世界模型的价值,用的是自动驾驶遇到结冰路面的例子:车辆需要在毫秒级时间内,在潜空间里模拟摩擦力变化带来的后果,预演「急刹车」与「点刹」两种操作在物理层面引发的不同结局,「这种能力使得 AI 不需要用真实的身体去悬崖边『试错』,而是在大脑中通过虚拟的试错找到最优解」。这个例子很好。
可到了「未来几年极有可能见证基础世界模型的诞生」这句,就没有支撑了——谁在什么时候、凭什么指标算「诞生」?Genie 3 算不算?书里在参考文献里引了 Genie 3(2025-08-05),正文却没把它接上。结果就是:该给证据的地方,给了修辞;该下判断的地方,给了愿景。
然后全书就结束了。结语 4 屏,标题是「站在巨人的肩膀上,抓住未来」。这个标题很稳妥,也很空——它没有回答任何前面提出的问题:三条轴最后谁会赢?开放权重能不能撑住?中国公司的突围点在哪?未来篇说的「黎明」还要几年?
我读完最后一页的感觉是:这本书所有的力气都用在了「记录得准」,没有留给「判断得狠」。
七、它的短板
四条。
第一,正文没有角标,22 屏文献表成了装饰。这本书的参考文献做得很规范——Authors. Title[EB/OL]. (发布日期)[访问日期]. URL,一条条列得清清楚楚,访问日期统一是 2026-05-18,一共 22 屏。这在同类书里绝对算上等。但问题在于:正文里我找不到 [1][2] 这样的编号。也就是说,读者看到「上下文窗口扩展到 40 万 tokens」这句话时,没法知道它来自哪条文献、是官方博客还是二手报道。文献表变成了一份「我读过这些」的清单,而不是一条条可以回溯的线索。
这个毛病改起来很便宜(正文加个上标就行),但影响不小:它把一本可以当资料书用的书,变成了一本只能当读物用的书。
第二,事件流的写法,让判断失去了落点。283 屏正文的基本单位是「一节讲一件事」:摆公司、摆参数、摆发布时间,然后翻页。一节 3 到 16 屏,节奏很快,信息密度高,但每一节结束时几乎不做归纳。读的时候很顺,读完合上书,你记得很多条事实,却不太记得作者对这些事实的态度。
对比一下那 15 屏小结:同样是这些材料,一旦被组织成「部署优先 vs 科学远征」,立刻就长出了骨头。这说明作者有能力做这件事,只是没有在每个章节里坚持做。一本产业地图如果只有末尾有判断,它就退化成了一份编年表。
第三,「谁能超越 OpenAI」这个设问,框住了中国篇。前面说过了,不重复。这里补一句更具体的:这个框架会让读者默认「超越」是唯一目标,从而忽略另一类问题——比如中国公司在「成本结构」「落地场景」「数据闭环」上有没有走出一条不同的路。第七章讲具身智能时其实碰到了这个方向(从实验室走向产业化),但被放在「追赶」的叙事之下,份量不够。
第四,越该有观点的地方越薄。未来篇 11 屏、结语 4 屏。全书最需要作者站出来说「我认为会怎样」的两个部分,加起来 15 屏,而且是修辞最多的 15 屏。这不是篇幅问题,是取舍问题:作者显然更愿意做一个准确的记录者,不愿意做一个会错的预言者。
这个选择我理解,甚至有点尊重——预言错了要被笑好几年。但一本书叫《AI 全球商业版图》,「版图」这个词本身就是在做判断:哪些地块重要、谁占着、边界往哪移。只画地形不标国界,图就不完整。
八、怎么读这本书
三种读法。
第一种,你想快速建立 2026 年的产业坐标。先读七个小结,15 屏,半小时。这 15 屏是全书判断密度最高的地方,读完你就有了三条轴:路径论、价值观、开放权重。然后再按需要翻章节——想知道算力就看第二章,想知道具身智能就看第三、七章对读(海外篇讲特斯拉与 Figure,中国篇讲国内玩家,对着看很有意思)。
第二种,你要拿它当资料库。从参考文献倒着查。22 屏文献表里有大量一手来源(各家官方博客、技术报告),比正文更好用——正文是二手的,文献是一手的。这是我对这本书最实用的一条建议:把正文当索引,把文献当正文。
第三种,你想看作者的真实立场。直接读第 69 屏那一个半屏的小结,加第 272 屏那一段「双脑协同」。前者是全书最硬的判断,后者是全书最漂亮的修辞。两个放在一起读,你大概就能判断这位作者是哪种人:一个材料扎实、判断谨慎、在收尾时忍不住浪漫一下的行业观察者。
最后说一句我的整体判断。
这本书我会留着,但不是当观点书留,是当快照留。它准确地记录了 2026 年上半年这条赛道上都有谁、各自跑到哪、参数多少、版本几何。三年后再翻,这些数字会全部作废——但它同时记录了一件事,那件事不会作废:在这个时间点上,行业里有三种关于智能的信念在互相挤压,而大多数人只看到了其中一种。
那 15 屏小结,就是这本书真正的价值所在。遗憾的是,它被埋在了 283 屏的事件流后面——就像一本好书的关键一页,被装订在了最后。
阅读记录
书名:AI 全球商业版图
作者:吴琼
本次阅读:微信读书逐页截图 298 屏,覆盖版权页至参考文献末页,两篇推荐序、序言、海外篇 4 章、中国篇 3 章、未来篇、结语、参考文献全部覆盖,抓取标记为全书读完(end=last_page),耗时 308 秒
篇幅分配(按起始页相减):前置 22 屏 / 海外篇 154 屏(51.7%)/ 中国篇 85 屏(28.5%)/ 未来篇 11 屏 / 结语 4 屏 / 参考文献 22 屏;七个小结合计 15 屏(5.0%)
说明:本文引句均来自本次截图,可逐字核对;书中模型版本与参数(GPT-5 系列、DeepSeek-R1 的 6710 亿 / 370 亿等)为原文引用,我未做二次核实;「正文无角标」的判断基于我翻过的全部 298 屏
逐页精读系列 · 2026 年 11 月
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: