
《心之壁》:这本书的「具身」,和机器人无关
微信读书《心之壁:具身智能如何获取意义乃至承担责任》(刘林澍 著,机械工业出版社,2026 年 1 月第 1 版)· 本次逐页翻阅 248 屏,从版权页读到「全书完」,含两篇序、前言、第 1 部分 4 章、第 2 部分 4 章、尾注,抓取标记为全书读完(end=last_page),耗时 365 秒。
说明:这不是一本讲机器人的书,尽管书名里有「具身智能」。它讲的是认知科学里的「具身」(embodied),是 4e 认知那一路。本篇不复述目录,只写我逐页读下来的判断;加引号的话都能在截图里核对,页码为本次截图编号。
这本书把「具身智能」四个字,拆回了认知科学。
我知道这句话听起来像在挑刺,但它其实是在说这本书的准确定位——如果抱着「人形机器人怎么做」的预期打开它,前一百屏会彻底懵:里面讲的是概念、类比、形式系统、哥德尔编码、范畴错误,一个电机都没提。真正的机器人内容,要等到第 2 部分之后才慢慢渗出来,而且是作为「应用推论」出现,不是作为主题。
所以我把判断放在最前面:这是一本用认知科学重写「具身智能」的书,它的价值在于把「智能」这个词从工程语境里拽出来,放回「一个系统如何在环境中维系自身」这个更古老的问题上。它不是路线图,是地形图。地形图画得好不好,下面逐个数。
一、先看骨架:248 屏是怎么分的
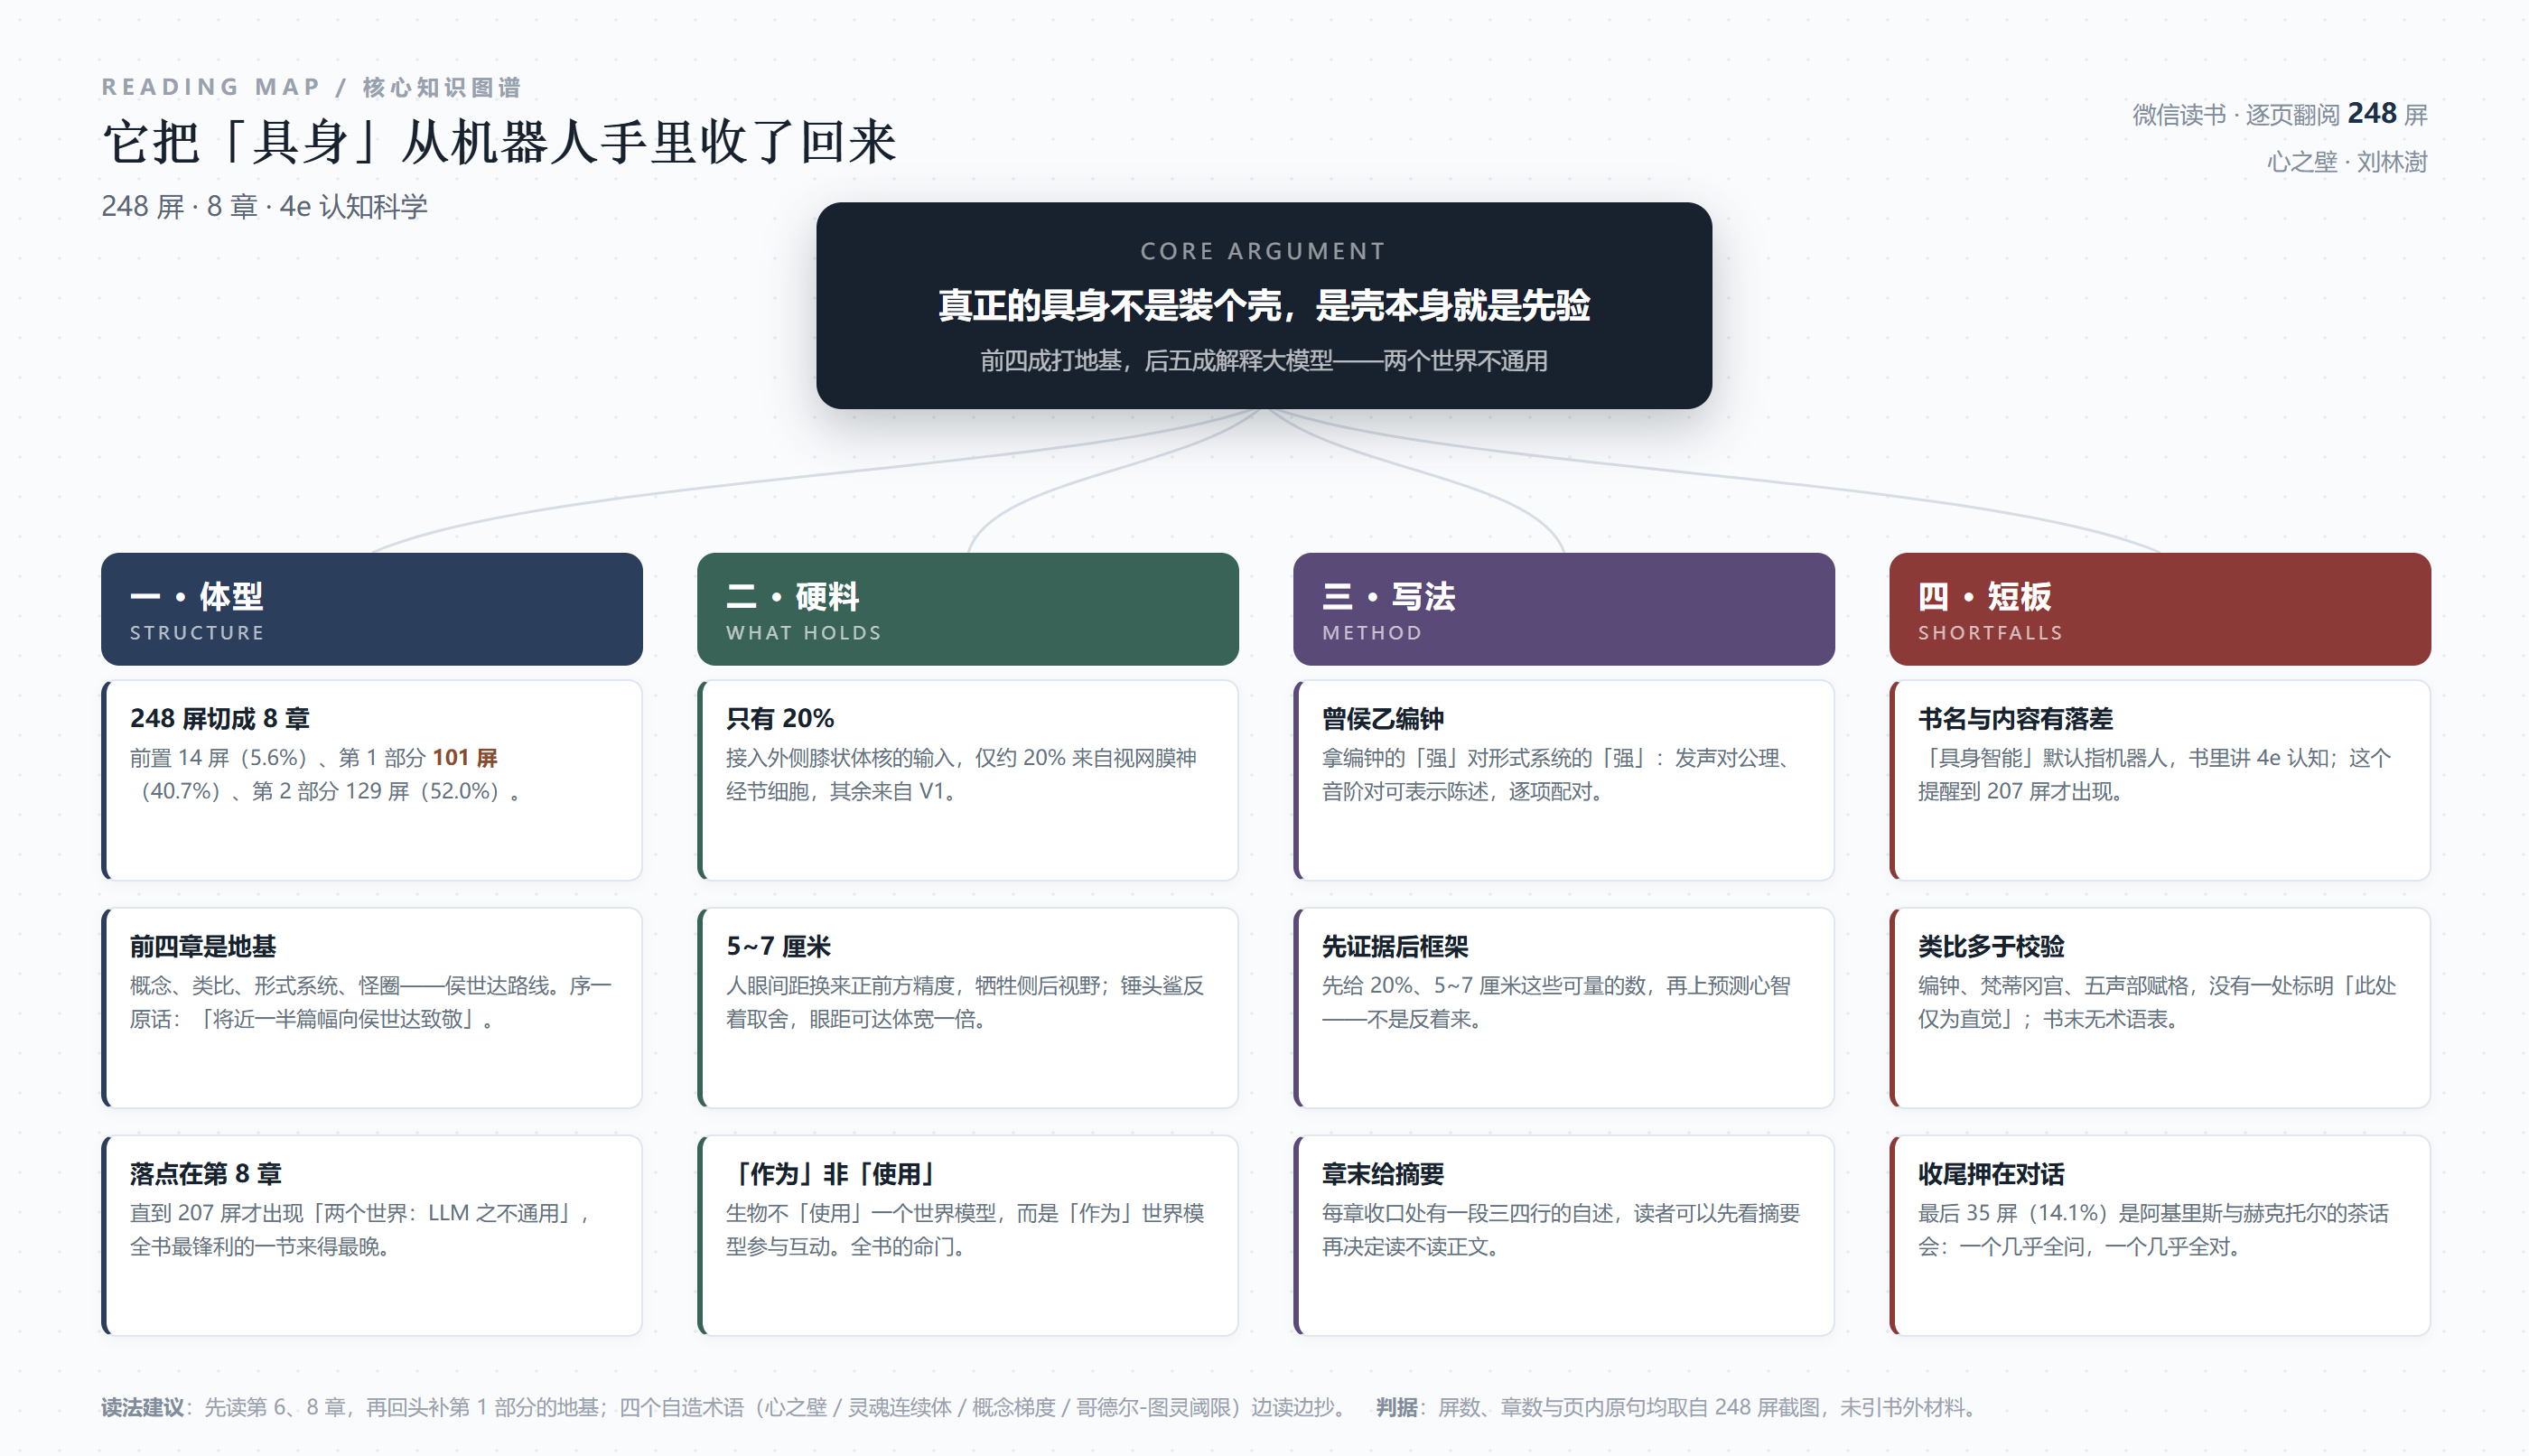
按章节起始页相减,248 屏的分配是这样的:
前置(版权页、序一、序二、前言)14 屏,占 5.6%;第 1 部分(4 章:衔尾之蛇、概念与类比、「灵魂」与形式、我是一个怪圈)101 屏,占 40.7%;第 2 部分(4 章:认知科学的实用主义转向、预测机器的主动推理、迈向未来的认知科学等)129 屏,占 52.0%;收尾对话体 35 屏已经算在第 2 部分最后一节里。
这个比例透露了这本书的真实重心:前四成在打地基,后五成在用这套地基解释大模型。地基那部分——概念如何形成、类比如何成立、形式系统的界限在哪里——是侯世达的路子。序一里魏军说得比我客气,也比我准:
这本书的确深度关联于侯世达的思想(它用了将近一半的篇幅向侯世达的理论体系致敬),但站在侯世达的肩膀上,大树尝试了一次鲁莽却充满勇气的跳跃——从「心智像什么」扑向了「心智是什么」。
「用了将近一半的篇幅向侯世达致敬」——这句话是可以算的,40.7% 对得上。但更值得注意的是后半句那个方向:从「像什么」到「是什么」。这是两种完全不同的写作。前者是类比,后者是定义。类比能让人有感觉,定义才能让人反驳。
而这本书的问题,恰好长在这个转换的缝上——它前四成用类比建立直觉,后五成想用定义收口,但类比的惯性太大,有些地方没收住。这一点我会在第五节展开。
二、它写得最好的两个例子:曾侯乙编钟与锤头鲨
我先说好的部分,因为这部分确实好,而且好得很具体。
第一个是曾侯乙编钟。第 4 章讲哥德尔编码——一个形式系统如何「谈论自己」,靠的是把符号序列映射到自然数上。这个论证抽象到几乎没有画面感,作者在这里做了一件很聪明的事:拿中国古代编钟做对照。他的论证是这样展开的:自然数本身蕴含极其丰富的模式,所以形式系统的运算才能映射复杂的数论陈述;
如果声波没有蕴含如此丰富的模式,其相互作用就无法映射复杂的音乐旋律乃至人类话语。而这一切的前提当然是「PM」「强」到足以在一定限度内「把握」自然数的丰富性——也就是能表示一切可证明的数论陈述。正如现代版曾侯乙编钟「强」到足以在一定限度内「把握」声波的丰富性——也就是能复现巴赫与卡奇能够创作的一切作品。
接着他给了一张对照表(图 4-1):左边是哑铃—敲击发声—曾侯乙编钟—演奏有限的旋律—现代版曾侯乙编钟—复现巴赫与卡奇的一切作品;右边是原版「加减法」—扩展版「加减法」—「PM」—表示一切可证明的数论陈述。中间一个双向箭头,表示同构。
这个类比之所以有效,是因为它挑对了对应关系。它不是「形式系统像编钟」这种文艺说法,而是逐一配对:发声机制对公理、可演奏的音阶对可表示的陈述、编钟的铸造精度对系统的强度。三段式一一对应,读者能顺着走。中国读者读到这里会有一个额外的收获:原来我们熟悉的这个东西,本身就是一部「形式系统」的物理实现。
第二个是锤头鲨。第 5 章讲「具身心智」,主张心智部分地由身体结构决定。这个主张很容易变成空话(「身体影响认知」),作者用了一个很妙的对比把它落地:
人的双眼位于面部正前方,间距 5~7 厘米,这种结构意味着我们双目视野重叠范围极大,因此对正前方目标距离和细节的判断都得到了优化,但牺牲了侧向视野,正后方更是彻底抓瞎;双髻鲨(或称锤头鲨)的双眼则分别位于头部两侧左右延伸的「锤头」末端,间距极宽(甚至可达体宽的一倍),这为它们提供了接近无死角的视野……
这段的说服力来自一个很小的事实:5~7 厘米。这个数字一出来,「身体结构决定认知方式」就不再是哲学口号,而是一个可以量、可以算的东西。人的视野是有取舍的——牺牲侧向换正前方的精度;锤头鲨是另一套取舍——牺牲精度换无死角。两种身体,两种世界。这就是「具身」这两个字最朴素的含义:不是给算法装个壳,是壳本身在决定算法能问出什么问题。
三、全书最硬的一段:20%,以及「作为」而不是「使用」
如果只能从这本书里带走一段,我会带走第 6 章里那个数字。
这一章讲「预测心智」:大脑不是被动接收信息的机器,而是主动生成预测的机器。论证的关键一步是把传统神经科学的图景翻过来——按马尔(David Marr)的经典框架,视觉是自下而上的:光打到视网膜,信号一层层往上走,最后形成三维表征。如果这个框架对,那么大脑里「向上」的前馈连接应该远多于「向下」的反馈连接。
事实正好相反。作者的原话:
违背直觉的是,大脑中承载「反馈」信号的神经连接在数量上要远远超过承载「前馈」信号的神经连接。以视觉通路为例,「接入」外侧膝状体核的巨量神经连接大部分源于 V1 视觉区,仅约 20% 来自视网膜神经节细胞。这一事实与根据马尔的理论还原的神经图景正好相悖,一度让神经科学家们困惑不已。
「仅约 20%」这四个字,是整本书最结实的一块砖。它意味着:视觉信息的主要来源不是眼睛,是大脑自己。眼睛提供的只是那 20% 的误差修正量,剩下 80% 是大脑对「外面应该是什么样」的预测。这就把「感知」从「接收」改写成了「校对」。
我读到这里停了一会儿,因为这个数字有一种罕见的性质:它同时是生理事实和哲学论证。你不需要接受作者的全部框架,也能被这个数字说服「自上而下」的重要性——这正是好的科普写法:先把证据摆出来,再让框架跟上,而不是反过来。
而全书真正的理论高潮,在 8.2 后半段。作者在这里提出了一个我认为是全书最有价值、也最容易被忽略的区分。他先描述了生物的生成模型是如何分层的:大尺度的先验(比如鱼的身体形态对应水的流体动力学)只能在「选择」层面更新,中尺度的先验(比如对某种食物的偏爱)只能在「发展」层面更新,只有小尺度的信念可以实时更新,而且必须受更大尺度先验的约束。然后他给出结论:
对生物而言,生成模型编码的许多先验信念没有更新的余地,因为它们原本就是具身的:或表现为神经系统的硬连线结构,或表现为身体的形态学。这些「活的信念」蕴含了生物对其生活世界的实用的理解。因此,尽管生成模型可以写成概率分布,但它并不是一架表征引擎,而是一个控制系统:生物不需要「使用」一个世界模型指导自身与环境互动,而是「作为」一个世界模型直接参与这种互动。
「不需要『使用』一个世界模型,而是『作为』一个世界模型」——这句话是全书的核心,也是它区别于所有「大模型就是世界模型」这类说法的关键。
因为「使用」意味着模型在外面,主体在里面,模型是一张可以随时抽出来看的地图;而「作为」意味着模型就是身体本身,你没办法把它抽出来——鱼的鳃就是它对水的理解,你不可能让鱼先把鳃摘下来再讨论流体力学。前者是表征,后者是存在方式。
按这个标准去看大模型,结论就很清楚:它是一个被「使用」的世界模型,不是被「作为」的世界模型。它的先验全在权重里,可以随时重训、微调、替换,而且它的所有先验都来自语料,没有一条是从「活过的身体」里长出来的。作者用一节专门讲这件事,标题就叫「两个世界:LLM 之不通用」。
我认为这是全书最有分量的一节,也是最不像畅销书的一节——它没有给读者安慰,反而把「大模型有世界模型」这个流行说法拆掉了。
四、「心之壁」到底是什么壁
书名里的这个「壁」,我读到第 8 章才确认它指的是什么。它不是一个比喻性的「困难」,而是两层意思叠在一起。
第一层是「人工智能效应」(AI effect)。作者的原话:
对「智能」的界定通常带有浓厚的人类中心色彩,导致了所谓的「人工智能效应」(AI effect):一旦人工系统实现了特定功能,人们通常就不再认为实现该功能需要「真正的智能」了。因此,要消除 AIGC 带来的焦虑,我们就要以一种「非人类中心」的方式重新界定并衡量智能。
这一层说的是:壁在人的定义里,不在机器身上。每次机器做成一件事,人就把「智能」的门槛往上挪一格——会下棋不算,会翻译不算,会写诗也不算。所以「它到底有没有智能」这个争论永远不会有答案,因为标准是移动的。
第二层是「意义」的来源问题。书名叫「如何获取意义乃至承担责任」,这个「获取」是核心动词。作者的方案是:一切智能系统都在其所在的环境或「认知生态位」中自我维系,智能与这种自我维系(即对环境的适应)密切相关。所以意义不是从天上掉下来的,是从「维系自身」这个动作里长出来的。
把这两层合起来看,「心之壁」的意思大概是:机器可以做到一切功能,但当它没有「需要维系自身」这件事时,功能就永远只是功能,不会变成意义;而一旦它有了需要维系的东西,责任问题就跟着来了。
这个逻辑链是成立的,而且我认为它比大多数「AI 有没有意识」的讨论都更扎实——因为它把问题从「它像不像人」换成了「它有没有利害」。一个有要害的系统才可能承担责任;一个断电就重启、重启后无所谓的系统,你没法追它的责。
也正是在这个意义上,这本书的副标题和主标题是一件事:获取意义和承担责任,是同一个条件的两个面。
五、我不同意的地方:把大模型说成「在语料环境中自我维系」
前面夸得够多了,现在说我真正有意见的地方。
作者把大模型纳入主动推理框架的方式是:区分它在人工语料环境中的「学习」和它在对话环境中的「推理」,二者分别对应预训练与微调、以及模型与使用者的对话。原话是:
尽管大模型并非如生命有机体一般「典型」的智能系统,但主动推理方案能刻画不同时空尺度的系统与环境的动态耦合,而并未限定耦合双方,即系统与环境的本体论内涵。基于此,我们可以界定大模型的主动推理……尽管这些模型自始至终都未直接接触物理现实。
「并未限定耦合双方的本体论内涵」——这句话是全书论证里最危险的一步。它的意思是:主动推理这个框架只看「耦合」的形式,不管耦合的两端是什么东西,所以语料也可以是环境,模型也可以是系统。
我认为这一步走得太快了,原因是它把「主动」两个字丢掉了。
主动推理(active inference)的完整结构里,最小化预测误差有两条路:一条是改内部模型去迎合世界(这叫感知/学习),一条是改世界去迎合内部模型(这叫行动)。后者才是「主动」的来源——生物不只是预测世界,它还会走过去、伸手、躲开,用行动让预测成真。没有行动通道,主动推理就退化成贝叶斯更新,而贝叶斯更新从 18 世纪就有了,不需要自由能原理来装。
大模型有什么?它有海量的「感知」(读语料),有极快的「学习」(调权重),但它没有「行动」——它不能改变语料的下一句,不能走到环境里做实验,不能让世界因为它的预测而改变。作者自己给出了这个区分:预训练对应「学习」,对话对应「推理」。可这两件事都是「感知侧」的,缺的那一条恰恰是「行动侧」。
所以在我看来:把大模型放进主动推理框架,得到的不是一个「主动」的系统,而是一个「极其被动的系统被一个主张主动的框架描述了」。这在数学上可能成立(形式确实不限定耦合双方),但在解释上会失真——因为它会让读者以为模型和生物在做同一件事,只是材料不同。
更麻烦的是,这个失真的方向恰好是顺着市场情绪的。当下最流行的一句话是「大模型是世界模型」,而这本书的大部分内容其实在反驳这句话(「作为」对「使用」),可一旦它把大模型也纳入主动推理,读者就容易只记住「纳入」这个动作,忘掉「两个世界」那节的限定。我不是说作者错了,我是说这个论证的入口太宽,宽到容易被误读成它想反对的东西。
顺带说一个更技术性的疑问。作者在 8.2 里给了三条要求:通用性(能确保生成符合人类使用者需要的内容)、可信性(能避免生成不符合需要的内容)、可判定性(能从第三人称视角确认是否符合需要)。这三条作为「工程上的验收标准」是清楚的,但它们和前面那套「作为/使用」的存在论区分,其实是两个层面的东西——一个是判据,一个是本体。书里没有明确说这两层怎么接,读者容易把「通过三条验收」误当成「跨过了心之壁」。
六、它的短板
这本书的短板不在学识,在体例和节奏。我列四条,都尽量给证据。
第一,书名与内容之间有真实的落差,而且书里没有提醒。「具身智能」在 2025—2026 年的中文语境里,默认指人形机器人、VLA 模型、灵巧手这一整套工程。这本书用的是 4e 认知科学的「具身」(embodied),讲的是身体结构如何构成认知。两者不是一回事,甚至不在一个层面上:一个是造物,一个是解释造物的框架。
作者其实知道这个落差——第 8 章那节标题直接叫「两个世界:LLM 之不通用」,说明他清楚工程实践和这套理论之间的距离。但这个提醒来得太晚(全书 248 屏,到 207 屏才出现),而且没有放在前言里。前言写的是 2011 年北师大楼顶的那段往事,很好读,但没有交代「这本书不教你怎么做机器人」。一个读者如果在第 20 屏放弃,他得到的印象会是「这书跑题了」,而实际上是他拿错了地图。
第二,类比的密度超过了校验的密度。曾侯乙编钟那个类比是成功的,但全书里同类密度的类比还有很多:衔尾之蛇、概念园林、微缩宇宙里的牛顿、梵蒂冈宫的甲方、五声部赋格、孤独的鱼、蛇衔之尾的茶话会。这些标题都很好看,问题是——好看之后,有多少被逐一校验过?
举一个具体例子。编钟的「强」和形式系统的「强」真的同构吗?编钟的强度是铸造精度决定的物理属性,可以量化到音分;形式系统的强度是可表示陈述的集合大小,是逻辑属性。两者在「能把握多少」这个层面上确实对应,但「为什么恰好是这个对应」并没有被论证,只是被呈现。类比在这里起的作用是「让读者觉得懂了」,而不是「让读者能检验」。
我不反对用类比——这本书如果去掉类比会难读十倍。我反对的是:类比用得多,却没有一处标明「此处仅为直觉,非论证」。读者没有办法分辨哪一段是严格推理,哪一段是修辞过渡。这在硬书里是硬伤。
第三,最后的收尾方式,把 35 屏押在了一场对话上。全书最后一节「蛇衔之尾:阿基里斯、赫克托尔与乌龟的茶话会」占 35 屏,是全书最长的一节(占 14%)。写法是模仿《哥德尔、艾舍尔、巴赫》里的对话体:阿基里斯和赫克托尔在讨论「身份是不是某种比头脑更大的东西」,中间还提到 Copycat 概念网络:
阿:可是赫兄,为什么一个人的身份非得是某种比他的头脑更大的东西呢?它不能是「编程」在他头脑中的一个概念吗?就像编程在 Copycat 概念网络中的那些概念一样?
这个收尾有野心,我承认。它想让全书「衔尾」——开头是蛇咬自己的尾巴,结尾回到同一个问题。但读下来的实际体验是:两个希腊英雄变成了两台上身是人、下身是提问机的装置。他们轮流抛出问题,替作者把论证推进一格,然后等下一个问题。对话体最难的地方是让每个角色有独立的意志和错误,而这一场里,赫克托尔几乎全对,阿基里斯几乎全问——这不是对话,是披着对话外衣的讲授。
而且它放在最后。读者读到这里已经跟了两百多屏的概念、形式系统、主动推理,最需要的是一段收束、一个明确的落点。结果得到的是一场 35 屏的寓言。我会把它形容为:作者把最好的文学野心,放在了读者最没有耐心的地方。
第四,没有索引,也没有术语表。这本书造了一批自有术语:「心之壁」「灵魂连续体」「概念梯度」「范畴连续体」「哥德尔-图灵阈限」。这些词在书里反复出现,含义随章节推进而微调,但没有一处集中定义。248 屏读下来,我对「范畴连续体」和「灵魂连续体」的区别仍不敢说自己抓准了——它们在 3.1、7.1 和 8.3 里各出现一次,每次的用法都略有不同。
这不是小毛病。一本以「澄清概念」为自我定位的书(1.1 里作者的原话是「澄清『心智』是什么、如何呈现,以及有何影响」),最该有的就是一张术语表。它没有。书末只有编号尾注,我翻到最后一页看到的是 [9] 条注,讲《伊利亚特》里「阿开亚人」这个称法在历史上并非源于「廷达瑞俄斯誓言」——一条很认真的注,但它出现在一本没有索引的书里,让人觉得力气使错了地方。
七、怎么读这本书
三条建议,都基于这 248 屏的实际结构。
第一,先读第 6 章和第 8 章,再回头读第 1 部分。第 6 章(预测机器的主动推理)和第 8 章(迈向未来的认知科学)是全书的落点,也是最有现实指向的部分——尤其 8.2 那节「两个世界:LLM 之不通用」,是全书唯一直接和当下 AI 实践对话的地方。先读这两章,你会知道前面那 101 屏的地基是为了撑什么;从前往后读,则很容易在概念与类比里迷路。
第二,把四个自造术语单独抄下来。心之壁、灵魂连续体、概念梯度、哥德尔-图灵阈限。每读到一次,就在旁边记下它当次的意思,读完再对照。这本书没有索引,这是唯一的补救办法。
第三,看到类比就停一下,问一句「这个对应是真的,还是只是像」。曾侯乙编钟那一处经得起问;梵蒂冈宫的甲方、五声部赋格这些,我的建议是先当氛围读,别当论证用。
最后说一句我的整体判断。这本书我读得慢,也确实被它说服了几处——尤其是「作为」与「使用」那个区分,以及 20% 那个数字。但它不是一本能让人「学会做具身智能」的书,它是一本让人「重新想清楚具身是什么意思」的书。在一个人人都在谈具身、但很少有人说得清「身」到底起什么作用的时候,后一种书更稀缺。
只是它取了一个太容易让人误会的好名字。「心之壁」三个字很漂亮,漂亮到会吸引一批想看机器人的读者,然后在前一百屏把他们劝退。这大概是这本书最实际的遗憾:它想跨过的那道壁在心智里,但它自己先撞上了一道壁——书名与读者预期之间的那道。
阅读记录
书名:心之壁:具身智能如何获取意义乃至承担责任
作者:刘林澍|出版社:机械工业出版社|出版时间:2026-01-23|ISBN:9787111800521
本次阅读:微信读书逐页截图 248 屏,版权页至「全书完」全覆盖,两篇序、前言、第 1 部分 4 章、第 2 部分 4 章、尾注全部读完,抓取标记为全书读完(end=last_page),耗时 365 秒
篇幅分配(按章节起始页相减):前置 14 屏(5.6%)/ 第 1 部分 101 屏(40.7%)/ 第 2 部分 129 屏(52.0%);最长一节为收尾对话体 35 屏(14.1%)
说明:本文引句均来自本次截图,可逐字核对;书中引用的神经科学数据(外侧膝状体核约 20% 输入来自视网膜神经节细胞、人眼间距 5~7 厘米、锤头鲨眼距可达体宽一倍)为作者原文引用,我未做二次核实
逐页精读系列 · 2026 年 11 月
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: