
中国AI下半场:投资人访谈录:共识很密,判断很稀
微信读书《中国AI下半场:投资人访谈录(轻访谈)》· 本次逐页翻阅 320 屏,从版权信息读到「全书完」,107 个标题全部覆盖,抓取标记为全书读完(end=last_page),耗时 372 秒。采访 Nico,编辑 Nico、万户。书末微信读书推荐值 72.5%,92 人点评。
说明:这是一本访谈集,十节人物访谈加一段合并问答。对访谈集我只关心两件事:不同人回答同一个问题时口径差在哪,以及有没有人肯承认自己判断错过。
先说结论:这本书的信息密度很高,判断密度很低。十一位访谈对象回答了同一批问题,几乎每个人的答案都能互相替换——十个人说「Agent 还没有共识」,十个人说「PMF 的有效期变短了」,十个人说「大厂做的是共识的事,机会在非共识的地方」。这些话都对,但它们拼在一起不构成判断,只构成气氛。
它是「下半场」这个说法最好的一次现场记录,也是「下半场」这个说法最空的一次论证:全书没有一处告诉我们,下半场从哪一天开始,谁在上半场输了。
一、这本书里有两种结构,只有一种是它自己的
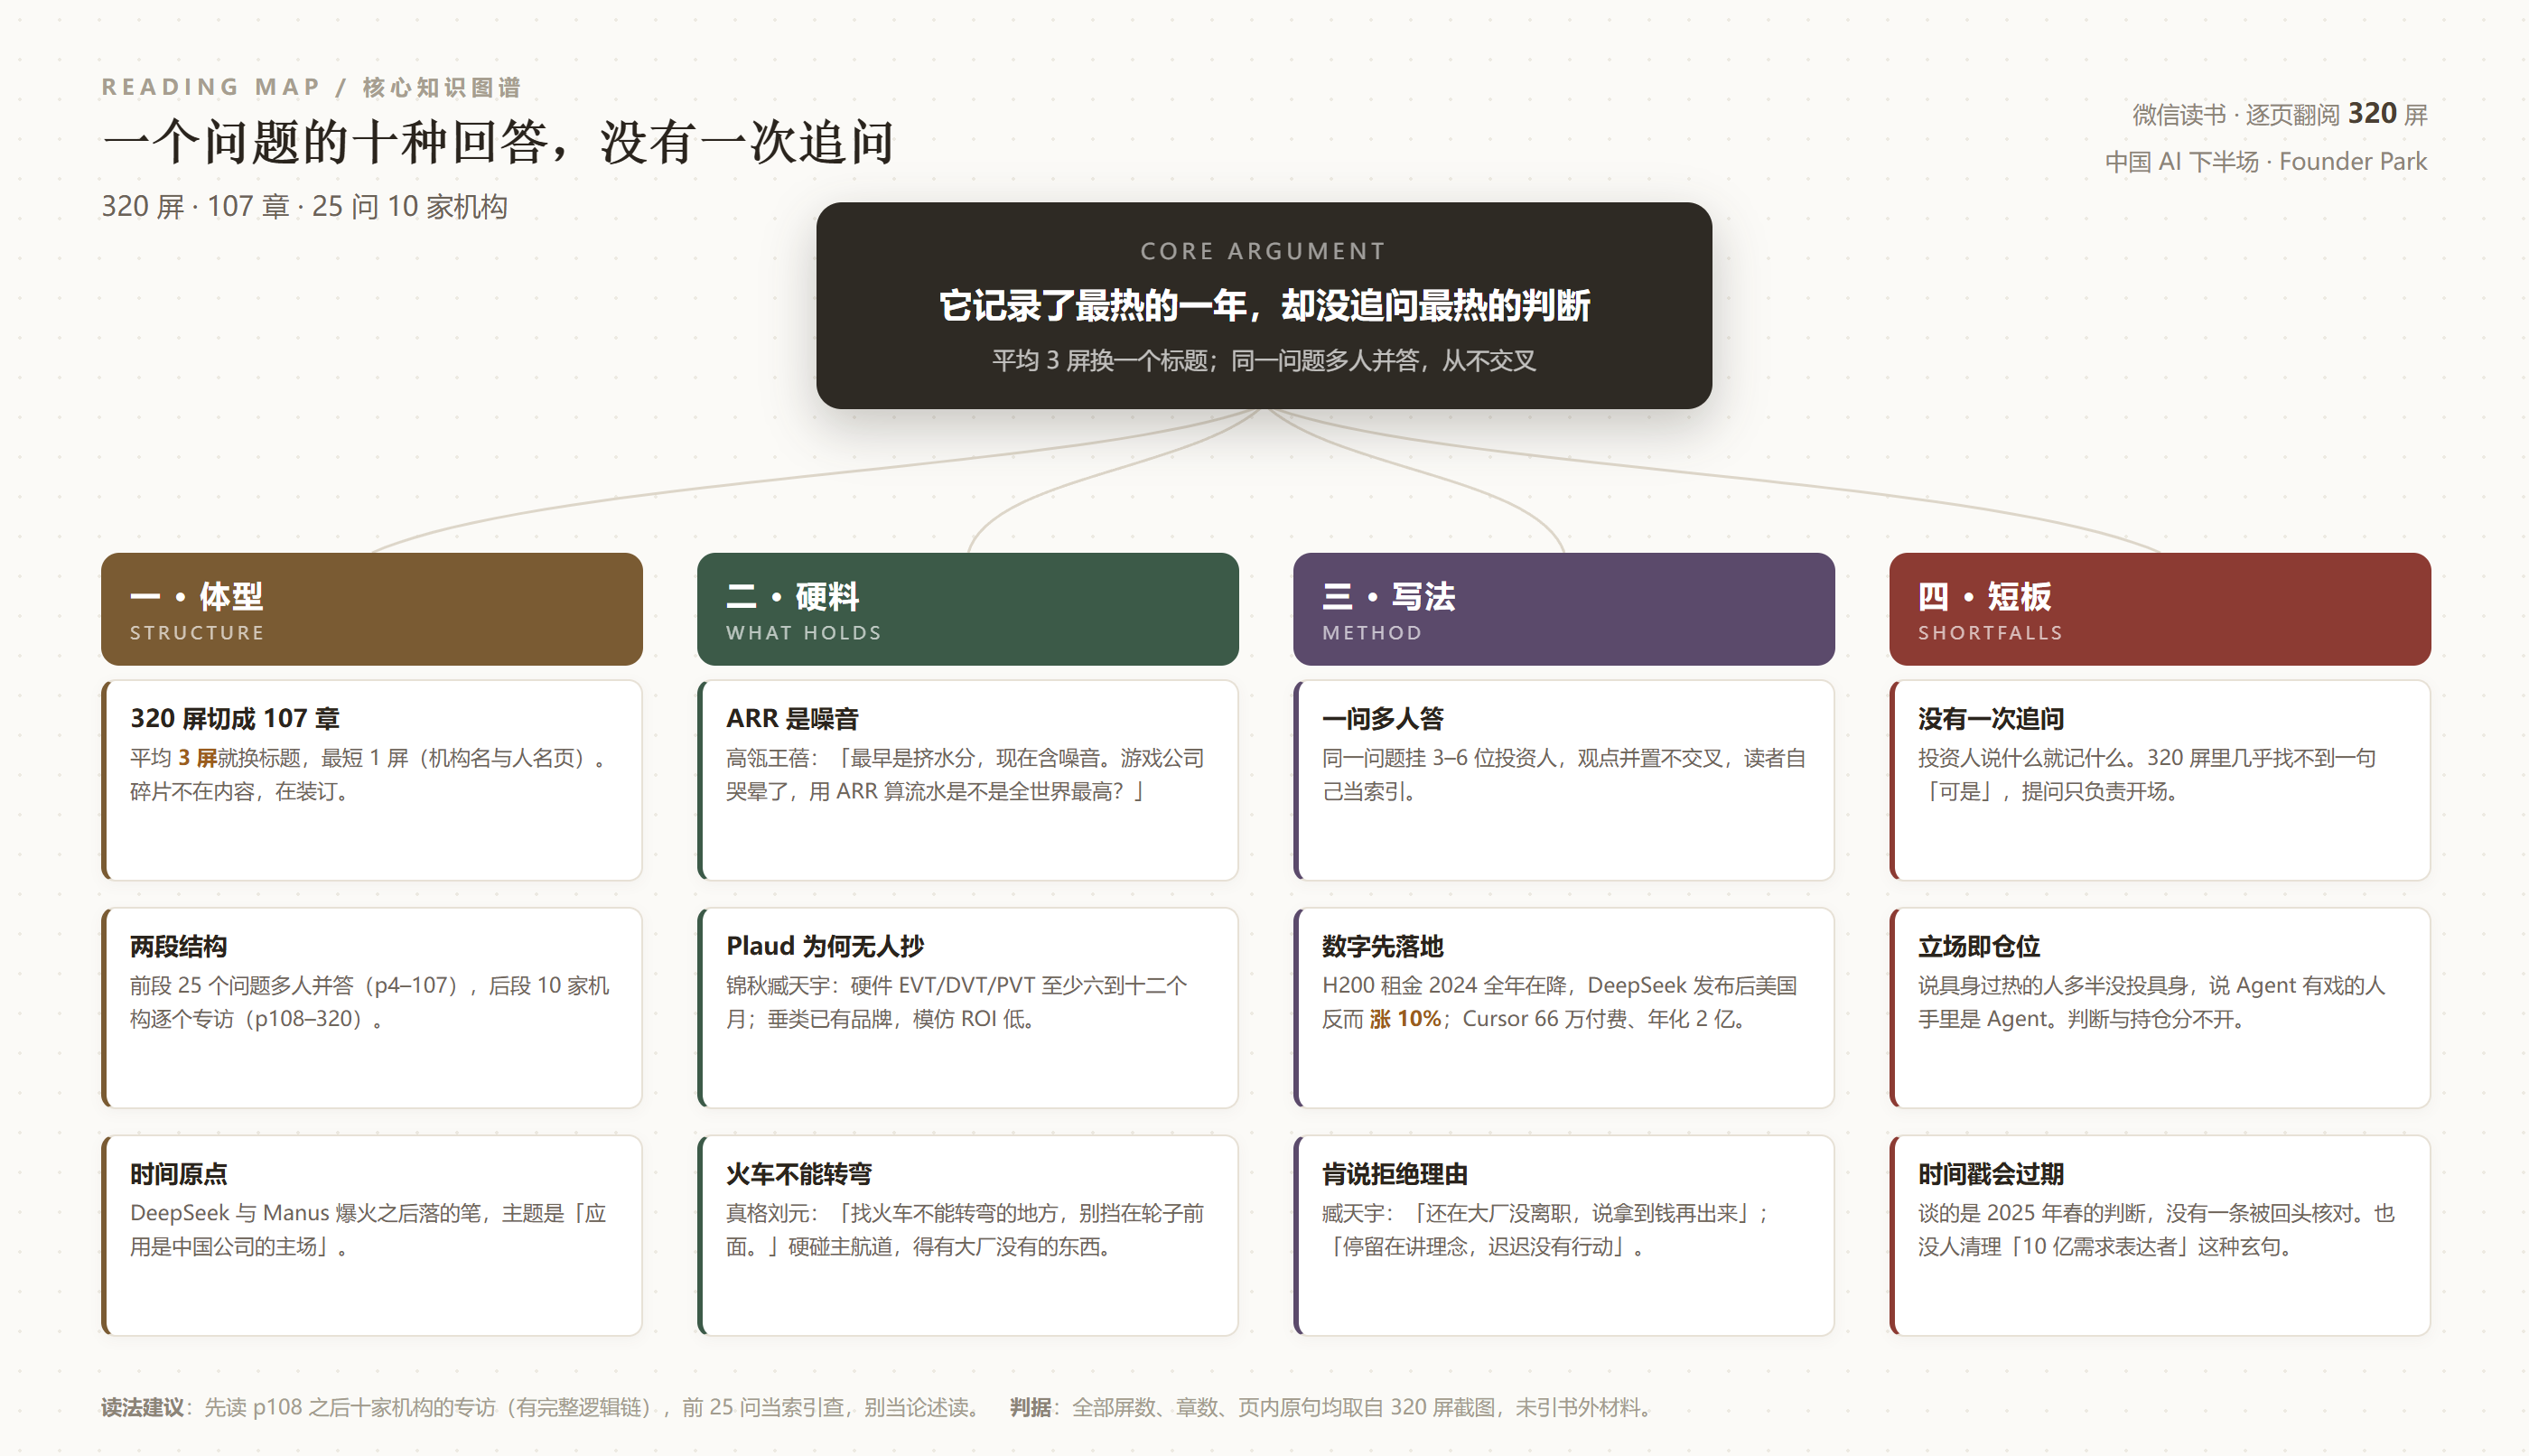
320 屏不是随手排的,我按页统计了一遍章节归属,结构很清楚。
第 1 屏是版权信息,第 2 屏是那页只有一行字的「练习时长两年半的中国AI投资人」,第 3 屏是引言。第 4 到第 107 屏是 25 个问题的合并问答——一个问题抛出,三四个投资人接力回答,答的人名字写在冒号前面:「高瓴创投王蓓:」「锦秋基金臧天宇:」「明势创投夏令:」。这一百来屏占全书 32.5%。
第 108 屏开始换了一种排法:一张只有机构和人名的分节页,然后是一节一节的单独访谈。十节,11 个人(Creek Stone 那节是李一豪、钟陆欢两位),从 22 屏到 29 屏不等:Alphaist 陈哲 22 屏、Atypical Ventures 邵帅 29 屏、Creek Stone 22 屏、创新工场任博冰 20 屏、高瓴创投王蓓 18 屏、锦秋基金臧天宇 22 屏、靖亚资本何沛 21 屏、明势创投夏令 17 屏、线性资本郑灿 19 屏、真格基金刘元 23 屏。合计 213 屏,占 66.6%。
两种排法的价值差得很远。前半段按问题排,你第一次能在一个屏幕上看到分歧:同一个「通用 Agent 会不会被大厂吃掉」,陈哲说通用 Agent 最终跟着模型水平走、Manus 现在推出的是「偏通用的形态」,夏令说「大厂往往做的是共识的事情」,何沛直接给了策略——「规避国内泛C用户的通用的 Save Time Agent 市场」。三个答案并排放着,你能自己算出他们各自的仓位。
后半段按人排,就变成了标准的机构介绍加个人履历。几乎每节的第一个小节是「新基金/机构介绍」,第二、三个小节是「投资策略:看好哪几个方向」,最后一个小节是「能为创业者提供什么支持」。十节里至少七节走的是这条流水线。换句话说,这本书真正原创的部分只有前面那一百来屏;后面 213 屏是把同一份问卷拆开、按人名重新装订了一遍。
这个判断不是刻薄。你在第 85 屏会读到「为什么要出来做新基金」,在第 159 屏读到「新基金聚焦AI,和创始人连接更紧密」,在第 181 屏读到「创新工场的投资策略」,在第 241 屏读到「靖亚资本的投资策略:看好五大方向」——四个机构、四个小节,讲的是同一件事:我们为什么值得被投。这部分内容对募资有用,对读者没用。
二、最有用的一幕:同一个产品,两个口径差三倍
全书我最想标出来的一处,在第 119 屏,讲 Plaud。
这一屏有个深色方框,是编者给产品做的名词卡,写得很具体:「Plaud Note 是 PLAUD.AI 的首款产品,AI 智能会议纪要录音笔……全球首款搭载 ChatGPT-4 的 AI 录音笔,交付超 30 万台,采用了『硬件+订阅』并行的收费模式,年化收入达到一亿美金。」还给了公司信息:2021 年在美国成立,许高创办,此前投资过早期 FA 机构小饭桌。
紧接着,同一个屏幕下方,Alphaist 陈哲的原话是:「Plaud 应该有接近百万的销量。我觉得它与其说是硬件产品,可能软件的部分占比还更大一些,因为它的硬件相对简单……」
「交付超 30 万台」和「接近百万的销量」印在同一屏上,差了三倍以上,书里没有任何一处对账。这不是小事,因为它直接决定你怎么读这个案例。按 30 万台加一亿美元年化收入算,单台年化约 333 美元;按百万台算,单台年化只有 100 美元上下。前者说明「硬件只是入口,订阅才是生意」,后者说明「这是一门靠规模摊薄硬件成本的消费电子生意」。两种读法对应两种完全不同的公司,而这本书把两种读法并排放着,让读者自己挑。
公允地说,这可能不是编者的疏忽,而是访谈体的物理限制:「接近百万」是估的,「30 万台」是公司口径,两者本来就不是一个东西——一个是销量,一个是交付量;一个可能含渠道,一个可能不含。但正因为不是一个东西,才更需要一句注释。一本 320 屏的书,连一句「两个数字口径不同」都不肯写,读者就只能记住一个大致的印象:「Plaud 很成功」。
而这个印象正是全书最不缺的东西。Manus 成功、Plaud 成功、DeepSeek 成功、Monica 成功,四个案例反复出现在不同访谈里,像四根柱子撑起整本书。第 4 屏的第一个问题就是「如何定义 Manus 的成功?」,第 298 屏之后真格刘元那一节,Manus 又出现两次:「投人的胜利」「平凡人做不凡事」。
三、全书最锋利的一句,在 ARR 那节
第 212 屏,高瓴创投王蓓那一节,小标题直接就是判断:「ARR 原本是为了『挤水分』而发明的指标」。
提问是「最近 ARR 这个指标很火,行业里有争议,您怎么看」,她的回答值得整段抄下来:
ARR 这个事最早其实是个「挤水分」的概念,但现在反而可能包含了很多噪音。我们开玩笑说,游戏公司哭晕了,要是用 ARR 算流水,那游戏公司是不是全世界 ARR 最高的?
收入往往是一个滞后的结果,前置的是高质量的用户行为。哪怕一个产品不产生收入,但用户行为质量很高,我们也认为它是高质量的产品。反之,如果只是通过各种手段(比如利用情绪 FOMO)促成了一个付费转化行为,但用户后续的使用频次、场景并不理想,那个转化本身意义也不大。
这是全书唯一一处把「指标」当对象来审的地方。它做了三件事:指出指标的来历(挤水分)、指出指标的失效方式(噪音、口径混乱)、给出替代方案(看转化漏斗每一层怎么形成、看付费后的留存与频次)。一段话里同时有历史、有反例、有替代,这在 320 屏里是极稀有的密度。
紧接着的第 213 屏,提问者提到了一个更具体的争议:「GenSpark Agent 发布 10 天就给出了 ARR 数据,其实这在业内有些争议。」这是一个可以立刻接住的话头——10 天的 ARR 怎么算?年化是不是把试用期收入也乘了 12?——但回答转向了别处:「每家公司在每一个当下的动作,背后可能有各种原因……我们还是强调,要有足够的同理心。」
这就是访谈集最典型的「差一口气」:最锋利的问题被问出来了,最该追的一句没追。我不怪受访者,她选择不评价同行是职业礼貌;我怪编者——同一次访谈里,前面刚讲完 ARR 是挤水分的概念,后面遇到一个「10 天 ARR」,这本该是全书最好的一段追问。
四、能对账的数字,一共四个
320 屏读完,我把所有带单位、带量级的数字抄了一遍,能拿去和别人对账的一共四个。
第一,Plaud:交付超 30 万台,年化收入一亿美元,2021 年成立(第 119 屏方框)。第二,某垂直领域 AI Agent:一年时间在国内做到 1000 万美元 ARR(第 272 屏,何沛)。第三,Devin:2024 年 12 月开启商业化,Team 客户每人每月 500 美元(第 24 屏方框,同时给了 Cognition AI 2024 年成立于旧金山、创始人 Scott Wu 是华人创业者)。第四,MiniMax 的海螺 AI 全球流量「远超快手的可灵」(第 41 屏,夏令)——这是唯一一处市场份额对比,可惜只有结论没有数字。
四个数字里,三个是单价或年化收入,没有一个是市场规模。这个比例说明一件事:投资人谈的是判断,不是财报;而判断在没有数字支撑时,只能靠语气加强。于是全书出现大量「非常非常早期」「远远没有共识」「极其重要」——第 66 屏讲视频生成,标题就是「视频生成还在非常非常早期」。
我并非要求访谈集变成行业报告。但至少,「大厂」「六小虎」「具身智能」这些反复出现的名词,应该各有一处规模数字。第 41 屏夏令讲模型层面时说得挺实:「文本大模型,DeepSeek 从投入量级、人员规模、卡的资源数量上看,都无法与字节、阿里等传统大厂相比。」——这句话的信息量全在「量级」两个字上,可惜没给量级。
顺带说一句,第 6 屏那段转型史写得比很多数字有意思:蝴蝶效应第一次创业做运营工具(壹伴助手、微伴助手),后来卖给独角兽公司;第二次按「中国的 Benching」方向做天使轮;第三轮主产品是 Monica 插件,收购了 ChatGPT for Google;再后来做 Monica.im。刘元在这里加了一句判断:「这个过程充满了演进和转型,它不是一个典型的『Agent公司』做出来的产品。」这句话值得抄下来,因为它解释了为什么这本书里所有成功故事都不像计划出来的。
五、具身智能:同一句判断说了两遍
第 61 到 62 屏,两屏,标题是「被高估的和被低估的,都是具身智能」。第 231 到 232 屏,又是两屏,标题是「最被高估的和最被低估的,都是具身」。
同一句判断,在相隔 170 屏的两个不同投资人那里,用几乎一样的措辞说了两遍。这在我看来是全书最有信息量的一处「重复」:它证明这句话已经是这一轮投资圈的共识句,而不是某个人的独立判断。当一句话被复述到措辞都趋同,它就不再是洞见,而是口令。
更要紧的是,这句话在逻辑上是偷懒的。「被高估」说的是当下的估值,「被低估」说的是长期的价值,两者可以同时成立,因为尺度不同——高估的是这一轮的价格,低估的是十年后的位置。把两个不同尺度的判断并列成一句俏皮话,结果是读者既不知道什么时候该谨慎,也不知道该在什么位置进。一句同时包含「高」和「低」的判断,等于没有给出时间。
相比之下,第 58 屏邵帅讲 AI 玩具那段,反而是全书最像产品课的内容。他先给了一个机制:「CES 上 Robopoet 推出的 AI 萌宠机器人 Fuzzoo,将五行(金木水火土)做成了五个毛绒形象,具备轻度的智能互动(例如摸摸它,眼睛会动)。它的『开口说话』能力,必须通过用户完成一些任务(比如喂食、抚摸)来逐步解锁。」然后给结论:「如果初创公司仅仅依靠引入成熟的 IP,实际上是在为像迪士尼、万代这样的巨头打工。」
这段好在哪?它把「情感陪伴」这种虚词拆成了一个可验证的机制:说话能力被当成奖励,而不是默认功能。这一步很关键——默认会说话,玩具就是个会应答的音箱;要解锁才会说话,玩具才有「养成」这件事。全书 320 屏,只有这一处把产品体验落到具体操作上。同一节里他还说「得 IP 者得天下」,这句话粗暴,但它是判断,不是气氛。
六、它的短板
第一条,也是最硬的一条:没有时间戳。320 屏里,唯一明确的日期是 Devin 的「2024 年 12 月」和 PLAUD 的「2021 年成立」。十一次访谈发生在哪个月、哪一季,读者不知道。这不是小毛病:书里反复出现「DeepSeek 爆火之后」「过完年,项目普遍变贵了」这类相对时间句,而投资判断的有效期以季度计——第 79 屏的标题就叫「PMF 的有效期变短了」。一本论证「判断会过期」的书,自己不标生产日期,这是结构性缺陷。
第二条:没有输家。十节访谈,没有一次「我错过了哪个项目」「这个判断我当时看错了」。谈失败的部分最多到「我们当时没投」——第 304 屏刘元讲早期浏览器产品:「挂出去试试呗,有人用就用,没人用就算了。他不发,就是不发。」这段讲的是创业者的取舍,不是投资人的失误。一本访谈集如果没有一次认错,它记录的就只是幸存者的记忆。
第三条:名词卡和正文不对账。Plaud 30 万与百万那一处已经说过。第 24 屏的 Devin 名词卡也一样:给了 2024 年 12 月商业化、500 美元/月的定价,却没给客户数或收入——而这个产品恰好是「Coding Agent 商业化」的标志性案例,缺的正是最该有的那个数。
第四条:口语没有整理。第 24 屏连续几段把 ComfyUI 和 Devin 缝在一起讲,中间靠「所以,我不认为 GPT-4o 的能力会简单地颠覆 ComfyUI 或基于它的应用生态」硬拐过去。这不是受访者的问题,是整理者没做分段。全书大量段落以「所以」「然后」「其实」开头,读起来更像逐字稿。作为「轻访谈」这可以理解,但它和 320 屏的体量不匹配——体量越大,越需要编辑动手。
第五条:目录不可回查。107 个标题里,除了 10 张分节页,没有任何一节标明「这话是谁说的」。合并问答部分靠正文里的「某某:」区分,人物访谈部分靠上一张分节页。这意味着你想找「谁说过规避泛 C 市场」,得逐屏翻——而在一个判断高度趋同的文本里,认人恰恰是最重要的事。
第六条:「大厂」是一个词,不是一组公司。字节、阿里、腾讯在书里反复并列,第 39 屏的标题是「通用Agent在大厂射程范围内」,第 255 屏问「如何扛得住大厂的进攻」。但没有一位受访者拆开讲:字节的流量分发、阿里的云与电商、腾讯的社交入口,对创业公司的威胁方式完全不同。把它们合成一个词,结论只能停在「要么出海,要么做垂直」。
七、谁该读,怎么读
如果只读一百屏,读第 4 到 107 屏的合并问答。这是全书唯一能看出分歧的地方,而且问题本身问得不错:如何定义 Manus 的成功、DeepSeek 改变了什么、六小虎接下来如何、「模型即产品」是不是错觉、为什么 Plaud 没有竞争对手、通用 Agent 在不在大厂射程内、Coding 是不是 AGI 的主线。
如果按方向挑:做产品的读王蓓那 18 屏(第 201 到 218 屏),她对指标的审法可以直接搬去用;看赛道的读何沛那 21 屏(第 241 到 261 屏),他给了「Save Time / Kill Time」这个二分,还给了垂直 Agent 的具体数字;关心具身的读邵帅那 29 屏,Fuzzoo 那段值得单拎出来。
可以直接跳过的,是所有「为什么出来做新基金」「机构投资策略」「能给创业者提供什么支持」的小节——加起来大约 40 屏,属于募资材料。
最后说一句真实的感受。这本书的结尾在第 320 屏,刘元那句话我读了两遍:「真正的好公司,不太需要投资人帮太多忙。」这是全书最诚实的一句,也是最像自我否定的一句。一本由投资人主讲的访谈集,最后落在「投资人帮不上太多忙」,其实已经把这本书的性质说清楚了:它记录的是他们的观察,不是他们的作用。
而观察这种东西,只有在给出时间、给出数字、给出反例的时候才是知识。这本书有很好的问题单,有几位答得极实的受访者,但它把这些散着放,没有对账、没有标注、没有追问。于是它成了一本很好读、很难引用的书——你可以一口气读完 320 屏,合上之后能记住的产品只有 Plaud、Manus、Fuzzoo 三个,能记住的判断只有一句「ARR 本来是挤水分」。
对一本访谈集来说,这不算失败;对一本叫「下半场」的书来说,这远远不够。下半场要的不是气氛,是站位。
书名:中国AI下半场:投资人访谈录(轻访谈)
本次阅读:微信读书逐页截图 320 屏,版权信息 + 引言 + 25 个问题的合并问答 + 10 节人物访谈,107 个标题全部覆盖,耗时 372 秒,抓取标记
end=last_page。未读到:无。全书一次抓完,书末出现「全书完」与推荐值页面(72.5%,92 人点评)。
判断依据:屏数与章节归属按 pages.jsonl 逐页统计(第 4 至 107 屏为合并问答,第 108 至 320 屏为 10 节人物访谈);引文均来自截图原文,页码为本次截图编号(如 p0119 即第 119 张截图)。书中方框名词卡由编者撰写,与受访者口述口径不同,本文已分别标注。
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: