
数据与AI战略:它用 255 屏照镜子,用 17 屏决定干什么
微信读书《数据与 AI 战略:企业实现指数级增长的实战指南》(莉莲·皮尔森)· 本次逐页翻阅 459 屏,从版权信息读到第 17 章末尾,4 部分 17 章全部覆盖,抓取标记为全书读完(end=last_page),耗时 903 秒。
说明:这是本写给管理者的战略书,我这次只问一个问题:它说的「战略」,到底有多少是在讲「选择做什么」,有多少是在讲「先把家底摸清」。
459 屏,17 章。平均每章 27 屏。
先给结论:这本书不是一本讲「战略」的书,是一本讲「体检」的书。
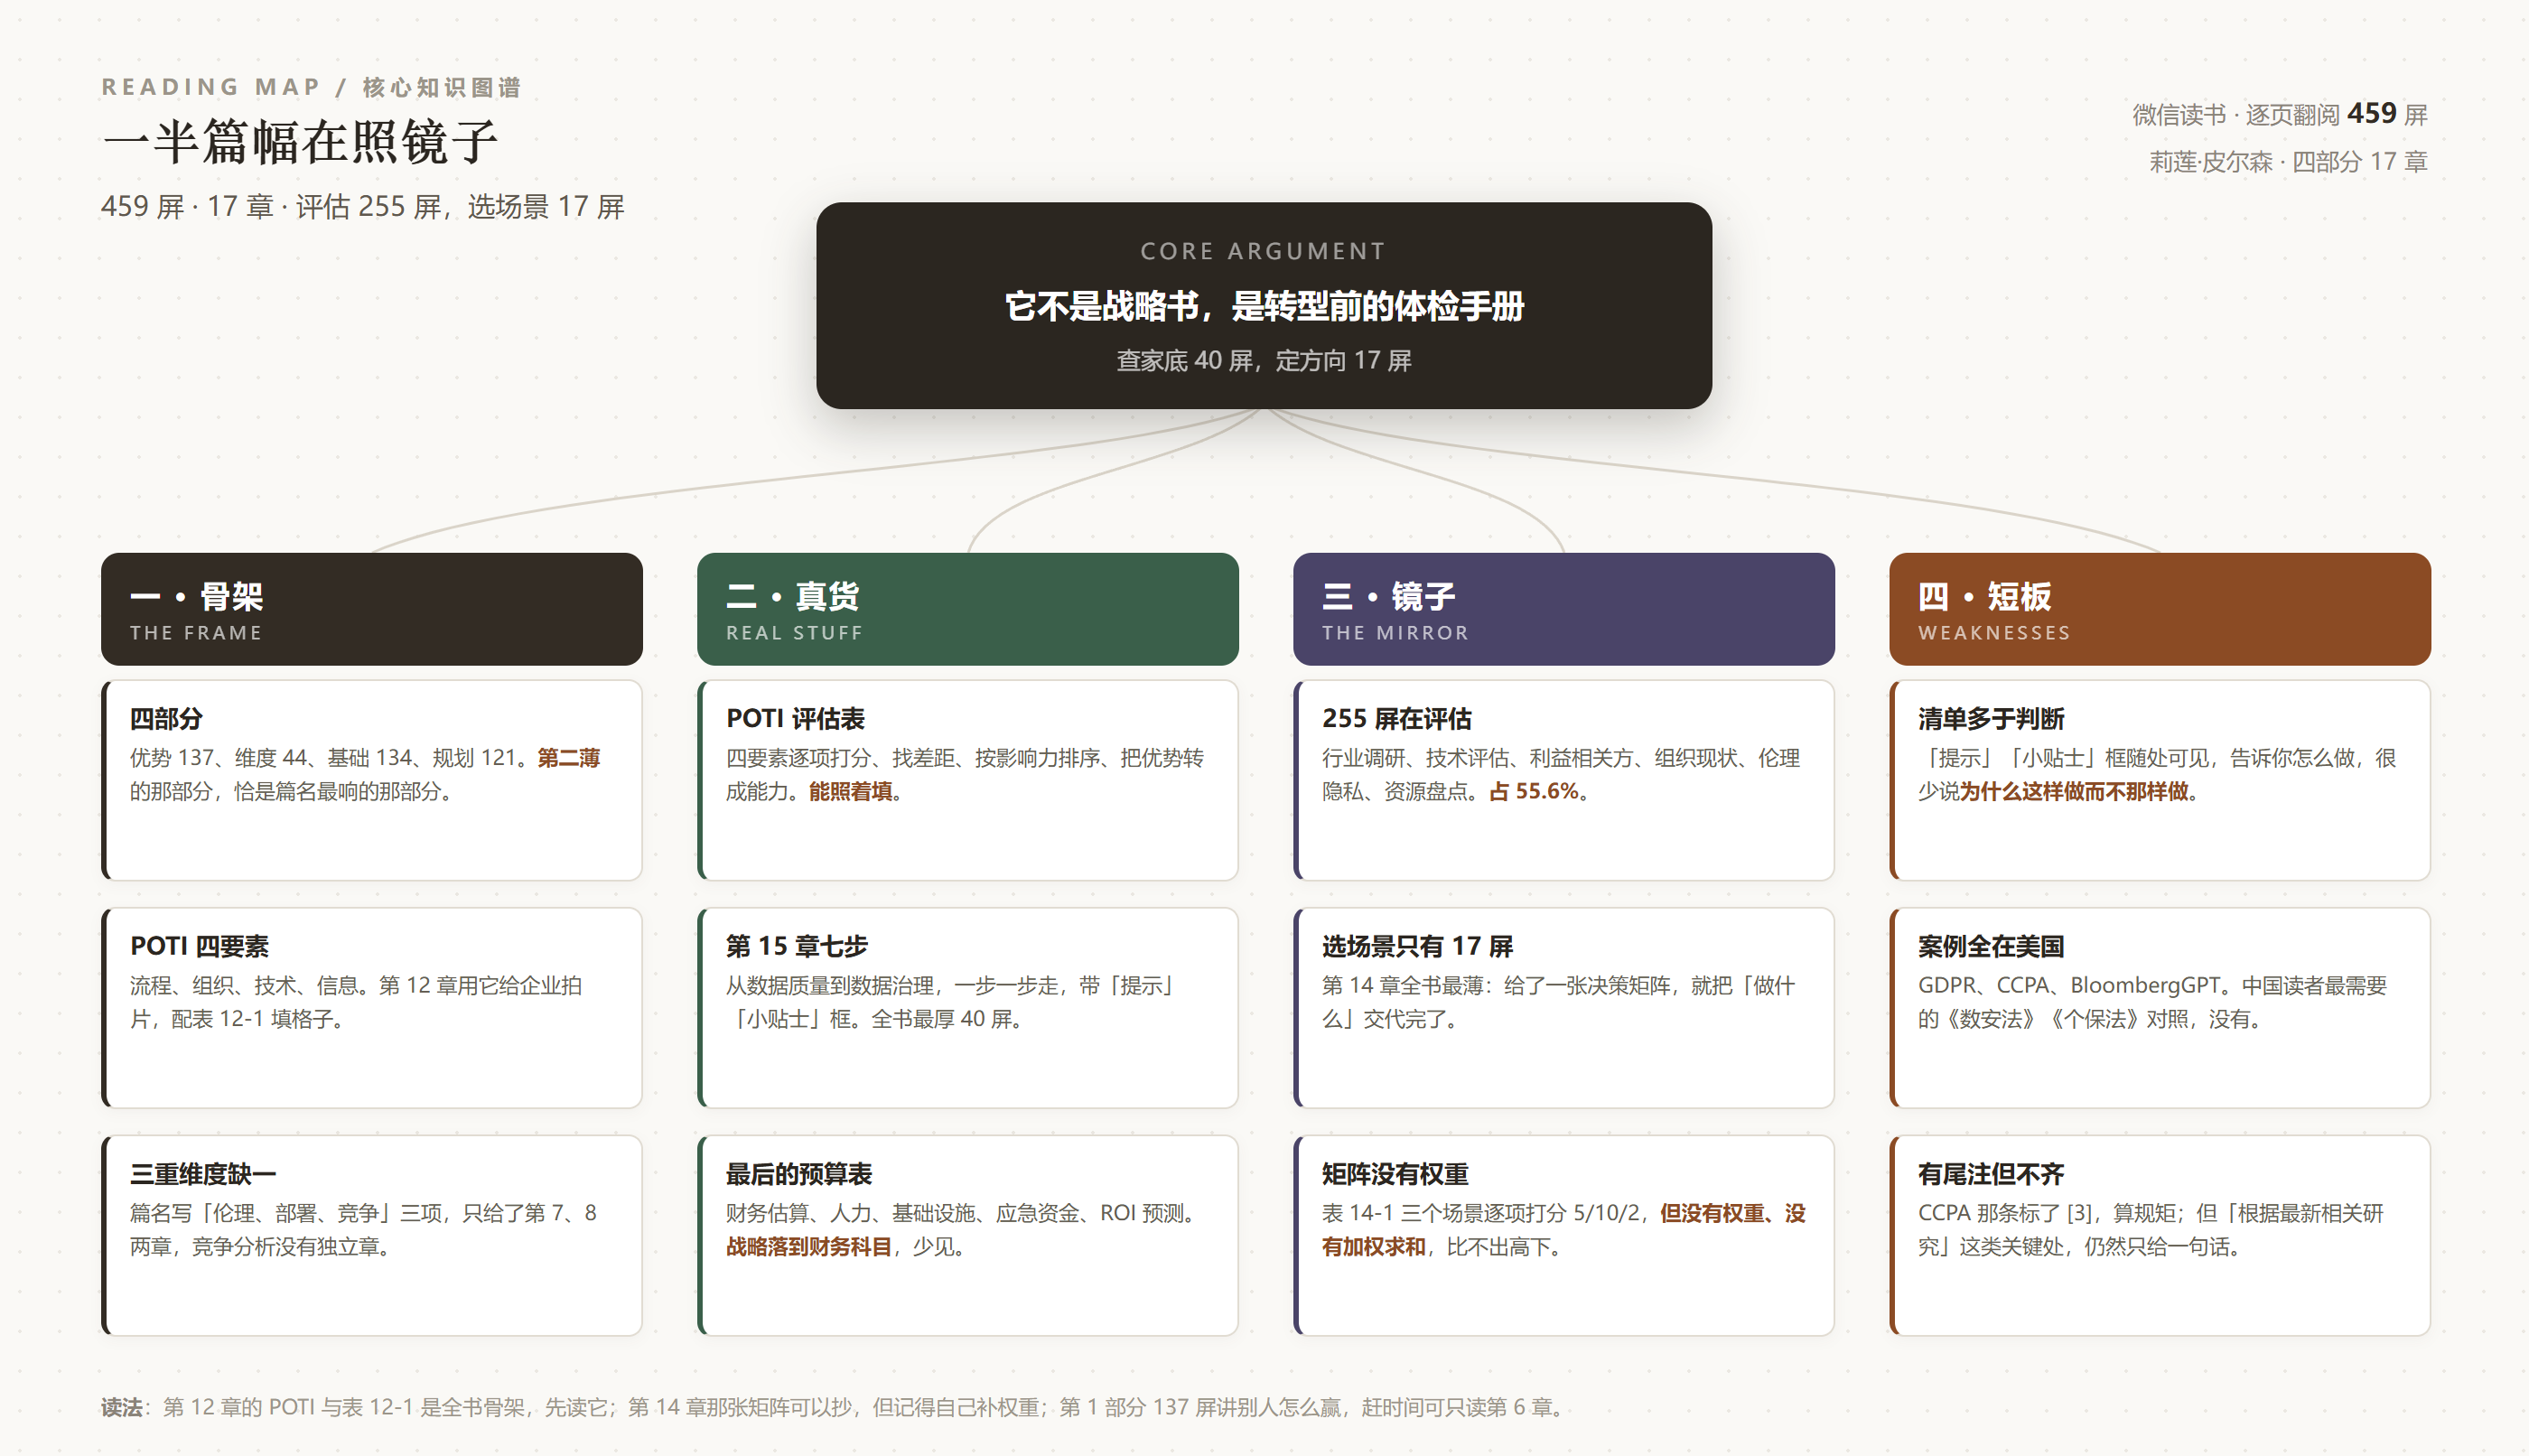
把它 459 屏摊开数,四部分是这样分的:讲别人怎么赢的 137 屏,讲伦理与部署的 44 屏,讲怎么评估自己的 134 屏,讲怎么写出规划的 121 屏。第三、第四部分加起来 255 屏,占 55.6%,全部是「评估—规划」的流水线:调研行业、评估技术、拉利益相关方、评估组织现状、评估伦理与隐私、盘点资源、排优先级、做预算。
而真正回答「我该做哪个场景」的第 14 章,全书 17 章里最薄,只有 17 屏。
这个结构不是缺陷,是一种判断。它等于在说:大多数企业 AI 转型失败,不是因为选错了场景,是因为根本没搞清楚自己有什么。这个判断我部分同意,但它也带来一个副作用——一本叫「战略」的书,把最需要判断力的那一步,交给了读者自己。
一、459 屏的账:137 : 44 : 134 : 121
逐章统计,屏数如下:
第 1 部分「数据与 AI 在现代商业中的竞争优势」:第 1 章「构建公平竞争新格局」18 屏、第 2 章「数据战略导论」20 屏、第 3 章「基于业务目标的数据密集型应用场景分类」21 屏、第 4 章「数据与 AI 驱动的产品主导增长」24 屏、第 5 章「数据与 AI 驱动的营销效能提升」22 屏、第 6 章「验证产品市场契合度」32 屏。合计 137 屏,占 29.8%。
第 2 部分「数据与 AI 的三重维度:伦理考量、部署策略与竞争分析」:第 7 章「遵循监管与伦理标准」20 屏、第 8 章「成功部署 AI 的实施策略」24 屏。合计 44 屏,占 9.6%。
第 3 部分「支持增长的技术基础」:第 9 章「行业与组织调研」26 屏、第 10 章「技术评估」22 屏、第 11 章「利益相关方的参与和数据素养能力」24 屏、第 12 章「评估组织的现状」33 屏、第 13 章「评估当前状态:AI 伦理与数据隐私」29 屏。合计 134 屏,占 29.2%。
第 4 部分「AI 战略的制定与实施」:第 14 章「筛选并界定最佳应用场景」17 屏、第 15 章「评估全部相关资源」40 屏、第 16 章「技术战略规划」31 屏、第 17 章「制定最终战略规划」33 屏。合计 121 屏,占 26.4%。
四部分 436 屏,加文前 23 屏(版权、文前、译者序、推荐序、前言、致谢),合计 459 屏,数对得上。
这个分布里,有三处值得说。
第一处:第 2 部分 44 屏,是四部分里最薄的,而它的篇名最长、最唬人。「数据与 AI 的三重维度:伦理考量、部署策略与竞争分析」——念起来像全书的纲领,实际上只给了两章:第 7 章讲伦理与监管,第 8 章讲部署,加起来 44 屏,占 9.6%。第三个维度「竞争分析」,没有对应的章。
更尴尬的是位置:竞争这件事,第 1 部分已经用 137 屏讲完了(讲别人怎么赢、产品怎么主导增长、营销怎么提效)。所以「三重维度」里的第三维,其实被挪到前面去了。篇名成了一个对不上的承诺。
第二处:第 3 部分叫「支持增长的技术基础」,五章里有三章的名字是「评估」。行业与组织调研(评估外部)、技术评估、利益相关方参与、评估组织的现状、评估当前状态。篇名说「技术基础」,内容是「体检项目」。
这不是笔误。第 3 部分的第 12 章「评估组织的现状」33 屏,用了整整一章教你怎么给自己拍片子——这个位置在一本战略书里,本该放「行业格局」或者「技术选型」。作者把它换成了「自我评估」,说明他真心认为:先看清自己,比先看清世界重要。
第三处:全书的节奏是「倒着走的」。正常的战略书是「定方向 → 配资源 → 排计划」;这本是「看别人 → 守规矩 → 查自己 → 再定方向」。方向放在最后 121 屏里。这个顺序像咨询公司的项目流程(诊断—方案—落地),不像一本给人读的书。它的好处是每一步都可交付,坏处是读者读到第 300 屏还没见到「该做什么」。
二、它的骨架是 POTI:流程、组织、技术、信息
这本书真正原创的东西,是第 12 章里那个四要素模型。书里叫 POTI。
原文的用法是这样:先按前面几步把数据、流程、技术摸一遍,然后「构建 POTI 模型」,具体四步——
(1)阐释流程、组织、技术和信息四要素之间的相互作用机制。
(2)找出当前运营中存在的差距、薄弱环节或效率瓶颈,并分析这些问题对数据战略的潜在影响。
(3)鉴于不同差距对整体战略的影响程度不同,应根据其影响力进行优先级排序,优先解决最大的问题。
(4)充分发挥你在 POTI 模型中识别的优势领域,探索如何将这些优势转化为组织能力的提升。
然后是一句很实在的话:「要得出 POTI 模型的结果,只需要填写一个类似表 12-1 的表格」。
这个模型的聪明之处,在于它把「技术」放进了四个格子里的一个,而不是中心。大多数企业做数字化转型,默认的思路是「先上系统」——买数据中台、上 BI、接大模型,技术是主角,流程和组织是被改造的对象。POTI 反过来:流程、组织、技术、信息是四个平等的格子,你要画的是它们之间的连线,哪条线断了,问题就在哪。
这条思路在书里有具体的落地。第 12 章的小贴士写得很直接:「在执行这一步骤时,应当重点评估数据对决策方面的实际可用性。同时,需要识别组织内部存在的各类数据孤岛现象,并考虑到数据集中化的可行方案,以提升数据的整体使用效率。」
「数据对决策的实际可用性」——这七个字是全章的关键。它评估的不是「我们有多少数据」,是「这些数据有没有真的被用来做过决定」。很多企业的数据资产在报表上很漂亮,在会议室里一次没被打开过。POTI 的用处,就是把这层窗户纸捅破。
但 POTI 有一个我没想通的地方:它给的是四个格子,没给四个格子的权重。四要素之间哪个更要紧?一家流程混乱但数据齐全的公司,和一家流程规范但数据一团糟的公司,谁更该先做 AI?POTI 只说「根据影响力排序」,但影响力怎么算,没有公式,也没有示例分值。
这一点在第 14 章那张决策矩阵上又出现了一次,下面会细说。
三、255 屏在照镜子,17 屏在决定干什么
把第 3、第 4 部分连起来看,是一条完整的「自检流水线」:
第 9 章调研行业与组织(外部长什么样);第 10 章评估技术(手上有什么工具);第 11 章拉利益相关方、算数据素养(人有几分本事);第 12 章用 POTI 拍片子(内伤在哪);第 13 章查伦理与隐私(哪条红线不能碰);第 15 章盘点全部资源(钱、人、设备够不够);第 16 章做技术战略规划;第 17 章出最终规划与预算。
八章,255 屏。这套东西的价值是真实的——如果你是一家传统企业的数字化负责人,手上没有一个现成的评估框架,这 255 屏可以直接当工作底稿用。每一步都给了要填的东西,甚至给了「小贴士」提醒你常见坑。
但八章里,只有一章在回答「做什么」:第 14 章,17 屏。
这 17 屏干的事是这样的:先用前面评估的结果,把候选场景列出来;然后「建议使用多准则决策矩阵作为备选方案分析的工具」;接着给表 14-1「潜在应用场景评估决策矩阵示例」。
表 14-1 长这样。横着是三个候选场景,竖着是考量因素,每个格子打分,1~10 分,1 分非常不利,10 分非常有利。因素分三组:
业务目标契合度:应用场景的目标与当前业务目标的契合度。场景一 5 分、场景二 10 分、场景三 2 分。
业务价值,拆四项:成本降低(7/7/10)、收入增长(6/10/8)、客户体验提升(9/6/5)、风险控制(5/6/10)。
实施可行性,拆两项:所需数据的可用性(10/8/10)、法律监管合规性(10/10/9)。表格续页还有一项「资源可用性:现有人员/技能的充足性」(9/7/10)。
这张表很有用,因为它把「拍脑袋选场景」变成了一件可以开会讨论的事。三个场景摆在一起,谁在哪一项强、哪一项弱,一目了然。
但它缺了最关键的一件东西:权重。
这三个场景到底谁更该做?看分数:场景一契合度只有 5,但客户体验 9 分最高,数据可用性满分;场景二契合度和收入增长都是满分,但风险控制和客户体验偏低;场景三成本降低和风险控制满分,可契合度只有 2 分。
没有权重,这三列分就没法加总。你说场景二好,因为契合度和收入高;他说场景三好,因为成本和风险低——两个人都不算错,因为这本书没告诉他们哪一项更重。
多准则决策矩阵(MCDM)是个成熟的工具,它的标准做法就是「打分 × 权重 → 加权求和 → 排序」。这本书给了前半段,把后半段留空了。
我知道这是「示例」,作者可能觉得权重该由企业自己定。但对一本教人做决策的书来说,最该示范的恰恰是「怎么定权重」——是让老板拍、让委员会投票、还是按历史项目的实际回报反推?这一步不教,读者拿到表还是只能接着拍脑袋,只不过这次是在表格里拍。
四、最厚的 40 屏,是一份七步清单
第 15 章「评估全部相关资源」40 屏,是全书最厚的一章,占 8.7%。
它厚得有道理,也厚得没道理。
有道理的部分:它是一份真正的操作清单。以数据资源评估为例,走到第五步是「评估数据访问与集成需求」——评估现有数据的可访问性以及与其他数据源的集成难度,因为这一结果直接影响项目的执行效率和进度。旁边配了一个小贴士:注意不同数据治理政策的影响,比如涉及欧盟数据的处理,根据《通用数据保护条例》(GDPR)的规定,必须获得用户对个人数据处理的明确授权。
第六步「确定数据采集、存储及处理所需资源」:基于分析结果,识别新的数据基础设施、数据采集工具、数据清洗服务、数据分析软件的需求。
第七步「制定数据治理规划」:确保产品开发过程中所使用的数据在隐私保护、安全合规上站得住。
这就是这 40 屏的样子:一步一步,带提示、带小贴士、带合规提醒。它不像书,像一份可以直接下发到项目组的 SOP。
没道理的部分:一套七步流程,其实可以用两屏说清楚(哪七步、每步产出什么)。剩下的 38 屏,大量是「要注意什么」的展开。这些内容不是没用,是重复度高——同一个提醒(数据质量决定模型效果)在书里出现了不止一次。
第 17 章的预算部分,倒是全书我最没想到的一节。它把「AI 战略」落到了五个财务科目上:财务估算(每个阶段的预期成本,比如技术采购、软件许可、咨询费和培训)、人力资源(列出人员要求,包括现有员工和潜在雇员,明确角色、职责和预计的薪酬)、基础设施和技术(所需基础设施升级和新平台的规格和成本)、应急资金(留出预算用于意外开支,降低因意外成本导致项目受阻的风险)、投资回报率预测(对该计划的预期财务回报进行分析,有助于领导层优先考虑战略要素)。
然后给了两条「最佳实践」:从历史财务数据记录入手(如果有类似项目,可作为参考基准)、调动利益相关方参与(避免对成本和资源需求做出主观臆断,充分听取信息技术、数据科学、人力资源和运营等部门的意见)。
「战略的最后一页是预算表」——这句话听起来不高级,但它是这本书最诚实的地方。大部分 AI 书讲完愿景就收尾了,这本讲到最后告诉你:你得去跟财务要钱,得算人力成本,得留应急资金。
五、第 1 部分唯一的方法:客户画像的六个格子
第 1 部分 137 屏,讲的是「别人怎么靠数据和 AI 赢」。六章读下来,最实在的是第 6 章「验证数据与 AI 商业产品及服务的产品市场契合度」——32 屏,第 1 部分最厚的一章。
它给了一套拆客户画像的方法,而且先把话说死了:为 AI 和数据产品构建客户画像时,不能仅停留在基础人口统计特征层面,而要深入挖掘并系统梳理客户对解决方案的具体需求和偏好。然后列了六个要素:
技术水平——该客户画像在使用先进技术方面的熟悉程度如何?对数据处理和应用的掌握程度如何?
数据环境——他们处理哪些类型的数据,以及组织内部如何对这些数据进行管理?
决策过程——谁在 AI 和数据工具采购决策中具有主导权?
现有工作流程——客户当前如何执行这些产品优化的任务?
痛点——产品能够解决客户面临的哪些具体难题?
衡量标准——他们如何评估其工作绩效和成功程度?
这六项里,最狠的是第三项和第六项。
「谁在采购决策中具有主导权」——这一问能救很多项目。卖给 CTO 的东西和卖给业务部门的东西不是一回事:前者关心架构、安全、可维护,后者关心这个月能不能出数。一本书如果只教你「找准客户痛点」,你还是会做出一堆业务部门叫好、IT 部门一票否决的方案。
「他们如何评估工作绩效」——这一问更少见。它问的不是「你需要什么」,是「你年底怎么被考核」。这两个问题的答案往往不一样:一家零售企业说需要「更精准的销量预测」,但它的采购经理年底考核的是「库存周转天数」,那你的预测模型只有把周转天数降下来才算赢,预测准确率提升两个点不算。
这本书还有一个别人少有的做法:它给了配套资源。原文写「我制作了一份客户画像工作表,可以帮助你系统地收集和整理目标客户的详细信息。你可以通过访问 www.data-mania.com/book 网址免费获取这份工作表」,以及「从 www.data-mania.com/book 网址可获取图 6-3 所示的客户画像文档」。
一本讲方法的书,肯把表格单独做出来让人下载,这是真把读者当执行者看。比起「请读者自行设计一份画像模板」这种话,一个能下载的 xlsx 要有诚意得多。
但这一章也有一个明显的缺口:六个要素给了,怎么用没给。六个格子填完之后,怎么判断这个客户「值得做」还是「不值得做」?没有一个评分,没有一条门槛。这一点跟后面的第 14 章是同一个毛病——它擅长把一件事拆成结构,不擅长给结构定阈值。
六、它敢拿自己人开刀:BloombergGPT 那个例子
前言里有这么一段,我读了两遍:
「以 BloombergGPT 为例,这是彭博社开发的一个定制 LLM,该模型使用其内部专有的金融数据进行训练。尽管该项目投入巨大,耗资数千万美元,但根据最新相关研究,在金融自然语言处理任务中,ChatGPT 和 GPT-4 的性能反而优于 BloombergGPT。」
这段话的分量,得放在语境里看。这本书是写给「技术型创始人和管理者」的,前言里明确要求读者「具有数据科学方法论、工具和技术方面的专业知识储备」「对 AI 和机器学习的基本运作机理有深入的认识」。这样一群读者,最容易犯的错就是「我们自己训一个」。
作者用 BloombergGPT 这个例子,正面劝退:连彭博社烧了几千万美元、拿独家金融数据训出来的专用模型,都没打赢通用模型。你凭什么?
紧接着他就给了这本书的立场:「本书提供的 AI 战略构建指南,旨在帮助企业充分利用那些更容易获取且用途广泛的预训练生成式 AI 模型。在介绍当前生成式 AI 领域全貌的同时,本书着重于实用性讲解,避免过多介绍生成式 AI 模型自身复杂的技术开发知识。」
这个立场在国内的 AI 书里很少见。2023 年到 2024 年,中文出版界的主旋律是「自研」「国产替代」「垂直大模型」,这本翻译书反过来讲「别自研,用现成的」,而且给了具体理由和反例。
更有意思的是它举的这个反例,本身也是它自己行业的反面。咨询公司卖的是「定制方案」,定制方案最贵的部分就是「为你的数据训一个专属模型」。这本书劝你别买这个,等于在砸自己同行的生意。
可惜这段话没给出处。「根据最新相关研究」——哪个研究?哪一年?什么基准?这是我读完最想问作者的一个问题。因为这句话是全书最重要的一个判断,而它只有一句话的支撑。
七、它的短板
把问题收一收,五条。
第一条,篇名与内容对不上。第 2 部分叫「三重维度:伦理考量、部署策略与竞争分析」,只给了两章 44 屏,第三个维度没有独立章。第 3 部分叫「支持增长的技术基础」,五章里三章是「评估」。这两个篇名都比内容大一号。
第二条,清单多于判断。整本书的句式是「第一步做什么、第二步做什么」,配上「提示」「小贴士」的浅色框。这些东西执行时很好用,但读书的时候会累——你很难记住三十个步骤,但你能记住一个判断。书里真正的判断句不多,BloombergGPT 那段和「数据对决策的实际可用性」那句,是我划下来的仅有两处。
第三条,案例全是美国的。合规章讲 GDPR(违规最高可处 2000 万欧元或全球年营业额的 4%,以较高者为准)和 2018 年《加州消费者隐私法案》(CCPA:消费者有知情权、删除权、拒绝个人信息被出售或共享的选择权,还有权纠正不准确信息、限制隐私数据的使用;每次故意违规最高可处 7500 美元罚款)。
这些都对,而且这一节标了尾注 [3],是规矩做法。但对中国读者来说,缺了最关键的一步转化:《数据安全法》《个人信息保护法》跟 GDPR 的差别在哪?「告知—同意」在中国的落地要件是什么?跨境传输的三条路径怎么选?这些一个没提。一本翻译书照搬原文不算错,但一本叫「实战指南」的书,读者拿它去开会时会发现用不上。
第四条,有尾注,但不齐。值得肯定的是它确实带引注(CCPA 那段标了 [3]),这在国内同类书里算讲究。但关键的判断处反而没标:BloombergGPT「数千万美元」投入、ChatGPT 与 GPT-4 在金融 NLP 上更优,这句只写「根据最新相关研究」。越是重要的判断,越需要一个能追的出处——这跟上一段说的「清单多、判断少」是同一个病:作者把力气花在了流程上,没花在论证上。
第五条,259 页的翻译腔。书里大量「你应该」「你需要」「让我们」,还有「CXO」这种把 CEO、CFO、CMO、CTO 打包的说法。不是不能读,是读起来像在读一份 PPT 的备注页。这类书的信息密度本来就靠结构撑,语言一旦松,读起来就慢。
八、一句话
如果你是带着「我们该做哪个 AI 项目」这个问题翻这本书的,你会有点失望——它用 17 屏回答你,还给了一张缺权重的表。
但如果你手上正握着一笔 AI 预算,不知道该先花在数据治理上还是先花在模型上,这 255 屏值得读一遍。它不会告诉你答案,它会给你一张足够细的体检单,让你自己的数字替你回答。
最后留一句它自己的话,也是全书我最认同的判断:「无论拥有多少数据,如果数据质量不达标,都会导致建模效果和分析结果不佳,从而对基于这些数据制定的决策产生负面影响。」
阅读记录:《数据与 AI 战略:企业实现指数级增长的实战指南》,莉莲·皮尔森著,微信读书 459 屏,4 部分 17 章,2026-11-17 逐页读完(end=last_page,903 秒)。文中屏数为逐页统计的实际值:17 章合计 436 屏(18/20/21/24/22/32/20/24/26/22/24/33/29/17/40/31/33),加文前 23 屏,合计 459 屏,与总数核对一致。
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: