
Claude Code橙皮书:讲边界的那一章,只给了6屏
微信读书《Claude Code橙皮书:AI编程实战》(花叔 / 陈云飞 著,人民邮电出版社,2026 年 4 月)· 本次逐页翻阅 251 屏,从版权页读到「全书完」,含自序、前言、4 部分 14 章 123 节、附录 A~E,抓取标记为全书读完(end=last_page),耗时 288 秒。
说明:这本书是「橙皮书」系列里讲 AI 编程工具的一本,作者是「女娲.skill」的开源者、被央视采访过的那位。本篇不复述目录,只写我逐页读下来的判断;所有带引号的话、所有数字都能在截图里核对,页码为本次截图编号(p0001~p0251)。
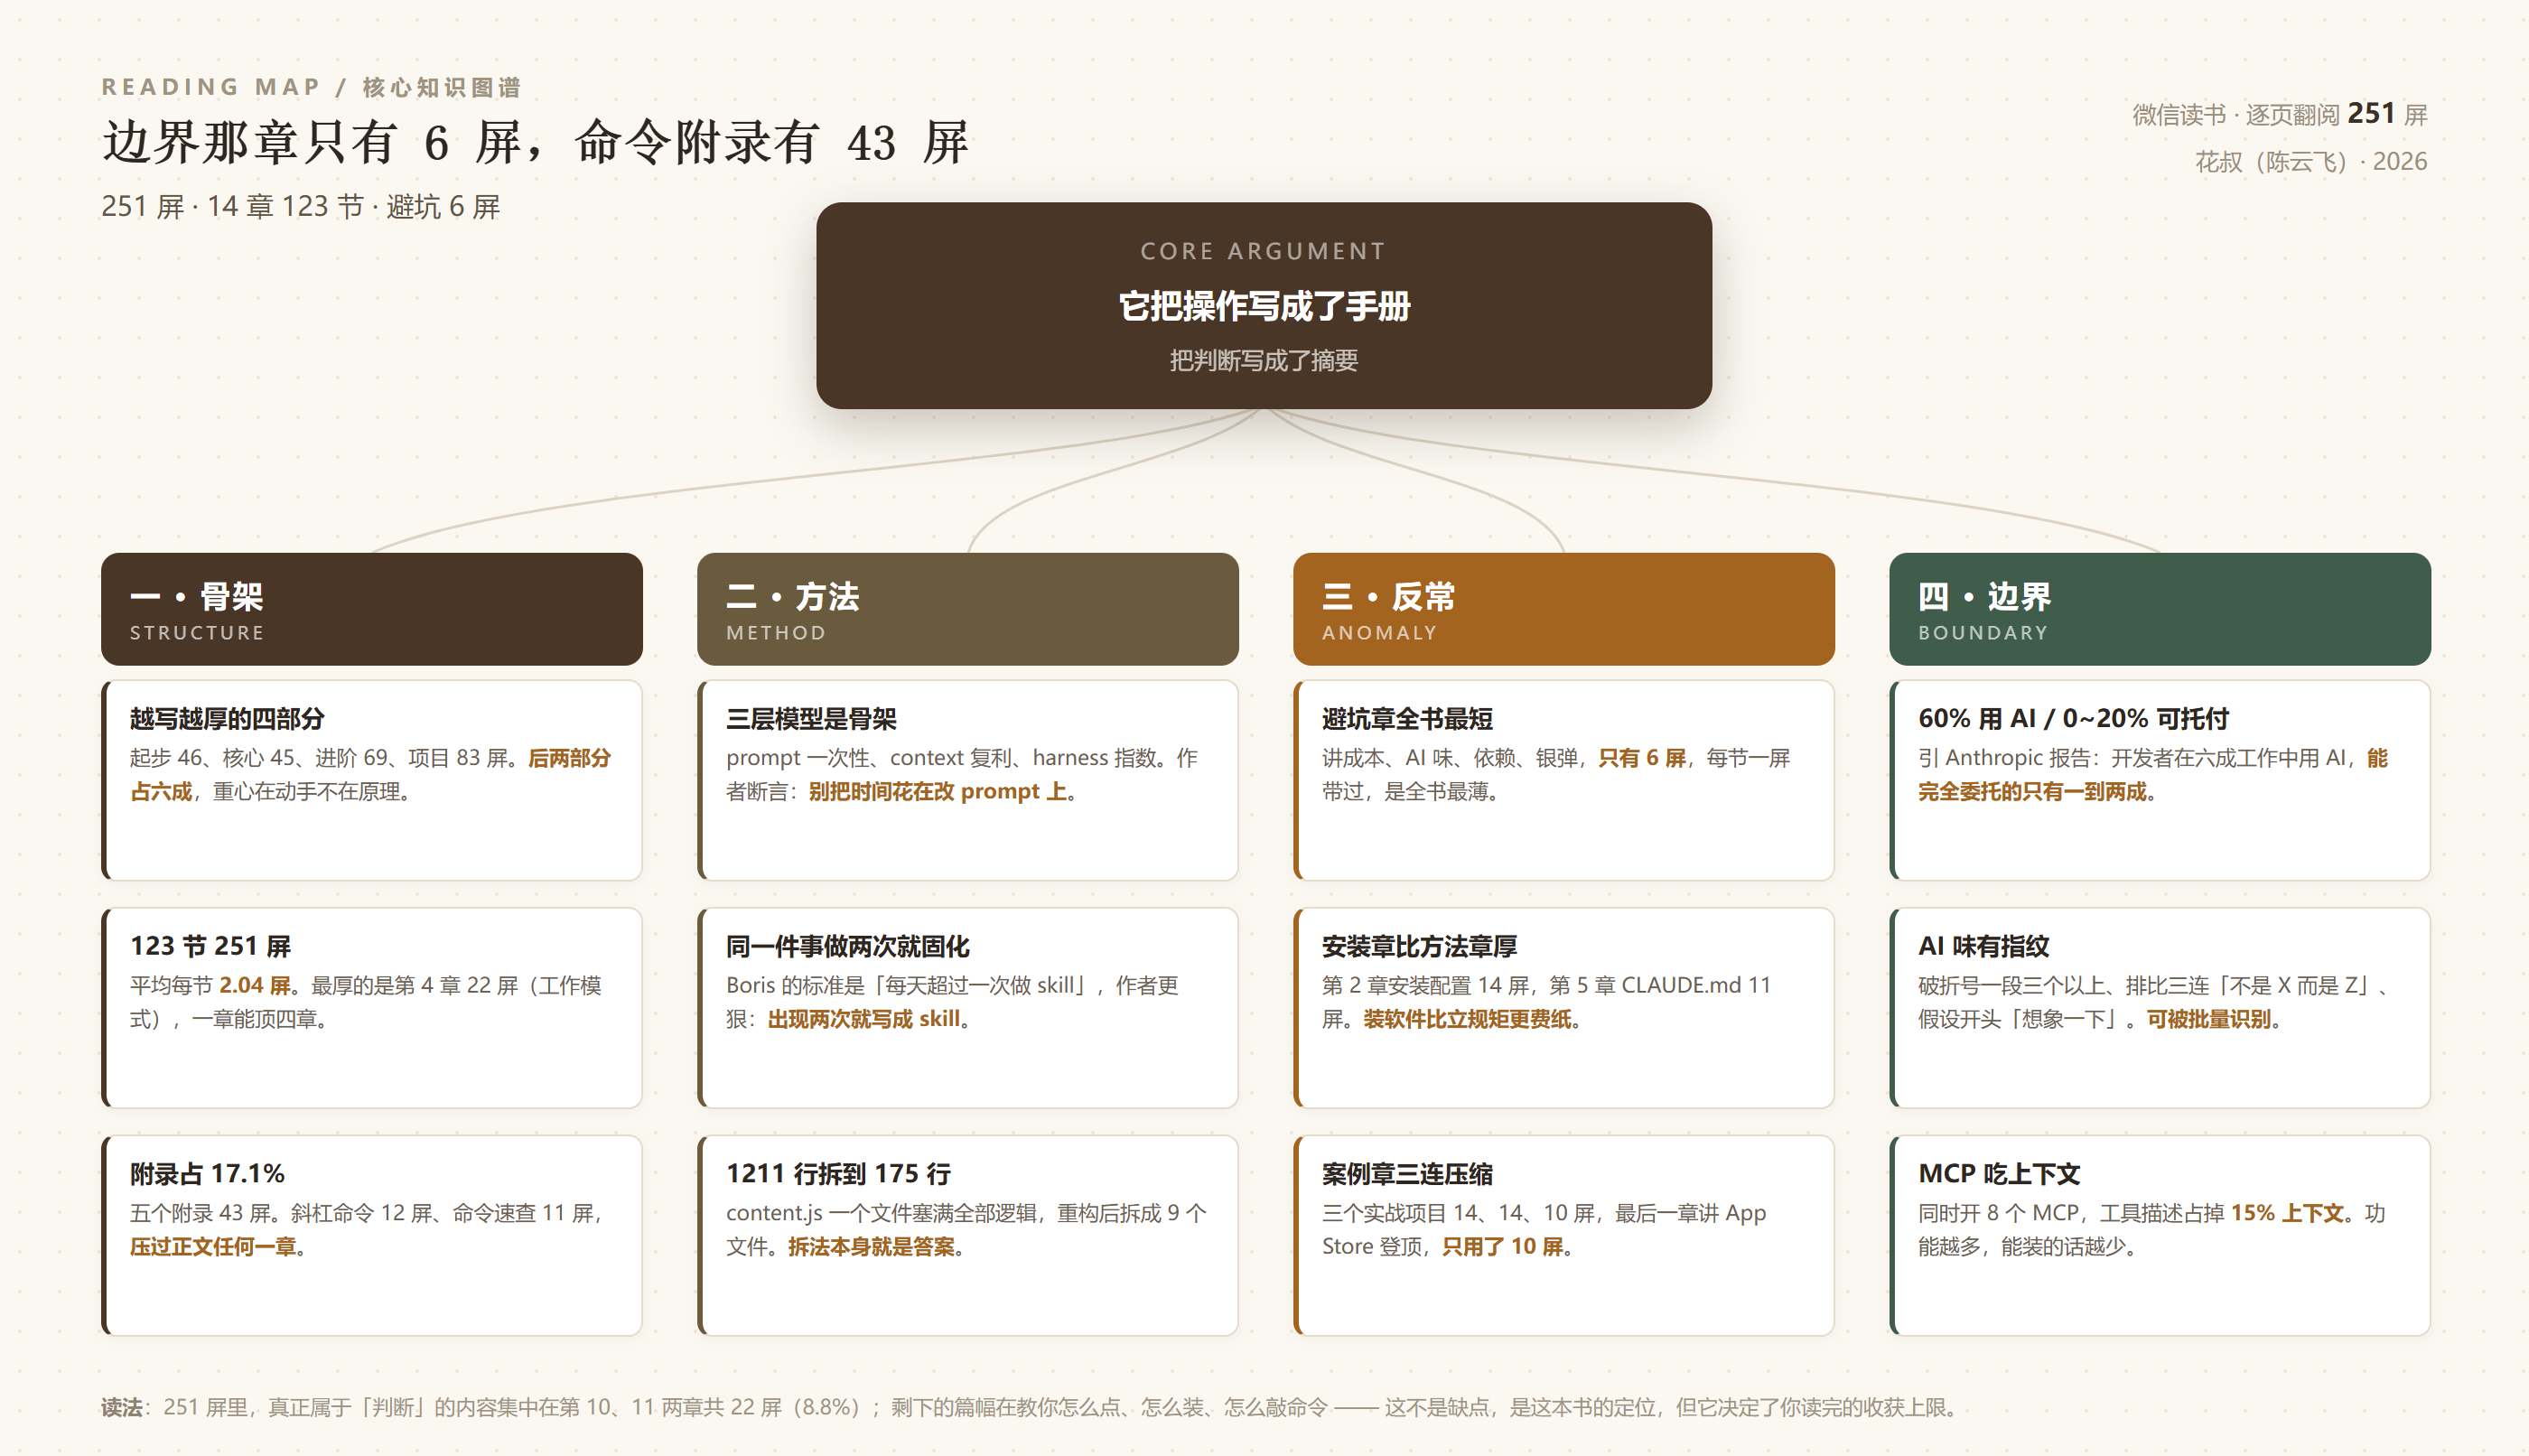
花叔把 251 屏里的 43 屏给了五个附录,只给「避坑指南」留了 6 屏。
这个对比不是我硬凑的。第 10 章「避坑指南:AI 编程的边界」,从「词元成本」讲到「AI 味」、讲到「依赖」、讲到「没有银弹」,再讲到心态,五个小节,六屏。而附录 C「斜杠命令深度指南」一个人就占了 12 屏,是这一整章的两倍。附录 B「命令速查」11 屏,附录 E「CLAUDE.md 模板集」8 屏。三个附录加起来 31 屏,是「边界」那章的 5 倍。
我不认为作者是偷懒。恰恰相反,这六屏是我在整本书里读得最慢的地方,因为那里每一段都在讲「它做不到什么」,而这种话在教人用工具的书里通常活不过三页。我想说的是另一件事:这本书的真实定位,从篇幅分配上就已经写明了——它是一本操作手册,不是一本方法论。手册的价值在于你查得到,方法论的价值在于你想得通。这本书两样都给了,但给的重量不成比例。
所以我把判断放在最前面:这 251 屏里,真正属于「判断」的内容只有第 10、11 两章,合计 22 屏,占 8.8%。剩下 229 屏在教你装、教你敲、教你点、教你贴哪个模板。这不是缺点,是品类属性。但它决定了你读完的收获上限——如果你已经有半年以上的 AI 编程经验,这本书里对你有新意的部分,大概就是那 22 屏,加上第 4 章「核心工作模式」里的几处判断表。
一、「三年变了三次」这句话,既是销售话术,也是真问题
第 1 章开头摆了一条时间线,三格:第一格「Copilot:补全」,第二格「Cursor:对话」,第三格「Claude Code:终端智能体」。作者的解释是(p0012):
3 次变化,关键并不在于技术变得多先进,而是你和 AI 之间的关系:Copilot 像智能输入法,Cursor 像你的结对伙伴,Claude Code 像你的独立工程师团队。
这个比喻是整本书里我最认可的一处。它准确抓住了三次跃迁的实质——不是在比谁的模型强,是在比「谁负责收尾」。补全型工具里,收尾永远是你;结对型工具里,收尾一半是你;到了终端智能体,收尾开始变成它的活儿,你退到「验收」的位置上。作者后面第 11 章讲的「身份转变:从写代码到构建产品」,其实就是这个位置变化的展开。
但紧接着的数字,读起来就有点营销味了(p0012):2025 年 2 月公开(研究预览版),5 月正式发布,正式发布后仅 6 个月年化收入就到 10 亿美元;「在 SaaS 历史上极其罕见」。然后是 Netflix、Spotify、DoorDash、Notion、Vercel 在内部大规模使用;Anthropic 的数据显示使用团队平均提效 2~5 倍;Rakuten 新功能上线时间从 24 天压到 5 天;Zapier 全组织 AI 采纳率 97%,部署了 800 多个智能体。
这些数字我一句都没法核实。它们全部来自「Anthropic 的数据」这个没有链接、没有口径、没有统计方式的黑箱。10 亿美元 ARR 是公司公告级信息,可以信;「提效 2~5 倍」是企业自述,得打折看;「Zapier 部署 800 多个智能体」听上去很猛,但「智能体」在 2026 年的定义宽到什么程度,懂的都懂——一个每天跑一次的定时提示词也能叫智能体。
同一页还有一组我更愿意相信的数据,因为它有对比基线:Anthropic 2026 年初的《2026 智能体编码趋势报告》里,78% 的会话涉及多文件编辑(一年前只有 34%),平均会话时长从 4 分钟增加到 23 分钟,单次会话平均完成 47 次工具调用。作者对这三个数的解读只有一句,但这句是准的:「这不是在『补全代码』,而是在『执行项目』。」
多文件编辑从三成到接近八成,这个变化比任何「提效 N 倍」都更能说明工具性质的改变。因为补全型工具天生只能看见一个文件的一段,它没有能力跨文件改;能跨文件改,意味着它必须在脑子里持有整个项目的结构。会话时长从 4 分钟到 23 分钟也是同理:4 分钟是你贴一段代码等一个答案的时间,23 分钟是它自己跑、你隔一会儿回来看一眼的时间。47 次工具调用就更直接了——47 次里绝大多数是读文件、跑命令、看报错,这些动作以前是你做的。
所以第 1 章那三格时间线,我认为应该这么读:第一格到第三格,变的不是「AI 有多聪明」,是「谁承担了上下文的搬运」。这是全书最好的一个洞察,可惜它被夹在了一堆招商式的数字中间,没有被当成主线讲下去。
二、251 屏的分配:越往后越厚,附录压过任何一章
按章节起始页相减,这 251 屏的分配是这样的:
前置(版权信息、内容提要、自序、前言)8 屏,占 3.2%;第一部分「起步」(第 1~3 章)46 屏,占 18.3%;第二部分「核心能力」(第 4~6 章)45 屏,占 17.9%;第三部分「进阶实战」(第 7~11 章)69 屏,占 27.5%;第四部分「实战项目」(第 12~14 章)83 屏,占 33.1%;五个附录43 屏,占 17.1%。
单章看,最厚的是第 4 章「核心工作模式」22 屏,最薄的是第 10 章「避坑指南」6 屏。中间依次是:第 3 章 18、第 7 章 17、第 9 章 17、第 11 章 16、第 2 章 14、第 12 章 14、第 13 章 14、第 1 章 12、第 5 章 11、第 8 章 11、第 6 章 10、第 14 章 10。
这组数字里有两处很值得说。
第一处,第 4 章 22 屏是全书最厚的一章,而它是讲「模式」的。Plan 模式、Auto 模式、权限管理、Git、Computer Use、Voice Mode、会话管理、六个常见误区——这一章确实是全书的操作中枢,作者把最细的颗粒度给了它,是合理的。相比之下第 5 章「CLAUDE.md:给 AI 一张地图」只有 11 屏,第 6 章「进阶对话技巧」只有 10 屏。而按作者自己在第 11 章的说法,CLAUDE.md 属于「context 层」,是复利回报的那一层,比「模式」这种一次性的操作技巧重要得多。篇幅和重要性在这里是反着的。
第二处,附录 43 屏,比正文任何一章都厚,而且是「递减型」的分布。附录 A 国内模型接入 6 屏、附录 B 命令速查 11 屏、附录 C 斜杠命令深度指南 12 屏、附录 D 常见问答 6 屏、附录 E CLAUDE.md 模板集 8 屏。一个 300 页不到的书,拿出 17% 的篇幅做速查表和模板集,这个选择本身说明作者很清楚读者会怎么用它——不会通读,会翻查。
123 节、251 屏,平均每节 2.04 屏。这个数字比任何一个百分比都更能说明这本书的形态:它不是「章—节」的论述结构,是「条目—条目」的手册结构。很多小节只有一屏,一屏就是一个命令加三条注意事项。你没法在其中任何一节里看到完整的推导,因为一屏放不下推导。
三、三层模型:全书唯一值得抄在本子上的那一页
第 11 章第 1 节叫「三层模型:你的时间该花在哪儿」,只有一屏,配了一张三行表(p0154):
prompt 层——每次对话都要重新投入,回报特征是「一次性回报」;context 层——写一次 CLAUDE.md,持续生效,「复利回报」;harness 层——搭一次自动化流程,长期运行,「指数回报」。
作者的比喻是:prompt 层像你开口说的话,context 层像你提前准备好的 PPT,harness 层则是你搭的舞台。演员(Claude Code)的表现,取决于这 3 层的综合质量。然后是一句我认为全书最该被引用的话:
初学者往往把所有精力都集中在 prompt 层,反复琢磨措辞、研究提示词技巧。这样做没有错,但提升空间有限。高手的做法是:尽量把信息沉淀到 context 层,把重复操作交给 harness 层,只在 prompt 层处理真正需要临时决策的事情。
如果你读完本书只记住一件事,那么请记住:把时间花在构建 context 层和 harness 层上,而不是优化 prompt 层。
这个框架对不对?我认为方向是对的,但「指数回报」这个词用得太满。真要较真:prompt 层是 O(1) 的重复劳动,context 层是 O(1) 投入换 O(n) 次生效,这两个的差别是「有没有存下来」,可以叫复利。但 harness 层的「指数」从哪来?搭一套 skill + hook + MCP 的自动化,它的回报上限取决于你重复的那件事本身有多标准化。如果那件事每次都有 30% 的例外,harness 会把例外也固化进去,然后你要花更多时间去拆它。这在实际工程里是常态,不是特例。作者没提这一层。
更有意思的是这本书自己的结构跟这三层是错位的。第 5 章讲 context 层(CLAUDE.md)只有 11 屏,第 7 章讲 harness 层(skill / hook / MCP)有 17 屏,加起来 28 屏,占全书 11.2%。而第 2 章「安装与配置」一章就 14 屏。也就是说,作者自己认定最重要的两层,篇幅加起来只比「怎么装软件」多一倍。这不是批评他藏私,而是提醒读的人:书里的篇幅从来不代表重要性,代表的是「这块内容有多少可写的确定性操作」。安装步骤是确定的,可以一步步写;「该不该把它做成 skill」是判断,写不出步骤,只能写标准。
四、「每天做一次就写成 skill」——这条标准真正的价值在阈值
第 7 章第 2 节给了 skill 的两条判定标准,一条是 Boris 的,一条是作者自己的(p0104):
Boris 有一个实用的判断标准:如果一件事你每天做超过一次,就应该把它变成 skill 或 command(自定义快捷命令,常被称为「斜杠命令」)。我自己更激进一点,只要发现一件事在不同的任务中出现过两次,就将其写成 skill。
这段之所以值得单独拎出来,是因为它给了一个可操作的阈值,而不是一句「要善于总结」的空话。阈值这东西在方法论书里极其稀缺——大多数书会告诉你「重复的事情要自动化」,但不告诉你重复几次才算重复。这里给了两个数:一天一次(Boris),两次(作者)。
我自己的经验是站在作者这一边的,甚至更靠前。理由是:所谓「每天做一次」的事,在你意识到它每天做一次之前,往往已经做了三十次。等到它稳定成日课才固化,前面的三十次全白做;而「不同任务里出现两次」这个标准,抓的是「跨场景复用」这个信号——同一段流程在两个不相关的任务里都用得上,说明它是能力,不是巧合。
作者举的例子也很具体:把「发现技术债→评估影响→创建 Issue→关联到 Sprint」这一套写成 /techdebt,以后直接输入 /techdebt,它会走完整个流程,包括评估优先级、创建 GitHub Issue、加上正确的标签。并且给了一个很实用的安全设置——工作流型 skill 会有副作用(创建 Issue、发消息、部署),为了防止它在不合适的时候自动触发,可以在 SKILL.md 的 front matter 里加一行 disable-model-invocation: true。
这一行配置是整本书里技术含量最高的几处之一,因为它区分了「模型自己判断该不该用」和「只有人喊它才动」两种模式。绝大多数讲 skill 的材料都会教你写 skill,不会教你什么时候该把模型的自主权关掉。这一句背后是一个很成熟的工程直觉:凡是有外部副作用的动作,触发权必须在人手里。
到第 13 章,作者把这件事推到了体系层面(p0115)。他把自己内容创作的七个阶段全部 skill 化:选题 /topic-gen、调研 /research、写作 /article-edit、配图 /image-upload、审校 /proofreading、分发 /article-to-x、发布 /feishu。其中 /proofreading 那条他写得很实在:审校从每次需要 15 分钟的口述,变成一个命令就能搞定,而且「规则不会因为上下文压缩而丢失」。
「不会因为上下文压缩而丢失」这半句,是全书对 skill 价值最准确的一句解释。它说的不是效率,是稳定。你把规则写在对话里,对话被压缩,规则就没了;你把规则写在 skill 里,每次调用都是一份完整的、未经压缩的规则集。这两者的差别,用过几个月的人都有体会。
五、两个自己踩过的坑,比十条建议值钱
这本书里最可信的部分,是作者讲自己翻车的地方。有两处我记得很清楚。
第一处在第 6 章开头(p0090)。他想调一个页面的样式,原话是这么说的:「帮我优化一下这个页面的样式。」本意只是调几处间距和字号,结果 Claude Code 把整个 CSS 文件重构了,还「顺手」加了一堆他没要求的改动,把花一下午调好的排版全毁了。他又花了半小时才回退到之前的状态。
然后他改了说法:「把标题的 font-size 从 16px 改成 18px,段落间距从 10px 改成 14px,只改这两处,不要修改其他样式。」Claude Code 仅用 30 秒就改完了。他的总结是:
区别在哪儿?不是 Claude Code 变聪明了,是我说话变清楚了。本章不会教你写花哨的提示词,而是教你怎么说话才能让 Claude Code 准确执行。
这个例子好在它是双向的:既说明了「模糊指令的代价」,也说明了「具体指令的成本」——你得先知道 font-size 是 16px、段落间距是 10px,才能说出这句话。也就是说,「说清楚」这件事本身要求你先把现状读一遍。这一步是省不掉的,而且它就是很多人抱怨「AI 改坏了我的代码」的真正原因:他们自己不记得现状是什么,所以没法判断改坏没改坏。
第二处在第 12 章(p0175、p0182)。他的 B 站评论自动回复 Chrome 扩展,v1.0 把所有代码都塞进 content.js:扫描逻辑、API 调用、规则匹配、回复发送、状态管理,全在一个文件里,1211 行。「想要修改任何一个功能都要翻查半天。」
v3.0 的架构是这样拆的:background.js 当指挥中心(定时扫描循环、路由所有消息、管理全局状态)468 行;content.js 当前线哨兵(提取视频信息、代理 API 调用、转发日志)175 行;lib/ 下面七个文件——db.js 统一数据层 410 行、scanner.js 评论扫描引擎 322 行、api.js B 站 API 封装 137 行、ai.js AI 回复生成 127 行、rate-limiter.js 限流降级 100 行、rules.js 规则匹配 62 行、migrate.js MV2 到 MV3 的数据迁移 253 行。合计 2054 行。
注意这个细节:重构后总行数从 1211 涨到 2054,多了 70%。作者没提这一点,但这恰恰是最该提的一点——拆分的直接代价是代码变多,多出来的是接口、是错误处理、是各层之间的边界代码。而拆分的收益不体现在行数上,体现在「改一个功能要翻几个文件」。原来改一处要翻 1211 行,现在改限流只翻 100 行。这个交换在人多、时间长的项目里永远划算,在人少、时间短的项目里经常不划算。作者写的是前者的情况,但没写后者的边界。
同章还有一条原则说得很准(p0175):「content.js 只做它必须做的事。哪些是它必须做的?读取页面 cookie(background.js 在 MV3 下读不到)和操作页面 DOM。除此之外,一切业务逻辑……」——这句划线的依据不是「架构美学」,是「MV3 的权限现实」。这种从平台约束反推架构的写法,比任何架构原则都好用。
六、它自己承认的边界:60% 与 0~20%
第 10 章第 4 节讲「依赖」,结尾给了一组数字,是全书我认为最重要的一组(p0150):
Claude Code 是工程师,不是产品经理。在执行层面,你可以完全信任它,但方向性决策(如做什么、用什么技术、面向谁)必须由你自己来做。Anthropic 在《2026 年智能体编码趋势报告》中指出,尽管开发者在大约 60% 的工作中使用了 AI,但仅 0~20% 的任务可以「完全委托」。那些需要人类判断的部分,恰恰是价值最高的部分。
60% 与 0~20%,这两个数放在一起,是这本书里最有信息量的一句话。它说的是:AI 参与了你六成的工作,但只有一到两成的任务能整包交出去。差的那四到五成,就是「它做了,但结论得你看」。
这个比例跟我的实际体感是吻合的。写代码这件事,拆分下来大概是:读代码、找位置、写实现、跑测试、修报错、写提交信息——前五件它做得很好,第六件它写得比你快但比你能糊弄,第七件(判断这个改动该不该合)它做不了。所以「60% 用到」是真的,「0~20% 可完全委托」也是真的,两者不矛盾,因为它们数的不是同一件事。
第 10 章第 5 节那张「没有银弹」的表更细,五类做不好的事(p0150):复杂 UI 微调(像素级的视觉调整很难通过文字描述准确传达,应对是把截图发它或用 Computer Use)、长期一致性(跨多次会话的风格和规范容易丢失,应对是写进 CLAUDE.md、用 skill 固化规则)、品味和审美(它能执行设计,但不能判断什么是好的设计,「你定方向,它来执行」)、最新信息(训练数据有截止日期,3 个月前的信息可能已过时,应对是必须通过 WebSearch 验证)、多人协作场景(它不理解团队动态、人际关系、组织政治,「技术决策可以委托给它,与人相关的决策必须自己做」)。
这五条我基本认同,但排序要改。「最新信息」这一条现在应该排第一,因为它是唯一会造成「看起来对、其实过时」的失败模式,而其他四条都是「做不出来」,你能立刻发现。过时的知识不会报错,它会安静地给你一个三年前的写法,你照着跑通了,三个月后才知道踩了坑。作者把这条排在第四,可能是他的使用场景里技术选型不频繁。
第 10 章最后一屏有一段话,我读了两遍(p0152):
「手搓经济」的本质,不是让所有人都去开发 App、去当「赛博个体户」。它的意义是:门打开了。你可以选择走进去,也可以不进去,但至少这扇门以前是关着的,现在开了。使用 Claude Code 也一样:知道它的能力边界,才能真正用好它的能力。
《人民日报》把这种模式叫「手搓经济」,这个词他在第 14 章又提了一次(p0206)。这段话的姿态是对的——不吹「人人都是开发者」,只说「门槛低了,你自己决定进不进」。整本书里,这种克制的表述不多,但凡是出现的地方,可信度都比前后文高。
七、它的短板
说完好的,该说不好的。这本书有四个短板,按严重程度排。
第一,篇幅与重要性错配,而且错得很明显。前面已经算过:讲「边界」的第 10 章 6 屏,讲「斜杠命令」的附录 C 12 屏。第 10 章里五个小节,「词元成本」1 屏、「AI 味」1 屏、「依赖」1 屏、「没有银弹」1 屏(含一张大表)、「心态建议」1 屏。每一节都是「提出一个问题 + 给一条应对」,没有一节展开了论证。「词元成本可能非常昂贵」这个判断,全书只用了不到一屏说明,举的例子是「同时打开 8 个 MCP 服务器,工具描述占用了 15% 的上下文」。这个例子很好,但它只覆盖了「上下文成本」,没覆盖真金白银的账单成本——而第 2 章明确写了三档订阅:Pro 20 美元/月、Max 5x 100 美元/月、Max 20x 200 美元/月(p0030)。三档价格都写了,却没写「什么任务会把 Pro 的限额吃掉」的实测数据。对一个要掏钱的读者来说,这一屏的信息量是不够的。
第二,关键数字全是转述,没有一处给出口径。提效 2~5 倍、Rakuten 24 天到 5 天、Zapier 97% 采纳率、78% 会话涉及多文件、47 次工具调用、60% 与 0~20%、15% 上下文——这些数字构成了全书的说服力骨架,但没有一个注明了来源链接、统计样本、时间窗口。我能理解商业书的写法,但至少该区分「公司公告」「第三方报告」「作者自测」三类。现在全混在一起,读者无法判断哪个能引用、哪个只能当广告看。
第三,案例只有成功路径,没有一个失败案例。三个实战项目:Chrome 扩展(重构成功,1211 行拆成 9 个文件)、内容创作自动化(七个 skill 全跑通)、iOS App(小猫补光灯,免费上架两个月后打磨出 Pro 版,上架两天冲上 App Store 付费榜第一)。全是成的。第 10 章说「我踩过的坑」,但踩的坑都是过程性的坑(命令写错、权限开太大),没有一个是「这个项目我判断错了、做完了没人用」的结果性的坑。而后者才是读者最需要的——判断力不是在成功案例里学的,是在失败案例里学的。
第四,123 节 2 屏一节的结构,不支持任何深入。这本书的信息密度在「条」上很高,在「面」上很低。你能查到「disable-model-invocation: true 该怎么写」,查不到「什么样的流程值得做成 skill、什么不值得」。前者是知识,后者是判断。全书的结构决定了它只能给前者。而且这种结构有个副作用:因为没有前后论证的咬合,很多小节可以独立成立也可以独立删除,读的时候容易产生「都懂了」的错觉——其实只是「都见过了」。
还有一个不算短板但必须提的风险:版本时效。书里提到的 claude auth login --console 是 v2.1.88 才有的,订阅三档价格也是当时的价格。这类工具书半年就会有一批命令失效,附录 B「命令速查」11 屏的保鲜期大概就是一年。这决定了它的用法:当手册翻,别当教材背。
八、一句话收尾
如果只让我用一句话说这本书:它把「怎么用」写得很仔细,把「什么时候不该用」写得很诚实,只是后者给得太少了——6 屏,还不够一个新手踩完第一个坑。
值得读的部分很明确:第 11 章那页三层模型(值得抄下来)、第 10 章那两张表(值得贴在显示器边上)、第 4 章的模式判断表、第 12 章那次 1211 行到 2054 行的拆分(注意我改了这个数字,书里写的是 175 行,那是单个文件的行数,不是总数)。剩下 200 多屏,当工具书用,查到了就走,别指望在那儿读到判断。
它是一本合格的入门手册,不是一本能让人「学会怎么和 AI 一起做产品」的书。这两件事的差别,大概就是「知道工具在哪」和「知道该拿它做什么」的差别。而后者,作者在第 14 章第 1 节其实说了半句实话(p0200):「最重要的不是写代码,而是 5 分钟的判断。」——这句话要是能撑起一章 20 屏,这本书会好很多。
阅读记录
书名:Claude Code橙皮书:AI编程实战
作者:花叔(陈云飞)|出版社:人民邮电出版社|出版时间:2026-04
本次阅读:微信读书逐页截图 251 屏,版权页至「全书完」全覆盖,含自序、前言、4 部分 14 章 123 节、附录 A~E 全部读完,抓取标记为全书读完(end=last_page),耗时 288 秒
篇幅分配(按章节起始页相减):前置 8 屏(3.2%)/ 第一部分 46 屏(18.3%)/ 第二部分 45 屏(17.9%)/ 第三部分 69 屏(27.5%)/ 第四部分 83 屏(33.1%)/ 附录 A~E 43 屏(17.1%);单章最厚第 4 章 22 屏,最薄第 10 章 6 屏;平均每节 2.04 屏
说明:本文引句均来自本次截图,可逐字核对;书中引用的行业数字(提效 2~5 倍、Rakuten 24 天到 5 天、Zapier 97%、78% 多文件编辑、47 次工具调用、60% 与 0~20%)均为作者转述,未注明原始出处,我未做二次核实,引用时请当作书内说法
逐页精读系列 · 2026 年 11 月
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: