
AI创富经济学:它把「经济学」写成了 65 个问号
微信读书《AI创富经济学:从超级个体到商业巨擘》(唐昕龙、王丹 著)· 本次逐页翻阅 298 屏,从版权页读到「全书完」,含内容简介、作者简介、序一序二、8 屏推荐语、前言、7 章 65 节、后记、12 条参考文献,抓取标记为全书读完(end=last_page),耗时 291 秒。
说明:这是一本讲 AI 时代个人与企业如何「创富」的书。本篇不复述目录,只写我逐页读下来的判断;所有引号里的话都能在截图里核对,页码为本次截图编号(p0001~p0298)。
这本书 298 屏,我读完的第一反应不是「有收获」或者「没收获」,而是——它其实没有论证,它给了六十五个回答。
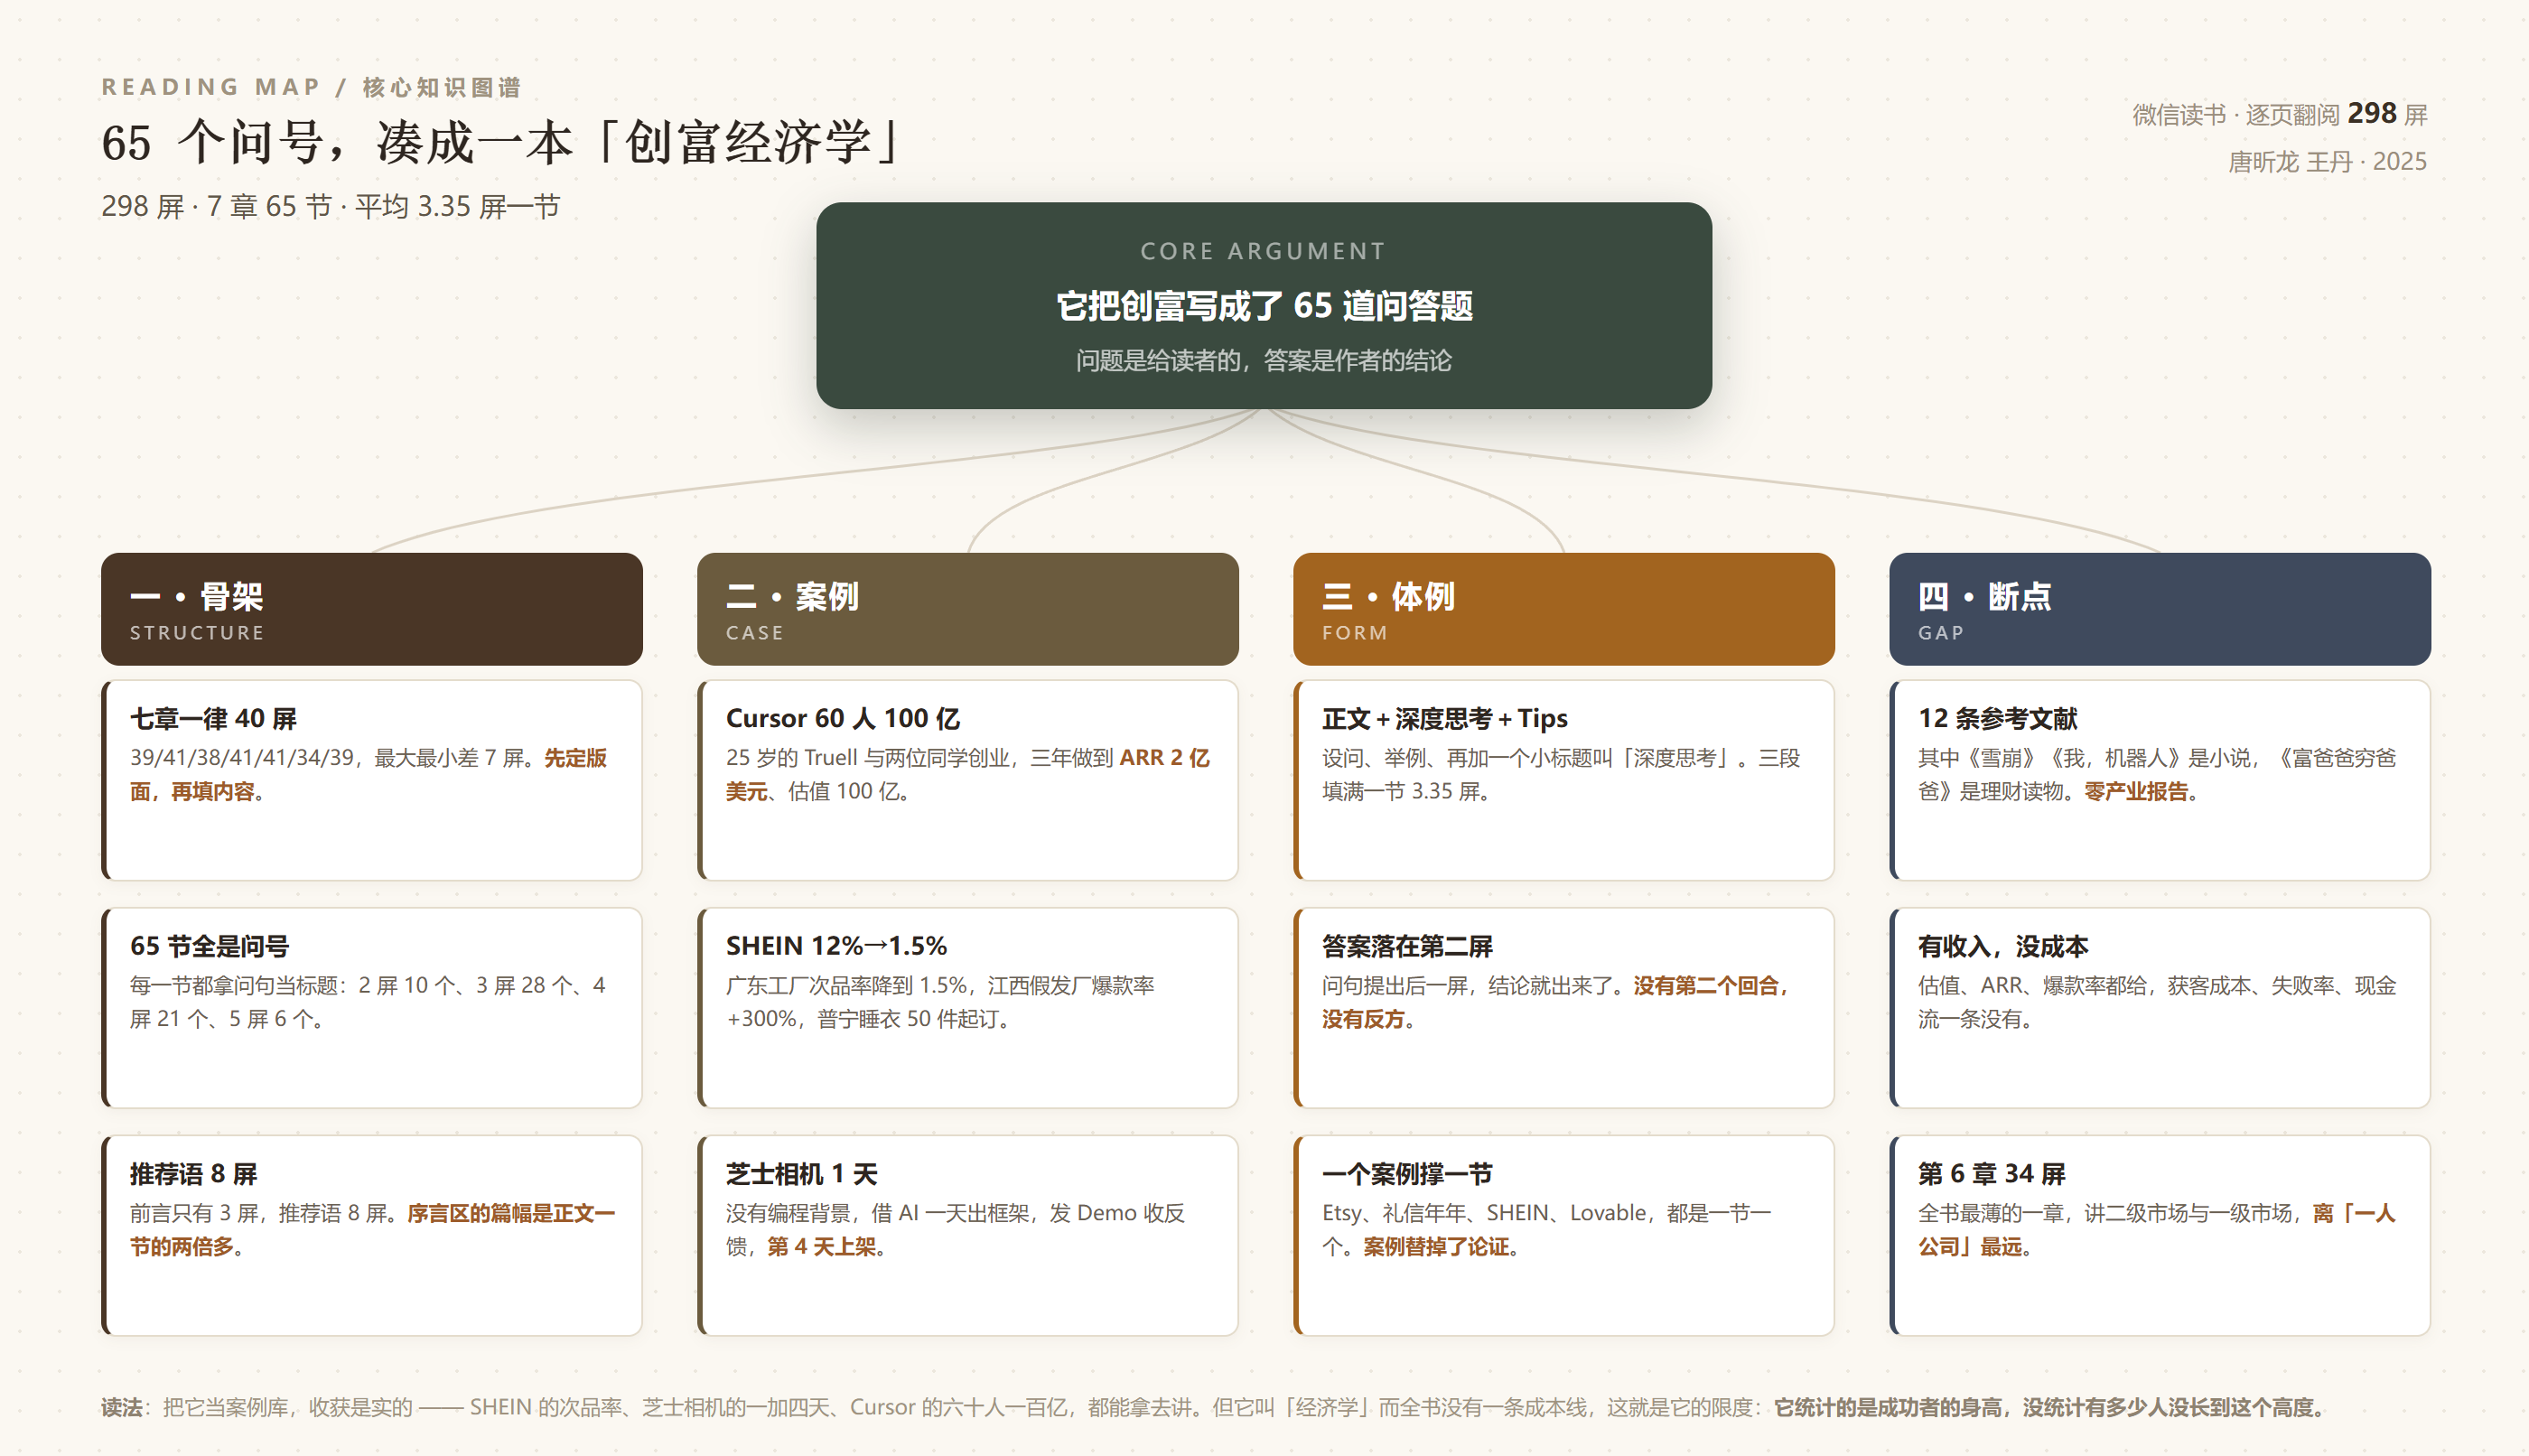
六十五,是三级小节的个数。我把它们一条条列出来看,发现没有例外:每一节的标题都是一个问句,从「AI 为啥能算新质生产力?」到「只有物理世界才是真实的吗?」,六十五个问号,一个不落。而它们的平均长度是 3.35 屏,最短 2 屏,最长 5 屏。
问句加三屏半,这是一个非常成熟的内容形态。它适合手机、适合通勤、适合随时点开再随时关掉。它唯一不适合的,是「经济学」这三个字。
一、它自己先把书名降了一级
先看内容简介那一页。作者对这本书的自我定位写得很清楚:
本书既是可随查随用的实用工具书,也是启发个人发展的参考读物。
「可随查随用」四个字,是工具书的自我认定。工具书是按需检索的,用户带着问题来,翻到那一节,拿走答案。这个定位本身没有问题,问题在于封面上印的是「经济学」。
经济学这三个字通常意味着三样东西:价格(成本结构,钱从哪儿来、到哪儿去)、约束(资源是有限的,所以要做取舍)、比较(同一笔钱投在 A 和投在 B 的差别,以及失败的概率)。我把这三样在书里各找了一遍:成本结构,全书没有一条;资源约束,只在个别地方顺口提一句「精力有限」;失败率与机会成本,一处都没有。
书里给的是另一套东西:案例、判断、金句,以及一种「你也可以」的语气。这三样东西凑在一起,是可以写成一本好书的,只是那样的书叫《AI 时代的六十五个机会》,不叫《AI 创富经济学》。
序一里那句评价其实已经点到了它的性质:「本书的两位作者以独到的观察力,以个人的财富增长为主线……全方位诠释了 AI 带来的各个层次的机遇,归纳了抓住机遇的实践要点。」「归纳实践要点」——这是经验总结的写法,不是经济学的写法。经验总结靠观察,经济学靠可证伪的比较。这本书从头到尾没有做过一次比较。
二、七章 39/41/38/41/41/34/39:等长本身就是一种写法
按每章第一个小节标题在截图里首次出现的页码相减,七章的屏数是这样的:
第 1 章「AI 浪潮」39 屏(p0022–p0060),第 2 章「超级个体」41 屏(p0061–p0101),第 3 章「一人公司」38 屏(p0102–p0139),第 4 章「轻型组织」41 屏(p0140–p0180),第 5 章「企业进化」41 屏(p0181–p0221),第 6 章「财富管理」34 屏(p0222–p0255),第 7 章「未来推演」39 屏(p0256–p0294)。前面还有 21 屏(版权信息 2、内容简介 1、作者简介 2、序一 3、序二 2、推荐语 8、前言 3),后面是后记 1 屏、参考文献 3 屏。
七章,最大 41 屏,最小 34 屏,去掉最薄的第 6 章,其余六章全在 38 到 41 之间,差 3 屏。这个整齐程度不可能是内容自然长成这样的。内容有自己的重量:讲案例的章节会膨胀,讲概念的章节会收缩。七章几乎一样长,说明篇幅是先在版面上定好的,然后往里填。
定好篇幅再填,会带来一个必然的结果——每一章都在「点到」,没有一章「到底」。
举一个最明显的例子。「创富」这件事真正的难点在哪里?在获客、在定价、在现金流、在失败之后怎么收场。这四件事,全书加起来给的空间,和「这轮 AI 热潮会不会又是一场泡沫」(1.1.3,4 屏)差不多。第 4 章讲「一人独角兽」占 3 屏,第 5 章讲「你的 AI 战略,是摆设吗」占 3 屏,第 7 章讲「AI 成神,文明进化」占 4 屏。一个具体到能明天动手的问题,和一个远到没法验证的问题,拿的篇幅是一样的。
这不是作者偷懒。这是一种内容产品的排版逻辑:读者翻到任何一节,投入的时间成本都一样,都是三分钟。三分钟能装下的东西,只能是「一个案例加一个结论」。
顺带说一个很好笑的细节:推荐语占 8 屏,前言只占 3 屏。八屏推荐语里,有北京计算机学会数字经济专委会主任步超、深圳开务控股集团创始人高国刚,还有一位酒仙网背景的推荐人,说「从传统酒商到互联网电商,我用了 10 年。现在 AI 来了,留给企业的时间可能只有 1 年」。序言区比正文一节厚两倍多,这在一本讲「效率」的书里,是个挺有意思的比例。
三、65 个问号,答案落在第二屏
我把 65 个三级小节的屏数做了统计:2 屏的有 10 节,3 屏的有 28 节,4 屏的有 21 节,5 屏的有 6 节。也就是说,八成以上的节,读者翻两下就到底了。
两下能翻完的一节,内部结构是固定的。以「1.1.1 AI 为啥能算新质生产力?」为例(p0027–p0029):先是三屏正文交代背景——AI 重构生产要素、2025 年政府工作报告把「人工智能+」写进新质生产力篇章;然后出现一个小标题叫「深度思考」;接着是「新质生产力的内核是劳动者、劳动资料、劳动对象及其组合的质变」,最后落到一句可以带走的话:「挪动一个『比特』比挪动一个『原子』轻松得多,需要的能源消耗也少得多,『先算后动』『多算少动』在任何领域都比『先行动后思考』成本更低、效率更高。」
这段写得不错,比特和原子的对比是有解释力的。但请注意它的位置:问题在标题里提出,答案在第二屏就给完了,剩下的屏是用来举例和升华的。没有第二个回合,没有反方,没有「但是这件事在什么条件下不成立」。
这就是问答体的天花板。问答体是「把一个话题说到够」,不是「把一个问题的所有面翻过来看一遍」。前者适合公众号,后者才是一本书该干的事。这本书选了前者,然后把它装订成 298 屏。
还有一处更隐蔽的东西:所有问句都是冲着读者来的。「年轻人有机会快速脱颖而出吗」「35 岁了,面对年龄问题,你该如何应对」「不懂技术,也能启动一人公司吗」。读者永远站在被提问、被回答、被安慰的位置上,作者永远站在知道答案的位置上。整本书没有一处是作者在自问——没有「我原来以为……后来发现错了」。一本讲判断的书,如果作者从没在书里改变过主意,那它的判断是从哪儿来的,就只能靠读者自己信。
四、它最扎实的地方:4.2.1 那五个数字
说了这么多结构问题,得把公道话补上。这本书有一节是真的硬——「为啥『一人独角兽』能持续涌现?」(p0157 附近)。它敢给名字、给人数、给金额、给时点:
Cursor:25 岁的程序员迈克尔·特鲁尔(Michael Truell)临近大学毕业时与 2 位同学组成初创团队,产品上线一年后估值 10 亿美元,公司成立 3 年后年化收入 2 亿美元、估值升到 100 亿美元,「那时候整个公司仅有不到 60 人」。
Lovable:联合创始人兼 CEO 安东·奥西卡(Anton Osika)在 2024 年 11 月发布产品时团队仅 15 人,3 个月做到从 0 到 1700 万美元年化收入;截至 2025 年 7 月估值 18 亿美元,团队不到 50 人。
再加上 Mercor(不到 15 人、成立 8 个月估值破 10 亿美元)和 ChatterDOC(核心成员 5 人、3 个月用户破百万)。这一节的信息密度,是全书其他节的三倍以上。同样是「AI + 商业」,为什么这一节好看?因为它把「小」量化了:不是「小团队很厉害」,而是「60 人、2 亿、100 亿」。
第 7 章讲 SHEIN 那段也在这个水准上:数据中心 7×24 小时扫 TikTok 和 Instagram 的达人种草内容,「如果算法发现『芭蕾核心风』搜索量单日暴涨 200%,会在 72 小时后将相似款挂上官网」;广东牛仔工厂接入数字化系统后次品率从 12% 降到 1.5%,江西假发厂爆款率提升 300%;普宁睡衣厂过去接单至少 5000 件起做,现在 50 件就能开机,生产周期压缩到 3 至 7 天。
第 4 章「芝士相机」那个案例也好用:开发者「超级峰」没有专业编程背景,借 AI 编程工具用 1 天时间做出相机框架和姿势模板,起因是 2024 年 10 月在新疆旅行时发现情侣为拍照姿势争执;他没有立刻开发,先去小红书搜「拍照姿势」验证需求,再发 Demo 收反馈,「开发仅用 1 天,但经过 4 天充分验证后才将芝士相机上架应用商店」。
我把这几段单独拎出来,是因为它们能撑住这本书的信用。一本书有一节硬,就说明作者是有能力写硬的。问题是为什么只有一节硬。
五、它的问题不在案例,在案例的「来源」
上面这些数字,有一个共同点:全都没有出处。
Cursor 的估值 100 亿、ARR 2 亿,是什么时点的数?是融资轮次里的投后估值,还是二级市场报价?Lovable 的 1700 万美元年化收入,是 MRR 乘 12,还是过去 12 个月的实际收入?SHEIN 那条「次品率从 12% 降到 1.5%」,是哪个工厂、什么口径的次品率(返工率?退货率?)?书里一处都没交代。读者能拿走的只有「很好看」,没法拿去核对,也没法拿去复用。
这不是苛求。一本讲「经济学」的书,数字的口径就是它的地基。同样的一个「爆款率提升 300%」,如果基数是 0.5%,那是从 0.5% 到 2%;如果基数是 20%,那是从 20% 到 80%,两件事完全不同。
更关键的是样本选择。全书出现的公司,全部是成功的。Cursor 成功、Lovable 成功、SHEIN 成功、Etsy 成功、芝士相机上架了、礼信年年做成了。没有一家是拿到了同样的工具、用了同样的方法、然后失败了的。而「创富」这件事的实际分布,恰恰是失败的多。
我顺手把书里的数字分成三类,看看它们的可用性差在哪里。
第一类是时点型:估值 100 亿美元、估值 18 亿美元。这类数字最醒目,最没用——它记录的是某一轮融资的定价,过了半年就只是一条历史数据,而且它不告诉你公司赚不赚钱。第二类是口径型:年化收入 2 亿美元、年化 1700 万美元。「年化」是把当月收入乘 12,一个增长极快的公司这么算,会把未来的增速提前兑现;如果换成过去十二个月的实际收入,数字会小一截。第三类是比率型:次品率 12% 降到 1.5%、爆款率提升 300%、生产周期压缩到 3 至 7 天。只有第三类能直接搬走——因为它描述的是「一个流程改造前后的差」,换到别的工厂也大致成立。
一本讲商业的书,含金量就看第三类占多少。这本书里第三类只有 SHEIN 那两三段,其余基本是第一类和第二类。所以它能让你「哇」,不能让你「照着做」。
这就是我前面说它「缺比较」的意思。它统计的是成功者的身高,没有统计有多少人没长到这个高度。用统计学的说法:它给了分子,没给分母。而一本叫经济学的书,最该给的恰恰是分母。
六、所谓的「深度思考」,最硬的一条在第五章
这个体例里的小标题「深度思考」,我抽看的六节里有五节都出现了。多数时候它承担的是「升华」功能:把刚才的案例拔高一层,给一句可以记住的话。比如讲 Etsy 那一节(3.1.1),「深度思考」里写的是:兴趣背后藏着的是一群相似的灵魂,每个看似小众的爱好,本质上都是一个精准的需求集合体。
这话不错,但它是一句正确的观察,不是一次思考。真正的思考会往下问一层:那为什么大部分人做兴趣社群赚不到钱?Etsy 活下来了,和它同时期的同类平台死了多少家?
全书真正称得上「思考」的,是第 5 章 5.1.3 里的一段(p0190):
要让 AI 战略甩掉「摆设」的帽子,就要找到最需要解决的业务问题……要拿着问题找技术,而不是拿着技术找问题。有行业人士形象地将其解释成「锤子和钉子」:锤子代指包括 AI 在内的技术工具,钉子代指面对的实际问题。很多企业家经常是找到一把高质量的锤子,就开始到处找钉子,这里敲敲那里敲敲,最后敲碎了木头,就骂锤子不好用。
这段话是全书我唯一想抄下来的一句。「敲碎了木头,就骂锤子不好用」——这个画面比前面六十四个问号都有说服力。
但它出现的位置很尴尬:在第 5 章,全书倒数第三章。而第 1 章到第 3 章,也就是整本书最前面的 118 屏,实际在做的事情是相反的——它在告诉读者 AI 有多强、别人用它赚了多少、你该怎么配一套工具组合(2.3.1「如何给自己搭配实用的 AI 工具组合?」占了 5 屏,是全章最厚的一节之一)。前半本在发锤子,后半本才说别乱敲。
同一段里还有一个案例值得记:清华五道口「数字中国」项目的学生王建创办团餐企业「礼信年年」,看到 AI 后没有直接买工具,而是先找技术供应商,最后与宏图智能合作,定下 7 个 IT 项目,分别落在财务、质量、人力、配餐几个环节。这个案例的正确之处在于:它把「AI 项目」拆成了具体的业务环节,而不是买一台一体机。可惜它只占了两屏。
七、它的短板
前面已经零散说过几条,这里集中写清楚。这本书的短板有四条,按我认为的严重程度排。
第一,参考文献 12 条,其中两本小说、一本理财入门。我把最后三屏(p0296–p0298)逐条抄了下来:波斯特洛姆《超级智能》(2015)、罗杰斯《创新的扩散》(2016)、莱斯《精益创业》(2012)、安德森《长尾理论》(2006)、郭平《常变与长青》(2024)、赫拉利《未来简史》(2017)、渥克《灰犀牛》(2017)、《富爸爸穷爸爸》(2017)、马克维茨《资产组合选择》(2017)、斯蒂芬森《雪崩》(2009)、普特南《理性、真理与历史》(2005)、阿西莫夫《我,机器人》(2013)。
十二本里,两本是科幻小说(《雪崩》《我,机器人》),一本是理财入门(《富爸爸穷爸爸》),剩下九本全是通识类的畅销书。没有一份产业报告,没有一份统计年鉴,没有一个一手调研。一本书讲了 Cursor、SHEIN、Lovable、Etsy 这么多家公司,却没有任何一条来自这些公司的公开材料。这不是疏忽,这是方法:它用的是「我记得」而不是「我查过」。
第二,只算分子不算分母。这一条前面说过,但它值得单独列出来。创富这件事的收入是幂律分布的,而一本只写头部案例的书,会让读者系统性地高估自己的成功率。书里给了「一人独角兽能持续涌现」的解释(AI 降低了工具门槛、开源模型降低了成本、社交平台降低了获客门槛),这三个解释都对,但它们解释的是「为什么头部能更快长出来」,不是「为什么大多数人长不出来」。后一个问题,全书没有问。
第三,判断跟着新闻走,会很快过期。「为啥 DeepSeek 崛起,很多企业都蔫了」这一节(p0053)写得很生动:DeepSeek 的崛起「如同一场『算法海啸』」,重构了 AI 产业竞争格局,闭源模型「前期投入研发、之后垄断市场收取授权费」的模式遭到开源策略的降维打击,一些基础大模型企业被迫转型为软硬件方案商,「还有一些转向医疗等垂直模型领域」。这段判断在 2025 年上半年是成立的,但它是新闻级的判断,不是结构级的判断。写成书,就等于给一本书定了保质期。
同一节里还有一句更值得注意:「中国很多芯片新玩家争相在 2025 年寻求 IPO(首次公开募股),也从侧面展现了持续融资的难度。」这句话的信息量很大——它其实在说,这一轮的「创富」里有相当一部分是资本市场的估值游戏,而不是经营现金流。可惜作者只是顺手一提,没有往下追。这本来是最像经济学的一段。
第四,第 2 章的职业建议是情绪价值,不是方法。「35 岁了,面对年龄问题,你该如何应对」「天天忙着开会,怎么脱身」「外包改了几十遍,还是只能用回第一版,怎么办」——这三节的标题抓得很准,都是真痛点。但三屏的篇幅里,能装下的只能是「别焦虑,用 AI 把重复劳动交给机器,把时间留给判断」。这句话对,也安慰人,但它不是方法。方法是:怎么算这件事该不该交给 AI?交出去之后自己的位置在哪?如果三个月后老板发现这件事不需要你了呢?
八、第 6 章 34 屏:最薄的一章,离主线最远
第 6 章「财富管理」是全书最薄的一章,34 屏。它讲的是把钱从「做业务」挪到「管钱」:不下牌桌硬扛行不行、不做实业去管钱是不是不务正业、能不能投资年轻人创业、AI 辅助投资靠不靠谱、AI 概念股还是不是造富神器、一级市场的几种参与形式哪种更好。
这一章里有一段是全书唯一的一手实验记录(p0236):
单纯依赖 AI 进行股票投资决策,结果大概率会让你失望。2025 年我们尝试用多个 AI 工具实操,发现未接入实时数据的 AI 模型,训练集截至 2024 年 6 月,这类模型常会告诉你……「我应假设数据是当前的,并给出一些建议。」
这段的价值在于:它记录了一个真实的技术边界——模型不知道今天是几号,也不知道训练集之后发生了什么,所以它会「假设数据是当前的」。这个观察是对的,而且很具体。
但它停在了这里。没有标的,没有时间窗,没有持仓,没有收益率,没有最大回撤,连用了哪几个工具都没说。「结果大概率会让你失望」——失望到什么程度?是跑输指数 3 个点,还是亏掉一半?读者拿不到任何可判断的东西。
这是全书最可惜的一处。它明明做了一次实验,却只写了一句感受。一个 2025 年真的拿工具跑过盘的团队,如果肯把过程摊开——选了哪些标的、每个工具的结论差多少、人最后改了几次——那会是这本书里最有分量的十屏。结果是它用了两屏讲 MPT(现代资产组合理论)能怎么被 AI 变成「综合计算的投资建议」,然后收工。
从结构上讲,这一章还有个更根本的问题:它离全书的主线最远。第 3、4 章讲的是「一个人 + AI 怎么做出东西来卖」,第 5 章讲「组织怎么运转」,第 6 章突然跳到「钱怎么投出去」。这条线不是不能接——「做出东西」之后确实是「把钱变成资本」——但中间缺了一环:从「赚到第一笔钱」到「有一笔钱可投」之间的那段路,书里没有。而这恰恰是绝大多数读者卡住的地方。
九、那这本书该怎么读
我不打算说「不值得读」。它有明确的用处,只是用处和封面写的不一样。
把它当案例库读,收获是实的。芝士相机那个「一天开发、四天验证」的节奏,是可以直接抄的作业流程;礼信年年把 AI 拆成 7 个业务环节而不是买一台机器,是可以直接抄的决策顺序;Cursor 六十人做到一百亿估值这件事,是可以拿去说服老板「小团队也能干大事」的素材。全书这样的段落大概有二十处,分布在 218 屏的小节里。
把它当经济学读,会失望。它没有价格,没有约束,没有比较;它的参考文献里有阿西莫夫;它的七章等长到像是按版面排的;它的每个问题都在第二屏就给了答案。
如果让我给作者提一条修改建议,只有一条:把那六十五个问号砍到二十个,每个问题给十屏,其中必须有一屏写「这个方法在什么情况下会失效」。298 屏的总量不用变,书的性质就变了——从一本可以随查随用的问答集,变成一本能被人引用、能被人反驳、能活过三年的书。
至于现在这一本:它是一份很好的「2025 年上半年 AI 商业观察笔记」。观察笔记的价值在于新鲜,而新鲜这件事,恰好是它写在封面上的「经济学」三个字最不承诺的东西。
阅读记录
书名:AI创富经济学:从超级个体到商业巨擘
作者:唐昕龙、王丹|出版时间:2025
本次阅读:微信读书逐页截图 298 屏,版权页至「全书完」全覆盖,含内容简介、作者简介、序一序二、推荐语、前言、7 章 65 节、后记、12 条参考文献,抓取标记为全书读完(end=last_page),耗时 291 秒
篇幅分配(按章节起始页相减):前置 21 / 第 1 章 39 / 第 2 章 41 / 第 3 章 38 / 第 4 章 41 / 第 5 章 41 / 第 6 章 34 / 第 7 章 39 / 后记 1 / 参考文献 3;65 个三级小节全部为问句,平均 3.35 屏(2 屏 10 节、3 屏 28 节、4 屏 21 节、5 屏 6 节)
说明:本文引句与全部数字均来自本次截图,可逐字核对;书中未标注任何产业数据来源,我据此判断其案例与数字为作者转述口径,非一手统计
逐页精读系列 · 2026 年 11 月
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: