
GEO实战:它把「被AI引用」当成了终点
《GEO实战:AI时代的流量密码》,庞文英著。作者是传播学与管理学硕士,做过二十一年 SEO 和网络舆情公关,服务过一百多家企业,书里还提到自己主导过某个燕窝品牌的「SEO+GEO 战略十一年」。
GEO 是 Generative Engine Optimization 的缩写,中文大概是「生成式引擎优化」。说白了:以前你要在百度、谷歌里排进第一页,现在你要在 DeepSeek、豆包、Kimi 给出的那段答案里被提到。战场从「链接列表」变成「一段话」。
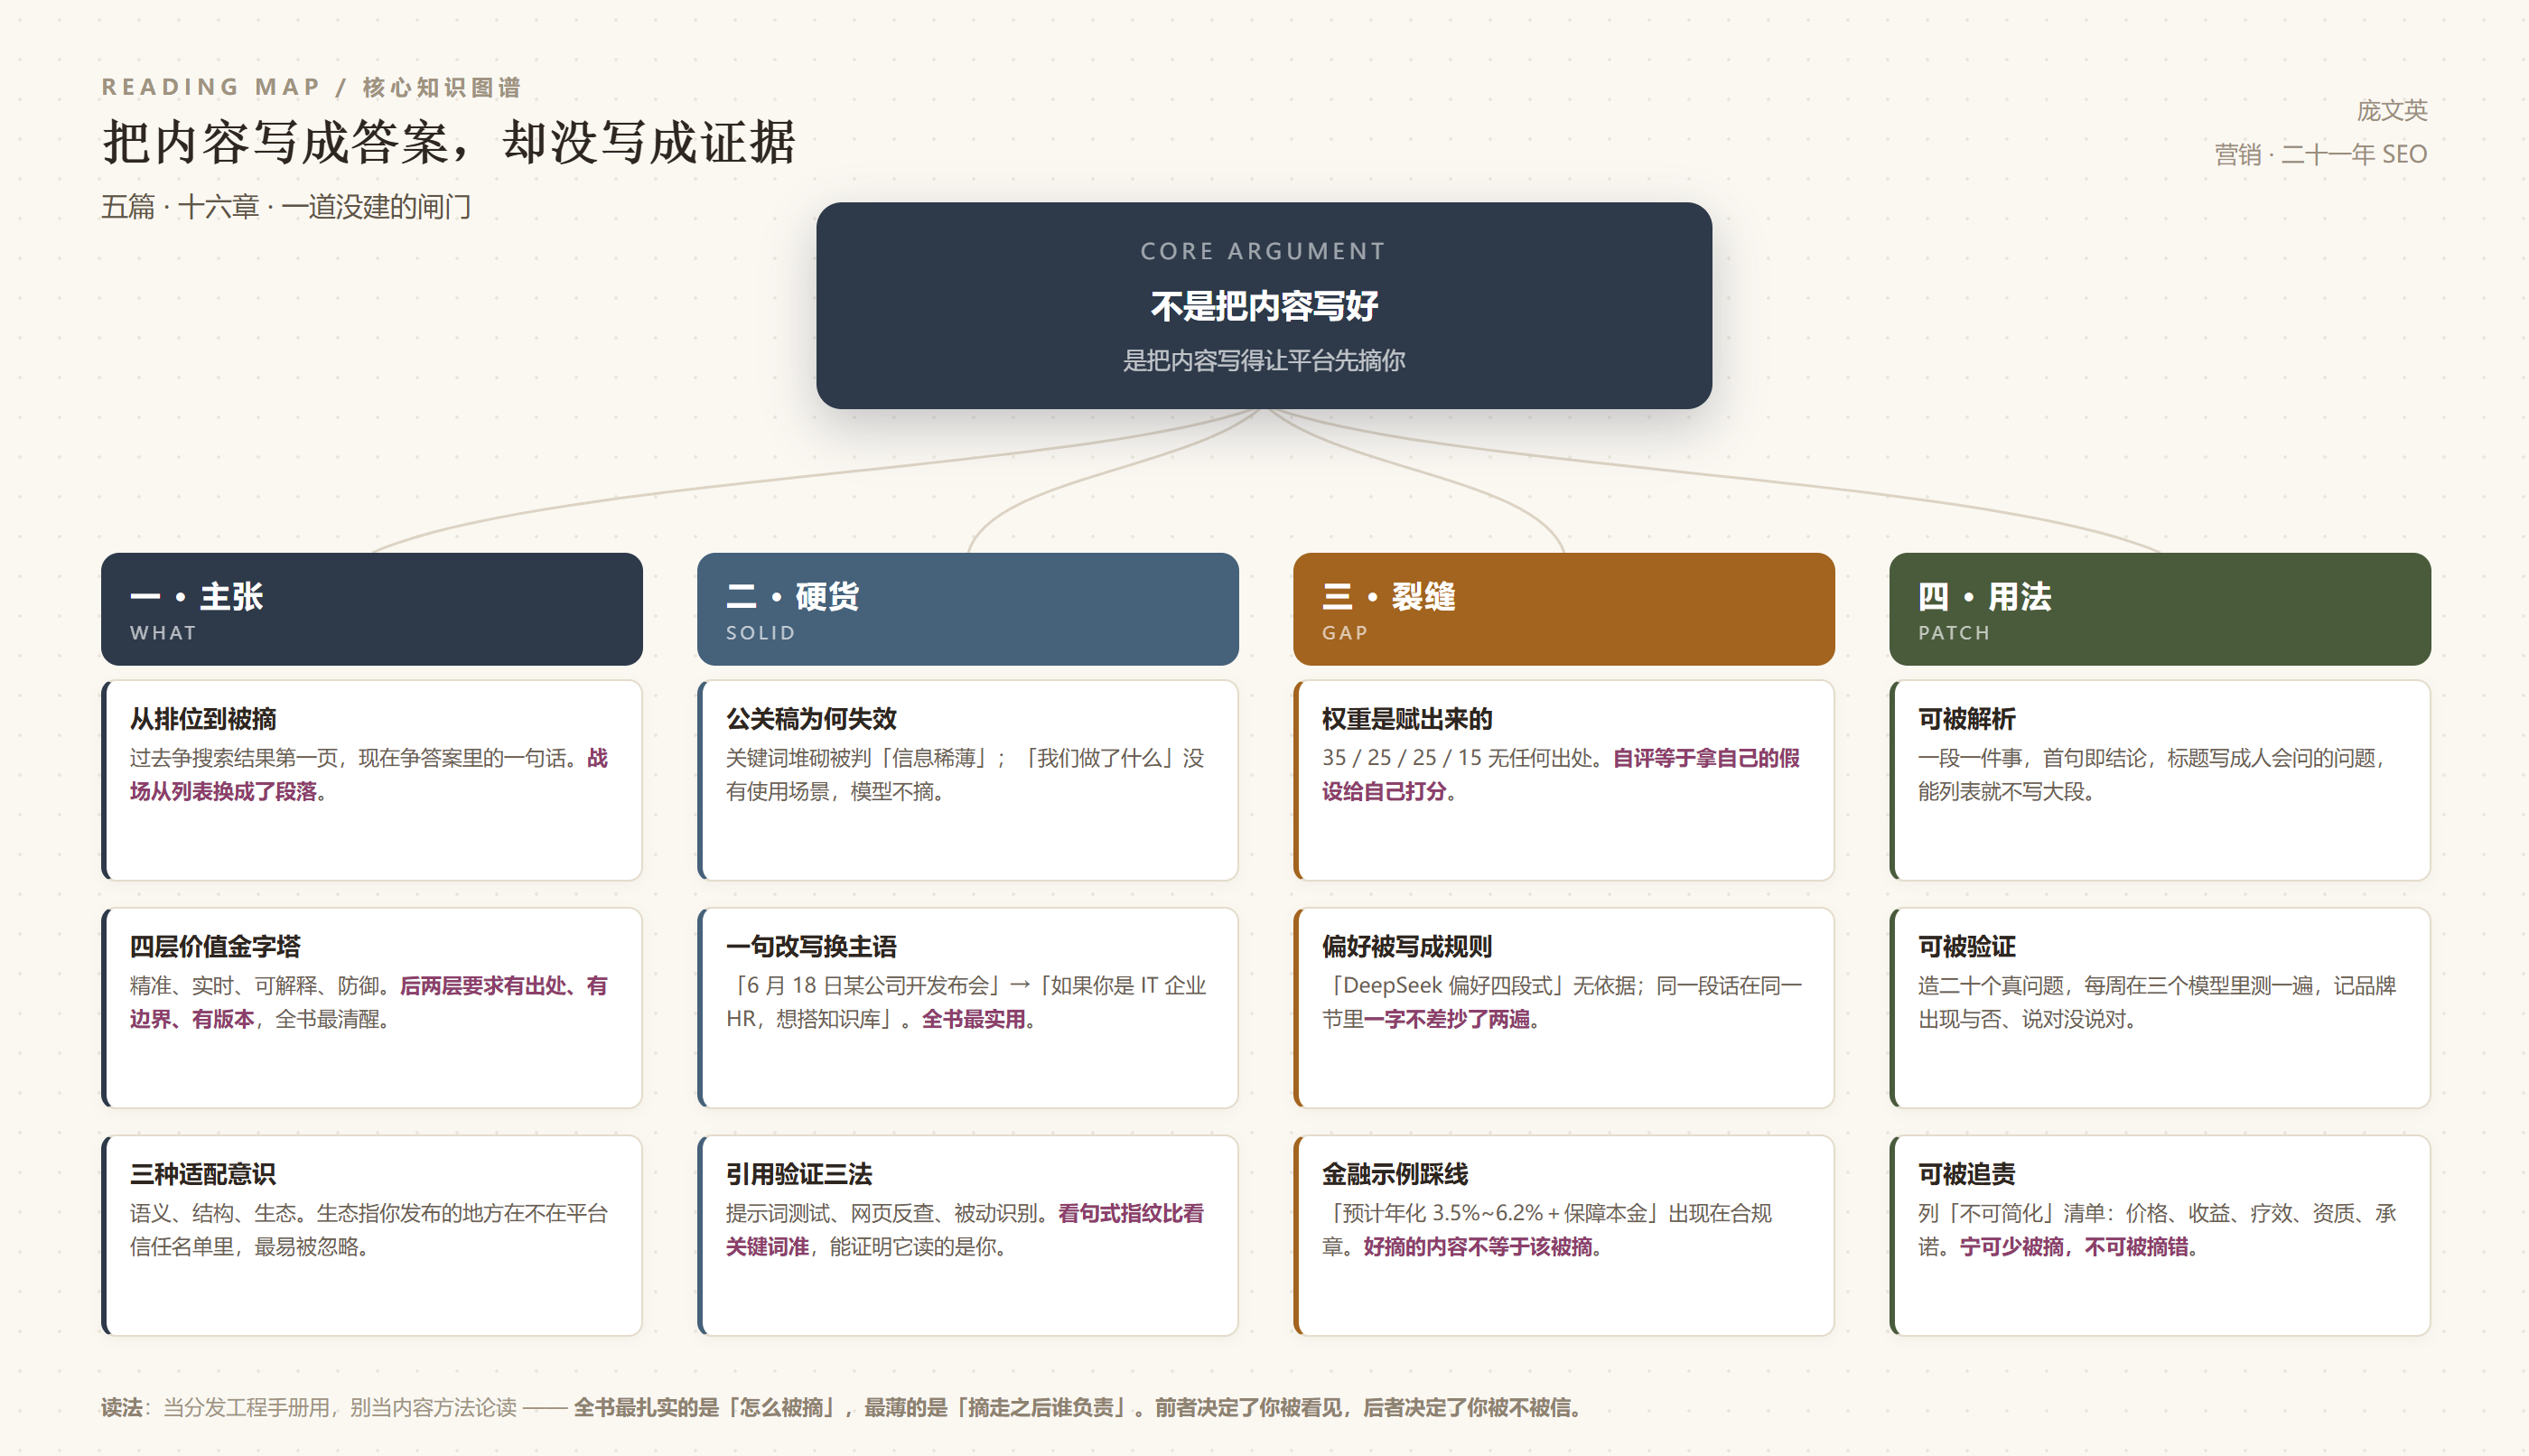
这本书读完,我最想说的是它自己写下的那句话——「最终目标,不是『把内容写好』,而是『把内容写得让平台优先引用』。」这句话诚实得近乎残忍。它把这本书的性质一次说清了:这不是一本讲写作的书,是一本讲分发的书;它衡量的不是「读者觉得有用」,是「模型愿意摘你」。
而全书最大的问题也就出在这儿:它把「被引用」当成了终点,几乎没有回头问一句——被引用之后,对不对?
一、先弄清它说的 GEO 到底是什么
这本书的框架很清楚,五篇:基础、技术、内容、行业、实战。逻辑是「先讲清 AI 怎么找内容,再讲怎么让内容被找到,最后按行业给方案」。
它给 GEO 画了一个「核心价值金字塔」,四层:精准性、实时性、可解释性、防御性。精准性是内容要对得上具体意图,不是泛泛而谈;实时性是内容要能被更新,作者举的例子是用户问「今天的股票市场表现如何」,你得给当下的行情,不是去年的;可解释性是内容要有可追溯的支撑,比如医学建议要能挂到文献和指南上;防御性是当 AI 把你的内容断章取义、或者引用了过期版本时,你有办法纠正。
这个四层设计我认为是书里最像「想清楚了」的地方。它把 GEO 从「怎么讨好算法」拉回到「内容本身得站得住」——尤其后两层,本质上要求你说的话有出处、有边界、有版本。
但读下去会发现,这两层在实操部分几乎没被兑现。这是后话。
它还提了「三种适配意识」:语义适配(内容能不能对上平台识别的意图场景)、结构适配(好不好被解析、有没有模块化和清晰逻辑)、生态适配(有没有出现在平台优先采信的数据源里)。三个词概括得准,尤其第三个是很多人忽略的:AI 引不引你,很大程度上取决于你发布的地方本身在不在它的信任名单里。你在自己官网写得再好,模型可能一次都没抓过;你在一个被反复引用的平台上写的一段话,反而更容易被摘走。
二、这本书的底子是 SEO,它自己也知道
读技术篇时我有一个很强的感觉:这不是一套新方法,是一套老方法的平移。
知识图谱、结构化 schema、多模态标注、向量数据库、FAQ 模块、meta 字段——这些词的祖宗都在 SEO 那一套里。Schema.org 的结构化标记 2011 年就有了,知识图谱是谷歌 2012 年推「知识面板」时的核心,FAQ 结构化数据也早写进了各家搜索的站长指南。作者做的事,是把这些「让爬虫看懂」的手段,重新解释成「让大模型看懂」。
这个平移是有效的,而且我认为是这本书真正的价值。大模型检索内容的方式确实和爬虫有相通之处:它要切块、要判断语义、要找到「一个完整的答案单元」,而不是一整篇抒情散文。这个判断我认。
问题在于,作者没把这层关系挑明。书里反复用「AI 时代」「范式迁移」「认知主权」这类大词,读起来像一门全新的学问;但如果老老实实说「这是 SEO 的结构化思路在生成式引擎上的延伸」,读者的预期会更准,也不会被后面那些明显没做完的部分绊住。
举个具体的例子。第 2 章讲结构化 schema 是「机器可理解的语言」,第 3 章讲「什么样的知识图谱可以被 AI 理解」,第 4 章讲「让 AI 看懂你的多模态信息」——三章的内核是同一件事:把你的信息拆成机器能对齐的实体和属性。这活儿在 SEO 时代叫「结构化数据」,在 GEO 时代叫「语义单元」。换了名字,工序没变。
这不是贬低。工序没变,恰恰说明这套东西是经过十几年验证的,不是拍脑袋的。真正的新东西只有一样:过去你优化的是「排名」,现在你优化的是「被摘录的概率」,而后者没有公开的排名规则,只能靠观察。
三、全书最实用的一节:公关稿为什么在 AI 眼里等于没说
第 6 章第一节,是我在整本书里读到的最扎实的一段。
它解释「传统 SEO 稿和公关稿为什么正在失效」,给了三个原因。
第一个:关键词堆砌被 AI 识别为「无效语义」。过去 SEO 讲「关键词覆盖」,现在模型做的是语义理解和意图判断,一篇文章里密集重复关键词却没有清晰结构,「语义链条不清晰,就容易判断为『信息稀薄』」。
第二个:公关稿的「品牌先行」语言模糊了用户的意图匹配。它举的原话是——公关稿常见的写法是「我们举办了什么活动,发布了什么产品,取得了什么成就」,而「这些内容在 AI 眼里不具备明确的使用场景,也难以匹配具体用户的兴趣标签」。
第三个:内容结构混乱,AI 提取不到核心信息。大段陈述、没有小标题、没有列表、没有 FAQ,模型就切不出「核心信息模块」。
然后它给了一个改写,这个改写我认为值得抄下来:某科技公司发新品,传统 PR 稿的开头是「6 月 18 日,某某公司在京召开战略发布会……」;而 GEO 视角的写法是「如果你是 IT 企业 HR,想快速搭建知识管理系统,这款平台上线……」。
同一件事,两种说法。前者在讲「我发生了什么」,后者在讲「你遇到什么麻烦、我这东西能不能解」。这个转换不需要任何技术,只需要把主语从「我们」换成「你」。而这一步,绝大多数企业的新闻稿从来没做过。
这一段之所以好,是因为它讲的是判断——判断读者在什么处境下会问什么问题。判断不需要数据支撑,需要的是对人的理解。而这本书里,凡是涉及「人」的部分,都写得比涉及「系统」的部分好。
四、但它把「平台偏好」写成了常识
从第 6 章往后,这本书出现了一种很危险的写法:把推测写成结论。
比如它有一张表,叫「企业内容评估模型参考」,四个维度四个权重:语义相关度 35%、结构清晰度 25%、引用率 25%、字段匹配度 15%,底下配一个公式「内容推荐分数=∑(每项得分×权重)」。表头写的是「简化的内容推荐评估模型,用于企业自评内容『平台友好度』」。
问题是:这四个权重从哪来的?没有任何一家平台公布过这样的权重,也没有任何一组对照实验能证明 35 比 30 更准。它看起来像一个模型,实际上是一次赋值。企业拿这张表去自评,评出来的分数是自己的假设在给自己打分。
更明显的一处在第 8 章。它写「以 DeepSeek 为例,该平台偏好结构明确、问题导向清晰、意图突出的内容表达,因此发布策略需重点聚焦『问题+背景+建议+风险』四段式呈现」。语气是陈述事实,但没有给出任何依据——没有官方文档,没有测试记录,没有对比样本。而没有任何一家平台公布过这样的「偏好清单」。
而且这段话说一遍还不够。它在同一节里一字不差地出现了两次:一次挂在「平台分发与优化推荐」下面,一次挂在「DeepSeek 优化示例结构」下面,两段之间只隔了一行流程箭头。这种重复已经不是观点问题,是编辑问题——一本书在同一个位置把自己的段落抄了两遍,说明成稿后没有被认真通读过。
这类「平台偏好」的断言在书里出现了很多次:这家喜欢四段式,那家喜欢问答体,另一家喜欢带数据的结论。它们可能有经验基础,作者做了二十年这行,手感是真的。但写进书里,就必须说明这是「经验观察」而不是「平台规则」。这两者的差别,决定了读者是拿去试,还是拿去当标准。
五、「三城对比」这一节,暴露了行业篇的通病
第 7 章讲地域 GEO,篇幅是全书正章里最短的。而它给出的核心示范,是「北京、上海、成都的 GEO 策略差异」,举的例子是奶茶店。
上海那一段:多模态上推精美图片和慢节奏视频,突出环境雅致的门店设计和消费者的优雅生活场景,配轻柔爵士乐;关键词围绕「高端奶茶」「网红店推荐」「下午茶打卡地」,吸引讲究生活品质的上海用户。
成都那一段:强调门店的社交属性,比如「好友聚会首选」,融入本地文化元素(川剧、火锅);多模态上发布带地方方言配音的趣味视频;关键词着重「成都奶茶推荐」「朋友聚会好去处」「休闲慢生活」。
读起来很顺,但你把它翻过来看:这里面有哪一个字是 GEO?这是标准的城市人群画像加关键词表,是本地生活投放的常规动作。整节没有一个「我在 AI 里搜了这几个问题、结果如何」的记录,没有一次引用测试,没有一条不同城市用户提问方式的对比。
一本讲 GEO 的书,讲地域策略时不给 AI 侧的观测数据,这是很奇怪的。GEO 的全部特殊性在于「答案是一段生成的话」,要证明策略有效,最直接的办法就是把同一批问题丢进几个模型,看答案里有没有你。这件事在第 15 章讲了方法,却没在第 7 章用上。
同样的毛病贯穿整个行业篇,五个行业五章:金融、B2B、快消、教育、医疗。每章结构都一样——先讲行业特性,再讲内容结构,最后给一个案例。而五个案例全部匿名:「某银行」「某 B2B 企业」「某财经教育品牌」「中国某食品品牌」。效果全是形容词或无法核对的倍数:「短视频产量从日均 3 条增长至 30 条以上」「热点响应时间从 48 小时缩短至 2 小时以内」。
我知道为什么匿名——客户不让说,这在乙方是常态。但匿名有代价:读者无法验证,也无法从中学到具体的坑。行业篇写了五章,真正能被复用的东西,只剩下「面向不同行业要有不同的语义场景」这一句常识。
六、第 8 章那段金融示例,把自己绊了一下
第 8 章讲金融行业的 GEO,标题里就带着「合规与精准决策」。这一章里有一段内容示例,是给客户看的回答片段,大意是:
「根据您的风险等级『中』,建议配置如下资产组合:40% 短期固收产品、30% 平衡型基金、30% 地区专项信托产品。预计年化收益范围为 3.5%~6.2%,其中固收类保障本金……」
这段文字放在一本讲「怎么让 AI 引用你」的书里,作为「好内容」的示范。
我要指出的不是它写得不好,而是它踩在了一条线上。金融营销内容里,「预计年化收益范围」这类表述在监管口径下是敏感的——不得预测收益、不得承诺保本,是这几年反复强调的红线。而这本书在同一章里刚讲过「风控与合规双重考量」,紧接着给出一个带收益率区间、带「保障本金」字样、还带具体配置比例的示例。
这个矛盾很说明问题。作者的注意力全在「这段内容结构好不好被 AI 摘走」——它有明确的风险等级、具体的数字、整齐的四段结构,从「可引用性」看是满分;但从「合规性」看,它是一段不该由 AI 生成、也不该被 AI 复述的话。
这就是 GEO 这套方法最需要的一道闸门:你优化的对象是「被引用的概率」,而被引用的内容里,有一部分是不该被放大的。这本书建立了这道闸门的意识(它提到了可解释性和防御性),但没有把它做成流程。它把责任放在最后一章的一小节里,标题写得很好——「GEO 时代的内容责任:不仅要『说得好』,更要『说得对』」——可这一节篇幅很小,配一张表,就结束了。
七、验证方法这一节,是全书真正的硬货
说完全书的问题,必须说它最有价值的部分:第 15 章讲「发布路径与引用验证」的那几页。
它给了三种验证办法,都很朴素,都能立刻做。
第一种是提示词测试:在 DeepSeek、文心一言、Kimi 里输入真实问题,观察生成的答案里有没有引用自家内容的段落。门槛是零,效果直观。你可以自己造二十个用户会问的问题,一周测一次,把结果记下来。
第二种是网页反查工具:分析内容有没有被模型抓取、有没有进索引。
第三种叫被动识别:监测 AI 的回答里有没有出现你的品牌名、你的句式、你的独有结构。这一条最有意思,因为它是「风格指纹」的思路——模型摘你的时候常常会保留你的表述方式,句式和结构比关键词更能证明「它读的是你」。
它还提了一个很实用的动作:在官网或外链内容里加 UTM 参数,追踪从各平台过来的点击路径,再结合站点数据看 AI 来源访客的点击路径、停留时间、跳出率,以及有没有引导到咨询、注册、试用。这套「数据回流」把 GEO 从玄学指标变成了可归因的漏斗——虽然归因不会太干净(用户在 AI 里看到你、然后自己去搜你,这条路径追踪不到),但比「感觉最近咨询多了」强得多。
第 15 章还有一张表,叫「针对舆情内容常用的处理策略」,两类风险两类对策。一类是「AI 错引内容」——模型引用了老旧、不适当或过时的信息,对策是设置数据时间戳、更新内容版本、标明时效性。另一类是「模型误读语义」——断章取义、忽略语气或上下文,对策是「使用段落语义封闭结构、限定条件表达」。
「段落语义封闭结构」这个词造得有点生硬,但意思对:你要让每一段自己站得住,不依赖上下文也能被正确理解,因为模型极有可能只摘走这一段。这是全书我唯一觉得「只有做过这行的人才写得出来」的地方。
八、它自己说破了:目标不是写好,是被优先引用
现在回到开头那句引文。
最终目标,不是「把内容写好」,而是「把内容写得让平台优先引用」。
我不认为作者在教人作弊。这句话在商业语境里是实话:企业做内容,本来就是为了被看见。但这句话一旦成为方法论的总纲,会产生三个后果,而这本书对这三个后果都没有正面处理。
第一,内容的同质化会加速。如果所有人都按「问题+背景+建议+风险」四段式写,所有答案都会长得一样,模型最后摘谁只能靠域名权重和发布量,内容质量反而退到次要位置。这跟 SEO 时代「所有人都在标题里堆关键词」是同一个结局。书里没有讨论这个均衡。
第二,答案污染会变成常态。书里讲「AI 平台凭什么推荐你」,讲的是引用率、结构、字段匹配。这套逻辑推到底,最优策略是「把自己包装成最容易被摘的答案」,而不是「最正确的答案」。当一批企业都这么做的时候,模型学到的是「谁更会写答案」,不是「谁更懂这件事」。这本书提到了防御性,但防御的对象是「别人错引我」,不是「我污染了答案池」。
第三,责任会落空。一篇文章被 AI 摘走、改写成一句更简洁的话、发给几十万人,这句话错了,谁负责?作者的原话、平台的算法、改写它的模型、还是把它当成答案的用户?书里给的答案是「建立跨部门语义危机响应预案」「设立语义危机小组,确保 AI 舆情事件可在 12 小时内响应」。这是公关的思路——出事了赶紧灭火。但 GEO 真正需要的不是灭火队,是发布前的闸门:哪些内容可以为了「可引用」而简化,哪些一个字都不能简化。
这三件事,作者不是没想到。他在后记里写「从流量争夺到认知共生」,标题就点到了。但整本书的篇幅分配说明他最终还是选择了「流量」这一侧——技术地基写得很厚,行业案例写得很满,而「责任」与「挑战」被压到最后,各占一章里的一小节。
九、它的短板
除了前面提到的,还有几处必须点出来。
案例全部匿名,且没有可核对的数字。五个行业五个「某」。效果描述要么是形容词(「显著提升」「大幅改善」),要么是无法验证的倍数(「产量从日均 3 条到 30 条」)。这是行业书的通病,但一本自称「实战」的书,读者最想要的恰恰是能对照的台账:改了什么、改之前引用率多少、改之后多少、测了多少个问题、覆盖哪几个模型。这些一个都没有。
「趋势与挑战」这一章被压得太薄。第 16 章讲「从 SEO 到 GEO 的范式迁移」「AI 平台技术的发展趋势」「GEO 方法体系的未来趋势」,三节加起来是全书最短的一章。而这一章本该最重要——因为这本书的方法全部建立在一个假设上:模型的检索和引用机制会保持现在这个样子。这个假设一旦变了(平台开始封闭、开始卖答案位、开始只引用白名单),整本书的招式会一起失效。作者只用几段话带过,还顺手举了几个无法核实的例子(某食品品牌的短视频产量、某公司的投放 Agent)。
地域 GEO 这一章最薄,而它本该最实用。做本地生意的人(餐饮、教育、医美、装修)最需要 GEO,因为他们的问题最具体:「附近哪家好」「多少钱」「靠不靠谱」。这一章只给了城市性格分析,没给「本地意图词怎么挖」「没有技术团队的商家怎么把内容结构化」。这是全书最明显的供需错位。
附录像是招聘启事拼的。附录 A 给了三个岗位:内容专家、技术工程师、数据与策略分析师,每个都有职责和能力要求。能力要求里写「熟悉 AIGC 内容生成工具(如 GPT-4、DeepSeek、豆包、Claude)」「能读懂基础 prompt 模板,理解 AI 是如何『理解内容』的」。这些话对,但它们是招聘启事的话,不是书的话——它没有回答一个更基本的问题:一家二十人的公司,这三个人是不是必须分开招?一个人能不能干三份?
还有一个时间上的小尴尬。作者简介里写「主导小仙炖品牌 SEO+GEO 战略 11 年实操」。GEO 这个词进入中文营销圈也就是这一两年的事,十一年前不存在「GEO 战略」这个东西。我理解作者想说的是「SEO 做了十一年,现在延伸到 GEO」,但写成「SEO+GEO 战略 11 年」,会让读者对这本书的经验厚度产生误判。这类表述在营销圈很常见,也就更该在书里被校一次。
十、这本书该怎么用
尽管挑了不少毛病,这本书我不会不推荐。它解决的是一个真问题:当用户不再点链接、只看答案时,你的内容怎么才能进到那段答案里。这个问题在未来几年只会更重要。
我的用法是把它当「分发工程手册」,不当「内容方法论」。具体三步。
第一步,可被解析。把每一段写成能独立成立的语义单元:一段只说一件事,第一句就是结论,标题写成人会问的问题,能列表就不写大段。这一步不需要任何工具,今天就能改。
第二步,可被验证。按第 15 章的办法,自己造二十个真实问题,每周在三个模型里测一遍,记录品牌有没有出现、出现在第几句、说的是不是你想说的。这件事的价值不在于「优化」,在于你终于有了一个能看的数。没有这个数,所有 GEO 方案都是自说自话。
第三步,可被追责。这一步书里没有,我自己加上:给每一类内容定一条「不可简化」的清单。价格、收益、疗效、资质、承诺,这几类信息在改写时必须原样保留,宁可牺牲「可引用性」,也不能牺牲准确。因为 AI 摘走的是句子,承担后果的是品牌。
一句话收束:让 AI 愿意引用你,是技术;让被引用的那句话经得起追问,是底线。这本书把技术写全了,底线只写在了最后。
阅读记录
书名:GEO实战:AI时代的流量密码
作者:庞文英
读法:全书五篇十六章通读,含推荐序、前言、三个附录与后记
说明:文中引语、表格数据与案例描述均摘自原书;关于权重无出处、平台偏好属经验而非规则、金融示例存合规风险的判断,是我读后所加,原书未作此论
逐页精读系列 · 2026 年 11 月
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: