
我的第一本生成式AI创意使用指南:它把 AI 会怎么翻车,讲得比怎么用清楚
《我的第一本生成式AI创意使用指南》,拉杰夫·卡普尔(Rajeev Kapur)著。这是一本入门书,第二版,序言由一位做过戴尔、联想和安富利首席执行官的人执笔。作者在前言里交代了来历:第一版 2023 年 9 月出,反响好,在购书网站的人工智能类目里排到过第一;但他写完就知道这本书"并没有真正完成",于是有了第二版。
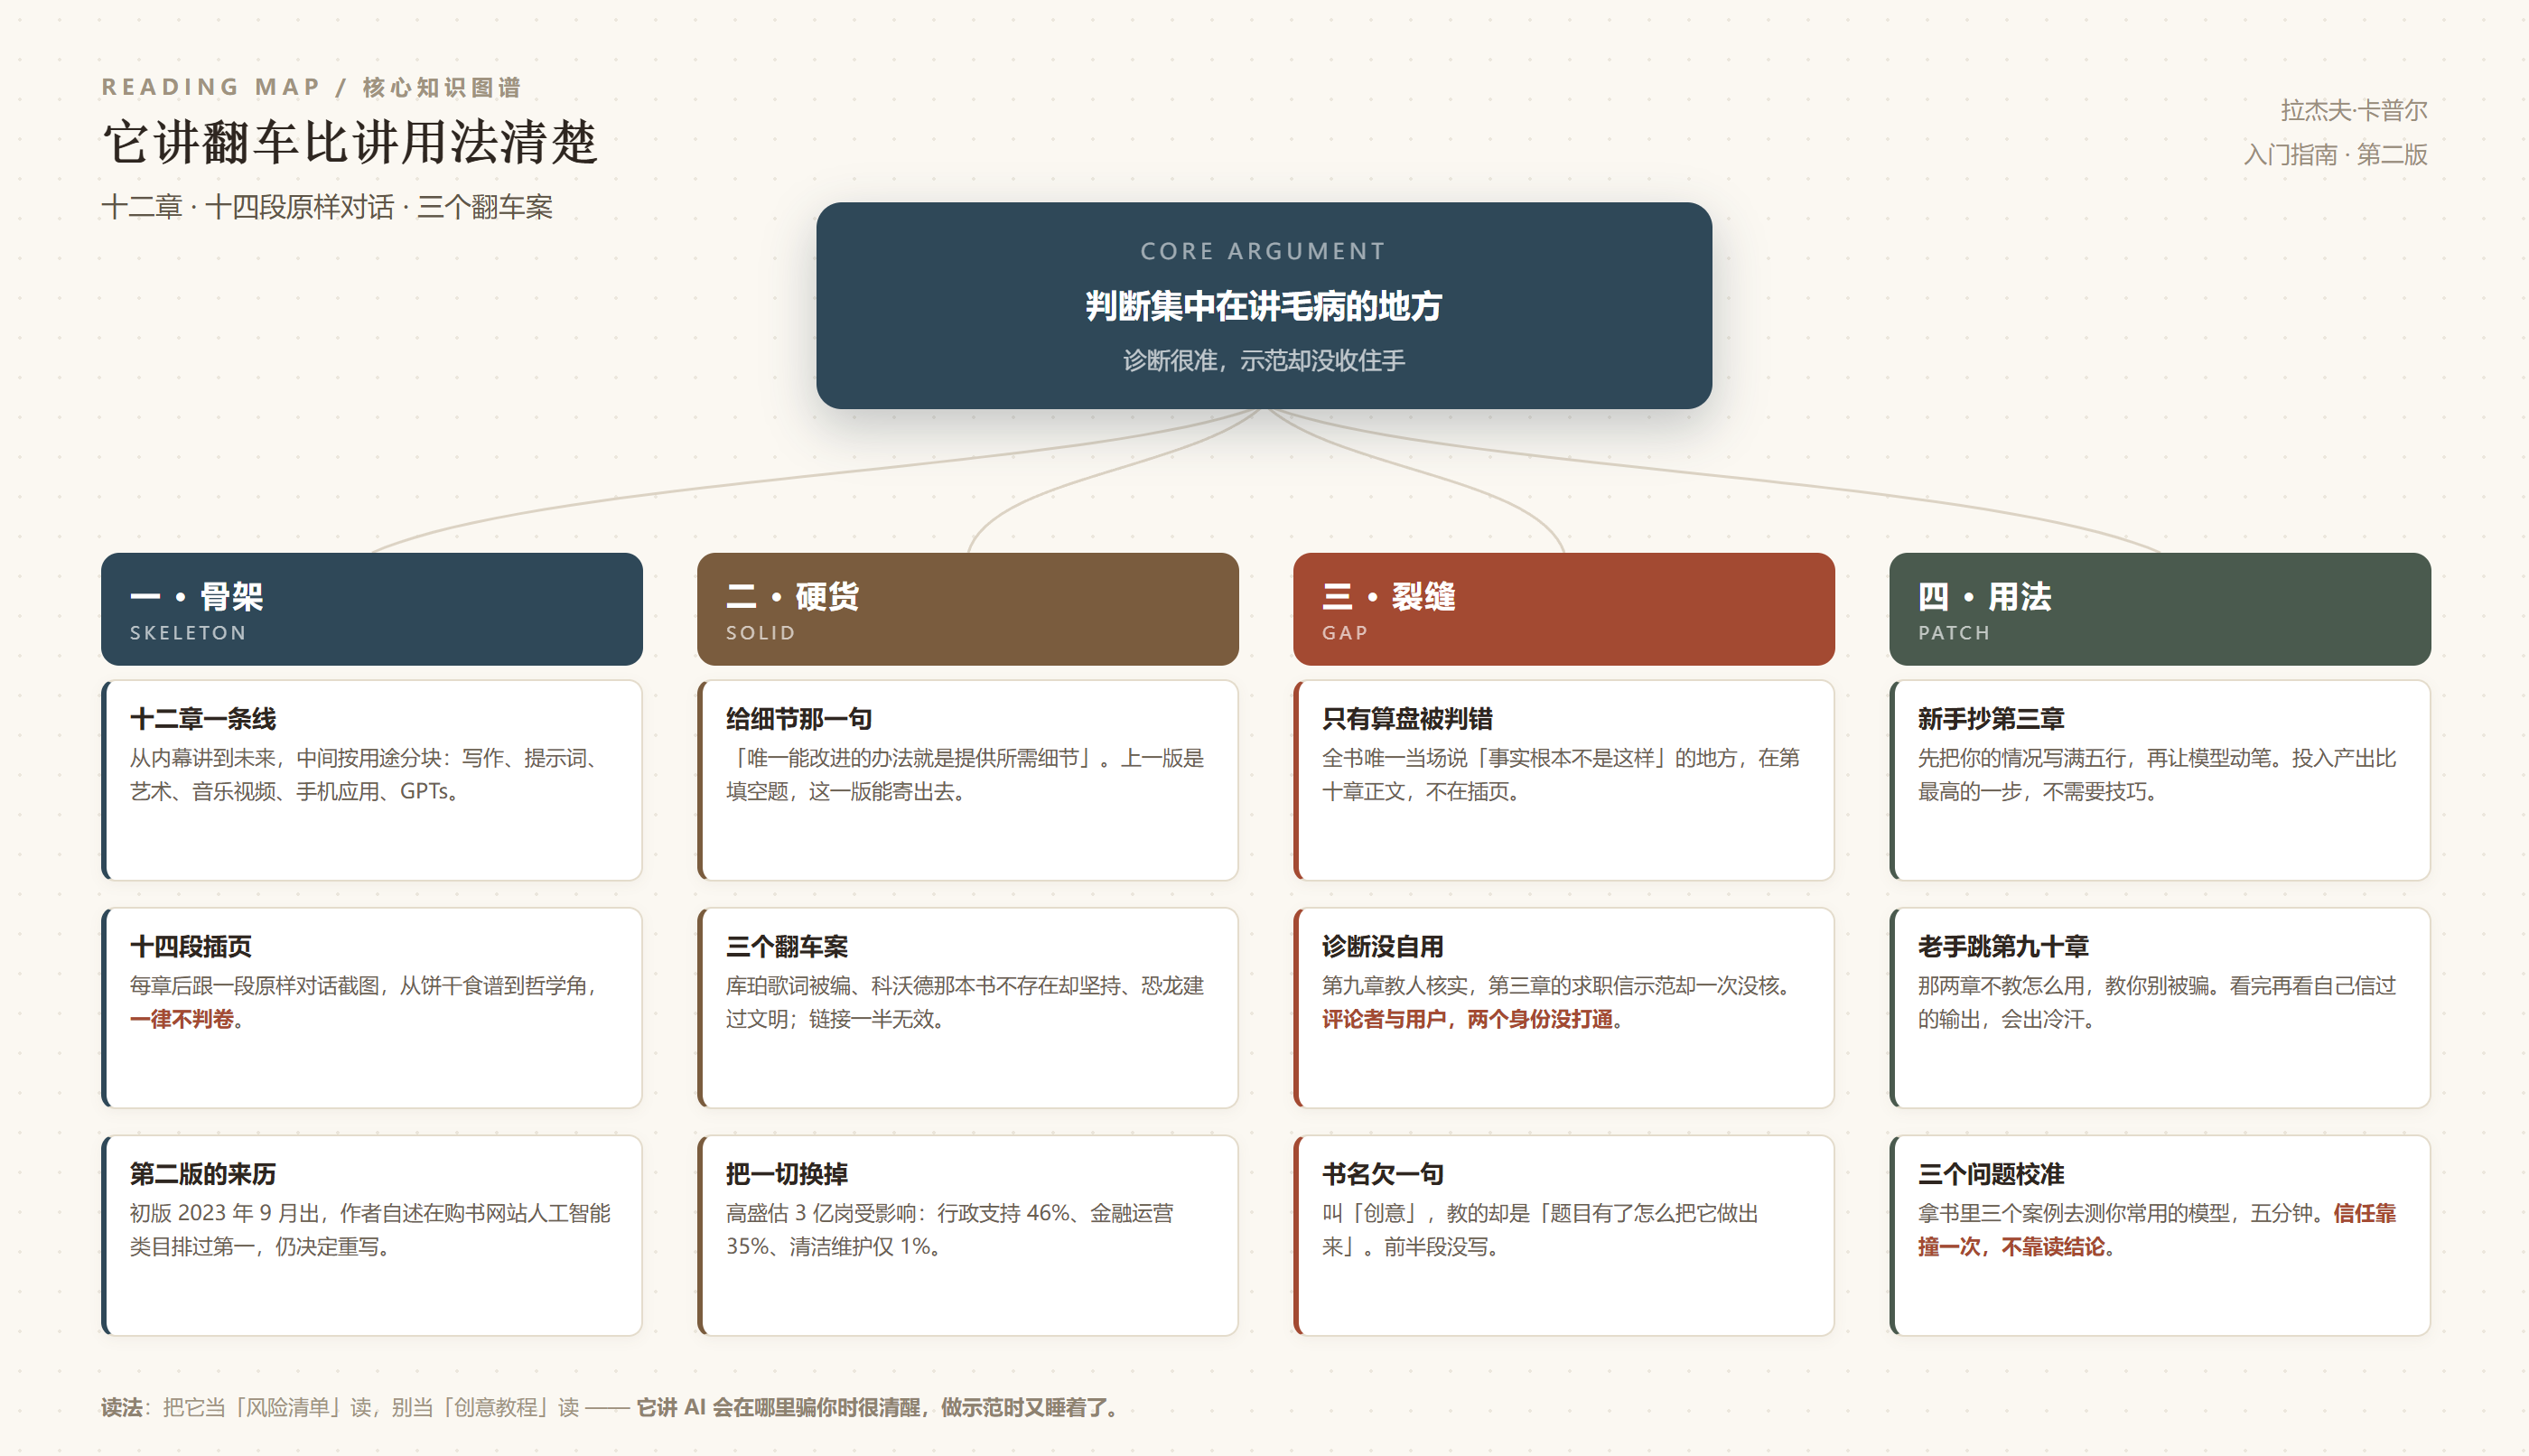
全书十二章,从"生成式人工智能的内幕"讲到"未来的冲击",中间按用途分成写作、提示词、艺术、音乐与视频、手机应用、GPTs 几块,最后落在局限、伦理和领导力上。每一章后面,跟着一段"向生成式人工智能提问"的插页,一共十四段,形式是把问题和 ChatGPT 的原始回答截图直接印在纸上。
我读完的判断是:这本书最有价值的不是"怎么用",是"会怎么出错"。第九、第十两章给的翻车案例,比前面七章的用法清单更耐读,也更难被时间冲掉。而它的问题恰恰在这两章之外——它把判断力集中放在了讲毛病的地方,等到自己示范的时候,又把判断收了回去。
一、它的骨架:每种用法后面,都跟着一段原样的对话
先说编排,因为这个编排是这本书区别于同类的地方。
多数入门书讲完一个功能,会附一段"我这样写提示词,AI 就这样回答",然后替读者总结"你看,效果很好"。这本书不一样:它把 ChatGPT 的界面截图整段搬上来,从"1. 将软化的黄油、砂糖和红糖在大搅拌碗中混合搅拌至轻盈蓬松"这样的饼干食谱,到"2. 逐个打入鸡蛋",七步,全部保留。第一段插页的引言只有一句轻描淡写的话:随着本书的深入,我将分享一些人工智能对各种问题的实际回答,好好享受吧,但记住,你还是需要自己动手做饼干。
十四段插页的题目清单本身很说明问题:谁来点饼干、为什么 E=mc²、迷失在群星中、你的人工智能健身计划、感到孤独、追逐瀑布、你真的可以问它任何问题、玫瑰的另一个名字、一个很难敲开的椰子、超级对决、开胃的奶酪之歌、圣诞剧透预警、哲学角、结束。
这些题目有两个共同点:一,都不难;二,都不需要负责。这是一本入门书对读者的体贴——先用好玩的问题把注意力留住,再谈正经的。但这也是一个代价:原样奉上的十四段回答,作者基本没有判卷。判卷的工作被集中挪到了第九、第十章。这个分工本身没错,问题在于,读者最容易记住的是插页里那些机灵的回答,而机灵和正确,是两件事。
顺带说一句第一章。这一章讲"内幕",路子是把 AI 从你身边的东西讲起:亚马逊旗下的智能语音助手 Alexa、苹果手机语音助手 Siri,问路、查天气;人工智能在智能家居、汽车电脑和银行系统背后起作用,银行靠它迅速检测欺诈;在线零售商拿它做产品推荐,奈飞(Netflix)和迪士尼(Disney)拿它推荐节目。然后往上追:人工智能的发展得益于 20 世纪 80 年代机器学习(Machine Learning, ML)的创建,研究人员受人脑结构和功能的启发,开发了人工神经网络,这些网络由相互连接的节点(又叫神经元)组成,处理信息并根据经验调整连接。再往下,是"告知"程序哪些图像与标签相对应,于是它能识别相似的图像——谷歌眼镜那类图像识别程序就是这么工作的。
这套讲法的好处是门槛低:不抛公式,不画矩阵,从"你家的音箱"一路讲到"神经元"。坏处是它把一件很难的事讲得太顺了,顺到读者容易以为"神经网络"就是"仿照大脑连线"。这个类比的代价,要到第九章才付——当模型一本正经地说恐龙建过文明时,读者会本能地想"它不是照着大脑做的吗,怎么会错成这样"。书里没有把这条线接上。
二、第三章里那句真正有用的话
全书方法论上最扎实的一句,出现在第三章讲写作的地方,而且是在一次失败之后说出来的。
作者想示范用 AI 写求职信。第一次,他大概只给了"帮我写一封求职信"这样的指令,出来的东西是这样的:我拥有[相关领域]的学士学位,并在[相关行业/领域]积累了[年数]年的工作经验……此致,[你的名字]。方括号全在,一个没填。
他对这个结果的评价很准:"这与你能在网上找到的,可以根据自身需求进行修改的任意一篇通用求职模板非常相似,对吧?唯一能改进的办法就是为 ChatGPT 提供所需细节,使求职信更具针对性。"
然后他真的把细节给了:我是一名拥有 10 年销售经验的销售人员,是我公司的销售冠军;我拥有哈佛大学的商学学位,并因创造的业绩而多次获奖;我比我所知道的任何人都更擅长销售;我申请的公司是美国内布拉斯加州南部排名第一的汽车零售商,职位是销售经理。请为我写一封求职信。
结果的差别是肉眼可见的:上一版是填空题,这一版是一封能寄出去的信。接着他又加了一句"不超过 200 字",让 AI 把长信压成短版——这一手在今天看来很平常,但它是这套方法的核心:你给的信息量,决定输出的针对性;你不给,模型只能给你平均值的答案。
这句"唯一能改进的办法就是提供所需细节",比后面第四章整章的提示词要素都管用。第四章讲的是怎么组织提示词——明确任务目标、设置限制条件、指定格式与结构、限定特定元素、拆解复杂任务——这些都对,都是标准动作。但真正让人从"能用"跨到"好用"的,是愿不愿意花五分钟把自己的情况写清楚。这是一件不需要技巧、只需要耐心的事,也正因为这样,它最容易被跳过。
三、第九章:全书最靠得住的一份资产
如果这本书只能留一章,我留第九章。
这一章讲局限,开篇先承认一件不太体面的事:尽管使用 ChatGPT 可能很有趣,但归根结底,你仍然是在和一台计算机交流。然后它甩出一个缩略词,GIGO——Garbage In, Garbage Out,垃圾进,垃圾出。作者用了一个很好的比喻:有人问去最近银行的路线,如果他拿到的是错误的路线指引,他没有办法知道自己得到的是错误信息。生成式 AI 也一样,它的输出会反映训练数据的偏差,而它自己并不知道哪一部分是错的。
接着是案例,每一个都具体到可以查:
美国全国广播公司财经频道(CNBC)向 ChatGPT 询问艾丽斯·库珀(Alice Cooper)在 20 世纪 70 年代的歌曲《德怀特·弗莱民谣》(The Ballad of Dwight Fry)的歌词。ChatGPT 不知道这些歌词,又无法获取它们,于是干脆自己编造了歌词,但没有说明这些歌词是编造的。它还声称西班牙油条(Churros)是家庭手术的理想工具。
有人要求它阐述加拿大生物伦理学学者哈罗德·科沃德(Harold Coward)关于"动态经典性"的观点。ChatGPT 很笃定地宣称科沃德写过一本名为《动态经典性:圣经与神学阐释的一种模型》(Dynamic Canonicity: A Model for Biblical and Theological Interpretation)的书。但实际上科沃德并没有写过这本书。然而,ChatGPT 仍坚持认为这本书是真实存在的。它还声称恐龙曾建立过它们自己的文明,并且存在恐龙工具的化石遗迹。
这三段的价值在于"坚持"两个字。编错答案不稀奇,稀奇的是被指出之后还坚持。作者由此给了一句挺重的评语:如此离谱的结果使得一些技术专家将 ChatGPT 称为"反社会的"。然后他自己补了一句更冷静的话——很容易理解为什么生成式人工智能没有道德意识,毕竟,我们是在和一台计算机交流,而且真的不能指望计算机能明辨是非。
这一章还引了一位记者的实测,那段话值得整段抄下来:在我多次向 ChatGPT 询问信息来源的过程中,它提供的大约一半的链接是无效链接。另有 25% 甚至更多的链接所指的主题与你的主题完全或在一定程度上不相关。这位记者测的是里根总统广泛推广的"信任,但要核实"这句话的资料来源,结果拿到的大多数来源根本不存在,剩下能打开的页面,主题与所讨论的短语毫无关系。
一半无效,四分之一不相关——这两个数字,比任何"请注意核实"的提醒都有用。因为它把"核实"从一个态度问题,变成了一个工作量问题:你要核的不是一两条,是一半以上。
四、那只算盘:作者唯一当场判错的一次
第十章讲伦理,中间有一段我读了两遍。
作者贴了一个提问和回答。问题是:为什么在深度学习方面算盘计算比 DNA 计算更快?ChatGPT 的回答一本正经:就深度学习而言,算盘计算通常比 DNA 计算更快,这是因为它运用机械计算原理来执行运算。这使得它无需进行复杂的分子反应,也无需消耗大量能源,就能快速且高效地进行复杂计算……算盘计算还具有高度的便携性……总体而言,算盘计算的速度和效率使其成为深度学习算法中,可替代 DNA 计算的潜在选择。
然后作者只写了一句:当然,事实根本不是这样的。实际情况就是如此!后面跟了一张老算盘的照片,图 10.1。
这是全书最诚实的一段。它没有解释"为什么模型会这样答",没有分析"这是不是对齐失败",它只是把一段胡说八道摆出来,配一张算盘,说:看,这就是它。
而这一段之所以重要,是因为全书十四段插页里,我找不到同样明确的一次判错。插页把回答原样给你,让你自己看着舒服;第十章把回答原样给你,然后告诉你这是假的。同一个作者,同一种排版,判断的有无,决定了这两处内容是"示范"还是"证据"。
同一章里还有一句,我觉得是全书最该被记住的态度。作者说,希望随着发展,生成式人工智能能够被"训练"得对自己把握不大的答案给出限定性说明,甚至,也许有时它能说出那神奇的 4 个字:"我不知道。" 我不知道这会不会在我未来更新这本书的第三版时实现,但如果能做到那就太好了!
写这段话的人,是一位做了几十年企业高管的人。他要的不是更强的模型,是一个肯承认不知道的模型。这个愿望朴素得有点让人意外,也说明他到写完这本书,仍然没等到。
这一章的另一半讲深度伪造,态度比讲幻觉时更保守。他承认:制作"深度伪造"的音频、视频和图像仍然是一个严重且持续存在的问题;借助这项新技术,人们真的可以让任何人说出自己想让他说的话。然后加了一句转折:幸运的是,大多数深度伪造内容都能很快被识破。但试想一下,要是没来得及揭穿其虚假性呢?
这句"但试想一下",是这一章里我最认同的地方。因为它没有停在"技术会自我修正"这种安慰上,它把问题往前推了一步:在自我修正之前,那段时间里被相信的东西,谁负责?书里没有回答,但它至少把问题问出来了。
五、他的立场:把"一切"换成"某些事情"
第十一章讲领导力,是全书姿态最高的一章,也藏着一句最实用的话。
他先摆数据:正如高盛银行所指出的,多达 3 亿个工作岗位可能会受到生成式人工智能的影响。某些职业类别受到的影响会比其他类别更大。那些不太会发生变化的职业包括需要大量体力劳动的工作,以及那些需要大量人力因素的工作,比如治疗师。然而,据估计,46% 的办公室和行政支持类工作以及 35% 的商业和金融运营类工作可能会实现自动化。而在清洁和维护领域,只有 1% 的任务可能会由人工智能来处理。
然后是他自己的判断:关键点是什么呢?虽然某些工作的某些方面可能会转由人工智能技术来完成,但我们仍然需要人类来确保一切顺利进行。所以,当你听到有人说人工智能将取代"一切"时,把"一切"换成"某些事情"。而这种取代,需要过渡时间。
"把一切换成某些事情"——这句话是我在这本书里划得最重的一句。它不是修辞,是一个可以随身带着用的过滤器。凡是看到"AI 将取代 X"的句子,先做这个替换,再看它还剩多少分量。绝大多数时候,剩下的是"某些环节的某些任务",而不是一个职业。
他给领导者的三条动作也很实在:让员工了解生成式人工智能能做什么、不能做什么;帮助员工提升技能并重新学习技能,以便适应变化;建立体系,帮助员工安全且负责任地使用生成式人工智能。三条里没有一条是"采购工具"。
第八章讲 GPTs,是全书唯一一处把"造一个小工具"的全过程摊开的地方。截图里,作者在 GPT 创建器里一步步答问:给这个机器人取名"公爵档案",因为要体现约翰·韦恩的绰号"公爵",又要体现它所提供信息的档案性质;选一张手绘风格的复古电影胶片加牛仔帽的初始头像;被问到"它应该纯粹陈述事实,还是在其语言中融入一丝经典西部风格"时,他答"一丝经典西部风格";被问到"是否应更侧重于约翰·韦恩的电影制作方面或文化影响",他答"尽可能避免政治因素";最后被问到"当用户问题不明确时,是索取更多信息还是做合理推测",他选"合理推测"。
这四个选择,其实就是产品设计:语气、边界、侧重、遇疑怎么办。有意思的是,创建器问得比大多数产品经理都清楚。这一段值得单独看,因为它是全书唯一一处让读者看到"调教"这件事的具体手感——不是写一句咒语,是连续做四个取舍。
六、结语那个类比,漂亮,但要小心
结语叫"一个新的启蒙时代即将来临吗",作者用一个体育故事收尾。
1954 年,罗杰·班尼斯特(Roger Bannister)打破了一项看似无法逾越的障碍:在 4 分钟内跑完 1 英里。突然之间,在几个月内,其他跑步者开始经常突破 4 分钟的极限,甚至超过了班尼斯特的成绩。他把这叫"班尼斯特效应",并把它和围棋放在一起讲:研究人员评估了在人工智能围棋程序诞生之前人类棋手的表现,然后在 3 年后进行了评估。他们发现,棋手们的决策能力和落子质量大幅提高,同时人为失误减少。
结论是乐观的:人工智能不是来取代人的,是来把人的上限往上顶一顶的。
这个类比我认可一半。班尼斯特效应成立有个前提:人能看到那个成绩是真的,并且能反复验证。4 分钟一英里是秒表量出来的,谁也造不了假。而 AI 给的东西,恰恰是最难验证的那一类——它可能编一首不存在的歌词,可能坚称一本不存在的书存在,可能把算盘说成深度学习的优选方案。用一个"可验证的极限"去类比"不可验证的输出",这一步跨得太快了。
围棋那个例子倒是站得住,因为棋手有棋谱、有胜负、有对手。可"AI 帮你写文案"没有胜负,只有转发量,而转发量里混着运气、投放和平台算法。所以我愿意接受他的方向,但要把条件补上:AI 能抬高上限,前提是你手里有一把能验证的尺子。没有尺子的时候,它抬高的可能只是自信。
七、它的短板
说几条具体的。
第一,工具清单的保质期很短。第六章讲音乐,Mubert 那一套被拆成 Mubert Render、Mubert Extension(与 Adobe After Effects 和 Premiere Pro 兼容)、Mubert Studio、Mubert Play 四个应用逐个介绍;Soundraw 连价格都写了——每月 19.99 美元,是市面上可用于商业创作的音乐生成器里最便宜的之一。这类内容在成书那天是对的,两三年后就得整段重写。而方法部分——比如"给细节"、"把一切换成某些事情"——不会过期。一本书把篇幅押在名单上,它的半衰期就短。
第二,插页不判卷,是个结构性让步。十四段原样回答里,至少第一段的引言只说了"好好享受",没有一句评价。判断被集中放在第九、十章。这个安排在阅读体验上说得通,但它让最容易被翻到的部分(短、有趣、有图)承担了最少的判断。读者记住的是机灵,不是边界。
第三,案例几乎全是美国的。内布拉斯加州南部的汽车零售商、CNBC、里根总统图书馆、高盛的就业估算、AlphaFold 拿的 300 万美元奖金。这些都对,但对中文读者来说是二手经验:你能理解那个场景,用不上那个场景。全书没有一个中国企业、中国平台的具体操作案例。
第四,书名里的"创意",正文没接住。书名叫"创意使用指南",副题是"快速掌握 AI 写作、绘画、编曲等技能"。可十二章里,讲的是怎么让 AI 写求职信、怎么让 AI 画一只拿电锯的黑猩猩、怎么用 Mubert 生成一段音乐、怎么在 GPT 创建器里做一个叫"公爵档案"的约翰·韦恩主题机器人。这些都是"用工具做事",不是"想出值得做的事"。创意的前半段——想出一个别人没想到的题目——这本书没有教。它教的是后半段:题目有了,怎么把它做出来。这不丢人,但书名欠读者一句说明。
第五,也是最要紧的一条:它诊断得很准,却没有把诊断用在自己身上。第九章说 GIGO,说模型会编、会坚持、会把不相关的链接当证据;可第三章的求职信示范、第六章的工具推荐、第八章的 GPT 创建器对话,都是"它给了,我就收了",没有一处回头问"这段是不是也可能错"。一本把"核实"讲得这么清楚的书,自己的示范里却没有一次核实的动作。这不是疏忽,是入门书的通病:讲道理的时候是评论者,做示范的时候是用户,两个身份没有打通。
八、这本该怎么用
我的建议很具体:
如果你刚开始用 AI,第三、四章值得照着做一遍。特别是第三章那个"给细节"的动作——先把你的情况写满五行,再让 AI 动笔,出来的东西立刻不一样。这是投入产出比最高的一步。
如果你已经用了半年,直接跳第九、第十章。那两章不是教你用,是教你别被骗。CNBC 那首歌、科沃德那本不存在的书、那只算盘,三个案例够你用很久。看完再回头看自己以前信过的 AI 输出,会出一身冷汗。
如果你在带团队,第十一章那三条动作和"把一切换成某些事情"那句话,可以直接拿去做内部分享的提纲。
至于第六章那些工具名单——看一眼就行,别记。等你真要做音乐那天,市面上的工具已经换过一轮了。
还有一个用法,是我自己试完觉得值的:拿第九、第十章那三个案例,去测你正在用的模型。问它艾丽斯·库珀那首歌的歌词,问它科沃德那本书,问它算盘和 DNA 计算哪个在深度学习上更快。三个问题,五分钟,你对它的信任度会校准到一个更真实的位置。信任校准这件事,靠读别人的结论没用,得自己撞一次。
一句话收束:这本书教会你的不是"AI 能做什么",而是"AI 会在哪里骗你";可惜它讲骗术的时候很清醒,做示范的时候又睡着了。
阅读记录
书名:我的第一本生成式AI创意使用指南:快速掌握AI写作、绘画、编曲等技能
作者:拉杰夫·卡普尔(Rajeev Kapur)
版本:第二版
读法:全书十二章通读,含序言、第二版前言、结语、术语表
说明:文中引语与案例(CNBC 歌词、科沃德著作、算盘与 DNA 计算、高盛就业数据、班尼斯特效应等)均摘自原书;关于插页不判卷、班尼斯特类比缺验证前提、书名与内容错位的判断,是我读后所加,原书未作此论
逐页精读系列 · 2026 年 11 月
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: