
AI速成课:它教你先造世界,问题是世界太干净
《AI速成课:从AI编程到构建智能软件》,[阿联酋]赫德林·德·庞特维斯著,程泽、黄曼莉译,机械工业出版社 2020 年 7 月版,十五万六千字。
先说结论:这本书叫「AI 速成课」,但它其实是一本强化学习的书,而且是一本相当扎实的强化学习入门书。整本十五万字,从头到尾只做一件事——教你怎么把一个模糊的现实问题,拆成「状态、行为、奖励」三个变量,然后让机器在这个你自己捏出来的世界里反复试错,直到它学会。
这个定位很重要。如果你带着「学 AI」的预期翻开它,会失望:没有 Transformer,没有预训练,没有一句提示词。如果你带着「我想知道机器怎么学会一件事」的预期翻开它,会觉得赚了:它把这个过程拆得极细,细到你可以在一个下午里,用几十行代码看着一个什么都不懂的程序,慢慢学会玩贪吃蛇。
这两种感受之间的落差,就是这本书全部优缺点的来源。
一、它教的不是 AI,是一条强化学习的独木桥
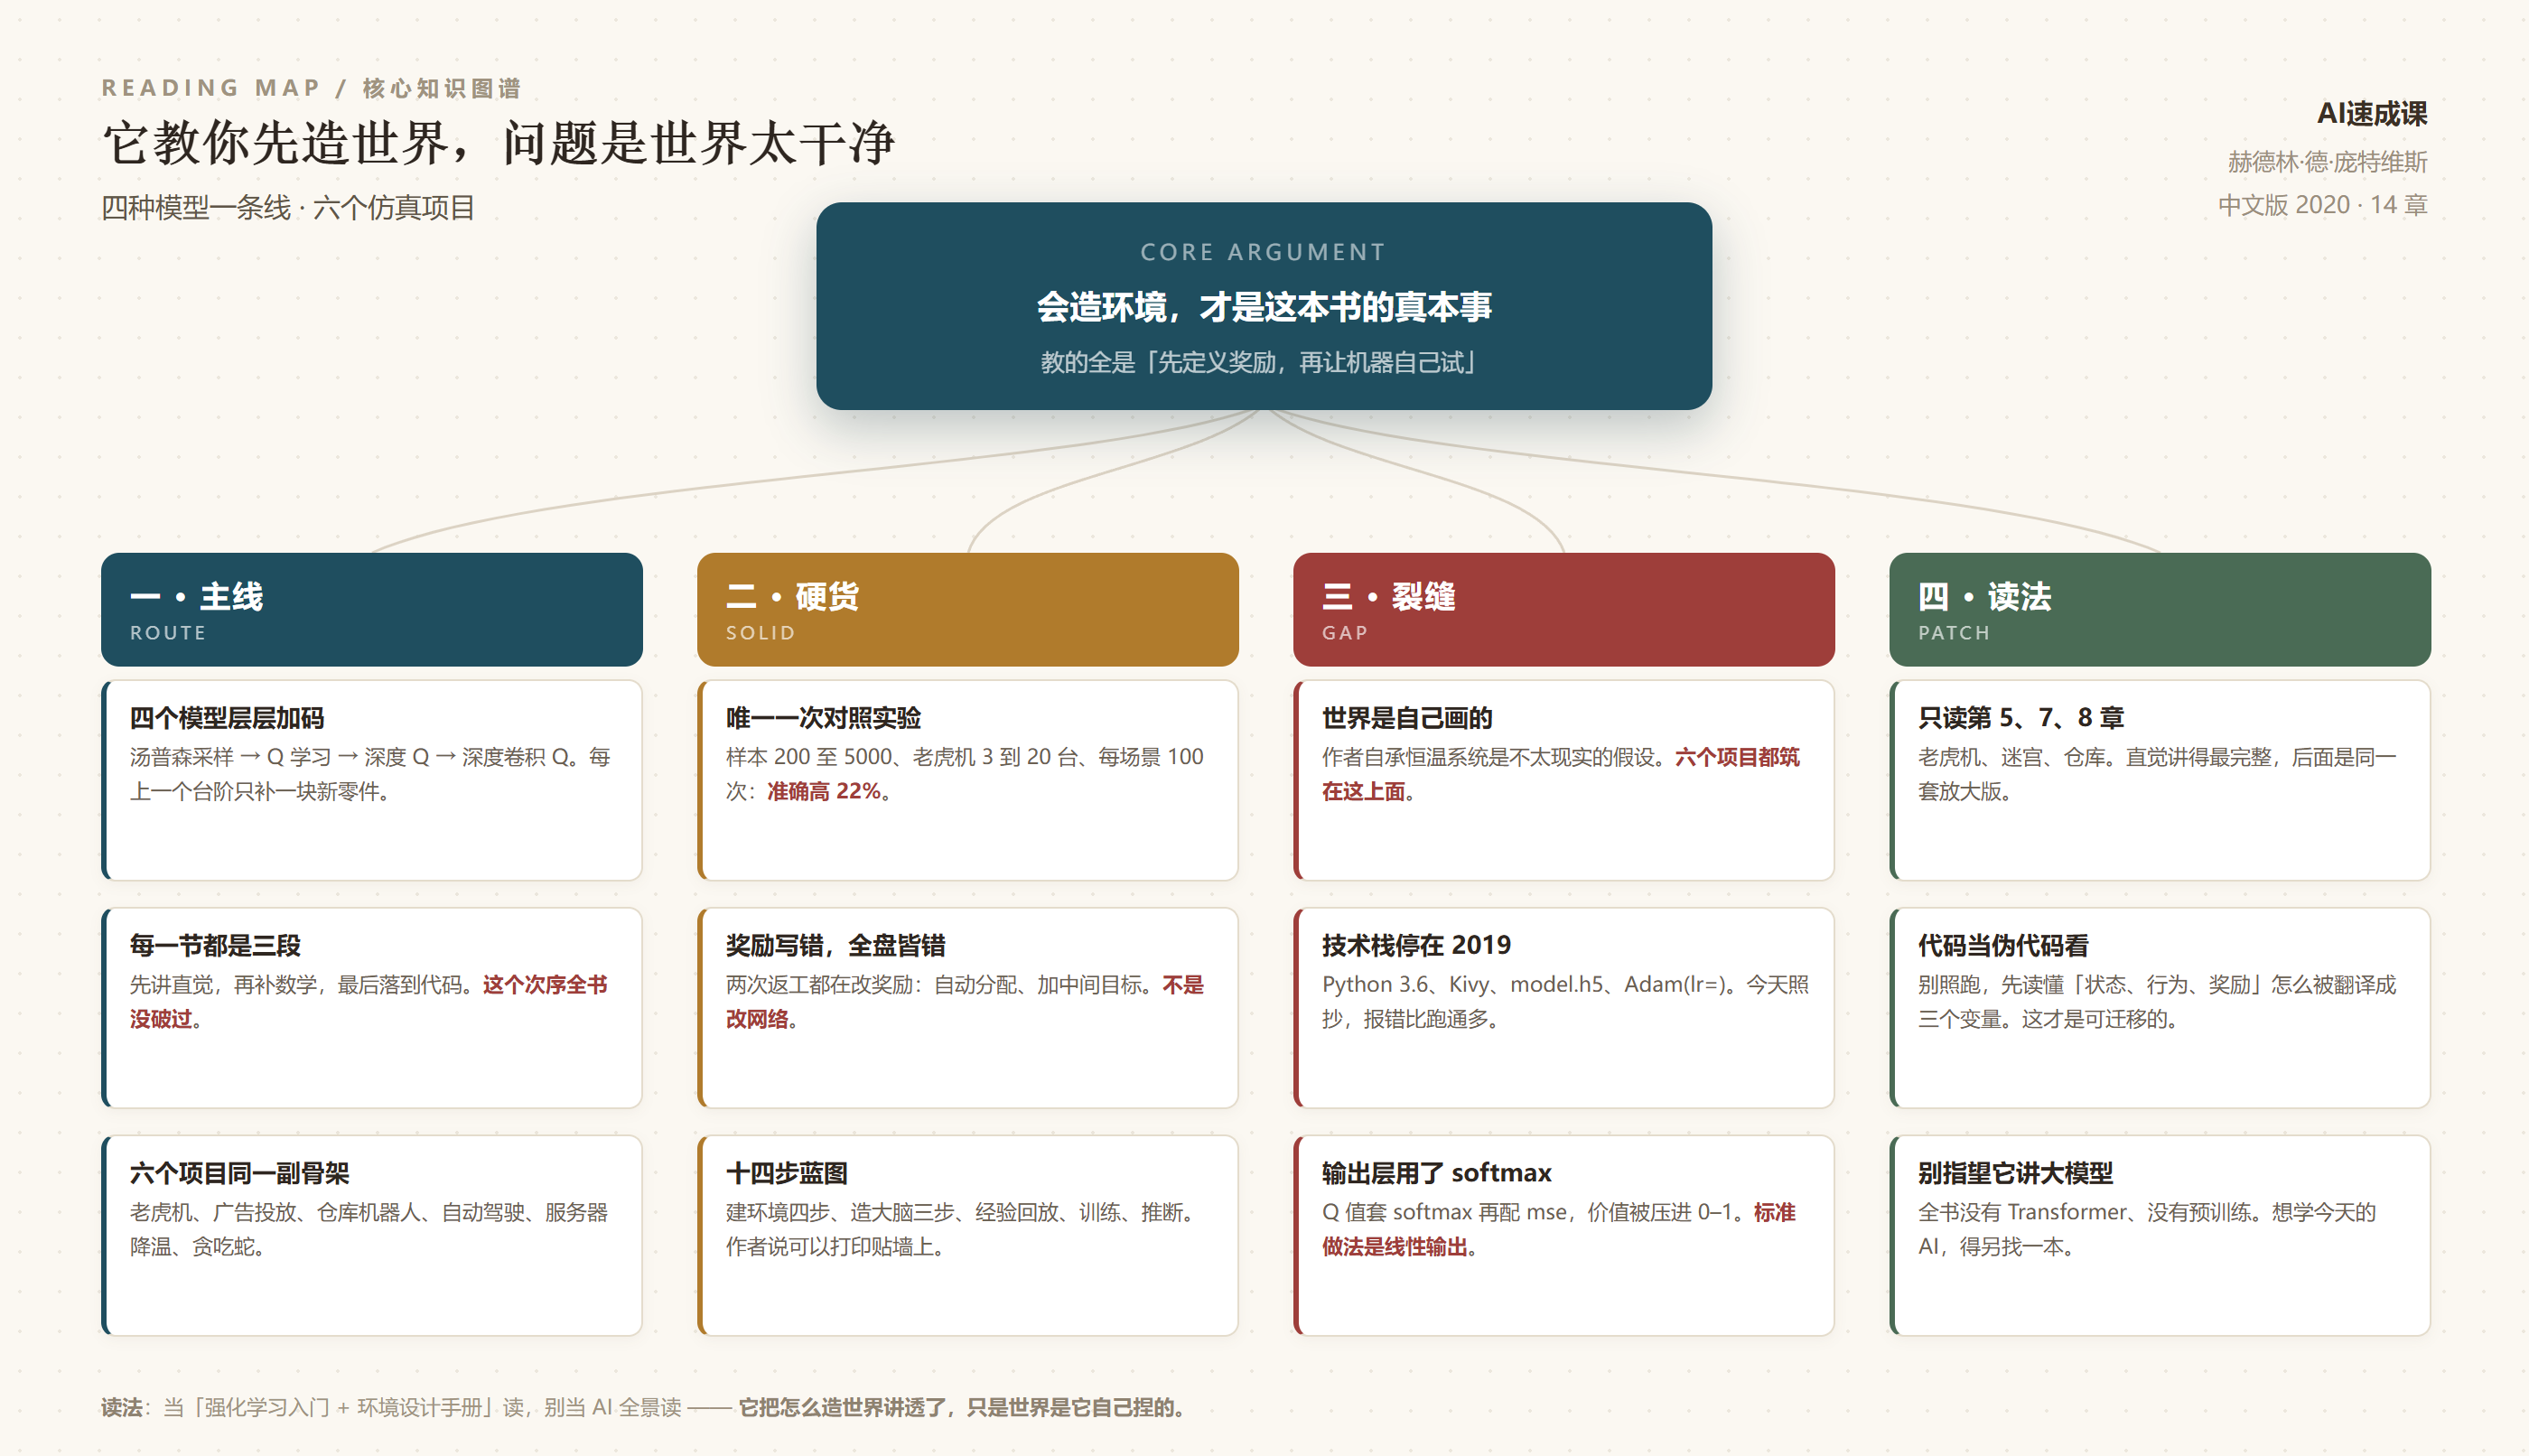
书的结构是一条直线,四个模型,一个比一个多一块零件。
第一个是汤普森采样,用在多臂老虎机上:一排老虎机,每台的赔率你不知道,怎么用最少的次数找出最好的那台。第二个是 Q 学习,用在迷宫里:给一张地图,让程序自己撞墙,撞出最短路径。第三个是深度 Q 学习,把 Q 表换成神经网络,于是状态可以不再是「第几格」,而是「房价的十九个特征」。第四个是深度卷积 Q 学习,在前面加一层卷积,于是状态可以是「屏幕上的像素」,这才轮到了贪吃蛇和自动驾驶。
第三个模型那一步,是全书唯一一次质变,值得多说一句。把 Q 表换成神经网络,不只是换了个存储结构,是换掉了能力的上限:Q 表只能记住它见过的那些格子,遇到没见过的状态就是一片空白;神经网络能对没见过的状态做插值,于是状态可以变成「十九个房价特征」这样的连续向量,而不再是「第几行第几列」。书里用房价数据集演示这一点,表 9.1 列了十九个字段:卧室数、卫生间数、居住面积、土地面积、楼层、是否临水、景观评分、维护状况、建造等级、地下室面积、建造年份、翻新年份、邮编、经纬度。这些字段既不是格子,也不是像素,它们是一段被量化过的现实。把这段现实喂给网络,比把它塞进一张表,能表达的东西多了一个量级。
但这里也埋下了后面所有问题的种子:状态一旦来自现实,它就开始带噪声、带缺失、带「这个字段到底算不算数」的争议。书里在「排除变量」那一节轻轻带过(哪些是必要的,哪些不必要),然后就往下走了。真正的麻烦——两个高度相关的字段同时进来会怎样、有缺失值的那几千条记录怎么处理、用「出售日期」做特征是不是在偷看未来——一个字没提。
作者把这条线写得很清楚,而且反复强调一个次序:「每当引入一个新的模型,你首先学习直觉,其次是数学知识,最后是模型的技术实现。」
这句自述不是宣传语,全书确实照着做了。讲汤普森采样之前,先花一整节讲「什么是分布」——不是抄教科书定义,而是自己重讲一遍:一个变量的分布是一个函数,在这个变量的取值范围内,对每一个取值,函数给出取到它的概率。然后配一张正态分布的钟形曲线。讲神经网络之前,先讲神经元、激活函数、正向传播、反向传播、三种梯度下降(批量、随机、小批量)。
这种「先直觉、再数学、最后代码」的次序,听起来是废话,做起来极难。绝大多数技术书是反过来的:先给你一段能跑的代码,再解释它为什么能跑,读者跑通了,但不知道自己在跑什么。这本书宁可让你先空着手想明白「奖励」是什么,再让你敲键盘。
代价是慢。全书十五万字,讲 Python 基础占了一整章(显示文本、变量、列表、if、循环、函数、类),讲 GitHub 和 Colab 占了一整章。对有一定编程经验的人来说,前三分之一是可以跳过的。但对它预设的读者——那些「想进 AI 行业但完全没写过代码」的人——这个慢是必要的。
它预设的读者是谁?译者序里有一句很直白的话:「选择一个最能与自己产生共鸣的领域,并为其做出自己的贡献。」这话是译者程泽 2020 年春在成都写的,写给那些正在犹豫要不要转行的人。前言里还抬出了吴恩达那句「AI 就是新的电能」,以及普华永道的一个预测:AI 到 2030 年将占全球经济高达 15.7 万亿美元的份额。
所以这本书从一开始就带着一点职业培训的味道:它不只要教你技术,还想给你一点进入这个行业的理由。这一点我不反感,甚至觉得它诚实——2020 年那会儿,市面上太多书假装自己只是「知识」。
二、最值钱的一课:把世界翻译成三个变量
如果这本书只能留下一节,我会留第 11 章末尾那份「整体 AI 框架/蓝图」。作者说这东西可以打印出来贴在墙上,我觉得这话不夸张。
蓝图只有两步,但每一步都拆到了骨头。
第一步,构建环境。声明并初始化环境里所有的常量和变量;创建一个方法,在 AI 执行行为之后更新环境;创建一个重置环境的方法;创建一个方法,返回任意时刻的当前状态、上次获得的奖励,以及某个条件是否超出允许范围。
第二步,构建大脑。构建由输入状态组成的输入层;构建若干隐藏层,每层的神经元与输入层之间、相互之间全连接;构建和最后一个隐藏层全连接的输出层。
就这些。但你把这两步和任何一个真实的业务问题对一下,会发现它几乎是一套通用的问法。
仓库里的机器人要拣货,那「状态」是什么?是它在第几排第几列,以及哪个货架还有货。「行为」是什么?前后左右四个方向。「奖励」是什么?找到货给正分,撞墙给负分。这套翻译做完,剩下的活儿,Q 学习会替你干。
广告投放要选策略,那「状态」是当前用户对哪个广告有反应,「行为」是投放哪一个,「奖励」是转化。服务器要省电,那「状态」是当前温度、用户数、数据传输速率,「行为」是把温度调高调低几档,「奖励」是省下的电量减去超温的惩罚。
这套翻译的功夫,恰恰是今天最缺的。所有人都在讨论「怎么让 AI 干活」,但很少有人认真问一句:这件事的「好」怎么量化?什么算成功,什么算失败,失败有多疼?强化学习的整套框架,本质上是在逼你回答这个问题。你答不出来,模型就学不会;你答得含糊,模型就学出一个你不想要的东西。
翻译的精度损失,书里也没讲透。服务器那个例子,本来要做的事是「把温度调到某个值」,这是一个连续的动作,可以调高 0.1 度也可以调高 2 度。但书里把它切成了有限几档:代码里定义了一个 direction_boundary,把动作编号换算成一个方向(升温还是降温),再乘上一个固定的 temperature_step,取值 1.5。于是「调多少度」这个连续问题,被改写成了「往哪个方向、跨一格」的选择题,一格 1.5 度。
这个手法在强化学习里很常见,叫动作离散化,本身不算错。但它有代价:一档 1.5 度,意味着模型永远学不到「刚好调到 22.7 度」这种精度,它只能在格子之间跳。格子越粗,学得越快,效果上限越低;格子越细,动作空间变大,训练变难。这个取舍,书里一次都没讨论过——而它恰恰是从「跑通 demo」走到「真能用」之间最难的一道坎。现实中的温控、机械臂、自动驾驶的转向,都是连续动作,都得面对这个问题。
书里有一处细节很说明问题。仓库机器人那一章,机器人学会了拣货,但作者不满意,做了两次改进。第一次是「自动化奖励分配」——原来奖励是人手工设的,改成让环境自己按规则给。第二次是「加入一个中间目标」——因为机器人只会直奔终点,路上该做的事一概不做,于是给它设了个中途的里程碑。
这两处返工,比书里任何一段理论都值钱。它示范了一件事:模型学不好,八成不是网络不够深,是奖励写错了。而「奖励写错了」这件事,外行看不出来,因为程序照样在跑,照样在收敛,只是收敛到了一个愚蠢的答案上。
三、全书最扎实的两处:一次对照实验,两次返工
我读技术书有个习惯:看作者有没有自己怀疑过自己。这本书有一处,写得很漂亮。
第 5 章末尾,讲完汤普森采样之后,作者突然插入一段自述:「当我第一次学习汤普森采样时,脑海中一直萦绕着这样一个问题:这个模型真的有那么好吗?」
然后他承认:如果分别单独运行标准模型和汤普森采样模型,结果上不会有太大差别,你很可能得出「这两种模型表现得差不多」的结论。
接着他做了一个真正的对照实验。变量三个:样本数量(200、1000、5000),老虎机数量(3 到 20 台),胜率范围(0 到 0.1、0 到 0.3、0 到 0.5)。每个场景测 100 次,算准确度。原始数据和对比脚本都放在 GitHub 上,一个 Excel 表加一个 comparison.py。
结论是:在样本 200、胜率范围 0 到 0.1 这个设定下——他自己说这是「本书所有对比试验中对汤普森采样挑战最大的设定」——汤普森采样表现得比标准模型好,准确度高 22%。
这一段的价值不在 22% 这个数,在于它示范了一个态度:讲完一个方法,先别急着说它好,先问「它真的更好吗」,然后设计一个能被推翻的实验。全书十五万字,只有这一处做了这件事。这是一处,不是八处。
也正是因为只有一处,它反过来暴露了别的问题——后面五个项目,全都只有「跑通了」和「效果不错」,没有一个基线数字。这一点我留到短板那一节说。
四、它自己承认了:这些世界是假的
第 11 章讲数据中心省电,写到一半,作者停下来交代了一句:
「这很显然是一个不太现实的假设,但本章的目标是让你构建一个可以解决当前问题的可用 AI,而并不是对真实服务器中的热力学原理进行完美仿真。在我们完成了本示例之后,我强烈建议你继续打磨代码,让它变得更加贴近现实。但对于目前而言,我们应该尽量简化问题,并且信任我们像魔法般高效的内置温控系统。」
这段话我读了两遍。第一遍觉得诚实,第二遍觉得——这句话说得太轻了。
它假设了什么?服务器内置的温控系统,无论温度偏离多远,都能在一分钟内把温度恢复到最优范围(18℃ 到 24℃)。现实里当然不是这样,现实里温控有延迟、有惯性、有制冷量的上限,超温会烧机器。作者自己用了「像魔法般高效」这个说法,说明他很清楚自己在偷懒。
问题不在偷懒。教学书简化问题天经地义,不简化反而讲不下去。问题在于:这个简化被沿用了六个项目,而作者只在第四个项目的第四节里,用一段话交代了一次。
货车调度、仓库拣货、自动驾驶、服务器降温、贪吃蛇——这五个环境,全都是作者用几十行 Python 自己捏的。它们有清晰的状态边界、确定的转移规则、即时的奖励信号、无限次的试错机会。这四条加在一起,就是强化学习最理想的游乐场,也是现实世界最不像的样子。
现实里,状态是带噪声的、不完整的;动作的后果要等很久才显现;奖励稀疏到可能一个月才来一次;试错的成本是真金白银。这四条,这本书一条都没有正面处理。它处理的方式是:把环境设计成这四条不存在。
所以读这本书要带着一个自觉:你学到的是「在理想环境里怎么学」,不是「在脏环境里怎么活」。前者是后者的必要条件,但只完成了大概三成。剩下七成的功夫——怎么在噪声里定义状态、怎么处理延迟奖励、怎么用离线数据代替试错——这本书没讲,也没打算讲。
五、代码停在 2019 年,还留了一处技术硬伤
这是这本书最实的一处问题,得说具体。
第 10 章要你跑自动驾驶的演示,步骤是:安装 Anaconda,用 Python 3.6 创建一个虚拟环境,安装 PyTorch,安装 Kivy。第 13 章贪吃蛇,模型从 model.h5 这个文件里加载。整本书的神经网络都用 Keras 的函数式 API 搭。
Python 3.6 是 2016 年的版本,2021 年底就停止维护了。Kivy 在 Windows 上装起来历来麻烦,2020 年如此,今天更如此。model.h5 是 Keras 旧格式,现在的 Keras 3 默认存 .keras,加载 .h5 要看运气。而那一行 Adam(lr = learning_rate)——lr 这个参数名在后来的 Keras 里被改成了 learning_rate,旧写法会直接报错。
这些不是作者的错,2020 年写书,2019 年的代码是当时的正确写法。但对 2026 年的读者,这就是一道真实的门槛:你照着书敲,第一个报错会出现在第三章之前。这不是理解问题,是环境问题,而环境问题最消耗耐心——它让你在还没搞懂「奖励」是什么的时候,就先花三个小时跟依赖打架。
比版本更值得说的,是一处技术选择。第 13 章构建「大脑」,代码是这样的:
输入层 → 全连接 64 个神经元,激活函数 sigmoid → Dropout 0.1 → 全连接 32 个神经元,sigmoid → Dropout 0.1 → 输出层 number_actions 个神经元,激活函数 softmax,编译时 loss 用 mse,优化器 Adam。
这里有两个问题,一个是习惯,一个是硬伤。
习惯问题是 sigmoid。隐藏层用 sigmoid,2019 年就已经是很不主流的选择了——ReLU 便宜、不饱和、梯度不消失,早就是默认。这本书只有两层隐藏层,所以不致命,但它教给新手的是一个过时的默认值。
硬伤在输出层。深度 Q 学习的输出是「每个动作值多少分」,这个分数可以是任意实数,可以是负的,可以大于一。而 softmax 会把一组数压成一个概率分布——每个值落在 0 到 1 之间,加起来等于 1。这就强行给动作之间加了「互相竞争」的约束:一个动作的分高了,别的必须低。可实际上,两个动作各自值多少,是两件独立的事,不该此消彼长。标准做法是输出层不做激活,让网络自由地估价值。
再叠一层:用 softmax 的输出配 mse 损失,梯度会被 softmax 的饱和区吃掉——输出接近 0 或 1 的时候,几乎不再学习。这两件事放在一起,是「能跑但学得别扭」的典型。
我要说清楚,这不是说书里的贪吃蛇跑不起来。它跑起来了,作者在第 13 章末尾还给了结果和演示。动作只有三个(直行、左转、右转),奖励经过归一化,网络又浅,所以这个错误被掩盖住了。但如果你照这个架构去做动作多、奖励幅度大的真实问题,会撞墙,而且撞了不知道为什么。
这处硬伤最值得警惕的地方,不是它错,是它错得很安静。程序不报错,loss 在降,蛇在长大,你完全有理由相信自己学对了。
六、六年后再看,它反而有点前瞻
这本书 2020 年出,赶上了一个尴尬的时点:GPT-3 那年发布,之后两年,整个行业的注意力全部转向大模型。一本讲 Q 学习、讲贪吃蛇、要你装 Python 3.6 的书,很快就显得像上个时代的东西。它讲的所有模型,在「能力」这个维度上,都被后来的东西碾过去了。
但我读完之后有一个反直觉的感受:这本书里最重要的那部分,这几年反而升值了。
升值的是「构建环境」这一步。原因很简单:2023 年之后,大家开始让 AI 干活,一下就撞上了同一堵墙——怎么判断它干得好不好?写文章好不好?写代码对不对?做的研究有没有价值?这些事没有标准答案,也就没法给奖励;没有奖励,就没法训练,甚至没法评估。
于是整个行业绕了一圈,回到了这本书第 11 章讲的那套东西上:造一个环境,定义状态,定义行为,定义奖励,让它在里面跑。今天的叫法变了——叫 sandbox,叫 benchmark,叫 reward model,叫 evals——但工序没变。你得先能判断对错,才能谈优化。
这本书里那些看起来最「玩具」的部分,恰恰是这套工序最干净的示范。老虎机是最小规模的决策问题,迷宫是最小规模的规划问题,贪吃蛇是最小规模的「看屏幕做决策」问题。三个玩具,三种最基本的困境:探索与利用、延迟奖励、状态爆炸。你把它们当真问题去想,它们就不只是玩具。
所以我对这本书的评价是分层的:作为「AI 入门」,它过期了;作为「怎么把一件事变成可训练的问题」,它比很多新书都清醒。
七、它的短板
前面已经零散说了几处,这里集中列一下。
第一,书名和内容是两回事。「AI 速成课」这五个字,承诺的是一个全景。实际给的是一个切面:强化学习,加一点神经网络基础。「从 AI 编程到构建智能软件」这半句更微妙——「构建智能软件」在书里的实际含义,是「构建一个会玩贪吃蛇的程序」。这不是欺骗,但预期会被拉偏。2019 年的 AI 版图里,图像分类、文本处理、生成模型各占一大块,这本书只碰了图像(还是作为 DQN 的前置),文本和生成一个字没提。
第二,六个项目,零个真实数据。唯一的对照实验在第 5 章(那个 22%),后面五个项目全部只有「效果不错」和一张漂亮的收敛曲线。省了多少电?作者给了代码让程序自己打印「Total Energy spent with an AI」和「without AI」,但没有给出一个可以被复算的基线,也没说这个基线是怎么来的。这在教学书里可以接受——教学的目标是让你跑通,不是让你相信——但读者要清楚,这些项目证明的是「方法可行」,不是「方法有效」。
第三,代码讲解的比重压过了原理。全书后半段有大量篇幅在逐行念代码:「可以看到,此处创建了一个新方法,名为 loadModel。它有一个参数 filepath,该参数代表预训练模型的文件路径……」这种句子读起来像旁白,信息密度很低。对完全的新手,这个旁白有用;对有一点基础的人,它是噪音。作者的取舍我能理解,但这让书的「有效厚度」比十五万字要薄不少。
第四,缺一章「失败长什么样」。全书所有项目都成功了,所有曲线都收敛了。可是强化学习最真实的样子是:不收敛、震荡、学到奇怪的策略、奖励黑客。仓库那两处返工是唯一接近失败的段落,但也被写成了「改进 1」「改进 2」——是成功故事里的插曲,不是失败案例。一本教人动手的书,最该给的是「我也卡过,卡在这里,这么出来的」。这一课缺席了。
第五,也是我最在意的一点:它没有回答「什么时候不该用强化学习」。全书六个项目,全都是强化学习的合适场景:有仿真器、能无限试错、奖励明确。可现实中绝大多数问题不长这样。一个明确的反面例子是——你今天想让 AI 帮你写周报,用强化学习是荒谬的。这本书从头到尾没有说过一句「这个场景不适合我们这套方法」,于是读者容易形成一个印象:什么问题都能翻译成状态、行为、奖励。这个印象是危险的。
八、这本书该怎么用
挑了这么多,我的结论不是别读,是换个读法。
第一步,只读第 5、7、8 章。老虎机、迷宫、仓库,三章把强化学习的三件核心事讲完了:怎么在不确定里做选择,怎么让奖励延迟到达,怎么把业务问题翻译成环境。这三章的代码量最小、原理浓度最高。第 9 章之后的神经网络部分,如果你已经有深度学习基础,可以快翻;如果没有,值得慢读,但别指望它替代一门正经的深度学习课。
第二步,代码当伪代码看,别照跑。如果你真想跑,把 Python 换成 3.11,把 Keras 的 Adam(lr=) 改成 Adam(learning_rate=),把输出层的 softmax 换成线性——这三处一改,书里的项目基本都能走通。改这三处的过程本身,比跑通更有价值,因为你会被迫想清楚每一行为什么这么写。
第三步,把它当「环境设计手册」用,不当「AI 教材」用。你手头任何一件想让 AI 接手的事,先照第 11 章的蓝图填一遍空:状态是什么,行为是什么,奖励怎么算,什么算失败。填不满的地方,就是你还不能自动化这件事的地方。这个练习不需要写一行代码,半小时能做,做完你对这件事的理解会比读十篇文章都清楚。
一句话收束:它教的不是怎么让机器变聪明,是怎么把一个模糊的世界说清楚到机器能听懂——这门手艺,比任何一个模型都活得久。这本书的短板是世界太干净,但教你造世界的那部分,是真的。
阅读记录
书名:AI速成课:从AI编程到构建智能软件
作者:[阿联酋]赫德林·德·庞特维斯 译者:程泽、黄曼莉
出版:机械工业出版社 · 2020 年 7 月 · ISBN 9787111661276
读法:全书十四章通读,含版权信息、译者序、前言、作者与审校者简介
说明:文中引语、代码片段、实验设定与数据均摘自原书;关于 softmax 配 mse 不合标准、六个项目零真实数据、缺席「何时不该用强化学习」的判断,是我读后所加,原书未作此论
逐页精读系列 · 2026 年 11 月
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: