
智能体开发技术:教会它干活,没教它上锁
《智能体开发技术(Python+FastAPI版)》,蜗牛学苑组编著,人民邮电出版社 2026 年 1 月版,ISBN 9787115685742。
先说这本书的出身,因为它决定了该怎么读它。前言里写得很直白:「本书作为蜗牛学苑AI智能体开发工程师的核心教材,通过知识点讲解、实例讲解、项目实战三大步骤,帮助读者对AI智能体开发的重要核心技术,包括提示词工程、Function Calling、MCP、RAG知识库、语音识别、人脸识别、大模型应用等进行系统性的梳理。」
教材。这两个字是钥匙。它不是一本让你读完恍然大悟的书,它是一本让你照着敲、敲完能跑、跑完能交作业的书。八大章,六个完整项目,每个项目都从需求分析写到前端界面,代码贴得密密麻麻,截图一张接一张。
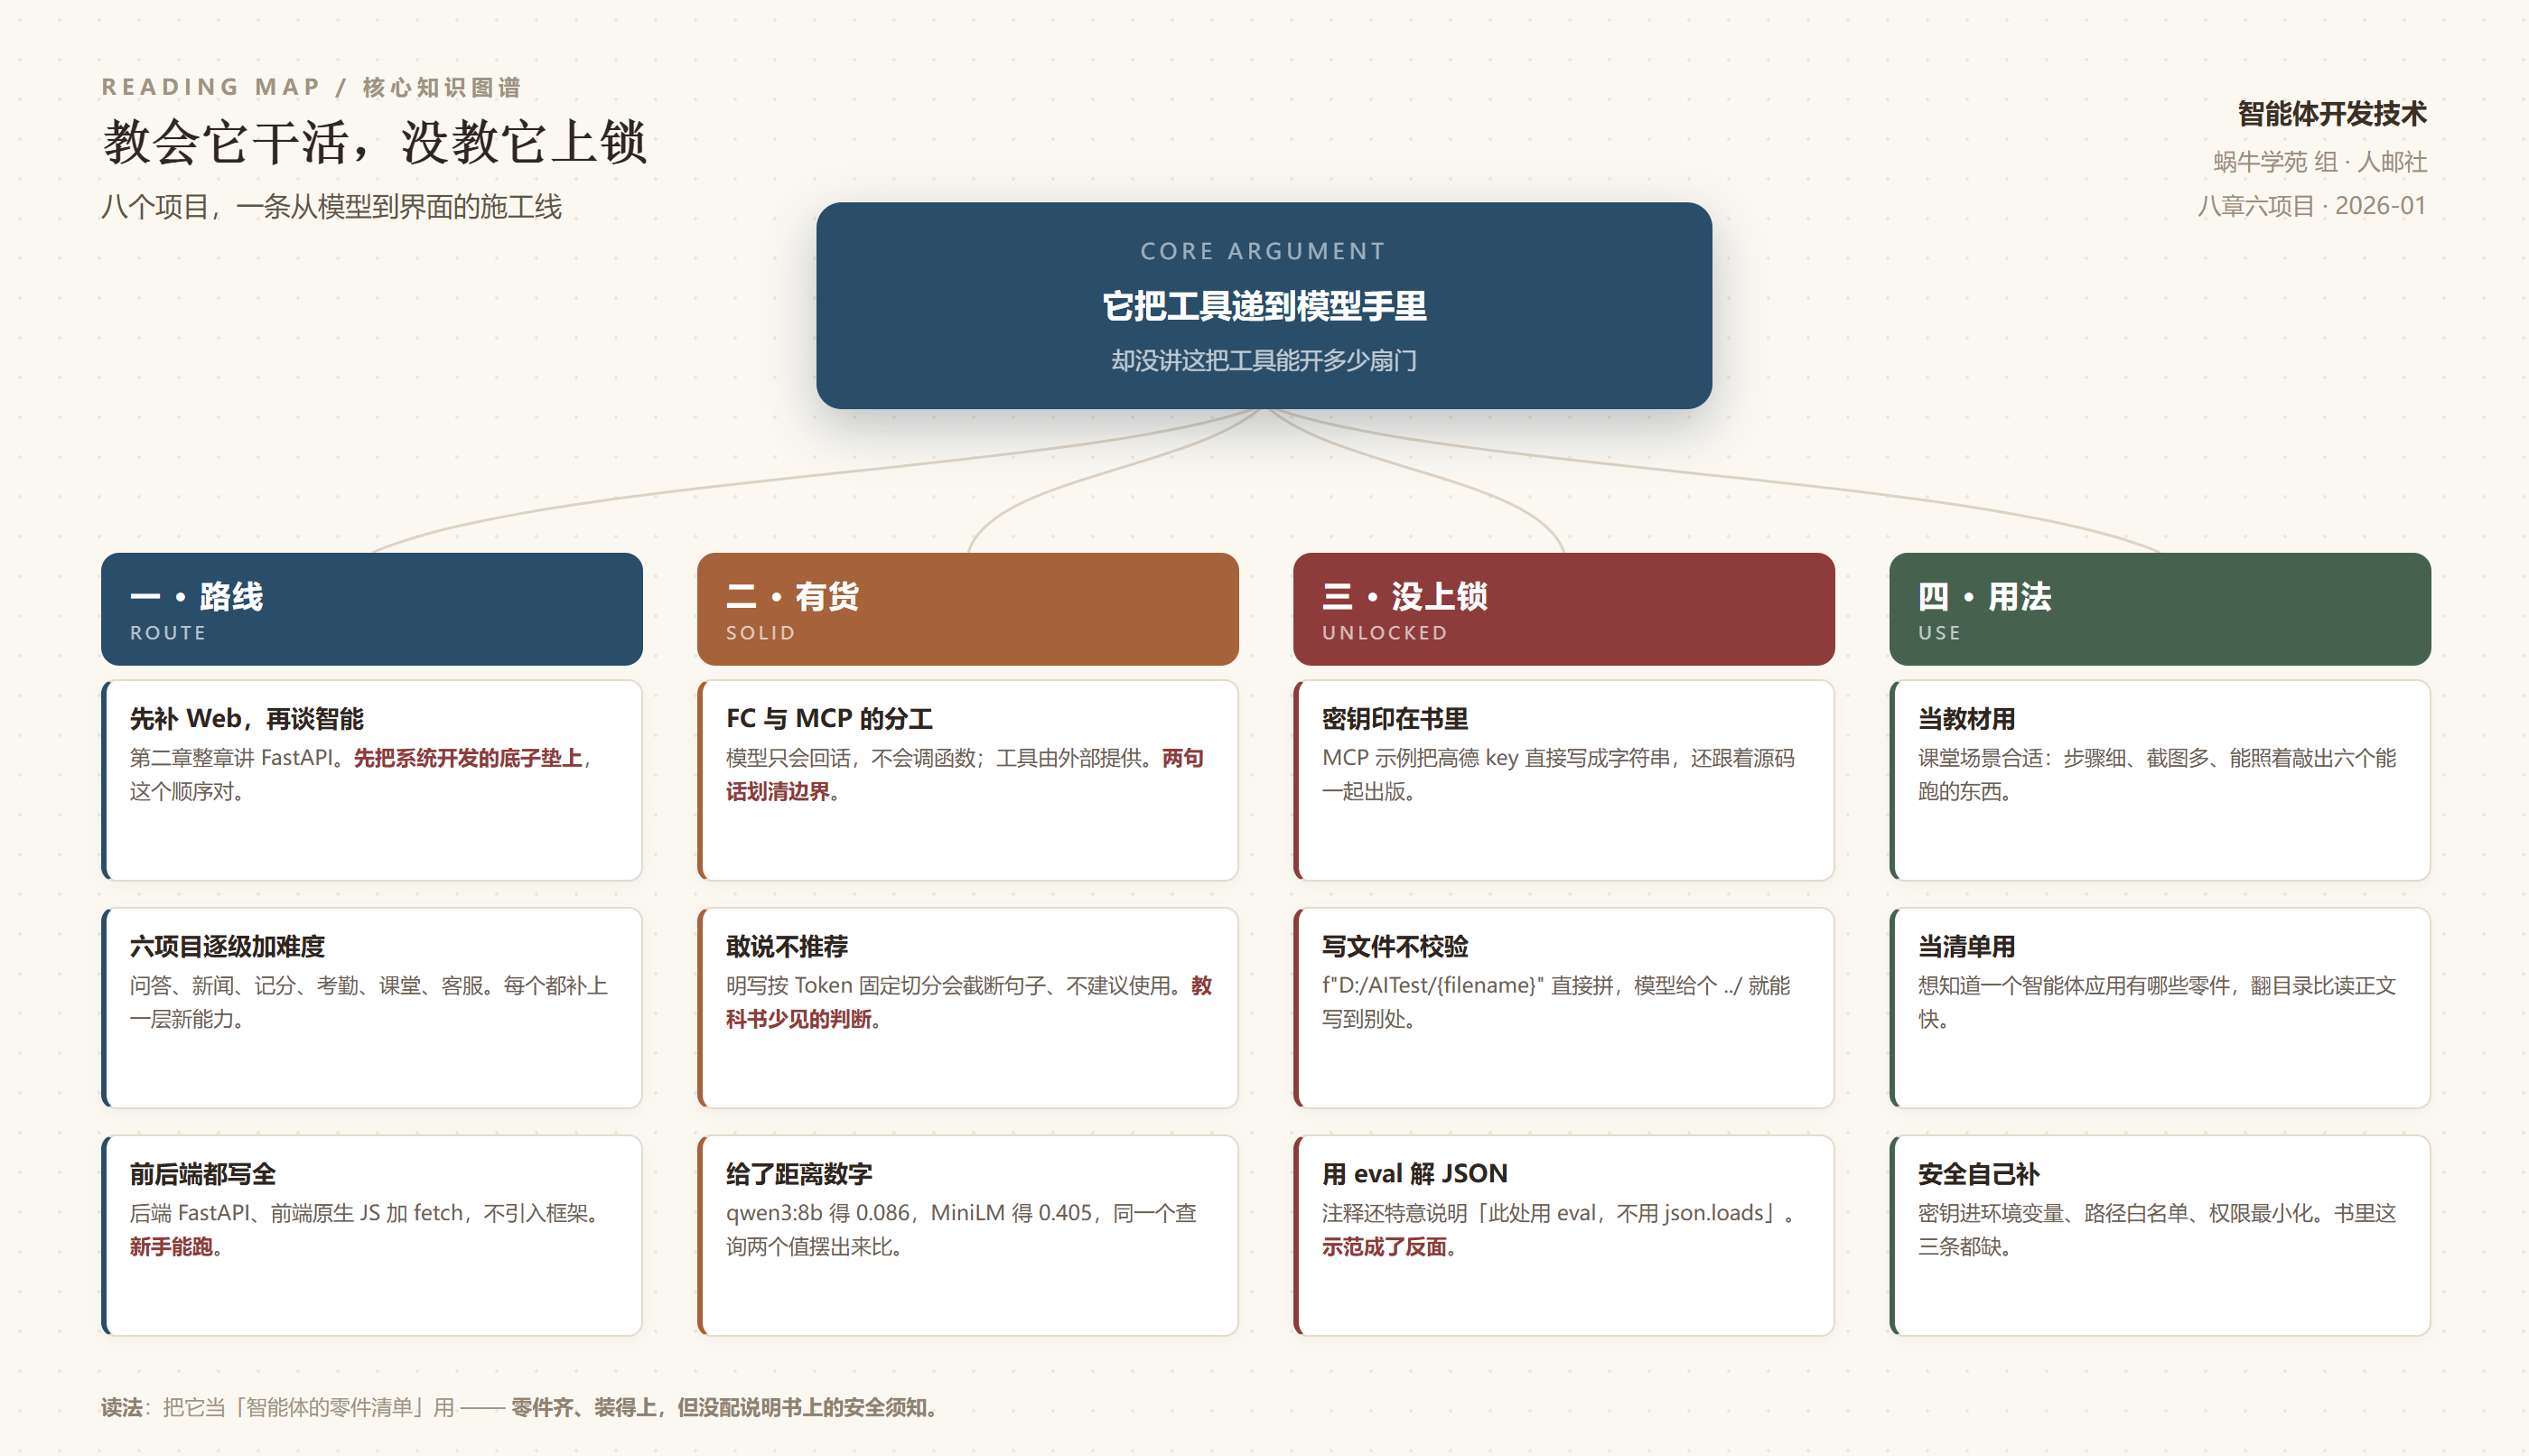
我的判断是:这本书把「智能体能干活」这件事讲清楚了,但它几乎没讲另一件事——这把工具能开多少扇门。
这个判断不是抽象感慨。书里第 1 章教你用 Python 写一个 MCP 服务,给模型两个工具:一个写文件,一个查天气。写文件那段的代码是这样的——路径用 f-string 直接拼,文件名是模型传进来的参数,没有白名单,没有路径规范化,没有任何校验;同一段代码里,查天气用的高德 API Key 就明明白白写成一个字符串常量,跟着书一起印了出来。
一本 2026 年 1 月出版的、教人做智能体的教材,把这两件事同时做错,还做在全书最核心的那一节里。这不是笔误,这是漏了一课。
我把这一课留到后面细说。先讲它做对的地方——它做对的地方其实不少,而且有几处做得比很多同类书扎实。
一、它把「智能体」拆成了能跑的东西
内容提要里那一段,把八章的结构说得极其清楚,我几乎可以照抄下来当目录用:
本书第1章主要讲解在Python中对接各类大模型,以及智能体开发所使用的Function Calling技术和MCP技术;第2章主要讲解FastAPI开发框架;第3章主要讲解基于网页对话来实现AI问答功能;第4章主要讲解每日新闻摘要功能的实现;第5章主要讲解智能语音记分功能的实现;第6章主要讲解智能考勤功能的实现;第7章主要讲解AI智慧课堂功能的实现;第8章主要讲解智能在线客服功能的实现。
这八章不是并列的八个知识点,是一条有坡度的小路。第 1 章解决「怎么跟模型说话」——云端接口(通义千问、DeepSeek、OpenRouter)、本地部署(Ollama)、然后是 Function Calling 和 MCP 这两个「让模型能动手」的机制。第 2 章整整一章讲 FastAPI,从 URL 参数、RESTful、JSON 请求体,到 Jinja2 模板、SQLModel 操作数据库,最后落到「FastAPI 怎么对接大模型、怎么处理流式响应、前端怎么用 fetch 接」。
然后第 3 到第 8 章,六个项目,每个都往上叠一层新能力:
第 3 章「AI问答」,叠的是多模态和工具调用——文本问答之外,加了联网搜索、MCP 客户端、函数调用增强,还有图像识别与图像生成。第 4 章「每日新闻摘要」,叠的是数据管道——用 BeautifulSoup 爬新浪新闻的标题和正文,存进数据库,用 Jinja2 分页渲染,再让大模型做摘要。第 5 章「智能语音记分」,叠的是实时性——speech_recognition 配 Vosk 做本地识别,WebSocket 配阿里云 Paraformer 做实时识别,然后把这套东西做成两个版本:一个 tkinter 桌面版,一个 Web 版,用来给球赛记分。第 6 章「智能考勤」,叠的是视觉——OpenCV 采摄像头、face_recognition 做人脸比对、活体检测防作弊。第 7 章「AI智慧课堂」,叠的是内容生产——把教学视频转成课堂笔记、思维导图、关键帧,再让模型出题、判卷。第 8 章「智能在线客服」,叠的是知识——RAG、向量数据库、文档分段、检索重排。
这个坡度设计得很老实。它没有一上来就讲 Agent 的「自主规划」「多智能体协作」这些听着高级的词,而是老老实实从「模型怎么回话」开始,一路做到「界面上有个按钮,点了会怎样」。对初学者来说,这条路径的价值比任何架构图都大,因为每一步都有能看见的结果。
更值得说一句的是它的诚实:书里没有把这些教学项目包装成「企业级方案」。第 6 章做人脸考勤,用的演示人脸图片是 AI 生成的——书里明说「由于Mr_Zhang.png这张图像是由AI生成的,编者使用提示词让AI生成了一张佩戴眼镜的人图像,以体现真实的人脸识别时面部有所变化的情况」。这句话看着不起眼,其实是在承认:我手上没有真实的人脸数据集,我用生成图代替。这种承认,比硬凑一个「某企业真实案例」要体面得多。
二、第 2 章那六十页,才是这本书的诚意
如果只能推荐一章给刚入门的人,我推荐第 2 章,不是第 1 章。
原因在第 2 章开头的「本章引言」里,那段话是全书写得最好的一段判断:
由于AI应用或智能体的开发仍然是系统开发的一部分,因此常规应用系统的开发技术同样适用于AI应用或智能体,只不过AI应用或智能体除了要使用常规开发技术,还需要与AI大模型进行交互,以实现更多智能化的功能。
这句话把 2024 年以来最大的一场误会戳破了。太多人以为「做 AI 应用」是一种新工种,学几个提示词、接一个 API、套一个框架,就能绕开 HTTP、绕开数据库、绕开会话管理。绕不开的。一个问答界面背后是三件事:请求怎么进来(路由与参数)、状态怎么留住(会话与数据库)、结果怎么出去(模板或流式响应)。这三件事跟 AI 一点关系都没有,但少了任何一件,你的智能体就只是个能跑通的脚本,不是能用的系统。
第 2 章的编排就是按这个逻辑走的。它先讲 FastAPI 最基础的东西——路由装饰器、路径参数、查询参数、RESTful 的语义、JSON 请求体怎么用 Pydantic 校验;然后讲会话管理,讲文件上传;再讲异步编程,因为流式响应必须懂 async;接着讲 Jinja2 模板引擎,讲它的语法、过滤器、怎么把数据填进 HTML;再讲 SQLModel,怎么定义表、怎么做增删改查、怎么写带条件的复杂查询;最后才回到 AI——用 OpenAI 库对接,处理流式响应,前端用 fetch 一段段接。
这个顺序没有任何花哨的地方,但它是对的:先把「系统」这件事补齐,再谈「智能」。
不过这一章也暴露了这本书的一个通病:示例数据的敷衍。2.2.5「应用示例」讲模板引擎怎么把列表渲染成表格,代码里定义的图书列表是这样的——{"id": 1, "title": "PHP教程", "author": "张三", "price": 52}、{"id": 2, "title": "Python教程", "author": "李四", "price": 36}、{"id": 3, "title": "Java教程", "author": "王五", "price": 68}。张三李四王五,还是二十年前计算机教材里那三个人。
这不影响你学会 Jinja2 的 {% for %},但它透露出一个态度:凡是跟「教学演示」无关的地方,作者不愿意多花一分钟。这个态度在后面会反复出现,有时候只是显得潦草,有时候会变成真正的问题——比如那个写文件不校验路径的 MCP 工具。
三、真本事:两句话划清 Function Calling 与 MCP
第 1 章 1.3 节是我在这本书里读到的最有价值的两页。
它先问了一个看起来笨、其实很关键的问题:函数调用这么普通的东西,为什么到了 AI 这里就变成了核心技术?然后它自己答:
AI大模型本身的能力在于理解用户的输入,并给予用户正确的响应内容,而响应的内容通常是文本或图像等数据,AI大模型本身并不具备函数调用能力。
这句话把边界划在了正确的位置上。模型是一个「文本进、文本出」的东西,它不联网、不读文件、不查数据库。所谓「智能体能干活」,本质是外面有一圈程序替它干活:模型输出一段结构化的意图(我要调哪个函数、参数是什么),外面的程序真的去调,把结果再喂回模型。模型从来没有碰过你的文件系统,碰它的是你写的代码。
这句话为什么重要?因为绝大多数关于 Agent 的混乱,都来自把这个边界搞混了。把模型当成「会自己动手的东西」,你就会写出这样的系统:给模型一堆工具、不检查它调了什么、不限制它能碰什么。而一旦你记住「动手的是我的代码」,你就会自然地问下一个问题:我的代码允许它动到什么程度?
遗憾的是,这本书问出了前半句,没接上后半句。这是后话。
接着它讲 MCP。书里的处理方式很务实:不纠缠协议细节,直接给一个能跑的最小服务。用 FastMCP 建一个对象,用 @mcp.tool() 装饰器把普通 Python 函数变成工具,函数的 docstring 就是给模型看的工具说明,最后 mcp.run(transport='stdio') 跑起来。然后在 CherryStudio 里配一下,就能在对话框里让模型调你的工具。
这条路径选得好。MCP 这个概念在 2025 年被讲得很玄,各种「AI 的 USB 接口」的比喻,但落到代码上其实就是这么点东西:一个能被列举的工具清单,一个能被调用的入口,一份能被读懂的参数说明。书里没有把它讲复杂,反而讲简单了——这对初学者是善意。
第 3 章 3.3.4 又把客户端那一半补上了:怎么在 FastAPI 里连 MCP 服务、怎么把工具清单交给模型、怎么处理模型返回的调用请求。服务端和客户端都写了,这个闭环在同类书里不常见,很多书只写一半,读者照着做永远跑不通。
四、敢说「不建议」的地方,才像老师
第 8 章讲文档分段,有一处细节让我对这本书的评价往上提了一档。
它列了几种分段策略,其中讲到按 Token 数量固定切分(TokenTextSplitter,设 chunk_size=200、chunk_overlap=20),然后明确写了一句:
该方案仅供演示,实际使用过程中不建议使用,因为它只关注Token,而不会关注句子,常常将一个句子从中间截断,导致AI完全无法正确、完整地表达语句。
「仅供演示,不建议使用」。这七个字在技术教材里是很稀缺的。多数教材的做法是把所有方案平铺出来,A 也行 B 也行,让读者自己选;更差的做法是把最省事的方案当标准答案。肯明确说「这个别用、原因是这个」的作者,是在替读者承担判断的责任。
同一章还有一处,是全书唯一一次拿数据说话的地方。它比较两个嵌入模型对同一个中文查询的检索距离:用 Ollama 的 qwen3:8b 做嵌入,两条结果的 distances 是 0.08639986 和 0.20743654;换成默认的 all-MiniLM-L6-v2,同一个查询的距离是 0.40570804 和 1.03044998。然后它下结论:qwen3:8b 对中文的语义理解更精确,算出来的距离值更小。
这个对比做得糙——只有一个查询、两条文档,样本量小到不能叫实验——但它至少把数字摆出来了。读者可以不同意结论,但没法说它没给证据。这跟那些只写「效果显著提升」的书,是两个物种。
第 7 章还有一处,是全书少见的「讲清楚了为什么」。7.3.1 讲考题的数据表怎么设计,作者解释了为什么不把四个选项单独建一张表:如果把选项拆出去,就要和考题表做关联,而这张表的功能只是把四个选项拿出来,再无别的用途;为了让表的关系简单一些,选择把整个 options 存成考题表里的一列,等前端需要渲染时再解析。最后它补了一句:「所以,前文对以上两点的考量不是纯粹出于技术层面的考虑,而是综合评估后的结果。」
数据库范式不是越高越好,这句话很多教材不会说。它愿意为一个「不那么规范」的设计给出理由,说明作者是真的做过项目,不是照抄规范。
五、它最贵的一课没讲:工具的权限边界
现在说那个 MCP 示例。1.3.4「使用Python开发MCP服务」,全书的智能体启蒙就在这一节,代码是这样的:
建一个 FastMCP() 实例,写两个 @mcp.tool() 函数。第一个叫 write_file,参数是 filename 和 content,函数体是 open(f"D:/AITest/{filename}", "w", encoding="utf-8"),把 content 写进去,返回「文件写入成功」。第二个叫 get_weather,参数是城市名,函数体里有一个常量 amap_api_key = "46644f43e3a56ce81f6f3633c5994c67",然后拼 URL 请求高德的天气接口,返回 forecasts。
两个问题,一个比一个重。
第一个是路径。文件名来自模型,模型来自用户。f"D:/AITest/{filename}" 这个拼法,意味着如果 filename 是 ../../Windows/System32/drivers/etc/hosts,这段代码会乖乖去写那个文件(在权限允许的范围内)。这不是理论风险,这是「提示注入」这个被讲烂了的话题最经典的形态:你不能假设模型的参数是善意的。一个合格的示例至少该做两件事——把文件名交给 os.path.basename() 剥掉目录部分,再把拼出来的绝对路径跟允许的根目录比一次,不在里面就拒绝。这两行代码不超过五行,但书里没有。
顺带一提,路径写死成 D:/AITest/ 也是教材的通病:Windows 专有盘符,Mac 和 Linux 用户照抄就是一句 FileNotFoundError。这本书通篇按 Windows 写(PyCharm、CherryStudio、D 盘),对跨平台读者不算友好,但这是小事。
第二个问题重得多:那个 API Key 是印在书上的。
我盯着那一行看了很久,确认自己没有看错——amap_api_key = "46644f43e3a56ce81f6f3633c5994c67",一个 32 位的十六进制字符串,跟高德开放平台的 Key 格式一致,直接写在示例代码里,然后随书出版、随电子版分发、随读者的复制粘贴流向各处。
这件事的性质,跟「示例代码写得糙」完全不是一个量级。一本教人做智能体的书,在第一堂课上示范了把密钥硬编码进源码——而这个做法恰恰是安全领域反复警告的头号错误。更尴尬的是,这本书自己在最后一节做对了:8.5.5 用大模型做分段,云端那条路径写的是 api_key=os.getenv('Dashscope_API_Key')。作者知道正确写法,只是没统一。
于是这本书在同一个能力上给出了两个相反的示范:一处教你从环境变量读密钥,一处教你把它写死在源码里。而后者出现在更前面、更核心、更多人会照抄的那一节。
我要把话说得再明确一点,因为这恰恰是智能体时代最该被强调的事。智能体的本质,是把工具交给一个不完全可控的调用者。你写的每一个 @mcp.tool(),都是给模型开的一扇门;门后面是你的文件系统、你的数据库、你的第三方账号。所以做智能体的人,第一课不该是「怎么让模型调我的函数」,而该是「我怎么保证它只能调到这个程度」——权限最小化、参数校验、路径白名单、密钥隔离、调用审计。这五件事,这本书一件都没讲。
它讲清楚了「模型不会自己动手,动手的是你的代码」。这句话的后半截是:所以动手的边界,得你来画。书停在了前半截。
六、代码里的沙粒:eval、.seconds 和字符串协议
除了那一课,书里还有一批细碎的、单个拎出来都不致命、凑在一起就让人不敢直接拿去用的东西。我挑三处说。
第一处,用 eval 解析 JSON。7.3.2「前端渲染考题」,后端把考题从数据库里查出来,选项存在 options 字段里,然后要把它变回列表。代码是 exams = eval(exam.Exams.options),旁边还有一行注释,写得清清楚楚:「此处使用eval(),而不是json.loads()」。
注释这个动作,说明作者知道这里有个选择。但选错了。json.loads() 是解析,eval() 是执行——后者会把字符串当 Python 代码跑。只要 options 这个字段的内容能被外部影响(比如题库导入、比如后台编辑),这就是一个任意代码执行的口子。而这里根本没有任何理由用 eval:数据是 JSON,解析器就在标准库里,一个字符都不用多写。
最难受的是那句注释。它不是在解释「为什么这样更好」,它是在提醒读者「我知道这里不一样」——然后照样选了错的那个。这种错比不懂更值得记下来,因为它会被当成范例传播。
第二处,用 .seconds 算时间差。6.2.5「实现人脸考勤功能」,判断重复打卡的逻辑是:checkstatus = checkstatus and (nowtime - checkend).seconds >= 600,也就是「距上次打卡超过十分钟才算新的一次」;算工时的逻辑是 result.Checks.hours = round((nowtime - checkstart).seconds / 3600, 1)。
问题在 .seconds。Python 的 timedelta 有两个属性:.total_seconds() 给你完整的时间差(浮点秒),.seconds 只给你「去掉天数之后剩下的秒数」,取值范围 0 到 86399。所以隔了一天的两次打卡,(nowtime - checkend).seconds 会回绕成「这个时刻当天的秒数」,可能只有几百,也可能有八万多。跨天的工时会被算成一个荒谬的数字,跨天的重复打卡判断会时灵时不灵。
正确的写法只有一个后缀之差:.total_seconds()。这个坑在 Python 社区被踩了十几年,教材里出现它,说明这段代码没有被认真跑过跨天的场景——而考勤系统最典型的场景,恰恰就是跨天。
同一段代码里还有个更常见的毛病:try: ... except: pass。裸 except 加上静默通过,意味着任何异常——文件读不到、模型没加载、图片解码失败——都会被吞掉,函数最后统一返回 "Checkin-NOK"。出了问题,你只会看到「打卡失败」,永远不知道是为什么。这是所有调试噩梦的起点。
第三处,用字符串当协议。整本书的前后端通信,大量依赖这种约定:后端返回 "Checkin-OK"、"Checkin-Repeated"、"Checkin-NOK"、"Face-Added"、"Face-Not-Exist",前端拿到纯文本之后 if (data.includes("Face-Added")) 判断一下,弹个 alert,然后 reload。
这在教学里是最省事的写法,我理解。但它是错的示范:状态码本该由 HTTP 承载(200 / 409 / 422),消息体本该是 JSON({"code": "FACE_ADDED"})。用 includes() 在字符串里找子串,意味着后端只要改一个字(比如加个前缀、换个措辞),前端就静默失效;也意味着任何一段包含 "Face-Added" 的报错文本都会被误判成成功。
这类问题不值得单独立一章批判,但它决定了这本书的性质:它教你让系统跑起来,不教你让系统活下来。教学项目和生产系统之间隔着的,就是这些沙粒。
七、它的短板
前面夸的和骂的都摆完了,这一节把它真正缺的东西列清楚。我认为有四处。
第一,也是最要命的:全书没有一节讲安全。没有权限模型,没有提示注入,没有密钥管理,没有输入校验,没有调用审计。八个项目里,凡是能碰到外部资源的地方,都是「能调通就行」。这不是遗漏了一个知识点,是遗漏了一个维度——智能体和普通程序最大的区别就在于「调用者是模型」,而模型是可以被说服、被诱导、被注入的。一本 2026 年的智能体教材,把这一维度整个空掉,等于把最危险的那部分留给读者自己去撞。
第二,没有评估。人脸比对用了 compare_faces(coding_list, check_encoding, tolerance=0.5),tolerance 取 0.5,这是 face_recognition 的默认值。为什么是 0.5?调到 0.45 会怎样、0.55 会怎样?误识率和拒识率怎么权衡?书里一个字没提。活体检测讲了 EAR(眼睛纵横比)公式、讲了眨眼和张嘴的判定,但同样没有给阈值来源,也没有说这套方法在什么条件下会失效——比如屏幕翻拍、视频回放、戴墨镜。语音识别用了 Vosk 和 Paraformer,识别准确率多少、噪声环境下掉多少,也没有数字。整本书的验收标准是「跑通了」,不是「准确率多少」。
第三,教学语料暴露了项目的真实体量。第 8 章的「智能在线客服」,RAG 的知识库文档是蜗牛学苑自己的招生问答。我读到那一段的时候愣了一下——文档里是一条条「蜗牛学苑可以保证我学习完一定能找到AI领域的工作吗?答:我们对自己的课程很有信心……」这种问答。这个选择本身没错,甚至挺聪明:招生问答天然是「问题—答案」成对的结构,最适合演示分段与检索。但它同时说明,这个「企业级智能客服」的语料规模是几十条 FAQ,而不是几千页产品手册。分段策略在小语料上表现好,不代表在大语料上表现好,这一点书里没有提醒。
第四,大量代码是「此处略」。第 8 章的前端 admin.html,注释写着「该代码与AI智慧课堂代码一致,此处略」。第 3 章的登录校验也用了同样的处理。对纸书来说这是必要的取舍,页数有限;但对「照着敲」的读者来说,这意味着你拿到的不是一份能直接运行的工程,而是一份带省略号的讲稿。你要么去下载配套源码(书里没怎么强调这件事),要么自己补。教材的完整性问题,在纸介质上几乎无解——但至少要明确告诉读者「这里有省略,请配合源码阅读」。
这四处加起来,构成了这本书的天花板:它是一本合格的「入门操作手册」,不是一本合格的「工程指南」。前者教你怎么开始,后者教你怎么不出事。它把前者做到了七十分,后者只做到三十分。
八、该怎么用这本书
说了这么多不是要否定它。这本书有它准确的读者,而且这个读者群很大。
如果你是刚学完 Python、想做出第一个「能对话、能动手」的东西的人,这本书的路径是最省力的:第 1 章让你今晚就能让模型回话,第 2 章让你明天能把它包成一个网页,第 3 到 8 章让你一周内有六个能截图发朋友圈的成品。「先做出来」这件事的价值,任何理论都替代不了。很多人卡在第一步不是因为不懂原理,是因为不知道从哪下手,这本书把每一步都写成了可执行的指令。
如果你是要把智能体放进生产环境的人,这本书只能当目录用。它的价值在于告诉你「一个智能体应用有哪些零件」——模型接入、工具调用、Web 框架、数据库、前端、RAG、向量库、分段、重排。这个清单是完整的,你可以拿它当检查表,一项项问自己「我这套系统里这块是怎么做的」。但每一块的具体实现,你得去别处找更严谨的材料。
如果你要把它当教材教学生,我建议加三节课,而且是加在第 1 章之后、第 3 章之前:第一节课讲密钥管理(为什么不能写进源码、环境变量怎么用、泄露了怎么轮换);第二节课讲工具权限(白名单、参数校验、最小权限、为什么要给每个工具写清楚「它能做什么、不能做什么」);第三节课讲评估(怎么定义「做对了」、怎么造测试集、误判的代价是什么)。这三节课加起来不到十页,但它决定你的学生做出来的是玩具还是系统。
最后说一句这本书让我改变的想法。我原以为「教材」这个身份是它的护身符——教材嘛,能跑通就行,不必苛求工程严谨。读完我改主意了:教材比专著更需要严谨,因为读它的人没有判断力。一本专著写错了,读者会质疑;一本教材写错了,读者会照抄,然后把这个错带到下一个项目、下一份工作、下一个产品里。那个印在书上的 API Key,会被多少人复制进自己的代码?那个 eval(),会出现在多少个期末作业里?
它教会了读者让智能体干活。它没教读者给智能体上锁。而在 2026 年,这两件事已经不能分开了。
书名:智能体开发技术(Python+FastAPI版)
作者:蜗牛学苑 组
出版:人民邮电出版社 · 2026 年 1 月 · ISBN 9787115685742
读法:全书八章通读,含版权信息、内容提要、前言
说明:文中引语、代码片段、章节结构与示例数据均摘自原书;关于「智能体缺安全维度」「教材比专著更需要严谨」「验收标准是跑通而非准确率」的判断,是我读后所加,原书未作此论
逐页精读系列 · 2026 年 11 月
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: