
Midjourney AI生图与修图从入门到精通:它教你怎么抽,没教你怎么交
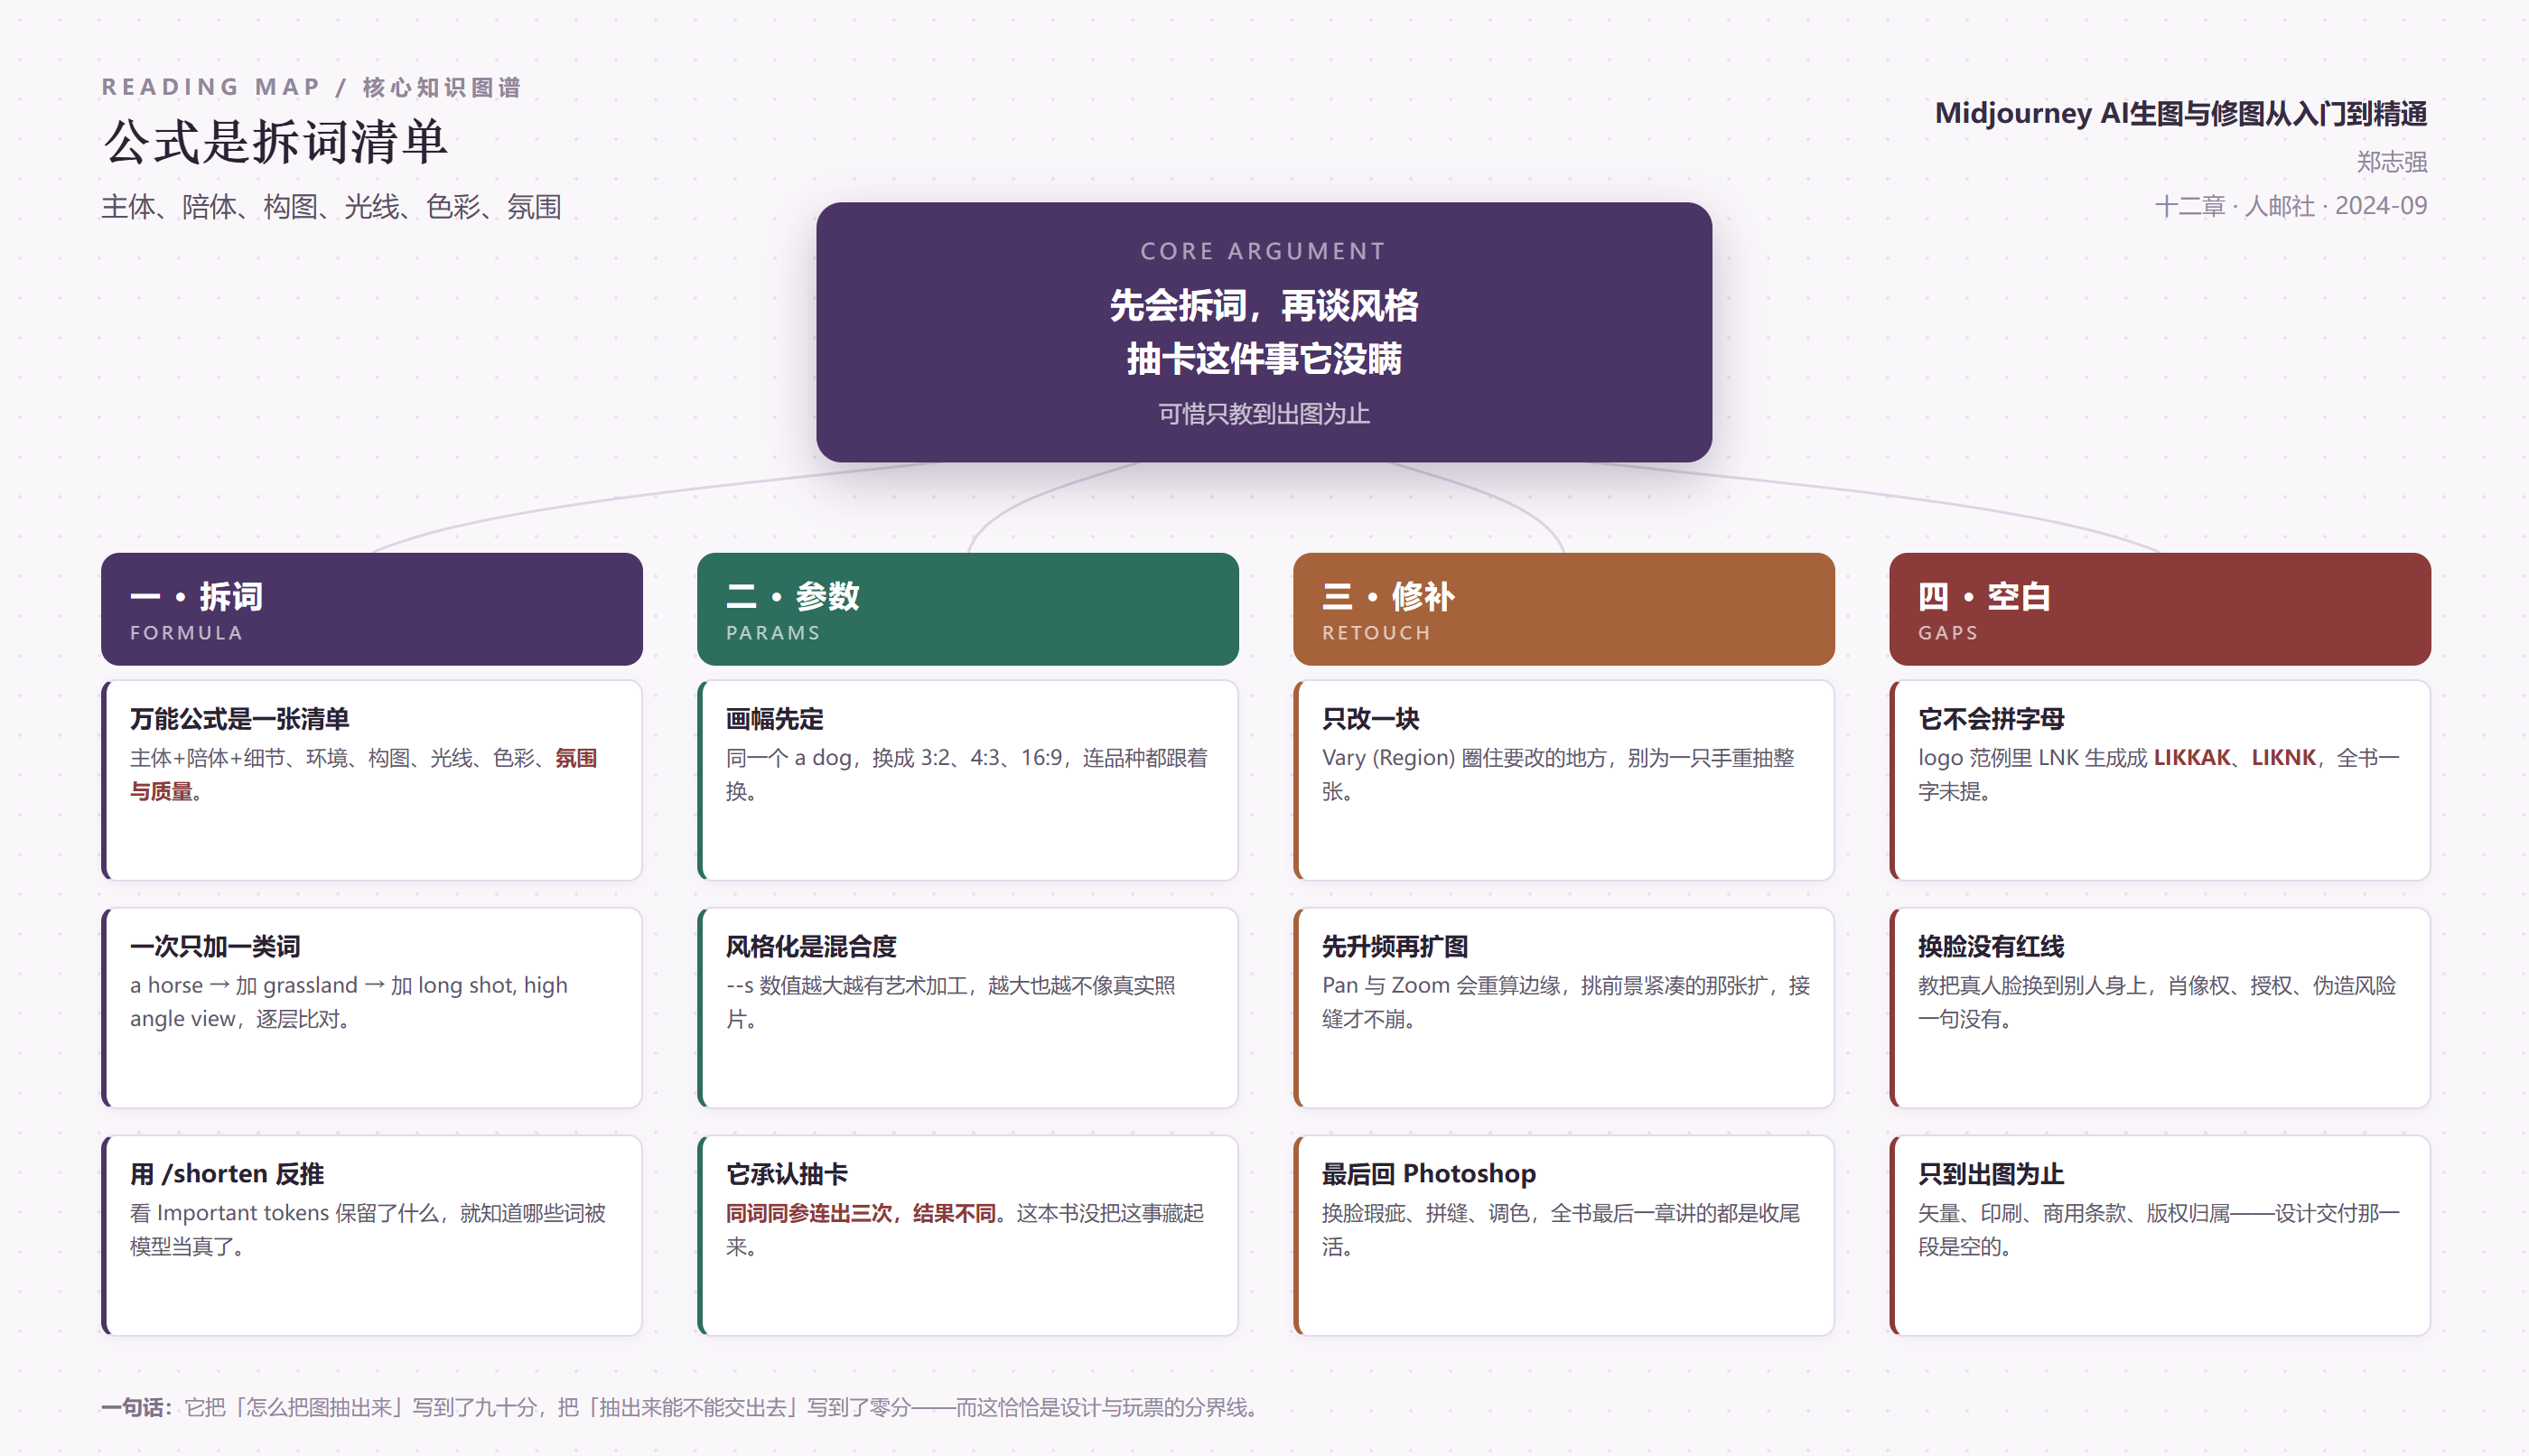
一、它最大的贡献,是把「咒语」拆成了一张清单
用过 Midjourney 的人都知道那种感觉:输入几个词,出来四张图,好看是好看,但你不知道哪句话起了作用。于是只能加词、再抽、再看,像在赌。市面上的教程大多在这个层面打转——给你一百条「神级提示词」,你抄了能用,换个题材就废。
这本书做的是另一件事:把一条提示词拆成部件。它给的中文公式是这样的——
主体 + 陪体(客体)+ 细节、环境 + 细节、构图(景别、视角高低、构图形式等)、光线(光的方向、自然光与灯光、电影光、影棚光、柔和与硬朗、日出与日落)、色彩、氛围渲染、情绪、质量。
看起来像废话,其实不是。它的价值在于把「我想画一张好看的图」这种模糊愿望,翻译成了九个可以分别取舍的槽位。你要拍人像,主体和光线先定;你要做室内,构图和色彩先定;你要出海报,画幅和氛围先定。每一类题材该往哪几个槽位里填东西,是有优先级的,而这本书按题材分了章来讲——摄影分了风光、人像、时尚、纪实、野生动物、微距、花卉、微缩、星空九类,设计分了室内、建筑、logo、UI、包装、服装、鞋类、电子产品、首饰九类。
按题材切,而不是按参数切,这个结构选择是对的。读者要的是「我要做一张 X,怎么办」,不是「--s 是什么意思」。
但我得说清这张清单的边界:它是「描述维度」的清单,不是「审美判断」的清单。它告诉你光线可以分方向、分软硬、分自然与棚拍,但它不告诉你这张图该用侧逆光还是顶光。后者要靠你自己看图、看片、看画。这一点书里没明说,容易被误读成「填满九个槽位就出好图」。
二、逐层加词:这本书唯一真正的方法论
第八章有一组我最认可的示范。作者拿一匹马做实验,第一句只写 a horse,出来的图里马站在各种奇怪的地方——他原话是「这匹马所处的场景是比较随机的,不符合我们的要求」。
然后加一层:a horse on the grassland。场景定了。
再加一层:A galloping horse in a meadow with blooming wildflowers, long shot, high angle view。这一次不只是场景对了,连视角、景别、动势都变了,作者的说法是「图片越来越具有形式美感」。
这三步看起来简单,实际上把生成式绘画最核心的学习方法讲明白了:一次只加一类词,然后比对。加环境,看环境怎么变;加构图,看构图怎么变;加光线,看光线怎么变。每一步只动一个变量,你才知道哪个词在起作用。
绝大多数人失败,不是因为词不够多,是因为一次加了十个词,出问题的时候不知道拆哪一个。这本书的方法等于强制你保留可归因性——跟做实验一样,控制变量。
顺带说,这个方法也能解释一个常见困惑:为什么抄了别人的提示词,效果差很远?因为提示词不是配方,是一组约束的叠加。别人的「氛围感」可能来自光线,也可能来自画幅,也可能来自某个你根本没注意的形容词。你不知道哪句话在起作用,就只能整体照搬,一改就崩。
三、/shorten 是个好东西,多数人不知道怎么用
书里有一节讲 /shorten 命令:把你写的一段提示词喂进去,它会返回两部分——Important tokens(它认为重要的词)和几档 Shortened prompts(删减后的版本)。
书里给的例子挺典型:一段写白裙女人的提示词,掺了 nostalgic、soft lighting、half body、real photo 这些词,/shorten 保留下来的核心是「复古、白裙、森林背景、侧面、膝盖以上、光线」,把 soft、half body、real photo 这类词判成了可删。
这个反馈信息的价值,比它本身的「帮你缩短提示词」大得多。它等于让模型告诉你:你写的哪些词它当真了,哪些它当噪音忽略了。你一直以为自己靠 real photo 在控制写实度,结果它根本没理这句话——那你后面所有的调参都是在瞎试。
可惜书里只把它当成一个「省字数」的工具在讲,没往这层推。它甚至没有提醒读者:删掉的词不一定没用,只是权重低;保留的词不一定重要,可能只是模型认识。这两句话一补,这一节的价值能翻倍。
四、它没瞒着抽卡这件事
这一点我要给它记一功。第六章讲 --repeat 的时候,作者用同一个提示词 a dog --ar 3:2 连出了三次,然后写了一句:
可以看到,即便使用完全相同的提示词和参数,图片效果也是不同的。
就这么一句,很多书是不写的。因为它们要卖「可控」这个卖点——一旦承认同样输入会有不同输出,读者就会问:那我怎么保证交付?
这本书选择说实话。它没有夸张地承诺「一次出图」,也没有把随机性包装成「灵感」。它只是告诉你:同词同参,结果不同;接着给了 --seed 之类能部分收敛随机性的手段。
为什么我要单独拎这一句出来?因为我读过太多生成式工具的书,通篇只放成功案例,读者照着做,出不来就以为是自己水平不行。真实情况往往是:这条片子/这张图,本来就要抽很多次。知道这一点和不知道,是完全不同的两种心理准备——前者会继续调,后者会怀疑自己。
但这本书也只走到「承认」这一步,没走到「定价」这一步。它没说一张商用级的人像大概要抽几轮、一个 logo 从概念到能用要烧多少额度、返工率大概多少。对一本要指导生产的手册来说,这几个数比任何参数都重要。
五、参数的真相:画幅比内容更能决定成败
第六章讲 --ar 的那几页,是全书最有说服力的地方之一。同一个 a dog,换 3:2、4:3、16:9 三种画幅,出来的不只是构图变了,连狗的品种、光线、气质都跟着变。3:2 那组偏电影感、环境占比大;4:3 那组更像棚拍肖像;16:9 那组干脆往宽银幕叙事上跑。
这个现象值得多想一层:画幅不只是裁剪比例,它是模型对「这张图是什么类型」的隐含判断。16:9 在训练数据里多半是剧照和风景,4:3 多半是人像和产品,1:1 多半是社交媒体图和图标。你改一个比例,等于给它换了一个「参考系」。
所以正确的顺序不是「先写好提示词,再定画幅」,而是先定用途,再定画幅,最后填内容。做封面先想清楚是横版还是竖版,做头像先想清楚是方图还是长图。这本书把这条经验摊在了图里,但文字上没点透,还是按「参数说明」的口吻在写。
风格化参数 --s 也一样。书里的解释是:数值越大,图片越具丰富性和艺术性,越像「处理过的真实照片」。这句话没错,但它漏了反面——数值越大,越偏离你写的东西。--s 高的图好看,但常常不是你描述的那张。做商业稿时,这个偏移是要命的:客户要的是「我们的产品」,模型给你的是「一张有氛围的图」。
同一章还藏着两个比参数更影响钱包的设置,书里都提到了,但都只当成按钮在讲。
一个是生成模式:Fast 与 Relax。前者扣额度、出图快,后者排队、不额外扣。作者在演示批量生成时撞过一次墙——想用 --repeat 一次出三组,系统直接回了一句 Job action restricted: Batch jobs are only available for subscribers with fast mode enabled。这句话的潜台词是:批量抽卡是付费能力。你抽得越多,越是花钱买运气。这一点对预算敏感的人比任何参数都重要,但书里只写「将生图速度模式改为 Fast mode」,把它当成了操作步骤,没当成成本决策。
另一个是可见性。Settings 里有一排按钮:Public mode、Stealth、Remix mode、High 与 Low Variation。作者逐个演示了点选效果,唯独没解释「Public」意味着什么——你的图会出现在公共频道里,别人能看见、能点开、能顺着找到你的账号。对做个人创作的人,这不算事;对拿公司未发布的产品图去试稿的人,这就是事故。要用隐身模式得升级到更高档订阅,这条信息在书里是缺的。
我不认为作者不知道这些。更像是这类操作书的惯性:把「怎么点」当成知识,把「为什么该点」当成常识。可对读者来说,恰恰后者才是花钱买不到的部分。
六、修图那几章,本质是「怎么少抽几次」
第五章和第十二章是这本书最实用的部分,虽然它们看起来最不像「方法论」。
第五章讲三件事:变体(V 系列)、局部重绘(Vary Region)、无限扩图(Pan 与 Zoom)。局部重绘的用法很朴素——图里只有一只手崩了,就圈住那只手重画,不要为了一只手把整张图重抽。这个动作省下的不是时间,是运气:整张重抽意味着其他你满意的地方也要重新赌一次。
扩图那节有个细节我印象很深。作者先选了一张前景树丛和太阳上方「显得比较紧」的图去升频,理由是这些区域后续方便扩展——也就是说,扩图前要先判断哪张图有「扩的余地」。然后依次试 2 倍、1.5 倍、方形扩展,比较视角变化。这个顺序是有讲究的:先扩再挑,比先挑再扩省事。
第五章末尾还讲了一节「升频后的管理」,讲怎么把过大的图下载、怎么整理文件。这一段技术含量不高,但我觉得位置很重要——它承认了一件事:出图不是终点,管图才是。一个人抽一下午能出几百张,全躺在 Discord 的频道里,没有命名、没有分类、过两天自己都找不回来。书里给的办法很朴素(按项目建频道、及时下载原图),但它至少提醒了你:这套工作流的瓶颈很快就不是生成,而是检索。
第十二章把图拉回 Photoshop:处理换脸留下的边缘瑕疵、拼接 AI 素材与实拍照片、调色统一。全书最后一页是一张在 PS 里合成的卫衣图——不是一句总结,也不是一个展望,就是一张做完的图。
这个收尾很能说明这本书的性质:它相信「做出来」本身就是结论。
我不完全同意这个态度,但我理解它的来源。对一个每天要交稿的人来说,方法论是奢侈品,能交稿才是硬道理。问题在于,只教「做出来」,读者就永远停在能交稿、但不知道为什么能交稿的水平——下一次换个题材,又得从头抽。
七、九类摄影、九类设计:模板的价值与尽头
第九、十两章占了全书将近三分之一,结构完全一样:先讲这一类的基本盘,再给一串通用提示词,最后一类一类往下拆。
摄影那章先讲流派,再分题材:风光、人像、时尚、纪实、野生动物、微距、花卉、微缩、星空。设计那章分室内、建筑外形、logo、UI、包装、服装、鞋类、电子产品、首饰。每一类的开头都是同一句话的变体——「输入英文提示词 X,中文翻译为 Y」,然后四张图。
这种写法常被批评为「模板化」,但我认为它有不可替代的用处:它是一个起点库。你完全不知道一类图该怎么描述时,先抄一条结构,再把自己的主体换进去,比从零开始想快得多。新手最缺的从来不是创意,是「这类图通常由哪几个视觉要素构成」的常识。
尤其是「流派」那一节的思路,我觉得比它的具体内容更值钱。作者把风格当成可拆解的项——极简是留白与低饱和,电影感是宽画幅加冷暖对比,超现实是尺度错位。这个拆法承认了一件很多人不愿意承认的事:风格不是玄学,是光线、色彩、构图、景别的固定组合。你能描述它,就能复现它;描述不出来,就只能说「我要那种感觉」。
但模板的尽头也很清楚:它给的是维度组合,不是判断标准。九类摄影各给一串提示词,可同一类里「能看」和「好」差在哪儿,书里没有一句。风光那节告诉你加 long shot、high angle view,却没告诉你什么时候不该用高视角——俯拍会把山拍小、把水面拍平,这是风光摄影的常识,但书里只讲「加了会更美」。
这就是模板类内容的老问题:它教你怎么做对,不教你怎么判断什么是对的。前者能抄,后者得练;而书能提供的是前者,读者误以为得到的是后者。
八、它真正在教的,是把图当成「提案」而不是「成品」
第十章讲室内设计,开头有一段话,我觉得是全书最有商业洞察的一处。作者说,借助这类工具可以生成非常真实的图,方便设计师更直观地做方案,也可以直接把图给客户看,客户满意之后就确定了室内设计的风格,这样做的效率是非常高的。
这句话把 AI 绘图在专业流程里的位置说准了:它是提案工具,不是生产工具。提案要什么?方向一致、气氛对、能摆在会议桌上讨论、能在一个下午改五版。提案不要求什么?尺寸精确、结构可施工、材质可采购。
一旦按「提案」定位,很多争论就没意义了。手指多一根不该纠结,因为提案里没有手;透视有点飘不用重抽,因为客户看的是气氛;文字拼错也不算大事,因为你后面要重新排字。反过来,如果你拿提案图当成品交出去,问题就全来了——这也正是这本书最该讲、却始终没讲的那条线。
举个最清楚的例子:logo 那一节。书里给的图很漂亮,一堆烫金质感的徽标,看着像能直接用。但它生成的是位图——放大就虚、单色就糊、印刷就偏色。真正的 logo 要矢量路径、要标准制图、要黑白与反白版本、要最小使用尺寸。书里一句没提,读者很可能拿着 PNG 去找印刷厂,然后被退回来。
UI 那节也一样。界面图好看,但它没有栅格系统、没有组件规范、没有交互状态,离「能交给前端」还差一整个设计系统。服装、鞋类、首饰更远——那是效果图,不是版型、不是结构、不是工艺单。
这个缺口为什么重要?因为它决定了报价和工期。客户看到提案图,会以为这就是成品;你按「一张图」报价,实际还要几倍工作量去落地。这类纠纷在行业里天天发生,而这本书恰好站在能提醒读者的位置上,却没有提醒。
九、那句「别家只用商业图库」,站不住
第一章有一段话,我读的时候停了一下。作者说 Midjourney 独树一帜,得益于它「利用全网图片训练的模型」,然后写:
相比之下,Adobe Firefly、DALL·E 等工具仅基于部分国外商业图库进行训练,因此在生图能力、细节和质感方面均存在局限。此外,这些工具在对大量包含中国元素的提示词的识别方面表现欠佳。
这句话有两个问题。
第一,事实层面站不住。Firefly 的训练数据确实以 Adobe Stock 和公版内容为主,但那是合规选择,不是能力短板——它的卖点恰恰是「可商用、有授权」,很多企业客户就为这个选它。DALL·E 的训练数据更不是「部分商业图库」。把一种数据策略说成能力缺陷,这个推论跳得太快。
第二,逻辑层面更麻烦。就算 Midjourney 在写实质感和中国元素上有优势(这一点在中文语境的素材上确实能观察到),把对手的合规路线描述成劣势,等于给读者一个错误的选型依据。一个要给客户交稿、要开票、要担版权责任的人,看到这段话会以为「选 Midjourney 就行」,而实际上他很可能需要的是能出具授权说明的工具。
我不认为这是恶意。更像是这类操作书的通病:写的时候要论证「为什么本书选这个工具」,于是顺手把别家压低一格。但这种压低,恰恰是读者最容易被误导的地方——因为读者没有能力去核对,只能信书。
十、它的短板
一、工具速朽,而这本书把速朽的部分做成了主线。第二、三章大量篇幅在讲 Discord 注册、建服务器、切账号、频道管理。这是平台操作,不是创作能力,而且变得极快——书里的界面是几年前的样式,模型版本停在 V6 的测试阶段。今天再打开,路径和按钮都对不上了。真正该多写的(提示词结构、参数取舍、修图判断)反而被压缩在后面几章。
二、图文比失衡。大量页面是一两句说明配一整屏界面截图。读者学到的是「点哪里」,不是「为什么」。一本讲创作的书,最该展开的是判断依据:为什么这张比那张好、这个视角为什么比那个稳、光线从哪边来更符合题材。这些内容在书里几乎都是一句话带过。
三、它没告诉你 AI 不会拼字母。讲 logo 设计那一节,示例提示词写的是「基于 LNK 设计徽标」,生成的图里出现的字母是 LIKKAK、LIKNK。作者把这张图当成范例放上去,全书没有一句提到「生成文字会拼错」。这是最典型的「看得见却没人指出来」——logo 恰恰是以文字为主的设计品类,这个坑不指出来,读者拿着图去找客户,第一轮就得返工。
四、换脸那一章,红线是空的。第十一章完整教了 AI 换脸:装 InsightFaceSwap 机器人、上传人脸、保存 ID、把一张脸换到另一张脸上,连「换脸后的 ID 管理」都讲了——用 /del 删全部、用 /delid 删单个。但你翻遍这一章,找不到一句关于肖像权、授权、深度伪造的话。
更微妙的是那个「ID 管理」:它把删除人脸数据当成一个技术操作在教(怎么删、删完提示什么),却没讲「什么时候必须删」。这两件事的差别很大——前者是操作熟练度,后者是责任意识。一个人脸 ID 存在别人的服务器上,存多久、谁能用、怎么证明已删,这些才是这一章真正该回答的问题。
五、它只教到「出图」为止。这本书的副标题叫「生图与修图」,确实只到图。设计交付那一整套——矢量转换、印刷色差、尺寸规范、字体授权、商用条款、生成图的版权归属——一个字没有。而第九章、第十章讲的是摄影和设计行业的应用,这就产生了一个落差:它给你看这个行业能怎么用,却不给你这个行业真正要交的东西。
六、没有失败案例。全书没有一节讲「这张图崩了,为什么崩,怎么补救」。手有几根指头、字拼错、透视歪、材质糊——这些是每个用 Midjourney 的人每天都会遇到的,书里只展示漂亮的那四张。读者学到的是一套理想流程,遇到现实就卡住。
七、没有结语。十二章讲完,最后一页是一张 PS 里的卫衣合成图,然后结束。没有回顾、没有边界、没有「什么时候不该用 AI」。一本六百多页的书,缺一个收束,读完之后你不知道作者到底想让你记住什么——这本身是个结构问题。
八、中文读者的门槛没交代。全书提示词都是英文,中文只作翻译对照。它没有解释为什么必须用英文(模型对英文视觉词汇的响应更准),也没有教怎么把中文意象翻成英文的视觉词——「烟雨朦胧」「市井气」「旧时光」这些词,直译过去模型根本接不住。对一本面向中文读者的书,这是最该补的一节。
九、全书没有一个贯穿案例。每一节都是独立的:这一节出室内图,下一节出 logo,再下一节换脸。没有一条从头到尾的项目线——客户提需求、出三版提案、选一版深化、改到定稿、交付文件。而这条线才是一个真实项目的样子。碎片化的好处是随手可查,坏处是读完之后,你不知道把这些碎片串起来该怎么走。
一句话:它把「怎么把图抽出来」写到了九十分,把「抽出来能不能交出去」写到了零分——而后者恰恰是设计与玩票的分界线。
如果你刚开始用 Midjourney,这本书值得翻:第八章的公式和逐层加词的方法、第六章的画幅与风格化、第五章的局部重绘,这三块能省你不少瞎试的时间。如果你已经在接活,这本书帮不了你——你要的答案在交付、授权、返工率里,那部分它没写。至于换脸那一章,我的建议是:技术可以学,红线得自己立。
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: