
DeepSeek写作革命:它给了你一张参数表,也给了你一堆查不到出处的数字
一、它干的头一件事,是把写作变成一张权重表
大部分 AI 写作书都是这个结构:先讲工具怎么注册,再讲提示词怎么写,最后给你五十个模板。这本书跳过了前两步,一上来先做了一件更根本的事——给写作本身分项打分。
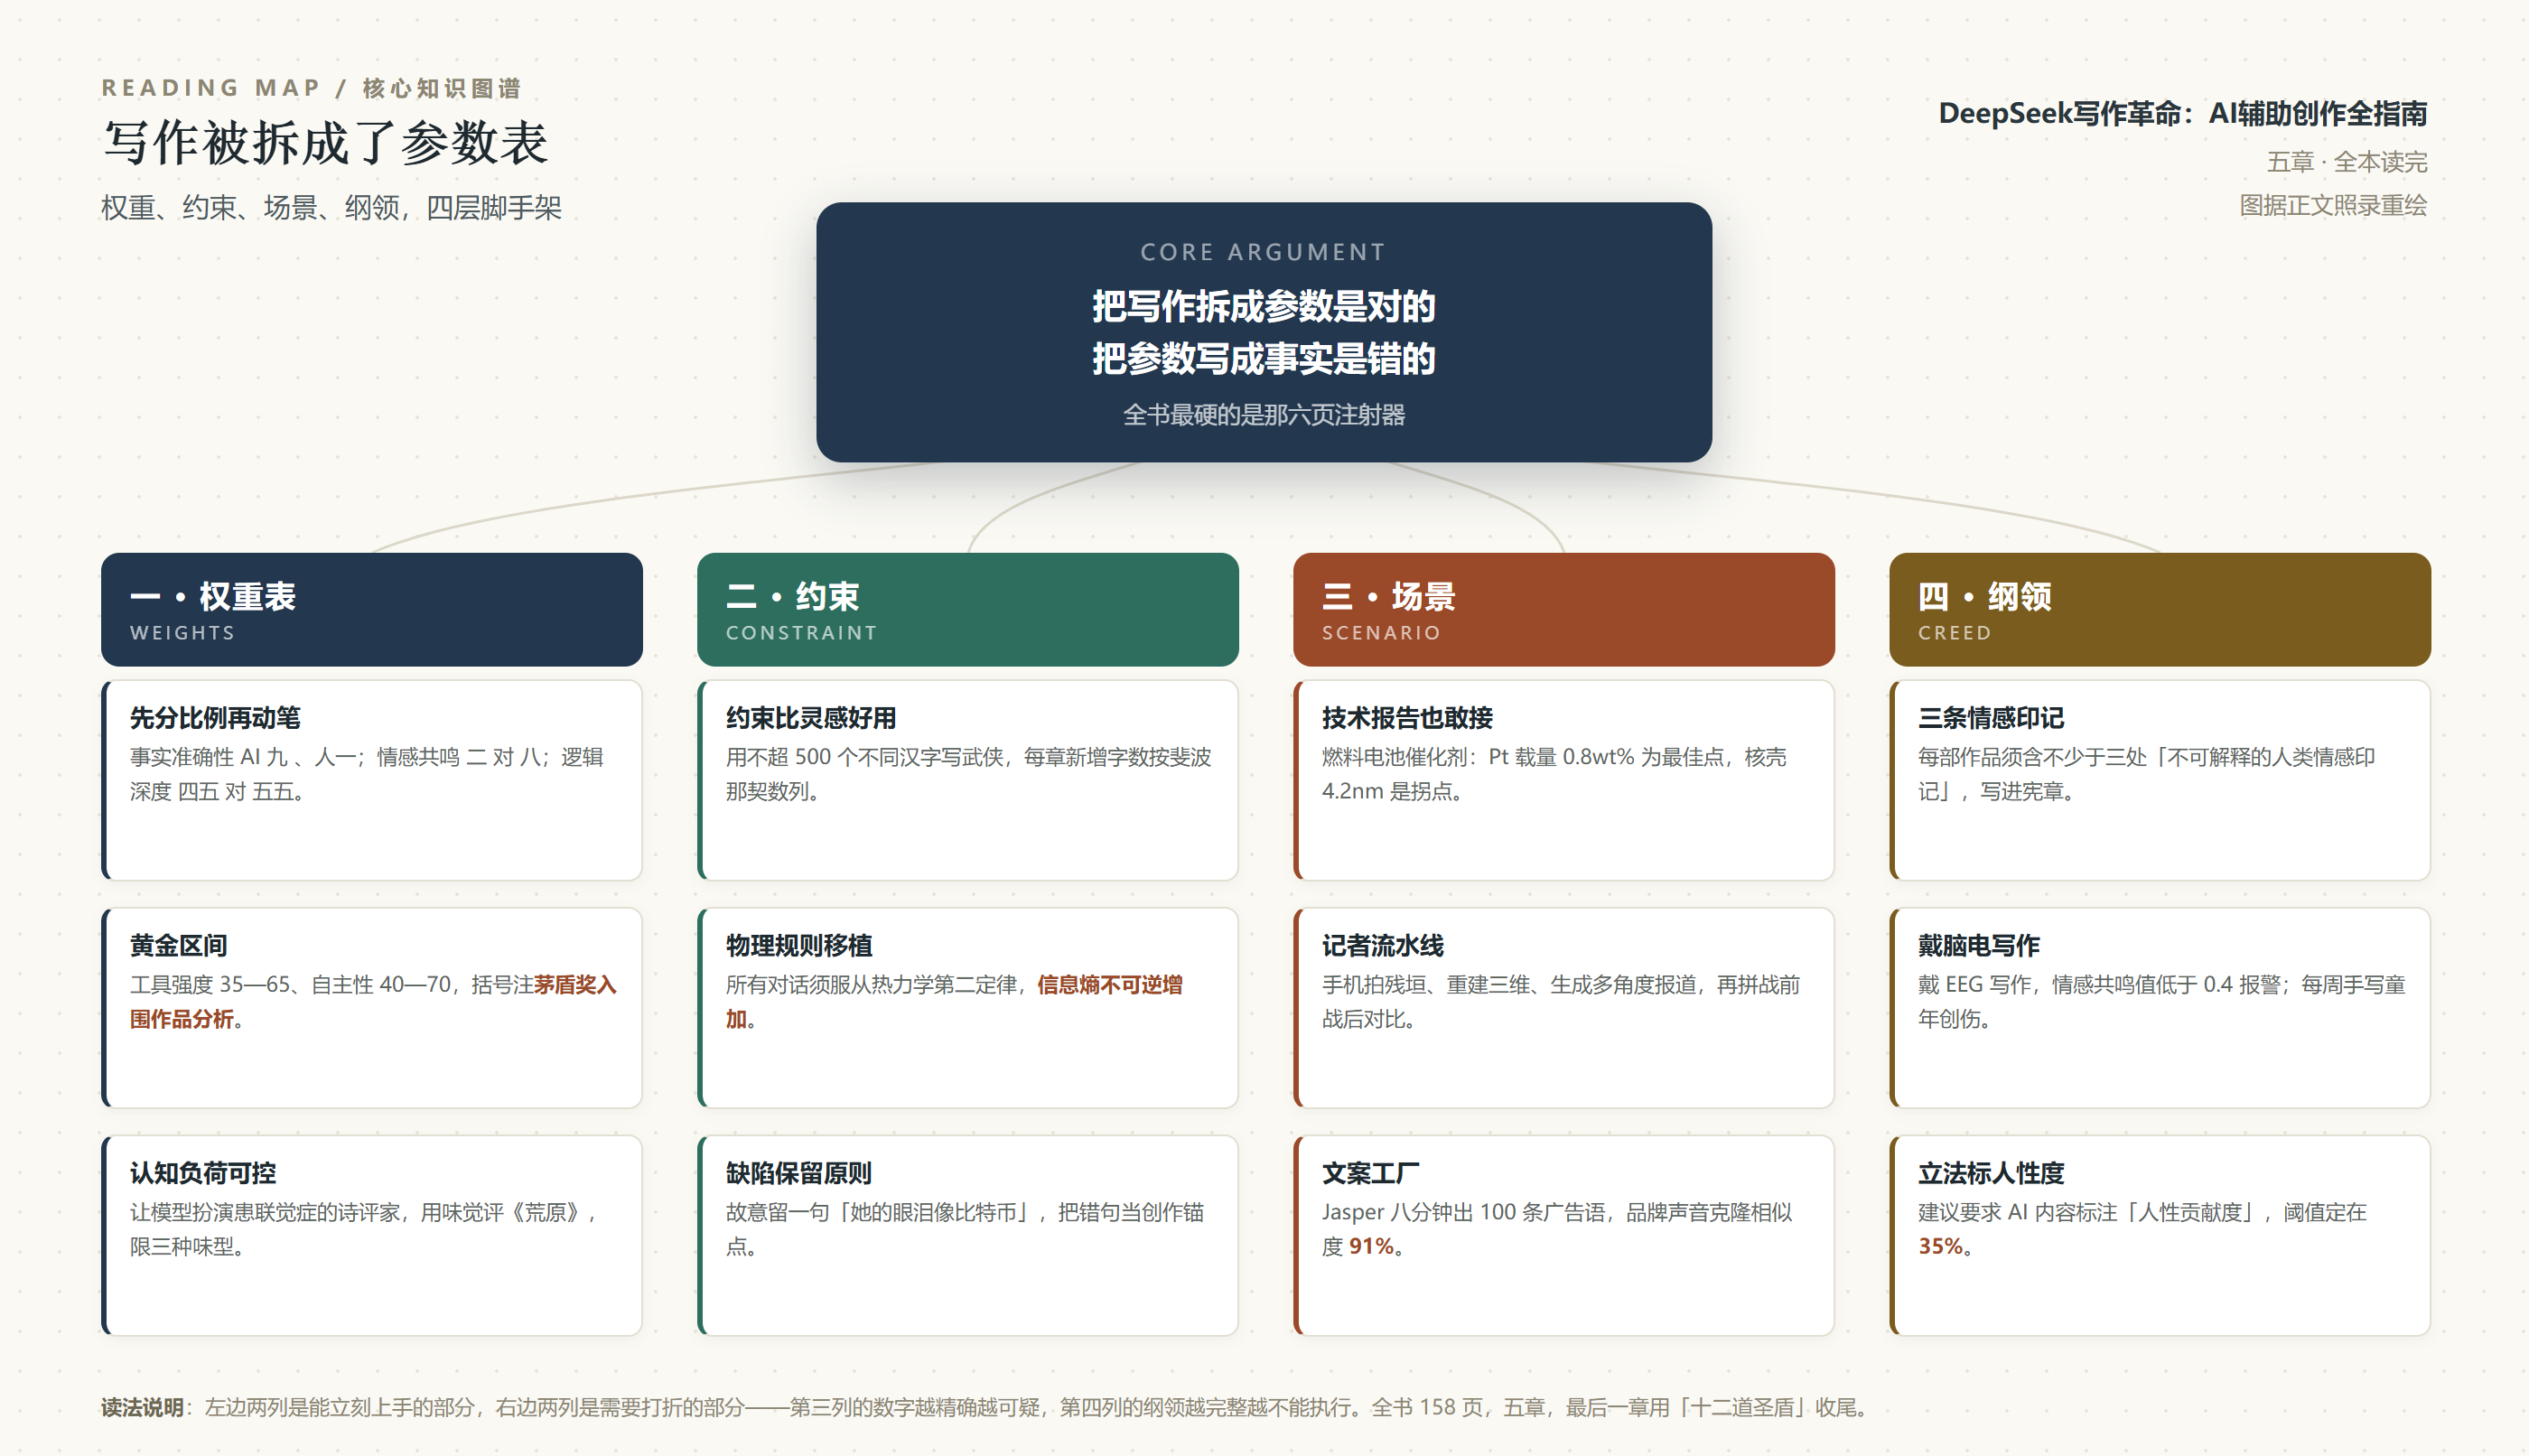
它给出一张对照表:事实准确性,AI 占九成、人占一成;情感共鸣,AI 两成、人八成;逻辑深度,AI 四成五、人五成五。这三个比例不是随便写的,它对应的是三种不同的活儿:查资料、抒情、推论。你想让 AI 写一篇行业分析,那你得知道它在「事实」这一项上的贡献大,所以你的力气应该花在核对;你想让它写一封给母亲的告别信,那它在这一项上只占两成,你的力气就得全花在自己身上。
我觉得这张表的价值不在于比例准不准——它肯定不准,也没法准——而在于它强迫你在动笔之前做一个动作:先决定这一篇里,哪部分该交给机器,哪部分必须自己扛。绝大多数人用 AI 写作出问题,不是因为提示词写得烂,而是因为从头到尾没做这个判断,于是把该自己扛的那部分也交出去了。
顺着这张表,它又搭了一个坐标系:横轴是「工具使用强度」,从纯人工的零到全 AI 的一百;纵轴是「创作自主性」,从完全自主的一百到完全依赖的零。它圈出一个「黄金区间」——工具强度三十五到六十五,自主性四十到七十,括号里注明「基于 2024 年茅盾文学奖入围作品分析」。
坐标系之后是一棵决策树,写法很程序员:如果类型等于商业文案,AI 强度上调到七十,自主性下调到三十;如果类型等于实验文学,反过来。这个写法看着笨,但它把一件一直被含糊处理的事说清楚了——不同类型的写作,机器该占的比重本来就不一样。文案要的是覆盖率和转化,实验文学要的是不可替代性,用同一套提示词去干这两件事,注定有一件要砸。
这个括号,就是这本书的分水岭。前半句是一个可用的启发式,后半句是一个我核不到出处的断言。而全书有几十处这样的括号。
二、第一章真正立住的地方,是它同时否掉了两种人
讲 AI 写作的书,立场通常是两边站:要么是「工具救世」,要么是「人文守夜」。这本书罕见地把两边一起否了,还给了名字——「工具依赖恐惧症」和「技术救世主幻觉」。
它描述了一场争论:某年书展的论坛现场,一位传统文学捍卫者当场摔碎了存着手稿的 U 盘,说「AI 写作是饮鸩止渴」;对面一位新锐作家掏出脑机接口设备,实时生成了辩论稿回击,说「恐惧工具才是创作的绝症」。作者把这场对峙定性为「整个行业对 AI 写作最典型的两大认知误区」。
立场我同意,例子的用法我不同意。因为这个场景读起来不像记录,像寓言——摔 U 盘、脑机接口现场生成辩论稿,两个动作都太完整了,完整到像为了说明观点而设计的。而作者没有给时间、地点、当事人,只有「某年书展的论坛现场」。
它接着给了数据:「85% 的传统作家拒绝使用任何 AI 辅助(中国作协 2023 年调研)」。这句话后面也一样,只有一个机构名和一个年份。
同一章里还有一处论述我是认的,虽然它的证据同样不可核。它引了一场盲测:把 AI 生成的战地报道与记者手稿混排,交评委盲审,结果是 AI 在伤亡数据整合的速度上明显占优,但一写到「母亲怀抱残骸」这样的段落,绝大多数评委能准确认出机器写的部分,作者给这个词起了个名字,叫「情感空洞」。
不管那场盲测是否真如书里所写,「情感空洞」这个词是准的,而且它比「AI 没有感情」这种说法有用得多。空洞不是说它写得假,是说它写得太全——每一句都在正确的位置上,每一层意思都不缺,所以读者找不到那个需要自己往里填的缝。人写的句子往往是有缺口的,缺口处才落得下读者的经验。这本书后面讲「留白生成器」,讲的就是怎么把缺口重新凿出来。
我不是说这些数字一定是编的。我是说,当一本书的论述强度全靠这类数字撑着,而这类数字又全部止步于「某机构 + 某年份」时,读者实际上被要求无条件相信作者。这在方法论书里是个硬伤——方法论书的全部价值就在于可复现,可复现的前提是证据链能走通。
三、「约束生成」是全书最可迁移的六页
绕过那些数字,第二章和第四章里藏着真东西。作者管它叫「约束生成美学」,说白了就是:不要给模型自由,要给它一条窄到只能往前走的通道。
他给了几个能直接抄的例子:
用不超过 500 个不同汉字创作长篇武侠小说,每章新增字数为斐波那契数列。
所有对话必须遵循热力学第二定律(信息熵不可逆增加)。
你是一位患有联觉症的诗评家,用味觉描述艾略特《荒原》的节奏变化(最多使用 3 种基础味型)。
这三条指令有一个共同点:它们都在人为制造匮乏。汉字的字表被限死,字数的增长被数列限死,比喻的通道被压缩到只剩三种味觉。为什么匮乏反而出好东西?因为模型在没有约束的时候,会稳定地回归它训练语料的平均值——也就是那种四平八稳、句句正确、读完记不住的文风。你给它自由,它给你平均数;你给它限制,它才被迫去语料里找不常走的那条路。
书里没把这层机制说明白,但它给的例子是对的,而且是对的样本。这一点我给它记一分。
同一套思路它还用在了长篇上,叫「世界观播种」。输入「后核冬天香港」,让模型长出来的东西是:摩天大楼包裹在防辐射菌丝网络中,货币单位改为「日照分钟」并对应光伏产能,黑市交易的是大脑皮层记忆刻录服务。再往下一步是「剧情分形生长」:主角发现政府篡改日照数据,模型推演三条路径,作者选一条,让分支继续长。
这一段我是真觉得有用。因为它解决的不是「怎么写得好」,而是「怎么开始写」。写长篇最耗人的不是句子,是设定——你脑子里有一个模糊的世界,但它没有规则,所以你写三章就写不下去。把设定拆成「货币是什么、能源从哪来、地下经济靠什么运转」这样几个必须回答的槽位,交给机器先长一版,你只需要做选择。写的人从「创造世界」降级成「审核世界」,这一步降级,恰好救了大部分卡在开头的人。
不过它漏了一件事:这类约束式提示的失败率很高。大部分「斐波那契数列」和「热力学第二定律」的产出是奇观,不是好文章——你会得到一篇结构精巧、读起来莫名其妙的东西。真正能用的做法是拿它当破冰,先出一个不像平均数的初稿,再由人来决定哪一段值得留。这本书把约束讲成了万能钥匙,却没有一句讲它什么时候会把门锁死。
四、那些精确到个位的数字,我一个都核不到
这一节要摆的东西多,我尽量一次说完。
讲 AI 的短板时,它说「作家独特用语习惯在 5 轮 AI 润色后消失率达 73%(《巴黎评论》作家跟踪调查)」;讲 AI 的强项时,它说「合同审查中发现隐藏条款风险的成功率达 88%,超越新手律师的 65%」;讲逻辑缺陷时,它说「在分析经济现象时,将相关性误判为因果关系的概率达 39%(MIT 经济系测试集)」「西方训练数据导致『个人英雄主义』叙事逻辑占比超 76%(跨文化写作研究)」。
讲情感识别时更狠:「2026 年全球情感计算峰会披露:顶尖 AI 模型对人类微妙情感(如愧疚与怜悯的混合态)识别率不足 12%,但已掌握 214 种情感操控话术。」
讲案例时也一样:「乌克兰前线记者产出效率提升 17 倍」;故宫合作项目「历史沉浸感得分 9.3/10(文旅部调查)」;某国产写作工具「中文语法纠错准确率 98.7%(超越 Grammarly 中文版 12%)」「网文敏感词库覆盖率达 99%(与网信办数据同步)」;某商用工具「生成 100 条广告语仅需 8 分钟(4A 公司实测)」「品牌声音克隆技术模仿苹果发布会文案风格相似度 91%」;查重系统「预测潜在重复段落准确率 92%」。
还有两处不属于「数据可疑」,属于「事件可疑」。一处是:「2025 年诺贝尔文学奖颁奖礼上,AI 翻译系统实时将瑞典语颁奖词转化为湘西方言俚语,同时生成符合苗族史诗诗律的答辩辞。」另一处是:「MIT 媒体实验室案例:杂交『蜜蜂舞蹈语言』与『5G 信号协议』,开发出能耗降低 72% 的通信算法。」
我没有能力把每一条都证伪,但我有能力指出它们的共同形状:全部精确到个位或小数点后一位,全部以括号里的机构名收尾,全部不给年份之外的任何索引,没有一篇论文、一个报告编号、一个可查的页面。而「5 万字小说框架仅需 12 分钟,比人类平均速度快 142 倍」这种话,括号里写的是「OpenAI 内部测试数据」——一个外部读者永远无法进入的地方。
这件事最讽刺的地方在于:这本书自己就在教你怎么让文字显得可信。它讲「情感注射器」的时候说,要往抽象段落里塞一个具体的、有物理质感的细节;它讲「记忆棱镜」的时候说,要把「市场竞争激烈」变成「父亲手表典当行的柜台玻璃,映照过十二个品牌的兴衰」。这些都是对的技法。而它自己在论证时用的技法,是往每个论断后面塞一个精确到个位的百分比——这是同一套手艺的另一面,只不过这次是用来给读者制造确信,而不是制造画面。
一本教人怎么写字的人写的书,在数据上这么写字,我不能当作没看见。
五、场景化那一章,它敢接技术报告,也敢编催化剂
第三章是全书野心最大的一章。它把写作场景分成学术、技术、新闻、新媒体、跨语言五块,每块都给一套流程。
技术那一块具体到让我停下来看了两遍:「输入『提高燃料电池催化剂耐久性』,AI 输出反常策略(故意引入晶格缺陷提升抗烧结性)、跨学科方案(借鉴生物酶自组装原理)、极端条件(测试 -196℃ 液氮环境下的异常活性)」,再给一组参数优化矩阵:「Pt 载量 0.51—2wt% → 找到 0.8wt% 最佳点;核壳结构厚度 35nm → 4.2nm 性价比拐点;退火温度梯度 ≤5℃/cm → 动态调整退火速率曲线」,最后注明用 Materials Project 数据库校验材料热力学稳定性。
我看着这组数字的第一反应是:如果这是真的,它应该出现在论文里,而不是一本写作书里。第二反应是:这本书没有告诉读者,0.8wt% 这个数在什么体系、什么测试条件下成立。燃料电池催化剂的铂载量优化,跟膜电极结构、离聚物含量、测试工况全都绑在一起,不存在一个脱离条件的「最佳点」。
学术那一块更值得说。「查重 4.0」一节写着:写作时实时连接查重数据库,预测潜在重复段落;然后——自动改写高风险句段,举的例子是把「量子退相干现象」改成「量子态环境退关联效应」。
我得把话说清楚:这不是写作技巧,这是规避查重的技术支援。把一句被判定为重复的话换成同义词组合,实质内容一个字没变,重复的本质也没变,变的只是检测结果。作者在这一节里没有加任何一句提醒,比如「改写不能替代引用」「换词不等于原创」。一本讲创作伦理的书,在伦理最容易被踩穿的地方留了白。
技术细节上还有一处说不通:新闻那套「战地记者系统」写着「手机拍摄残垣 → DALL·E 3 重建 3D 模型 → ChatGPT 生成多角度报道 → Midjourney 模拟战争前后对比图」。文生图模型不输出可用的三维几何,这条管线在第二步就断了。这种错误不像笔误,更像是照着听说来的工具清单排了一遍流程,没亲手跑过。
新媒体那一块稍微实一点:它给了一个「同质化」的诊断标准——相似文案占比超过 12% 就该警觉,还提出用生成式模型去检测生成式水文。跨语言那一块则是全书修辞最飘的地方:它说 AI 能同时完成「文化语境适配、俚语本地化、诗意保留翻译」三件事,然后照例上了一段颁奖礼轶事。三件事里,第三件最难,而它给的证据最薄。
六、创意章里的三支「注射器」,是这本书真正的干货
如果这本书只留六页,我留第四章的这一段。
作者给「人味」准备了三个工具,名字一个比一个玄,用法一个比一个实。
第一支叫「情感注射器」:在 AI 生成的科技报道里插入一句——「实验室白炽灯管发出蜂鸣,像极了几时乡村诊所的临终心电图」。第二支叫「记忆棱镜」:把「市场竞争激烈」转化为「父亲手表典当行的柜台玻璃,映照过十二个品牌的兴衰」。第三支叫「留白生成器」:在 AI 的完整叙述之后追加一句——「她没说的是,抽屉最深处藏着三粒褪色的抗抑郁药」。
还有一条我更喜欢,叫「缺陷保留原则」:故意保留 AI 生成的「不合理比喻」,比如「她的眼泪像比特币般难以预测」,把它当作创作锚点。
这四条的机制其实是同一个:把一个抽象判断,替换成一个有物理质感的物件。灯管的蜂鸣、柜台的玻璃、三粒褪色的药片、比特币的波动——它们都不是感情词,但它们让读者自己产生了感情。这就是「人味」在技术层面的定义:不是句子更抒情,而是细节密度更高、更具体、更不属于平均数。
这一节还有个附带的好处:它把「人味」从一种玄学变成了一个可以检查的清单。你写完一段,问自己有没有一个能被看见、被听见、被摸到的物件在里面;没有,就回去加一个。这比「要有真情实感」这种话有用一百倍。
它在这几页旁边还配了一套「神经可塑性训练」,做法朴素得不像一本讲 AI 的书:读 AI 文本的时候同步手写批注,说是激活运动皮层;把机械的段落用口语复述一遍,说是刺激布罗卡区。附带的结论照旧很硬——「经过 30 天训练,作家前额叶调控能力提升 41%」。
结论我照旧不信,做法我认。手抄和口述这两件事,本质上是在给文字加一条身体的回路:你看一遍,只过了眼睛;你抄一遍,过了手;你讲一遍,得先自己听懂。而 AI 写作最容易造成的退化,恰恰是这条回路的短路——你读它给你的一千字,每一句都通顺,于是你以为你懂了,其实你只是同意。抄一段、讲一段,是把这个「同意」逼成「理解」最土也最有效的办法。
但它同样缺了边界。这三支注射器全是文学化的抒情句式,塞进技术文档、财报、产品说明书里就是矫饰。一篇讲燃料电池的稿子,中间忽然出现「白炽灯管发出蜂鸣」,读者只会觉得作者在演。书里没有一句话讲「什么时候不该注射」——而 Judgement,恰恰是这套方法里唯一不能外包的部分。
七、它的短板
说完好的,说不够的。这本书的短板不是零散的疏漏,是结构性的。
第一,证据链是空的。上一节已经摆过,不再重复。只补一句:这类问题在方法论书里是致命的,因为方法论书的读者是来学「怎么做」的,而「怎么做」必须能被复现,复现必须能被核验。
第二,它的行动纲领自己都执行不了。第五章最后给了一份「守护者行动纲领」,四条:每部作品必须包含不少于三处「不可解释的人类情感印记」;AI 输出的价值观要过「伦理压力测试」(模拟 12 种文化视角冲击);保留 10% 的「道德模糊地带」禁止算法优化;佩戴 EEG 设备写作,当情感共鸣值低于 0.4 时触发警报;建议立法要求 AI 生成内容标注「人性贡献度」,阈值 35%。
「不可解释的人类情感印记」怎么计数?「情感共鸣值 0.4」由哪台消费级设备给出?「人性贡献度 35%」谁定、怎么测、谁来执法?这四条一条都落不了地。一份不能执行的纲领,功能不是指导,是表态。
第三,工具会过期,而它没给不变量。书名挂着 DeepSeek,正文里真正专门讲 DeepSeek 的篇幅反而不多,大量案例落在 ChatGPT、Midjourney、WorldAnvil、Jasper 和几个国产工具上。工具清单是最容易腐坏的部分,书里却没有一章讲「换工具的时候,哪些东西是不变的」。而那些不变的东西——约束、替换、留白、核验——恰恰散落在各章的例子里,没被提出来。
第四,案例只有结论,没有过程。乌克兰记者提效 17 倍、故宫项目沉浸感 9.3 分、品牌声音克隆相似度 91%,全部是一句结论,没有一篇稿子、一张前后对照、一次失败。读者学不到东西,只能记住数字。
第五,全书没有失败样本。我翻遍五章,几乎找不到一张「这样写就废了」的反例。而写作这件事,知道什么不能写,往往比知道什么能写更有用。
第六,它不谈读者。通篇在讲怎么写,几乎不讲谁在读、读多久、在哪读。一篇公众号、一份标书、一封家书,写法差异的根源不在作者,在读者的处境。这本书把镜头全对着写的人。
第七,术语通胀。「量子化创作」「创作维度的折叠术」「认知折叠」「巴别塔重建现场」「人性火种的十二道圣盾」——这些标题的修辞成本明显高于信息量。它们让目录好看,让正文变薄。
第八,伦理那章把责任指向了个人。它讲 AI 代写、讲学术不端、讲风格同质化,最后落到「创作者要自律」。但真正决定一个写作者行为的是平台的分发规则、雇主的交付周期、稿酬的计价方式。不谈这些,只谈自律,等于把结构问题翻译成道德问题。
把八条摆在一起看,问题就清楚了:这本书的骨架是好的——权重、约束、场景、纲领,四层搭得很整齐;坏的是填充物,填充物里混了太多看起来像证据的东西。骨架好、填充物虚,是这类书最常见的病,也是最难治的病,因为读者第一眼看到的是骨架。
八、一句话
这本书的用法,我建议反过来:把它的动词留下,把它的形容词删掉。
动词是这些:约束、替换、注射、留白、保留缺陷、口语复述、核对来源。形容词是那些:「革命」「终极形态」「量子化」「圣盾」「巴别塔」。前者能让你今天就动手改一段稿子,后者只会让你觉得这本书很重要。
至于那些精确到个位的百分比,我的处理办法很简单:一个都不引用。不是因为我认定它们全是假的,而是因为一本要求读者相信它、却不肯给出任何可查线索的书,本来就没打算让读者去核。
如果只让我从这本书里带走三样东西,我带走这三样:一张自己填的权重表,写在纸上,半年改一次;一套约束式指令,用来破冰出不像平均数的初稿;一份「具体物件」清单,用来检查每篇文章里到底有没有能被看见的东西。剩下的框架、圣盾、折叠术,都不必带走——它们属于目录,不属于手艺。
本篇只写我在书里实际读到的内容与判断;书中数据均照录,未作二次核验,也因此不引用。
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: