
AI辅助编程实战:它最值钱的地方,全是AI写砸的现场
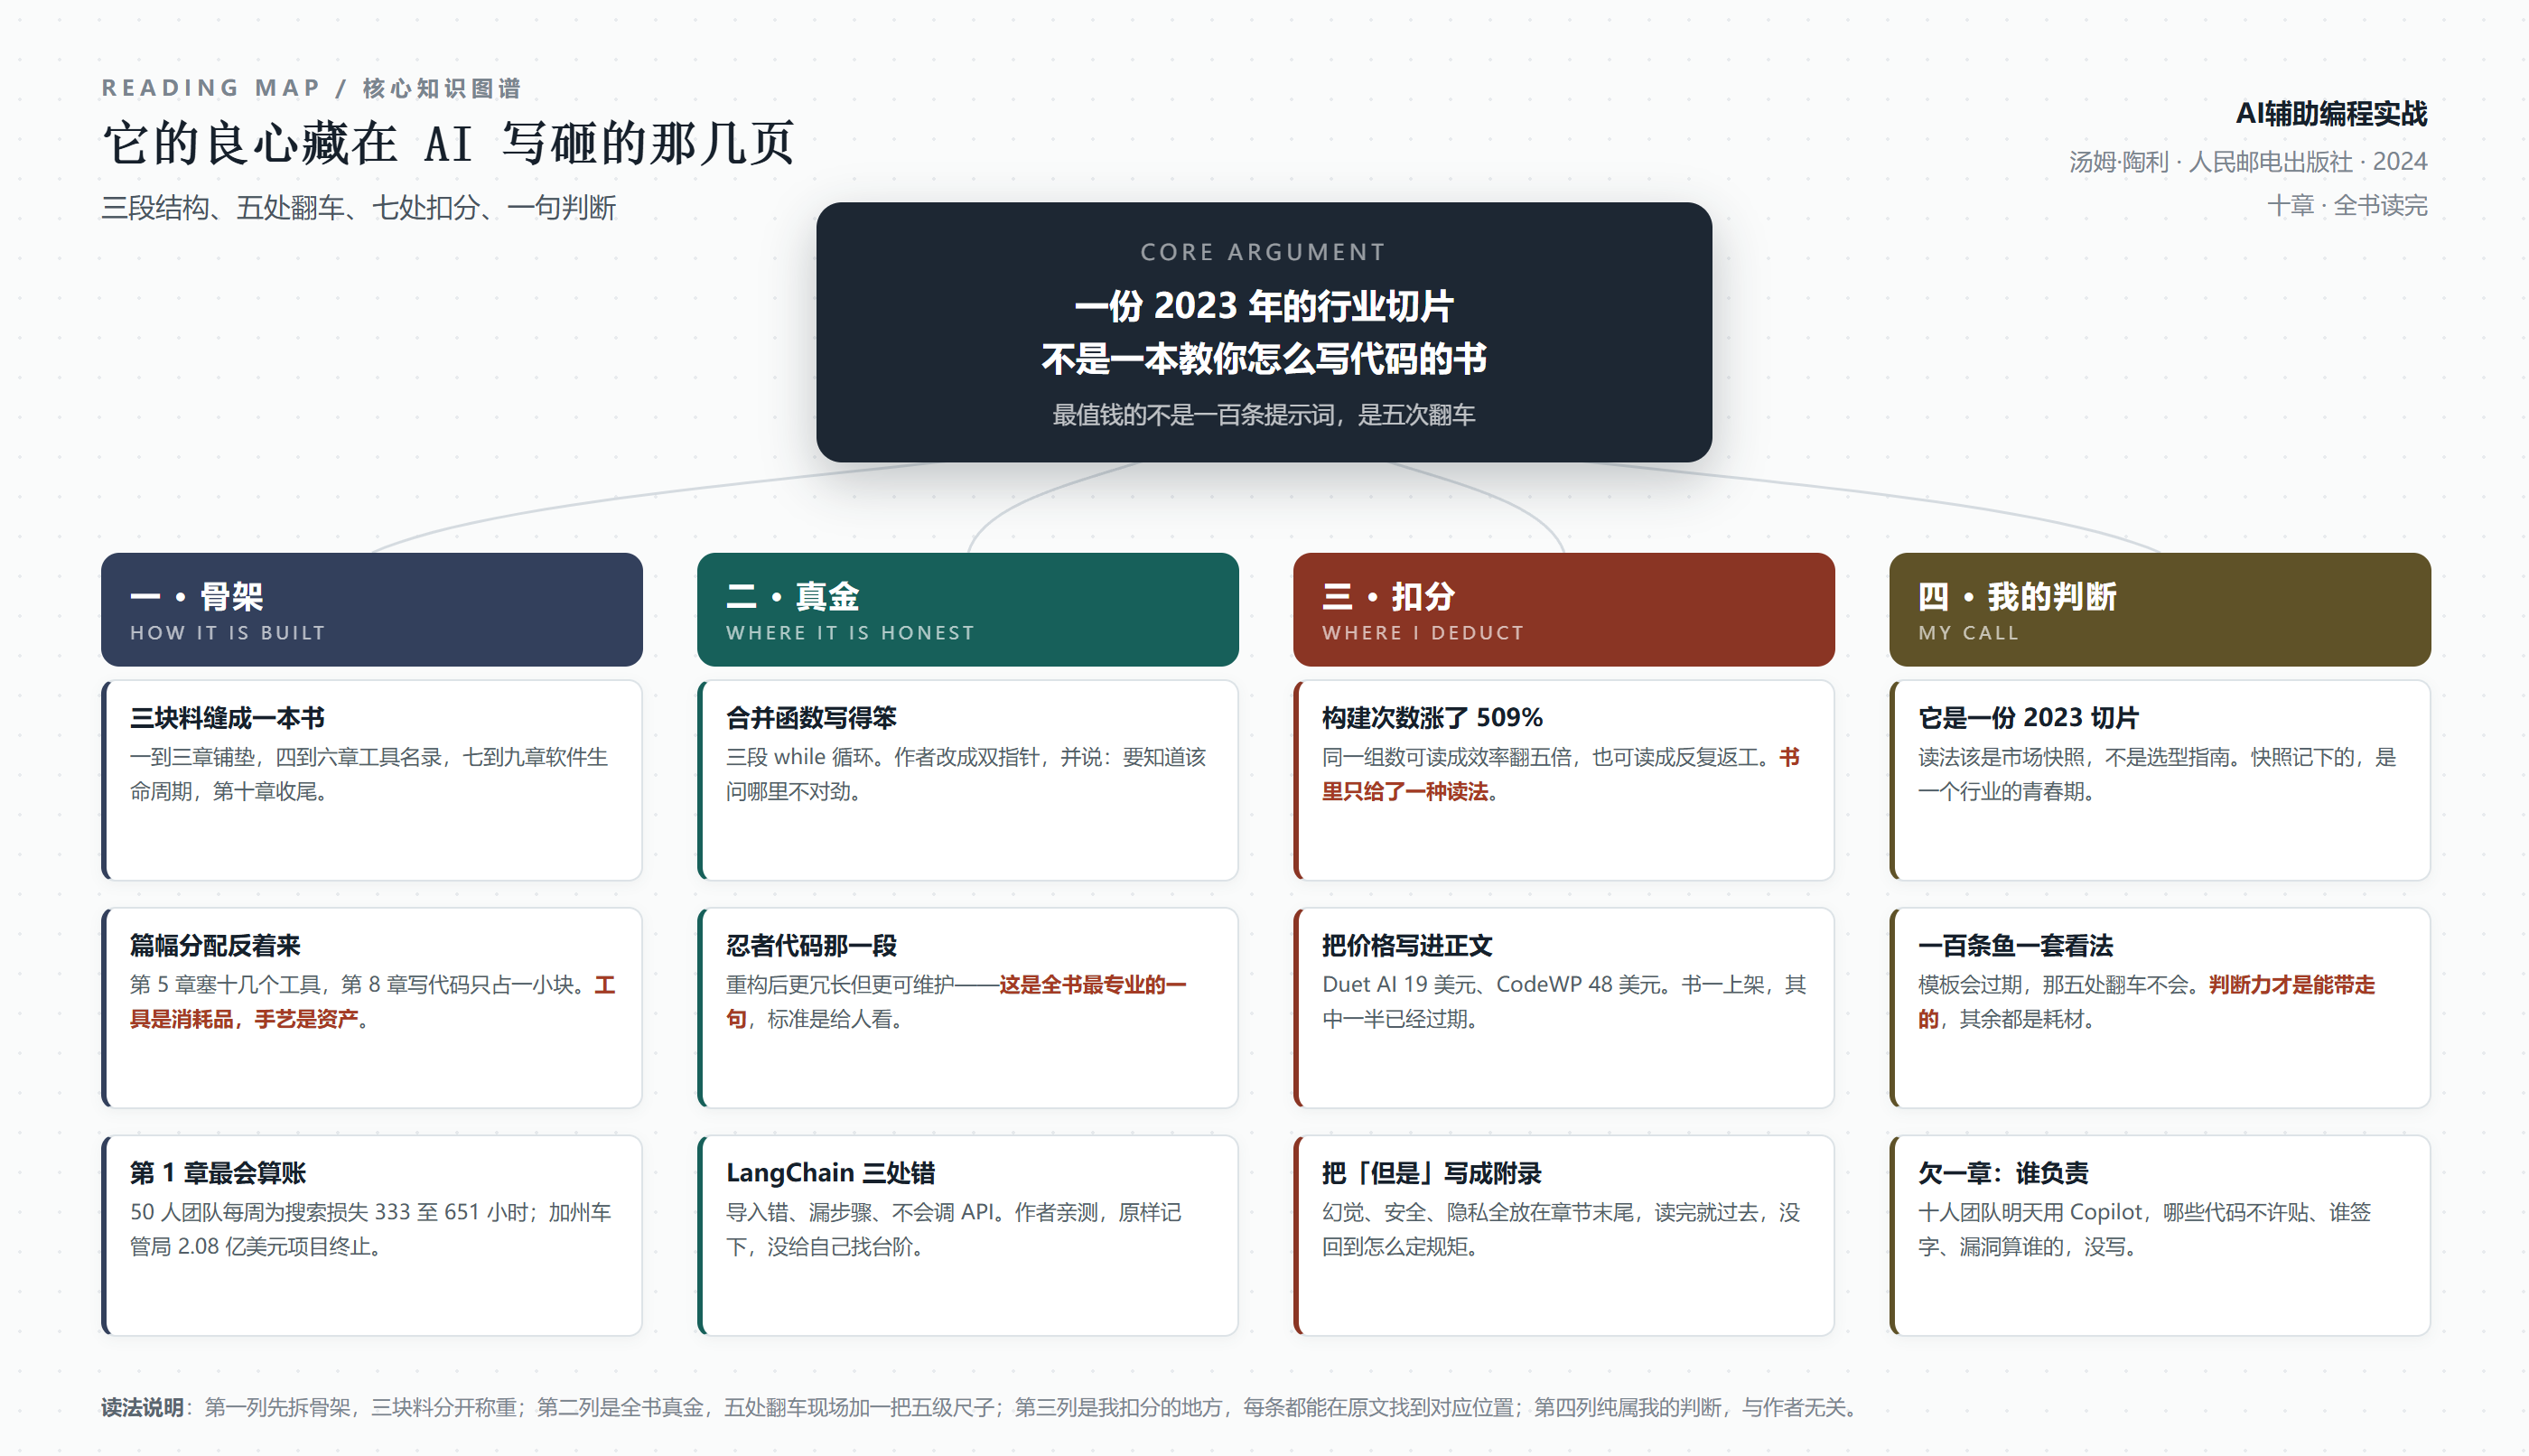
一、十章,其实是三块料缝起来的
先把骨架说清楚,不然没法谈它的轻重。
第 1 到第 3 章是铺垫。第 1 章讲编程语言的抽象史,从机器语言、汇编、Fortran、面向过程、面向对象、脚本语言,一路讲到「AI 辅助编程是抽象化的最新一级」,然后罗列这类工具的七个优点和五个缺点;第 2 章拆技术底子,Transformer、注意力机制、token、温度、Top P、频率惩罚,还有 OpenAI Playground 的实操;第 3 章讲提示工程,把提示拆成上下文、指令、输入内容、输出格式四块。
第 4 到第 6 章是工具名录。Copilot 单独一章,CodeWhisperer、Duet AI、Tabnine、Replit、CodeGPT、Cody、CodeWP、Warp、Bito、Cursor、Code Llama、StableCode、AlphaCode、PolyCoder、CodeT5 挤在第 5 章,ChatGPT、GPT-4、Gemini、Claude 在第 6 章。
第 7 到第 9 章按软件生命周期铺开:需求(头脑风暴、市场调研、PRD、SRS、TDD)、写码(重构、函数、面向对象、样本数据、前端)、交付(调试、测试、部署)。第 10 章收尾。
这三块料的成色完全不同。作者是顾问出身,写「清单」是他的看家本领——第 5 章那种「一家公司一节、一节一张价格表」的写法,他写得很顺;但写「纵深」他不太行,第 8 章标题叫「编写代码」,是全书最该厚的一章,结果一大半篇幅在讲怎么让 ChatGPT 帮你写样本数据和 CSS。真正谈手艺的地方,被稀释了。
第 1 章里倒是有几段值得留。讲「最小化搜索」时,它引了 Stack Overflow 2022 年那份覆盖七万多名开发者的调查,说「有 50 名成员的开发团队,每周因搜索答案或解决方案而损失的时间达到 333 至 651 小时」。这个数字我第一眼是怀疑的,但顺手一算就服了:50 个人,一人一周 7 到 13 个小时在搜,其实是行业常态。它没夸张,是我们平常不这么算账。
讲「现代化支持」那段更有意思。它写 IBM 2023 年 10 月推出 Watsonx Code Assistant for Z,专把大型机上的 COBOL 翻成 Java,背后模型懂 115 种语言、1.5 万亿个 token、约 200 亿参数;然后马上补了一句冷水:把数千亿行 COBOL 迁到现代语言「绝非易事」,失败的例子「屡见不鲜」——加利福尼亚州机动车辆管理局曾投入 2.08 亿美元,几年后不得不终止项目。短短一页里,既有厂商的乐观数字,也有一个 2.08 亿美元的坟。这是这本书写得最好的那种段落:它让两个数字站在同一页上,让读者自己称重。
二、它最值钱的地方,全是 AI 写砸的现场
我要重点讲这一节,因为这是我认为这本书唯一不可替代的价值。
第一个现场,第 8 章,一个写得很笨的合并函数。作者让 ChatGPT 写「合并两个已排序列表」,它交出来的东西是:先分别判断两个列表是否为空,然后用两个额外的 while 循环,把各自剩下的元素一个个追加进去。
这段代码确实正确地合并了两个列表,但它采用了一种烦琐的方法:分别处理空列表的情况,然后使用两个额外的 while 循环来追加每个列表中剩余的元素。
然后作者自己动手,把它改成了一次遍历的双指针写法,并写了一句我读到时停下来想了很久的话:
这正是你的编程智慧真正发挥作用的地方。你必须了解基础知识,并且需要知道在事情不太对劲时应该问什么问题以及对哪里进行探究。
这个例子好在哪儿?它没有停在「AI 也会犯错」这种正确的废话上,它示范了一个可迁移的动作:不是问「AI 写得对不对」,而是问「这段代码交到人类评审手里,会不会被打回」。前者是编译器的活,后者才是工程师的活。
顺手说一句作者没说破的话:他给出的「更好写法」是 sorted(list1 + list2)。在两段都已排序的前提下,归并是 O(n),排序是 O(n·log n)——他为了「简洁」牺牲了复杂度,而且没提这件事。这不是硬伤,但它很能说明这本书的气质:它优先照顾「读起来顺」,不太追究「算起来贵」。
第二个现场,第 8 章讲重构,一段「忍者代码」。作者贴了一段故意写得花里胡哨的斐波那契:一个匿名函数、两个变量、一行 while 里的解构赋值,运行起来是对的,但没人愿意维护。他让 ChatGPT 逐步解释,再重构成清楚版本,然后自己评价说,重构后「可能稍显冗长,但它更易于理解和维护」。「更冗长但更可维护」,这句话是整本书最专业的一句。因为这句话代表了一个工程师的取舍标准:代码是写给人看的,机器只是顺便执行。可惜这种取舍,全书只出现了这么一两次。
第三个现场,第 6 章,作者自己上手试 LangChain。他让 ChatGPT 开必应浏览,然后要求写一个用 LangChain 调 OpenAI API 生成博客和社交帖子的程序。结果是:
虽然 ChatGPT 能够提供基本的 Python 代码结构,这是意料之中的,但它在处理 LangChain 的代码时却出现了问题。ChatGPT 在导入 LangChain 库时犯了错误,并且遗漏了一些必要的步骤。此外,ChatGPT 未能展示如何正确调用 OpenAI API。
这段写得很老实。它没有把失败归因于「提示词写得不好」,也没有马上补一句「多试几次就好了」,它就是记下了三处具体的错:导入错、漏步骤、不会调 API。三处错全在「库的用法」上,全在训练数据追不上的地方。
第四个现场,第 9 章,单元测试。作者引了一位叫 David Lee 的工程师的话,大意是:一般函数让 AI 写测试还行,一旦涉及真实数据库交互和 Docker,情况就完全变了。
第五个现场,第 8 章末尾,删无用代码。这一处我认为是全书最清醒的一段:
生成式 AI 可能未能完全理解代码之间的依赖关系。在 AI 辅助编程工具变得更加成熟之前,应避免使用它们来彻底清除无用代码。
他给的替代方案很务实:用 ESLint、Pylint、RuboCop 这类 linter,用 SonarQube、Code Climate、Coverity 这类静态分析工具。这是他做的少数几次「不给 AI 派活」的决定,而这个决定背后是一个很硬的判断:看不见依赖关系的工具,没有资格做删除。
问题在于位置。这些段落全被放在章节的末尾、小节的尾巴、「注意事项」的格子里。前面是热情洋溢的用例,后面是一句「但是」。这本书的结构性遗憾就在这里:它把「但是」写成了附录。而读者读书的习惯,是读到「但是」之前就合上了。
三、一堆漂亮数字,没有一个交代口径
这本书很喜欢摆数据,摆得也很整齐。我挑几处原文里的:
微软做过一次实验,招了 95 名专业开发者,分两组用 JavaScript 写 HTTP 服务器,「使用 GitHub Copilot 的开发者完成任务的速度比不使用该工具的开发者快 55.9%」。麦肯锡另做了一次,调查四十多名开发者,做代码生成、重构、文档编写三类任务,结论是文档和代码整洁性上「所需时间减少了近一半」,而「对于特别复杂的任务,AI 辅助编程工具的优势并不明显,仅缩短了不到 10% 的时间」。注意后半句,这是全书里最不讨喜、也最可信的一句。
Shopify 的账是这么算的:近 2000 名开发者用 Copilot,70% 认为它非常有用,75% 经常使用,「Copilot 提供的代码建议约有 26% 被采纳」,代码库里「大约 100 万行代码是用 Copilot 编写的」。26% 这个数,比 70%、75% 诚实得多——它说明四分之三的建议是被扔掉的。
埃森哲的账更热闹:450 名开发者试用 6 个月,「Copilot 建议的接受率为 35%,其中 88% 的修改甚至在经过代码审查后仍然有效」;「拉取请求增加了 50%,合并率提高了 159%」;「构建次数增加了 509%,成功率提高了 45%」;「高达 96% 的开发者认为他们从第一天起就取得了成功」。看到这组数,埃森哲决定向全球 5 万名开发者推开。
这些数字单独看都挺唬人,摆在一起就会产生一种「多方研究互相印证」的错觉。但它们其实是四种完全不同的东西:微软测的是「完成任务的速度」,麦肯锡测的是「三类任务各自省了多少时间」,Shopify 测的是「采纳率和满意度」,埃森哲测的是「GitHub 上的行为指标」。样本从 40 人到 5 万人,任务从写 HTTP 服务器到写文档,度量从秒表到后台日志。它们不可能互相印证,只能互相陪衬。
而其中有一个数字,我认为作者欠读者一句注解:「构建次数增加了 509%」。
构建次数是什么?它是代码提交后触发编译、测试流水线的次数。这个数字涨五倍,至少有两种读法:一种是你交付得更多了;另一种是你第一次没编过,改一版再编一次,反复编译才过。同一组数据,可以被写成「效率提升五倍」,也可以被写成「AI 生成的代码要反复返工」。书里只给了前一种读法,连一个「也可能意味着」都没有。
我不认为这是作者故意。更可能的情况是:这些数字是他从各家公司的案例材料里摘来的,而案例材料的天职就是报喜。但一本书的责任,恰恰是把案例材料里没有的那半句话补上。这一节他没补。
还有一个数,作者放在第 2 章的边栏里,很不起眼:据《华尔街日报》2023 年初的报道,每位用户每月在 GitHub Copilot 上的花销超过 20 美元,在某些特定情况下甚至高到 80 美元,作者认为随着基础设施规模化,这个成本会逐年下降。这个数字为什么重要?因为它把「AI 帮你省时间」翻译成了「AI 每月从你账上扣多少钱」,而后面这个数才是能进预算表的。一本书肯在讲原理的章节里塞进账单,说明作者确实是从公司里出来的。
为了不显失公允,得把反面的例子也摆上来。第 7 章讲头脑风暴,作者引了沃顿商学院几位教授在 MBA 创新班上做的一次测试:学生提出十几个产品创意,GPT-4 也做同样的题,用线上购买意向调查打分。平均分上学生 40%、ChatGPT 49%,AI 略胜。但教授们接着只看排名前 10% 的创意——40 个顶级创意里,只有 5 个来自学生,35 个来自 GPT。
这组数据对 AI 是有利的,而且利得有点惊人。作者把它放在「AI 有点用」的位置带过去了,没有往下问:如果 AI 在「想点子」这件事上已经能赢过 MBA 班级,那么工程师的核心竞争力到底搬到了哪里?这本书拿到了能推翻自己结论的数据,却没有用它。这比数据不准更可惜。
四、五级能力模型,是全书唯一一把尺子
第 2 章引了 Sourcegraph 的 Quinn Slack 的一个分级,把 AI 在编程中的能力分成 0 到 5 级:0 级无 AI;1 级代码补全;2 级代码创建;3 级受监督的自动化,AI 能接一个目标、连续做几件事、中途向人请示;4 级完全自动化,不需要人对代码做最终审批;5 级 AI 主导的完全自治,AI 自己设定目标。
作者的落点是:「到目前为止,像 GitHub Copilot 这样的工具大致处于第 3 级。」
这把尺子很好用,因为它把「AI 会不会取代程序员」这种没法吵的问题,换成了「现在的工具在第几级」这种能查的问题。而且它顺手解释了很多现象:为什么 AI 能一口气写完一个函数,却在跨三个文件的重构上翻车;为什么它能修语法错,却要你在逻辑错上盯半天。第 3 级的意思是:它能接活,但每一步都得有人看着。这不是能力不足,这是设计位置。
同一章里还有一组数据,我抄下来了:斯坦福的「基础模型透明度指数」,100 条标准,结论是「目前还没有任何一个主流的 LLM 达到足够的透明度,它们的平均透明度仅为 37%」。三分熟。你每天在用的那个东西,你对它的了解程度是 37%。这个数字比任何一句「AI 有风险」都有说服力。
公平地说,书里也有 AI 表现好的地方,而且好得让人意外:第 9 章讲代码审查,作者故意塞给 ChatGPT 一个写得很烂的函数,它的表现是——指出不该在函数里硬编码数据库连接,指出 SQL 里直接拼用户 ID 有注入风险,还指出这条 SQL 的写法可能有性能问题。三条全中,而且都在「人容易漏」的那一档上。这恰好印证了第 3 级的说法:它看不懂你的系统,但它看得懂模式。硬编码、拼接、缺校验,这些都是模式。
五、它给的是一百条鱼,不是一套看鱼的方法
这本书的体例非常统一:讲完概念,立刻给「提示:……」,然后贴一张 ChatGPT 的回答截图,说「如图 X-X 所示」。全书这样的提示模板,我粗粗数下来上百条。第 3 章是提示工程总纲,第 7、8、9 章每一个小节都配一组。
写得好的有没有?有。比如第 3 章讲「越具体越好」,它先给四个坏例子(「开发一个增强数据安全的功能」「优化这段代码」),再给好例子:
开发一个 Python 函数,用于从字符串中解析日期。该函数应能处理以下日期格式:YYYY-MM-DD、MM/DD/YYYY 和 Month DD, YYYY。它应返回一个 datetime 对象。请提供一个脚本,演示该函数正确处理每种日期格式的至少 3 个示例,并在附带文档中说明任何依赖项、函数中使用的逻辑,以及如何运行该脚本。
这条好,是因为它把「验收标准」写进了提示里:三种格式、各三个示例、返回 datetime、要说明依赖。这不是在「描述需求」,这是在「写测试用例」。能把提示写成测试用例的人,本来就会写代码。
但问题也在这儿。一百条模板,本质上是一百条鱼。而整本书里教人「怎么看鱼新不新鲜」的地方,只有我上面列的那几处翻车。第 3 章其实自己承认了这一点:
对于提示工程,不要期待会有一个一劳永逸的神奇解决方案。市面上的许多课程、视频和图书声称揭示了提示工程的「秘诀」。对此,你需要保持谨慎,否则可能会感到失望。
话说得很对,但说完这句,后面紧接着的还是模板。它承认了「没有秘诀」,然后继续发模板。这就是这类书的宿命:模板能印在纸上,判断力不能。
全书里我认为对「不写代码的人」最有用的一段,反而在第 7 章,讲需求那一节。它让 ChatGPT 出 PRD 的大纲(引言、目标市场、产品概述、功能需求、用户界面、系统功能),出 SRS 的要素清单,还演示了把一张潦草的登录流程图拍下来丢进去,让它读成「已注册走登录、未注册走新用户、密码错回到输入、密码对进邮箱验证」这样一条条步骤。作者自己都夸了一句,说草图上把 password 简写成 pw,它照样认出来了。
这段为什么有用?因为它说明白了一件事:真正决定输出质量的,不是你提示词写得多花哨,而是你心里有没有那张结构图。你要是不知道 PRD 该有哪几节,AI 给你的大纲你就没法判断好坏;你要是知道,你根本不需要它给你大纲。这个道理作者没有明说,但这一节的示例把它演示出来了。
六、产品名录的保质期,作者自己盖了戳
第 5 章我一页页读下来,感觉像在读一份 2023 年的采购比价单。CodeWhisperer 个人版免费、专业版 19 美元;Duet AI 19 美元一月、按年付;Tabnine 免费 / 12 美元 / 企业定制;Replit 免费 / 7 美元 / 20 美元;CodeGPT 高级版 49.99 美元;Cody 免费 / 9 美元 / 19 美元;CodeWP 18 美元 / 48 美元;Warp 免费 / 12 美元 / 企业定制;Bito 免费 / 15 美元;Copilot 个人 10 美元、商业 19 美元、企业 39 美元。
这些价格,在 2024 年 10 月这本书摆上书架的时候,有一半已经不对了。Duet AI 正在往 Gemini 的品牌里并,CodeWhisperer 正在变成 Amazon Q Developer,Cursor 从「融资 800 万美元的小工具」变成了很多人日常写代码的主界面——书里给它的篇幅是半页。
作者其实知道工具会变。他在第 2 章就写过一句很清醒的话:「表 2-1 中所列的功能并不是一成不变的。」但他没把这句话用在第 5 章的价格表上。一本书把价格写进正文,就等于给自己的保质期盖了一个戳。
这不是刻薄话,是读法建议:这一章应该读成「2023 年的市场快照」,而不是「选型指南」。快照有价值——它记录了一个时刻:那时所有人都在比「谁的补全更准」,还没人比「谁的智能体更能自己跑完一个任务」。三年后再看这一章,你看到的不是工具,是一个行业的青春期。
七、它的短板
这本书的优点和缺点是同一件事的两面:它太像一份顾问报告了。顾问报告的长处是齐整、可查、有案例;短处是不下判断、不担风险、结尾一定要写「前景广阔」。具体到这本书,我扣这几处:
第一,结构失衡。第 5 章把十几个工具塞进一章,每个工具给一节加一张价格表;而第 8 章「编写代码」——真正的手艺——只用了不到全书十分之一的篇幅讲重构和函数设计。工具是消耗品,手艺是资产,这本书的篇幅分配反过来做了。
第二,数据只给一种读法。前面说过,「构建次数增加 509%」这种数字,作者照抄了,没拆。全书几十组数字,几乎全部来自供应商和咨询公司的案例材料,没有一处标注「这是厂商自报」。这不是学术著作,不该要求它做文献综述;但一本给工程师看的书,至少该告诉读者「这个数是谁算的」。
第三,所有警告都在章节末尾。幻觉、知识产权、隐私、安全、偏见,第 1 章就列了五条,每条都写得不错——比如它引了一项研究,审查 GitHub 上 435 个项目里 AI 生成的代码片段,发现 35.8% 存在通用缺陷枚举(CWE)实例,跨 42 个类别,其中 11 个进了 2022 年的 CWE Top 25。这个数字很硬。但它被放在「缺点」一节里,读完就过去了,后文再没回到「那团队该怎么定规矩」这个问题上。
第四,缺一个真问题:谁负责。知识产权它提了 Matthew Butterick 起诉微软、GitHub 和 OpenAI 的案子;安全它给了 35.8%;隐私它举了 Gridspace 宁可自研也不用第三方平台的例子。三件事都提到了,但都是散点。它没有把这三件事合成一个工程问题:一个十人团队,明天开始用 Copilot,应该定哪几条规矩?哪些代码不许贴进对话框?生成的代码谁签字?出了漏洞算谁的?《AI 辅助编程实战》这个书名,欠的正是这一章。
第五,结尾退化了。这本书在第 1 章说过一句我很欣赏的实话:谈到「10 倍开发者」,作者写「很抱歉,可能不会」,还说这个概念「会激起刻板印象和偏见」。这是清醒的。可到了第 10 章结尾,笔调变成了「AI 引领的编程新纪元,未来必定璀璨夺目、潜力无穷」「让我们一同乘上 AI 创新的巨轮」。同一本书,前面在拆神话,后面在放礼花。这不是作者一个人的错,是这类书的通病——最后一页总要交给出版社的营销部过一遍。
第六,有一处它自己没意识到的自相矛盾。第 10 章说「如果你不使用 AI 辅助编程工具,你可能会落伍」,理由不是「AI 会取代你」,而是「雇主希望你会用」。这句话是整本书里最像现实的一句,也是最不像技术判断的一句。它把「该不该用」从技术问题换成了就业市场问题,然后就不再往下问了。
第七,时效。2023 年的工具、2023 年的价格、2023 年的能力水位。第 5 章尤其明显。这不是它的错,但读者得知道。
八、一句话
这本书像一位很会做尽调的顾问:他给你列了十几家供应商的报价、二十个客户的证言、还有五次现场翻车的记录。翻车记录是全书最值钱的部分,因为只有那几页,他不站在任何人那边。
至于三年后哪家供应商还在,他没说,因为他也不知道。
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: