
具身智能数据工程:一本敢给数、但还没给尺子标单位的工具书
这次读的是《具身智能数据工程:标准、技术与实践指南》,夏轩、俞波、刘少山著,人民邮电出版社 2025 年 7 月出版(ISBN 9787115672704),推荐序出自清华大学计算机系刘华平教授。全书九章:前三章讲概念、理论、采集系统架构,第四章讲数据标准,第五、六章讲真实世界采集与仿真生成,第七、八章分别落到工业和服务业,第九章介绍作者团队自己的数据生产平台 AIRSPEED。全书读完了。
说明:这不是一本观点书,是一本工具书。所以我看它的标准也不一样——不看它说得漂不漂亮,看它给的东西能不能直接拿去用、拿去的数字能不能核。加引号的句子都可以在书里找到原话,我不复述目录。
这本书做对了一件事:把「具身智能缺数据」这句正确的废话,拆成了一份能排期、能报价、能验收的工程清单。这是我读过的国内同类书里最像工程手册的一本。
但它自己也没接住最后一棒。第 2 章它把「评估空白」列为三大数据瓶颈之一,第 4 章给出的验收标准,是一张没有出处的数字表。
它讲的不是模型,是模型的粮食
全书的起点不是技术,是一笔账。作者在序里算:互联网行业每用户数据估值约 600 美元,全球约 50 亿用户,合起来 3 万亿美元;具身智能这边,马斯克说未来机器人数量会超过人类,假设饱和时 100 亿台、单台成本 3.5 万美元、机器人企业愿意拿每台成本的 3% 投到数据采集和生成,于是算出「具身智能数据的市场价值将超过 10 万亿美元,这将是互联网行业用户数据价值的 3 倍多」。
这个算法的毛病不在乘法,在三个假设。机器人数量超过人类、单台 3.5 万美元、3% 投入——三个数任取一个换成保守值,结论就从「十倍于互联网」跌回「和互联网一个量级」。3% 尤其悬,它既不是行业均值,也不是任何调研的结论,书里没交代从哪来。作者紧接着自己也说「目前具身智能数据采集和生成行业尚处于起步阶段」:一个刚起步的行业,先算出一个十万亿美元的成熟市场,这是这本书最常见的一种写法,用终局估值论证当下的必要性。
好在它没有停在这一层。第 2 章换了一套朴素得多的说法:ChatGPT 能靠 570 GB 文本训出来,是因为文本是人写的、网上现成的;机器人数据不行,它得多模态,得在物理世界里一次一次做出来。这一句比十万亿美元有用。
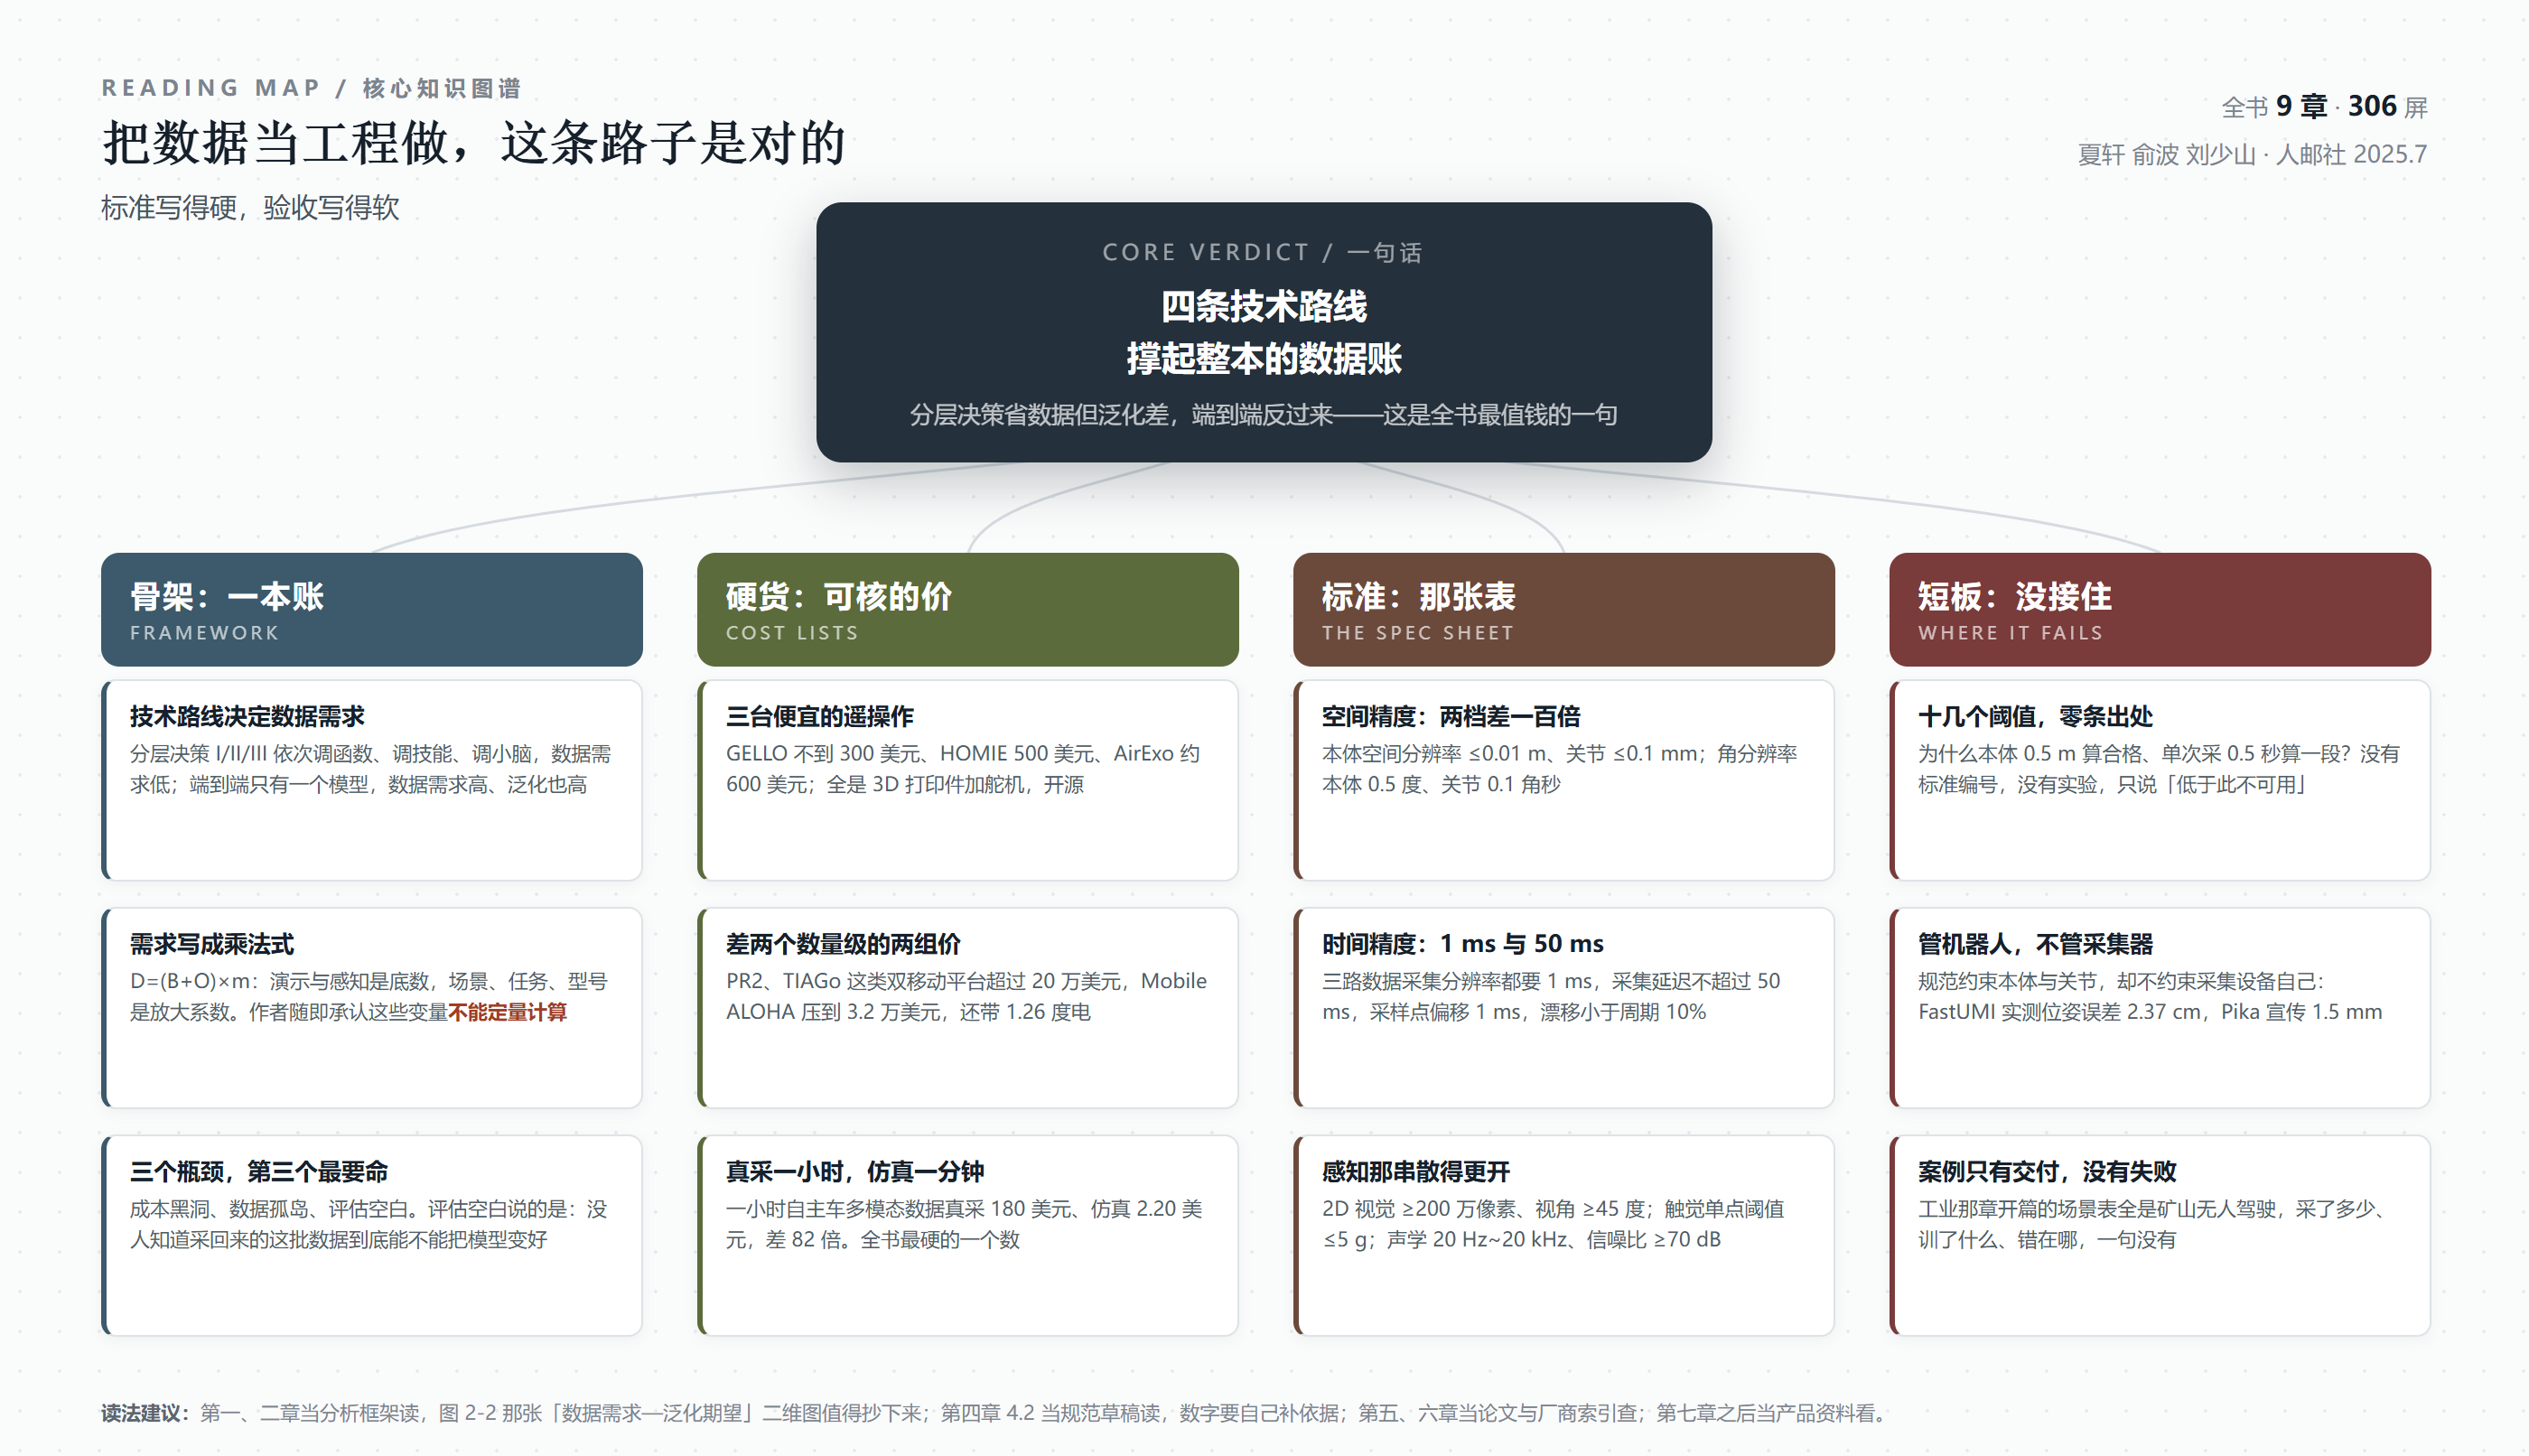
后面紧跟着的那组对比,是全书最锋利的一刀:一小时自主车多模态数据的真实采集成本是 180 美元,仿真环境里生成同样的数据只要 2.20 美元。差 82 倍。一个数量级以上的差距,直接把「要不要上仿真」从路线之争变成了算术题。
四条技术路线,决定你要多少数据
第 2 章有一张图,我建议每个做具身智能的人都抄下来。它把具身智能分成四条技术路线:
分层决策 I,一个大脑负责推理规划,调用机器人的函数 API——定位导航、位姿估计、轨迹控制这些已经写好的函数,大脑必须精确控制每一个变量,容错范围窄。分层决策 II,大脑调用的是技能 API,导航、抓取被封装成模块,大脑不必给出精确参数。分层决策 III,大脑调用小脑 API,小脑负责全部运动规划与控制,相当于「所有技能的集合」。第四条是端到端,一个大模型直接从传感器输入输出动作,中间没有 API。
四条路排成一条斜线:越往左,数据需求越低、泛化期望越低;越往右,数据需求越高、泛化期望也越高。作者的结论是:分层决策适合任务明确、模块化的场景,每个模块可以独立训练,数据压力小,但换新任务新环境时泛化受限;端到端要学从输入到输出的整个映射,数据需求极高,但理论上能捕捉更广的模式,泛化可能更好。
为什么这个判断值钱?因为它把「要不要采数据、采多少」从信念问题变成了选择题。你选了分层决策 I,就得把每个函数调到能容错,数据压力小,代价是换场景要重调;你选了端到端,压力全压到采集端,换来的是跨场景的泛化期望。这本书后面所有的成本讨论、采集方案选型、仿真讨论,都挂在这条线上。有了这条线,「我们该采多少数据」就不再是一个可以拍脑袋的问题。
但它这条斜线画得太顺了。数据需求和泛化能力不是同一个变量,把它们排成一条对角线,等于默认「数据越多、泛化越好」。现实里端到端模型吃了一百多万条轨迹、换个桌面就崩的例子不少,问题出在数据分布,不在数据量。书里在后面讲「数据孤岛」的时候其实就是在讲分布问题,但它没有回头修正这张图——图在第 2 章开头,孤岛在 2.4.2 末尾,隔了几页,两件事没有接上。这是全书最可惜的一处「差一步」。
把需求写成公式,然后承认它算不出来
接着它把数据需求写成了一个式子。设具身智能总数据需求期望为 D,大脑需求 B、小脑需求 O、型号数 m,作者给出 D=(B+O)×m,再展开成 B+[(a+p)×s+l]×t 再乘 m:a 是人类演示量,p 是机器人感知数据,s 是场景数,t 是任务数,l 是人类语义标注。
然后 2.4.2 的第一句是:「式(2-2)中的各个变量的值并不能定量计算得到,因此式(2-2)仅是对具身智能总数据需求期望的一种定性描述。」
这句坦白很诚实,诚实到把前面整页推导变成了摆设。一本讲「工程」的书,写出一个所有变量都取不到值的公式,它的作用只剩一个:告诉你哪些变量在乘法位上,哪些在加法位上。
而这个作用是真的。底数(人类演示、机器人感知)涨一点,D 线性涨;系数(场景、任务、型号)涨一点,D 成倍涨。所以钱该往系数上压——多采几个场景、多覆盖几种任务、多上几个型号,比在同一个场景里多录一百遍划算。这个结论不写公式也能讲,但公式能让它变成一句可以拿去开会的话。
我的看法:这是全书「学术腔」和「工程腔」打架最明显的地方。它想用数学立信,又怕被追问数值,只好先写式子再自我否认。其实这一节完全可以改写成「三个乘法因子」,效果一样,还不用让读者背一个算不了的公式。工具书里最忌讳这种东西——读者会以为是自己没看懂。
写完公式,作者马上把话头转向了更要紧的地方。2.4.2 一上来就是三个瓶颈:成本黑洞、数据孤岛、评估空白。
前两个好理解。成本黑洞是采数据贵,设备、场地、维护、长期人力都算进去。数据孤岛是采出来的数据格式不统一,不同设备、不同采集方式之间不通用,大多数机构只能在特定受控环境里采,数据只够提供有限的泛化能力。
第三个才是这本书真正的洞察:「难以评估当前数据是否能有效提升数据集价值。数据采集过程中缺乏标准和理论指导,可能导致盲目采集和资源浪费。」
翻成大白话:你不知道你花三个月采的这批数据,到底能不能让模型变好一点。这在别的行业有个更直白的名字——没有验收标准。在数据采集这行,它意味着所有投入都是先花钱、后赌。
我读到这里是服气的。这句判断把行业最尴尬的地方说穿了:大家都在比谁采得多,没人能说清楚采到什么程度算够。
但往下读,第 4 章给规范的时候,它填的是另一件事。
第 4 章那两节,是全书最该被抄走的部分
4.2.1 回答的是「一个数据集里该有什么」。它要求数据结构做金字塔分层:顶层可以是机器人型号,第二层场景,第三层任务,第四层执行次数;也可以把场景放顶层、型号放第二层,规则不固定,但必须选定一种。然后逐层列字段——型号数据要硬件型号与版本、软件型号与版本、URDF 描述文件;场景数据要场景分类(室内室外、草地沙地、白天黑夜、光照与天气)、地图、各传感器内参外参标定;任务数据要任务内容(可以是「把苹果放进冰箱」这样的自然语言,也可以是 Move <Object> to <Place> 这样的模板)、任务分类、本体与各关节的初始位姿、操作对象的类别与状态;执行数据要带时间戳的本体位置速度角度、关节位置速度受力、以及(可选的)大模型版本、部署方式、推理延迟、执行状态变化。
一份机器人数据集该长什么样,这一节基本说全了。这不是观点,是可以直接改成公司内部字段表的东西。
4.2.2 给的是数字。我把它们抄在下面,因为这一节值得被抄:
角分辨率:本体 ≤0.5 度,各关节 ≤0.1 角秒
视觉:2D 感知 ≥200 万像素,本体与末端视角 ≥45 度
定位误差:本体 ≤0.5 m,关节 ≤1 mm;角误差本体 ≤3 度,关节 ≤1 度
深度:0.5 m 内误差 ≤2 cm;20 m 内点云 ≥10 点每平米,角分辨率误差 ≤0.5 度
时间:单次采集 ≥0.5 s;本体、关节、传感器三路分辨率都 ≤1 ms;系统时间同步误差 ≤1 s;采集延迟 ≤50 ms;采样点偏移 ≤1 ms;漂移小于采样周期的 10%
触觉:单点压力阈值 ≤5 g,空间定位误差 ≤0.5 mm
声学:20 Hz~20 kHz,信噪比 ≥70 dB,采样率 ≥44.1 kHz
温度:-20 到 80 摄氏度内 ±0.5 摄氏度,热响应 ≤3 s
并且它给了一句硬话:「该基本指标规范应当被视为采集数据的质量下限,低于该基本指标规范的数据应当被视为不可用。」
「不可用」三个字的重量在于,它不是建议,是判死。一本行业书敢写出这种判死条款,说明作者确实想推标准,不想和稀泥。
然后是这本书记得最清楚的一处裂缝:这十几个数字,一个出处都没有。没有引国标,没有引 ISO,没有引任何测量学文献,也没有说「这是我们实测得到的经验值」。为什么本体给 0.01 m、关节给 0.1 mm,差一百倍,依据是什么?为什么本体定位误差 0.5 m 就算合格——0.5 m 的误差,机器人连杯子在桌上哪个位置都说不准;为什么单次采集 0.5 s 就算一段有效样本,而「抓起来放进抽屉」这种任务至少要三秒?
我不是说这些数字错了。我是说它没有给出让人信的办法。而这一章前面刚批评过行业「评估空白」,后面就用一张没依据的表来填这个空白——这是这本书最需要被追问的地方。一份判死的表,如果它的依据也是拍出来的,那它判的就不是数据,是嗓门。
第 5 章是写得最好的一章,好在它报了价
第 5 章讲真实世界怎么采数据,分两大类:遥操作(位姿类、视觉类、光惯类)和示教(直接示教、间接示教)。技术分法各家书都差不多,这一章真正稀罕的是,几乎每个系统后面都跟着一个价。
GELLO,加州伯克利做的,用与目标机器人相同的运动学结构做一个小号控制器,3D 打印件加经济型伺服电机,单个设备物料成本不到 300 美元。HOMIE,上海人工智能实验室的人形同构外骨骼,7 自由度手臂、15 自由度感应手套、加一个控制行走的踏板,硬件成本 500 美元,姿势采集频率 200 Hz。AirExo,上海交大与上海 AI 实验室的可穿戴外骨骼,总成本约 600 美元,主要靠 3D 打印,角度编码器分辨率 0.08 角秒。Mobile ALOHA,斯坦福的移动双臂平台,整机 3.2 万美元,含 1.26 千瓦时电池和一台 3070 Ti 笔记本。作为对照,书里说 PR2、TIAGo 这类双移动操作平台通常超过 20 万美元。
四个数放在一起,就是这一章的论点:遥操作设备的门槛已经从二十万美元级掉到三百美元级,中间隔着两个数量级。四位数和六位数之间的差别,不是「贵一点」,是「这个实验室到底能不能开始」。
它还给了几条效率数据,我挑三条。UMI 用 12 小时、3 名演示者、30 个不同环境,采到 1400 个演示;在「杯子排列」任务上,UMI 夹爪的采集速度是传统遥操作的 3 倍以上,达到人手演示的一半左右。DexCap 只采 30 分钟人类演示,「海绵抓取」成功率 85%、「球采集」60%。最扎人的一条是「剪刀剪切」:做 30 次人类在环修正,成功率从 0 提到 45%。
最后这条其实是对「数据量崇拜」的反驳——0 到 45%,靠的不是更多数据,是人在环纠错。作者把这条写出来了,但没有往下推,一句「人类在环修正显著提高了任务成功率」就带过去了。这是全书最好的一颗钉子,钉进去半寸就收手了。
这一章还有一处自我矛盾,是作者自己标出来的。AirExo 那段末尾写着:「需要指出的是,研发人员认为 AirExo 是一种同构类遥操作系统,而不是一种可穿戴遥操作设备。在本书中,由于其显而易见的特性,为了不引起读者混淆,依然将其归类为可穿戴遥操作设备。个中差别,请读者自行判断。」
我欣赏这个坦白,但它同时暴露了分类的问题:这套分类(位姿、视觉、光惯;手持、可穿戴、同构)是按「设备长什么样、用什么感知」切的,不是按「采到的数据质量怎么变」切的。所以同一个设备天然会落在两类之间,作者只能用「读者自行判断」收场。如果分类改成按「位姿精度 + 自由度覆盖 + 是否闭环」来切,AirExo 该站哪一队不会有争议。工具书里,分类体系本身就是产品;一个需要读者自行判断的分类,等于少了一个功能。
更要紧的是本章最后那张表。表 5-1 叫「不同真实世界数据采集方法比较」,七列:数据质量、成本、操作员要求、采集效率、数据多样性、设备依赖度、机器人兼容性;九行是各类方法,从手持类一直排到人类视频演示学习。整张表的每一格,填的都是「高」「中」「低」,偶尔一个「中高」或「无」。
七个维度乘九种方法,六十三个格子,没有一个数字,没有一句评分依据,也没有说这个分数是谁打的、按什么标准打的。比如「直接示教」一行是低、低、低、低、低、无、低——七列全低,只有设备依赖度是「无」。这个判断我大致同意,但它凭什么成立?是作者实测过,还是读过别人的对比实验?书里没给。一张全靠语感定级的表,放在一本批评行业「评估空白」的书里,几乎是自我指涉。
还有一句在 5.3 小结开头:「限于篇幅,还有部分数据采集技术未能在本章详细介绍,如用于灵巧手数据采集的遥操作外骨骼系统 ACE、用于人形机器人数据采集的视觉类遥操作系统 HumanPlus、用于人形机器人数据采集的光惯类遥操作系统 OmniH2O 和 Mobile-TeleVision。」四个系统,一句话带过。一本专门讲采集的书,用「限于篇幅」省掉四个同行方案,却肯花整章讲自家的平台——这个取舍,读者心里得有数。
第 6 章两个反直觉的结论,比前面五章都值钱
第一个:数字表亲比数字孪生更容易迁移。
书里讲斯坦福那条线。数字孪生是把真实场景一比一复制进仿真,精度高,但生成成本高,而且无法跨域泛化——你复制了这间厨房,换个厨房就得重做。数字表亲(Digital Cousin)不追求像,只保留高级几何与语义功能:它不明确模拟真实世界的对应物,但「仍然展现类似的几何和语义功能」,所以可以为一个真实场景生成多个不同的虚拟场景。ACDC 就是干这个的:从一张 RGB 图出发,提取物体、从资产库里为每个物体匹配「表亲」、再把它们编译成一个物理上可行的可交互场景。结果是零样本从仿真迁到真实,数字表亲策略成功率 90%,数字孪生策略只有 25%。
这个结论反直觉在哪儿?我们默认「越像真的越好」。它说不是。太像真的,模型学到的可能是这间屋子,包括那盏灯的角度;不那么像、但功能一致的多个版本,反而逼模型去学「把手是用来抓的」这件事。这是全书对我认知改动最大的一段,也是我读完唯一一个立刻想转给别人看的结论。
第二个:MimicGen 与 DexMimicGen。前者用约 10 个人类演示生成 1000 个;后者从 5 个源演示生成 1000 个双手演示,书里给的效果是「抽屉整理」成功率从 0.79% 升到 76.0%,「穿线」从 1.3% 升到 69.3%。
这里我得泼一盆水。0.79% 和 1.3% 这样的起点说明什么?说明基线基本不会做这个任务。从「完全不会」到「会一点」,任何有效的数据增强都能拿到这个量级的跃升,它证明的是「这方法有用」,不是「这方法比别的强多少」。书里没有给同任务的对照组数字,也没说这 1000 个演示要跑多少次仿真、失败率多少。MimicGen 自己的数据生成成功率低到 21.6%,这个数字它写了,但写在「尽管……但训练出的智能体成功率仍然很高」这个从句里。
顺带记一个数:Genesis 平台号称单张 RTX 4090 跑出 4300 万帧每秒,「比实时快 430,000 倍」。4300 万除以 43 万等于 100——它把「实时」定义成了 100 帧每秒。这个基线怎么定的,书里没说。
后面三章:一个模板用了三遍
第 7、8 章是工业和服务业的数据采集需求,第 9 章是作者自己的平台 AIRSPEED。这三章是全书的「实践」部分,也是它最容易露怯的地方。
先说第 7 章。开头很讲究,拿 GB/T 4754—2017《国民经济行业分类》把边界划清楚:工业对应第二产业,包括采矿、制造、电力热力燃气及水生产供应、建筑四个子领域;其余全算服务业。拿国标定边界,这是标准该有的做法。
但落到 7.2「数据采集需求」,四个子领域用的是同一个四段模板:感知数据、轨迹数据、任务规划数据、资产数据。采矿那节还好,讲到了矿区地形坡度、岩石硬度、瓦斯浓度、塌方震动信号这些具体的东西。到了制造业和建筑业,模板就开始自己抄自己了:
制造业写「操作轨迹:记录机器人在完成任务时的运动轨迹,包括关节角度、速度、加速度等信息。例如,在焊接任务中,机器人需要按照预设的轨迹进行焊接,以保证焊缝的质量」;建筑业写「操作轨迹:记录机器人在完成建筑任务时的运动轨迹,包括关节角度、速度、加速度等信息。例如,在砌砖任务中,机器人需要按照预设的轨迹进行砌砖,以保证墙体的平整度」。
制造业写「环境交互轨迹……例如,在物流仓库中,机器人需要根据货架的位置和货物的分布,规划最优搬运路径」;建筑业写「环境交互轨迹……例如,在建筑工地上,机器人需要根据施工现场的布局和障碍物,规划最优的搬运路径」。
制造业写「物体属性数据:包括物体的形状、尺寸、重量、材质等信息。例如,在搬运任务中,机器人需要根据物体的属性,选择合适的抓取方式和搬运策略」;建筑业一字不差,也是这句。
「设备状态数据:涉及机器人自身和周边设备的状态信息,如设备的运行时间、维护记录、故障情况等。例如,在设备维护中,机器人需要根据设备的状态,及时进行维护和修理」——这句也是两节各一份。
第 8 章把这件事做到了极致。8.2 分五节:家庭、商业、医疗、教育、公共服务,每节四个小标题,加起来二十条。其中「运动轨迹数据」这一条,五节各写一遍,差别只有中间那个场所名:家庭环境、商业环境、医疗环境、教室、复杂环境。「帮助机器人学习如何在××环境中安全、高效地移动和操作物体」——这句话出现了五次。「平衡与稳定数据……避免摔倒或碰撞」五次。「情感识别与响应数据:记录机器人识别用户情感状态的过程和响应方式」也是五次。
一章二十条,去掉重复的模板句,真正属于「这个行业特有」的信息剩不下几条。医疗服务机器人最该讲的术前无菌边界、术中力反馈精度、器械与组织的接触模型,一句没有;教育机器人最该讲的儿童安全距离、课堂噪声下的语音识别,也一句没有。它们被同一个模板吃掉了。
我不能确定这是作者的写作习惯还是排期压力。但读者买的是「标准、技术与实践指南」,翻开指南发现同一句话印了五遍、中间换了个名词,这个体验很难说是指南。
第 9 章讲 AIRSPEED,反而是这三章里信息密度最高的。它的设计是三接口三服务:遥操作接口、机器人接口、仿真接口;数据采集服务、数据生成服务、数据集构建服务。三个接口都是 ROS 2 或 DORA-RS 的通信节点,靠配置文件适配不同设备——这个思路是对的,把「换设备就要重写采集软件」变成「换设备就改一个 yaml」。
它给了几个工程上很实的数:传感器数据流从 800 B/s(只采运动数据)到 246 MB/s 不等;分频器按采样率把数据切成 0.01~10 Hz、10~100 Hz、100 Hz 以上三档,分别用不同的压缩与关键帧策略;关键帧选择率可以压到 2% 而训练性能相近;压缩比最高 50 倍、吞吐 296 MB/s;单机器人数据流能压到 30 MB/s 以下。还有一个 ROS 2 与 DORA-RS 的延时对比:5 MB 的数据包,ROS 2 的延时大约是 DORA-RS 的 100 倍;超过 250 MB,ROS 2 直接传输失败。
然后是它的实验。表 9-2 到表 9-5,一共四组:光学惯性遥操作采 20 个样本,数据集构建加速 23.5 倍;虚拟遥操作生成 20 个样本,加速 7.67 倍;ACT 数据飞轮 50 个样本,真实数据集构建 35.62 倍、数据生成 1.2 倍、合成数据集构建 3.5 倍,整体 6.01 倍;并行度实验里,16 路并行时合成效率 3.04 秒每样本,相对人类遥操作的加速比 6.56。
这些数我信一半。信的那一半是:手工整理数据集确实慢,慢到平均要 926 秒,而 AIRSPEED 在采集结束 26 秒后就构建完了——这个对比只要是做过数据整理的人都认。不信的那一半是:样本量。20 个、50 个样本,一台 myCobot Pro 630,一张室内桌面,抓水果或者搬方块,3 名操作员。用这个规模去支撑「通用数据生产平台」这个定语,太薄了。作者自己也写了「受限于遥操作的原理,AIRSPEED 并不能减少数据采集过程的耗时」——这句诚实救了这一节,它说明加速的是「整理」,不是「采集」。
还有表 9-1,一张 AIRSPEED 与 PATO、MimicGen、EmbodiedCity、Habitat 3.0、Robo-G9 的兼容性比较。结果是 AIRSPEED 六项全勾,其余平台各有几个叉。这张表的问题不在于真假,在于出题方式:它比的维度是「支持几种采集方式、几种生成方式」,而 AIRSPEED 的设计目标就是「全都支持」,MimicGen 的设计目标只是「轨迹合成」。拿通用平台去和专用工具比覆盖面,赢了也不说明什么,就像拿瑞士军刀和螺丝刀比谁功能多。
它的短板
第一条,也是最要紧的一条:第 4 章那张指标表,没有出处。
十几个阈值,一条引用都没有。不引国标、不引 ISO、不引论文,也不说是实测经验值。这在一个连推荐序都要强调「标准」的领域里,是硬伤。标准之所以是标准,是因为它可以被追溯、被复核、被争议;一张只能被遵守、不能被追问的表,是规矩,不是标准。
第二条:规范管了机器人,没管采集设备。
4.2.2 约束的是机器人本体和关节的定位误差、角分辨率、传感器时间分辨率。但数据是从采集设备来的——遥操作手柄、动捕服、外骨骼、手持夹爪。这些设备自己的位姿误差,规范里一个字没有。第 5 章恰好给了两个数:FastUMI 用 Intel RealSense T265 取 6 自由度位姿,对照动捕系统测得的平均位置误差是 0.0237 米;松灵 Pika 宣传的位姿精度是正负 1.5 毫米。两者差了一个数量级还多。如果采集器本身偏了两厘米,后面所有关于关节 1 毫米的精度要求都成了空话。这是全书最大的漏项,也是它最该补的一节。
第三条:说行业「评估空白」,它给的尺子只量广度不量深度。
第 9 章 9.1.3 推了一个指标,P = e × s × t × m,即执行样本数 × 场景种类数 × 任务种类数 × 机器人型号数,用来「评估一个数据集的性能潜力」。这算是给第 2 章的「评估空白」交了一份作业,值得肯定——它至少把「数据集好不好」变成了一个可以算的数。
但这个数只能排序,不能判断。四个整数相乘,量纲是混的:样本数和型号数乘在一起是什么意思?而且它是单调的——只要往里灌样本,P 就涨。一个「越大越好」的指标,最终一定会把采集团队推向堆量,这恰恰是作者自己在第 2 章批评的「盲目采集和资源浪费」。
第四条:第 10 章那六个「局限性」,没有一条是它自己的。
第 10 章列了六条:传感器精度与稳定性、环境变化、多模态融合与协调、实时性与响应速度、跨平台兼容性、数据标注与质量控制。六条全是真的,六条也全是行业共有的。通篇的句式是「需要研发……」「需要制定……」「可以采用……」,没有一句是「我们的平台目前做不到……」。唯一一处自我设限在 9.1.4:AIRSPEED 不支持具身问答数据集和基准数据集,因为它们与仿真平台强相关。这一句藏在一堆「都支持」里,反而是全书最可信的一句。
第五条:一万亿那个数,一路用到了最后一页。
第 10 章开头又写了一遍「预计其数据市场的价值将超过 10 万亿美元,达到互联网行业的 3 倍」。序言里由三个假设乘出来的数,到收尾成了不加限定的事实。这不是数据错误,是论证纪律的问题:一个自己标了「假设」的估算,不该在四百页之后变成结论。
第六条,编校。第 5 章末尾说「限于篇幅」省掉 ACE、HumanPlus、OmniH2O、Mobile-TeleVision 四个系统,第 8 章却用五节把同一句话写了五遍。篇幅是有限的,只是分配得不太像一本讲采集的书。
说完这些,我还是愿意把它放在这一行里最该读的三本之一。因为它的长处不是「全」,是「敢给数」——380 美元、500 美元、600 美元、20 万美元、180 对 2.20、0.79% 到 76%、90% 对 25%。这些数有的能核,有的不能核,但它们至少让读者可以不同意。一本让你能不同意的书,比一本让你只能点头的书有用得多。
判断只有一句:它把「数据」从一个形容词做成了一个名词——可以分层、可以标价、可以验收、可以争论。这一步是硬的。至于那把验收的尺子,它画出了刻度,还没标出单位。
值得读,因为它敢给数;要小心,因为它只给了数。
阅读记录 · 夏轩、俞波、刘少山《具身智能数据工程:标准、技术与实践指南》,人民邮电出版社,2025 年 7 月第 1 版,ISBN 9787115672704,推荐序作者刘华平。全书 10 章,从版权页读至书末。文中所引原文、表格与数字均照录自书中(第 5 章表 5-1、第 9 章 AIRSPEED 各节实测数据、第 10 章局限一节),OCR 造成的个别字符误差已对照上下文校正,未作改写。
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: