
一本 2023 年的视觉教材,代码为什么停在 2020 年?
一、先看它长什么样
这本书的结构非常规整,规整到像一份教学大纲。三篇十章:第一篇讲机器学习基础,第 1 章是概念与发展史,第 2 章搭环境,第 3 章把机器学习的完整流程走一遍——数据探索、预处理、特征选择、线性回归六种、决策树五种、模型评估、管道与网格搜索。第二篇讲计算机视觉基础,第 4 章讲图像是什么、OpenCV 怎么用,第 5 章用传统方法做图像分类,HOG 和 SIFT 讲得挺细。第三篇讲深度模型,第 6 章神经网络与 BP,第 7 章卷积神经网络,第 8 章 LeNet 到 DenseNet 六个经典模型,第 9 章目标检测,第 10 章图像分割与目标追踪。
这条线是通的,而且是递进的:先让你知道图像在内存里就是一个二维数组,再告诉你人怎么手工设计特征去认它,最后告诉你怎么让机器自己学特征。三个阶段的分界点选得不错——第 5 章末那个用 HOG 加 SVM 认手写数字的实验,正好是“人工特征时代”的最后一步;第 6 章一开篇就进感知机,衔接得上。
每章的模板也统一:先讲原理,再列参数表,再给代码,最后贴结果图。这个模板对初学者友好,因为你知道下一段要出现什么。但它也带来一个后果:原理部分被压得很薄,参数表和图占了大头。第 3 章里,Pandas 的各种切片、Seaborn 的各种图型,从表 2.2 排到表 2.6、图 2.9 排到图 2.24,二十多页基本是库函数演示。第 4 章更彻底,imread、imwrite、flip、warpAffine、blur、medianBlur、inRange、findContours 一个接一个,本质上是一本 OpenCV 的 API 手册。
这类内容不是没用,是“位置不对”。官方文档写得更全、更新更快、还能直接复制。一本 547 页的书把四分之一给了可以随时查的东西,剩下的四分之三就得压缩真正需要作者判断力的部分——而这本书的短板,基本都出在被压缩的那部分。
二、第 9 章是全书最值钱的一章
如果只读一章,读第 9 章。它把目标检测这十来年的演进写成了一条因果链,而不是一串模型名字。
起点是最笨的办法:滑动窗口。拿一个框在图上滑,每滑一次问一遍“这里是塔吗”,滑完整幅图就得到一堆候选区域。问题是目标大小不定,框也得换尺寸,候选区域于是爆炸性增长。书里给了一个很实在的算法:24×24 的窗口、步长 1,扫一张 1024×768 的图,待检区域超过一百万个。这个数字一摆出来,你立刻明白为什么这条路走不通。
第二步是选择性搜索。它不硬扫,而是先按色彩、纹理、尺度和吻合度四个相似度把相邻的小区域合并成大区域,合并过程本身就产生了一批候选框。书里给了 OpenCV 实测的两个数:快速模式 1067 个候选区域,详细模式 3352 个。比一百万少了三个数量级,这就是进步的量化表达。
第三步是 R-CNN。它用选择性搜索出 2000 个框,每个框缩到 227×227,逐个送进 AlexNet 提特征,再用一组 SVM 分类,最后用边框回归修位置。听起来很合理,代价写在书里:
由于这些区域之间有很多重叠的部分,因此 R-CNN 模型有大量的重复计算,其检测和训练的速度都很慢(使用单 CPU 检测一张图片需要 47 秒左右的时间)。
47 秒一张图,这个数字比任何形容词都有说服力。更麻烦的是存储——5000 张图会产生几百 GB 的特征文件。于是有了 SPPNet:整幅图只提一次特征,把候选框的坐标按比例映射到特征图上,再用空间金字塔池化把任意大小的区域压成固定长度。书里算得很清楚,用 4×4、2×2、1×1 三种池化核,通道 256,最后得到 (16+4+1)×256 = 5376 维。这个 5376 就是“为什么 CNN 可以吃任意尺寸输入”的答案。
再往后是 Fast R-CNN,把 SPP 简化成 ROI 池化,并且把分类和回归并到一个模型里,两件事一起做;然后是 RPN,用 9 个不同尺度和长宽比的锚框(3 种尺寸 × 3 种比例)替掉选择性搜索,一条 18 维的 1×1 卷积判前后景,一条 36 维的 1×1 卷积做位置校准;再到 Faster R-CNN,四个步骤全交给网络,终于端到端。最后是 YOLO,把图切成 7×7 个单元,每个单元出 2 个边界框,每个框 30 维(4 个坐标 + 1 个置信度 + 20 类概率),一次前向就出结果。作者给的对比也很克制:准确率比 Faster R-CNN 低约 7%,速度提高近 3 倍。
这一段读下来,你会明白一件事:目标检测的每一次迭代,解决的都是上一次的具体瓶颈,不是“我又提了个新模型”。这种写法比罗列 SOTA 有用得多,因为你能把同样的思路搬到自己的问题上。
三、它有几处是真下了功夫的
第一处是 BP 算法的手算示例。大部分教材写到“根据链式法则求偏导”就收笔了,这本书真拿一组数字算到底:输入固定,权重初始化成 0.49、0.34、0.65 这些具体值,激活函数用 Sigmoid,前向算出两个输出 0.75 和 0.21,跟真值 0.75、0.74 一比,总误差 0.14。然后算 w5 对总误差的影响:输出层误差项 −0.34、激活函数导数 0.19、上一层输出 0.65,三个一乘,−0.04。学习率设成 1,w5 从 0.49 减 0.04 变成 0.53。
这串数字能对上,说明作者是真跑过一遍再写的。初学者卡在反向传播,卡的就是“这个偏导到底谁乘谁”,光看公式看不出来,跟着算一遍就通了。这一节的价值超过后面十页公式。
第二处是两笔参数账。一笔是 1×1 卷积降维:输入 100×100×128,直接用 256 个 5×5 卷积核,参数量 819200;先用 32 个 1×1 核压到 32 通道,再上 256 个 5×5 核,输出一样是 100×100×256,参数量掉到 204800。另一笔是 3×3 堆叠:两个 3×3 卷积的感受野等于一个 5×5,三个 3×3 等于一个 7×7,但参数只有后者的三分之二左右,而且多了两次非线性。这两笔账算完,“为什么 VGG 全用 3×3”“为什么 Inception 到处塞 1×1”就不用背了。
第三处是 ROI 池化的量化误差。书里给了一个能算的例子:用 VGG16,步长 32,候选框 665×665,第一次量化 665/32 = 20.78 取整成 20,第二次 20/7 = 2.86 取整成 2。看着只是小数被抹掉,但它指出了一个要命的放大效应——特征图上偏 0.5 个像素,映射回原图就是偏 16 个像素。这就是 Mask R-CNN 非要用 ROI Align 加双线性插值的全部理由。这种“误差怎么被放大”的说明,比单说“ROI Align 更精确”有用。
四、短板一:代码环境停在三年前
第 2 章开了一张表 1.1,列了全书用到的工具和版本。Python 3.7.9,scikit-learn 0.23.2,opencv-contrib-python 4.5.1.48,Graphviz 2.47.0。这套配置对应的时间点是 2020 年秋天——Python 3.7.9 是 2020 年 8 月发布的,sklearn 0.23.2 是 2020 年 10 月。书是 2023 年 5 月出的。
版本旧本身不是罪,很多经典教材都用旧版本,图的是稳定。问题在于书里用的 API 不是“旧”,是“已经删了”。第 8 章讲 LRN 层,代码写的是 with tf.Session() as sess,这是 TensorFlow 1.x 的写法,TF2 里 tf.Session 整个被移除,这段代码在任何 2020 年之后的 TensorFlow 上都跑不了。同一章讲模型预测,用的方法是 model.predict_classes(),这个函数在 TensorFlow 2.6 起就被标记废弃,在 Keras 3 里已经删掉,正确写法是 np.argmax(model.predict(x), axis=-1)。
还有 Keras 的路径问题。书里写 from keras.preprocessing import image、from keras.applications.resnet50 import preprocess_input, decode_predictions,这套写法在 Keras 2.9 之后也变了。第 9 章的选择性搜索要 cv2.ximgproc,这属于 contrib 包,普通 opencv-python 装不上,书里虽然提了要装 opencv-contrib-python,但没提醒版本对不上的后果。
这就造成一个很尴尬的局面:读者拿到的是一本 2023 年的书,按书敲代码,大概率在第二章装环境时就遇到一堆版本冲突,在第 8 章第一次训练时遇到 AttributeError。而这些问题跟“深度学习与计算机视觉”一点关系都没有,纯粹是 API 变迁。一本教材最不该让读者卡在这种地方。
五、短板二:示例太小,小到不说明问题
书里反复出现“AI 编程”“神经网络应用实例”这样的标题,但打开一看,例子都很小。
第 2 章讲 AI 编程入门,示例是用 PolynomialFeatures(degree=30) 加 Ridge 回归去拟合四则运算。30 次多项式拟合加减乘除,这个例子的作用是让你看见“模型能拟合”,但它拟合的是一个你自己就能算出来的东西,学不到任何关于数据、特征、泛化的判断。
第 6 章神经网络的两个实例:回归那个是拟合笛卡儿心形方程,分类那个是随机生成两列数,判断它们的平均数大于 0 还是小于等于 0。用 5 个隐含层、每层 50 个神经元去拟合一个心形曲线,用 2 个隐含层、每层 10 个神经元去分一个“平均数符号”——这两个任务用三行 if 就能解决。它们的价值只在于验证 MLPRegressor 和 MLPClassifier 这两个类能跑通。
第 5 章更典型。这一章叫“使用传统方法进行图像分类”,是全书唯一一次给传统方法做实证的机会。它选了 MNIST,然后只取标签为 0 和 1 的样本,训练一个只能分辨 0 和 1 的模型。MNIST 的 0 和 1 是全世界最好分的一对数字,任何模型在这上面都能拿到 99% 以上。用一个必然成功的实验去论证一个需要比较才能成立的结论,这个实验从设计上就没有信息量。
这不是吹毛求疵。教材里的例子承担两个功能:一是让你跑通,二是让你形成判断。这本书第一个功能做到了,第二个功能基本没做——因为它所有的例子都太干净,没有脏数据、没有类别不平衡、没有标注错误、没有推理延迟,而真做项目时,你要处理的恰好就是这些。
六、短板三:实验自己拆自己的台
第 5 章开头有一句话,是这本书对传统方法的核心论断:
由于深度学习对样本和计算量要求较高,在许多场景下,传统的图像分类方法仍然有着不可替代的优势。
这句话本身站得住,工业界确实还有大量场景在用 HOG 加 SVM。但书里给出的证据撑不住它。前面说的那个 MNIST 0/1 实验,十个分类器用默认参数跑出来的得分是这样的:逻辑回归 0.99905437,K-近邻 0.99905437,支持向量机 0.99905437,决策树 0.98723404,随机森林 0.99858156,AdaBoost 0.99669031,GBDT 0.99479905,Bagging 0.99054374,LDA 0.99621749,MLP 0.99810875。
三种完全不同的算法,得分小数点后八位一模一样。这不是“三个模型都很强”,这是“这个任务简单到测不出差别”。在这样的数据上,你无法得出任何关于方法优劣的结论,更无法支撑“不可替代”这种强度的判断。作者自己在旁边也写了“这个例子只使用分类器的默认参数进行训练,只使用判别系数对模型进行评估”,说明他知道这个实验粗糙,但没有换一个能说明问题的实验。
第 8 章是同一个毛病的另一面。这一章用 Keras 搭了一个 LeNet-5,在 CIFAR-10 上训练 50 个 epoch,然后老老实实把混淆矩阵贴了出来:飞机 558、汽车 668、鸟 423、猫 391、鹿 597、狗 451、蛙 670、马 603、船 662、卡车 687(主对角线,共 5710,即准确率约 57%)。接着是一句总结:
可以看出,LeNet-5 在 CIFAR-10 上的表现并不理想。
问题是,它当然不理想。LeNet-5 是 1998 年为 32×32 的手写数字设计的模型,五个可训练层,它从来没打算处理十类彩色物体。用它跑 CIFAR-10 拿到 57%,这个结果不需要实验也知道。真正该做的是拿 AlexNet 或 VGG 跑同一份数据做对照,让读者看见“深度带来的差距有多大”——而这恰恰是这一章存在的意义。书里有六个模型的结构图、参数表、创新点,却没有一次横向对比。读者读完知道 VGG 比 AlexNet 深、ResNet 比 VGG 更深,但不知道深多少能换多少准确率。
这是这本书最可惜的地方:它有很多“可以做成实验”的素材,但只在最容易的地方做了实验,在最该做实验的地方停了笔。
七、还有几处硬错,读的时候得自己校
第 10 章的小结里,有一句话把两个概念说反了:
实例分割和语义分割的区别在于:前者不区分同一类别中的个体,而后者则区分同一类别中的每个个体。
正确的是反过来。正文第 10.1.1 节自己写得很清楚:“语义分割不区分同一个类别内的对象个体,而实例分割则区分不同的对象个体”。也就是说,小结里的“前者”“后者”调了个位置。这个错不算小——语义分割和实例分割的区别是这一章的第一个知识点,读者如果只翻小结复习,会记反。
第二处是图号错位。第 9 章讲完整人脸检测流程时,正文写“完整的检测流程如图 9.45 所示”,但紧随其后的流程图图注印的是“图 9.42 人脸检测流程”。而图 9.42 在几十页之前已经用过一次,是滑动窗口初检的结果图。同一本书里两个不同的图共用一个编号,交叉引用就断了。
第三处我要说明白:我在逐屏读的过程中遇到过多处整页内容重复,比如第 3 章小结那段“机器学习的完整流程包括多个环节”连排了两页,第 4 章小结、第 5 章小结、第 8 章小结也各有一页几乎完全相同的内容。但我没法确定这是书里的排版问题,还是阅读器翻页时上一屏未滚完导致的重叠截图。所以这一条我不算作书的错误,只作为阅读体验记录在这里——如果你手上有纸书,可以自己核一下。
八、那这本书到底该怎么读
我给一个明确的分工。
当索引读,别当教程敲。它的目录结构清楚,模型谱系完整,你想查“Inception 的四个版本差在哪”“ResNet 的残差块怎么算”“YOLO 的 30 维输出都是什么”,翻它能快速定位。第 8 章那六张结构图加参数表,是全书密度最高的部分,值得反复看。但代码不要照抄,尤其第 8、9 章的 Keras 和 OpenCV 调用,那些 API 现在都得重写。真要跑,去官方文档抄当下的写法,把这本书当注释看。
第 9 章精读,第 10 章选读,第 3 章速查。第 9 章那条演进链值得逐段读,它是全书唯一一处把“为什么”讲透了的地方。第 10 章只有 FCN 和 Mask R-CNN 两节值得看,ROI Align 的双线性插值讲得不错,光流法的 LK 算法也可以,但整章篇幅偏短,语义分割和实例分割都只各讲了一个模型,远不如第 9 章扎实。第 3 章当 sklearn 速查表用,别顺着读。
第 1、2、4 章可以跳。第 1 章的发展史两页就能讲完,写成一章;第 2 章的环境搭建已经过期;第 4 章是 OpenCV 手册。这三章加起来一百多页,是全书最容易被替代的部分。
至于这本书适合谁:适合完全没有视觉基础、想知道这个领域有哪些部件、各自解决什么问题的人。读完你会有完整的地图。不适合谁:不适合想上线一个检测或分割项目的人——它不教你标注怎么管、数据怎么增广、模型怎么压、推理怎么部署,这些一个字都没有。也不适合已经做过一两个 CV 项目的人,因为你需要的是判断力,而这本书给的是清单。
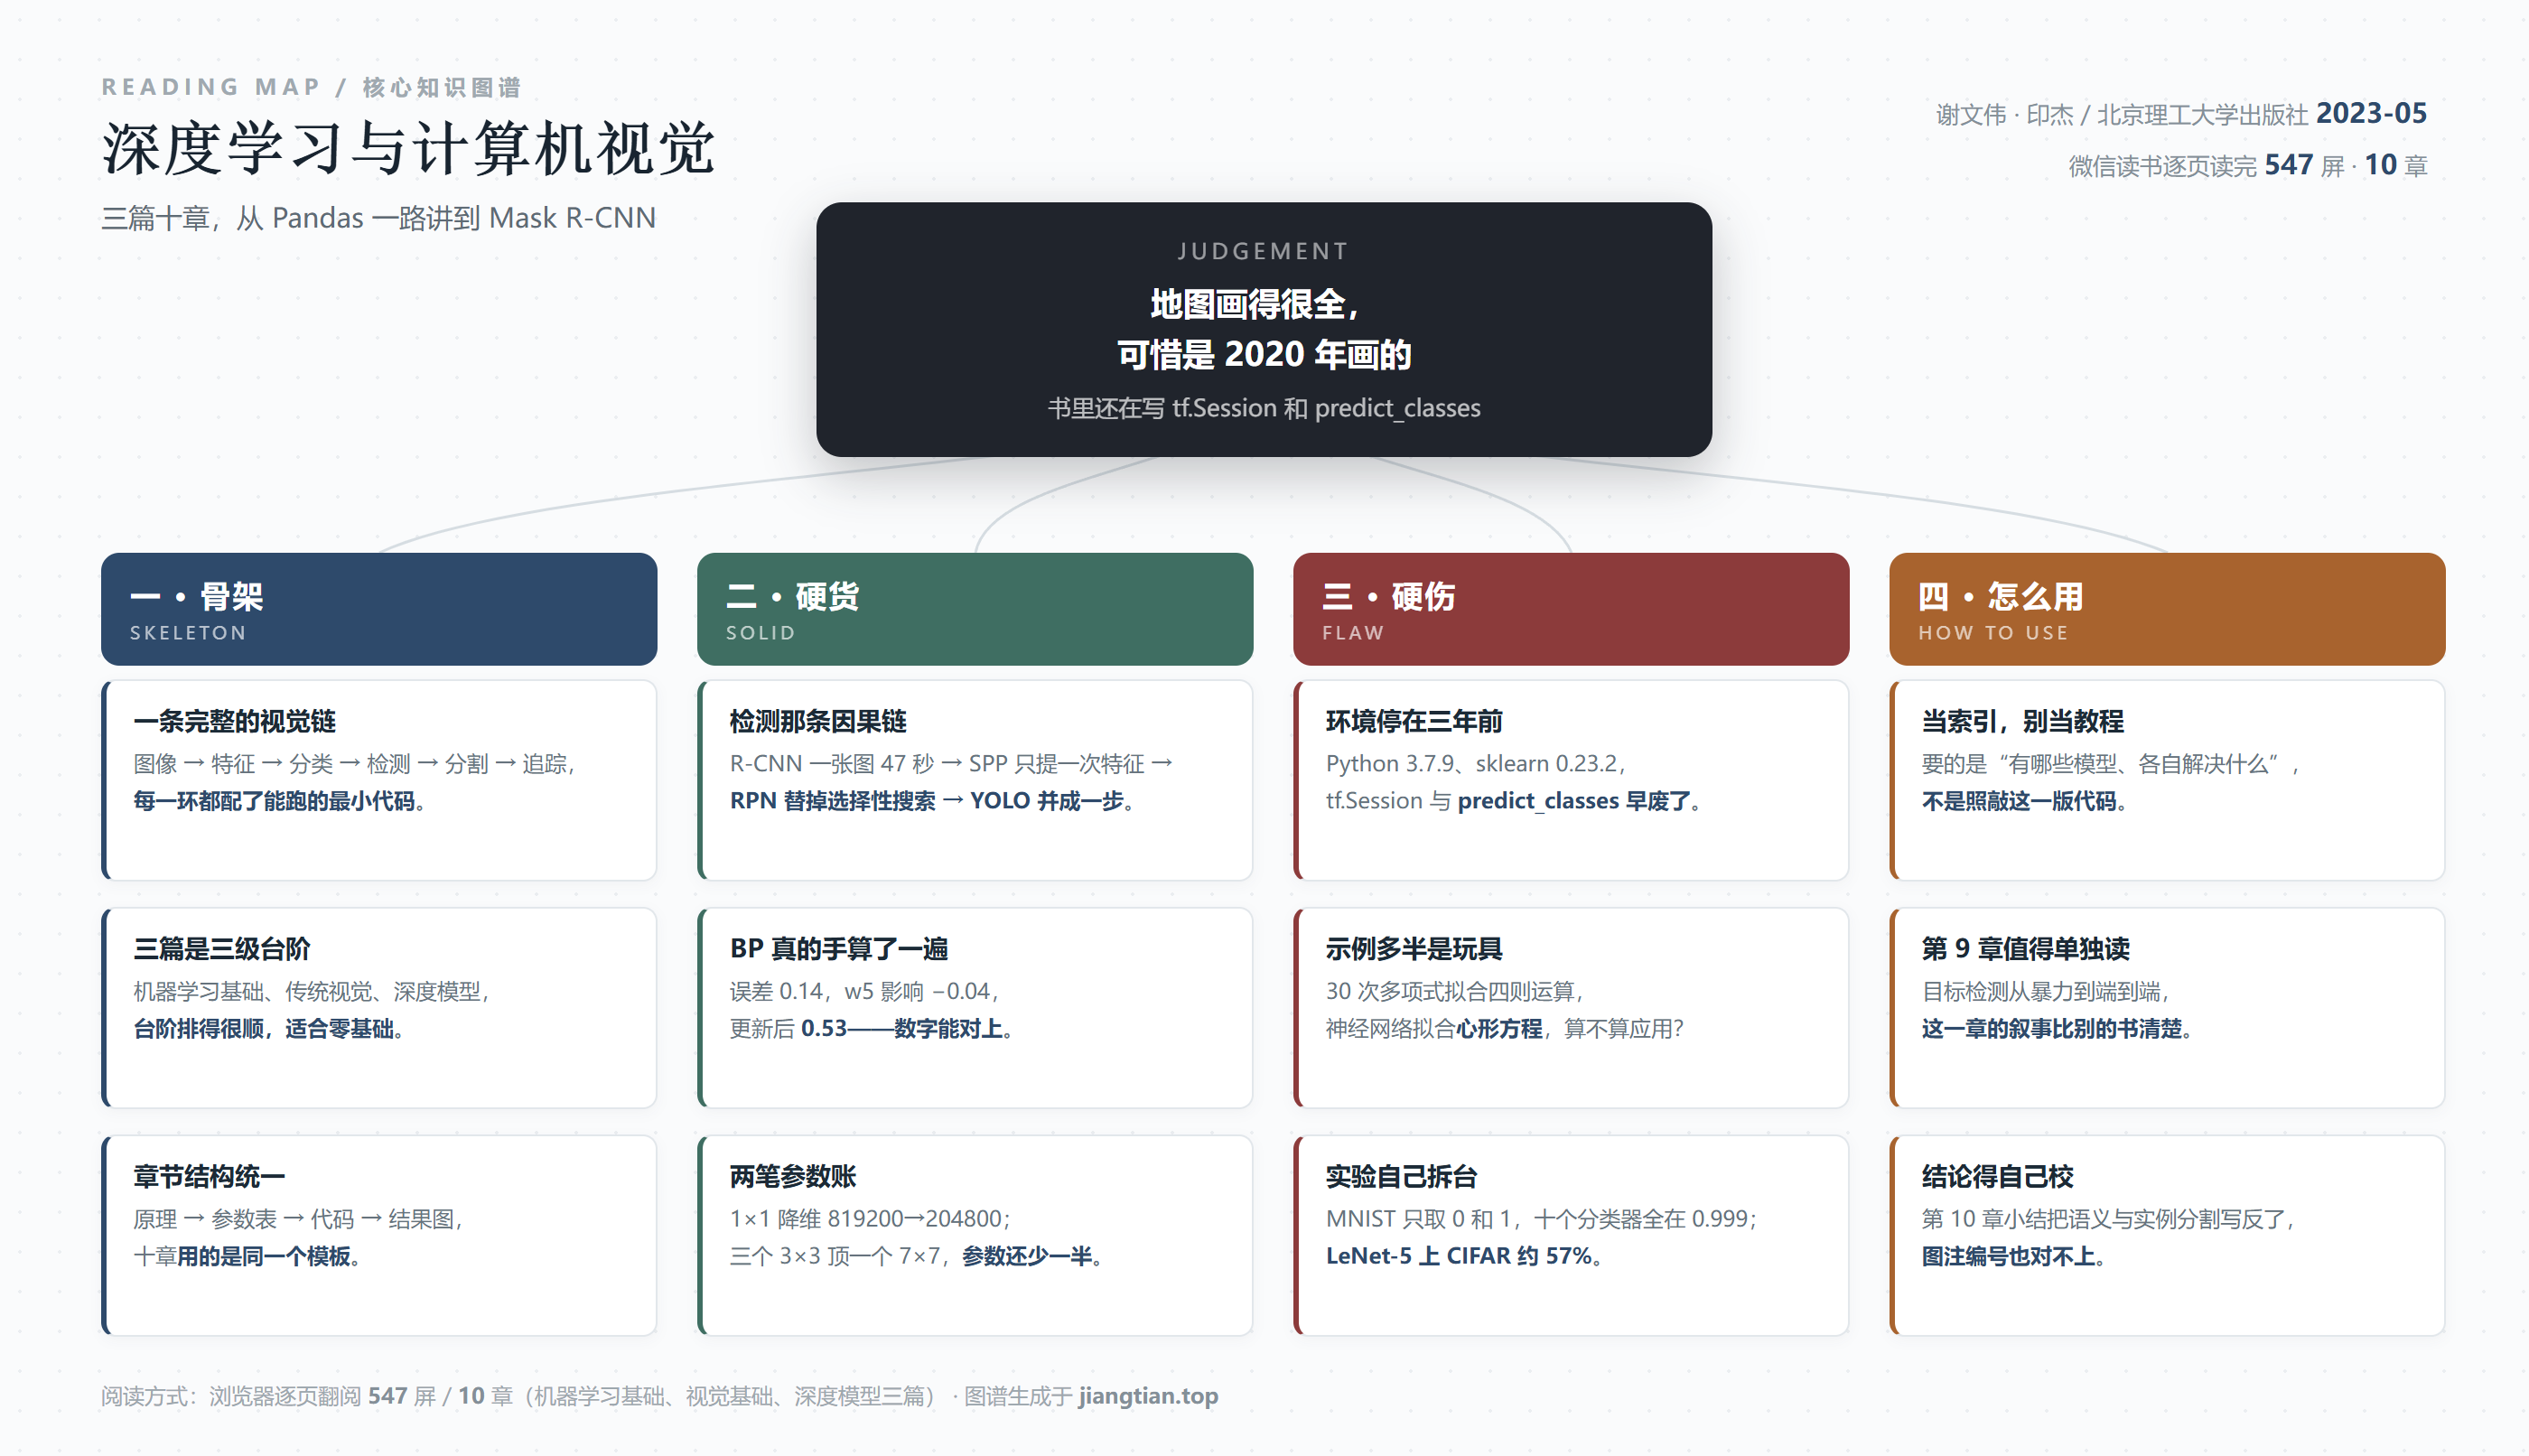
最后说一句我自己的感受。这本书最像“认真写的教材”的地方,是它肯把失败的结果贴出来——混淆矩阵里那些错分的数字,本来可以不印。最不像的地方,是它没有顺着那个失败往下追一步。第 8 章看到 LeNet-5 只有 57%,正常反应应该是“那我换个模型试试”,书停在了“表现并不理想”。这一步之差,就是清单和判断力的差别。
它把视觉这十年的家当都摆出来了,摆得整齐,只是没告诉你哪件该拿、哪件已经不能用了。
阅读记录 · 谢文伟、印杰《深度学习与计算机视觉:核心算法与应用》,北京理工大学出版社,2023 年 5 月第 1 版,ISBN 9787576323054。全书 10 章 547 页,从版权页读至书末“全书完”,书末微信读书显示推荐值 0%、评分不足。文中引文与代码输出均照录原书,混淆矩阵数字为主对角线逐项摘录;因原书为图片版,OCR 造成的个别字符误差已对照上下文校正,未改写原意。
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: