
从好玩到好用,中间隔着一次部署
阅读方式:微信读书网页版,从版权页翻到第 4 章末,共 216 屏、6 分 30 秒。 结构:从大模型到 Agent、Dify 介绍与开发流程、部署开发环境(Docker/Dify/Ollama/Xinference)、工作流与节点。
这本和我刚读完的那本《零基础开发 AI Agent——用扣子做智能体》,几乎是同一个题材的两条路。
扣子是云平台,注册就能用;Dify 这本书,一半篇幅在教你把它装到自己机器上。
而它给出的理由,比"开源免费"扎实得多。
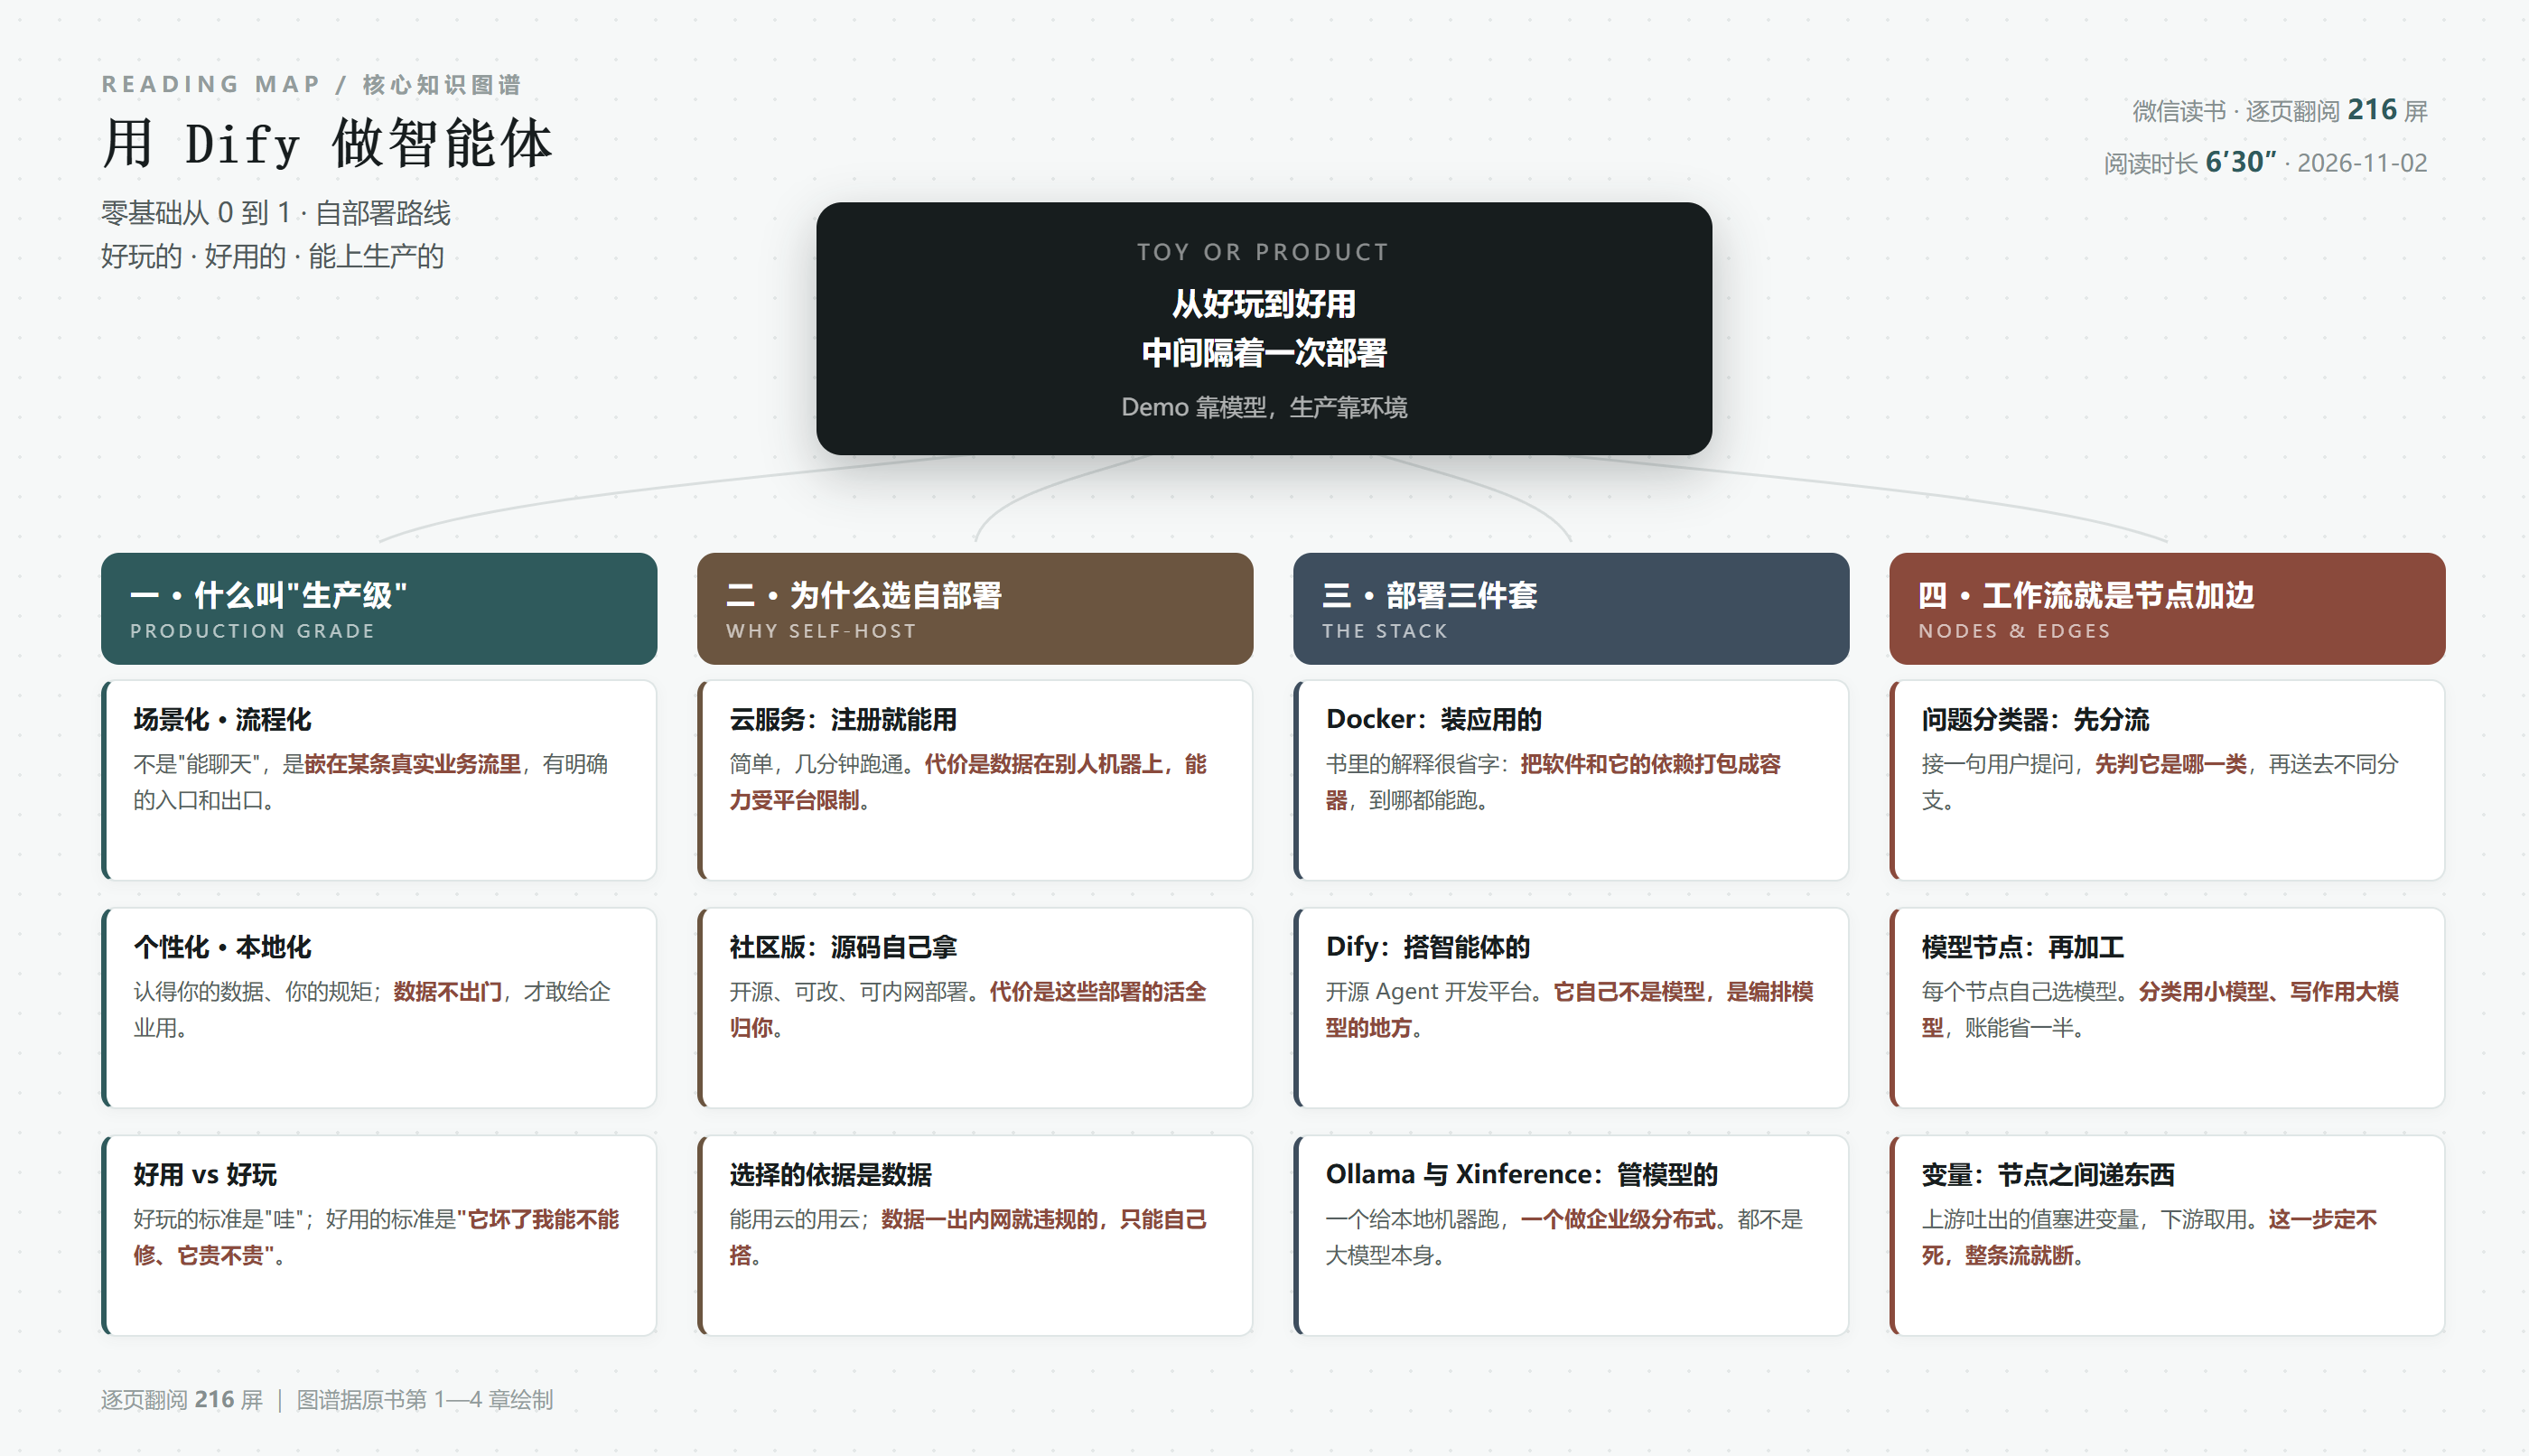
一、什么叫"生产级"
第 1 章第三节的标题是:Agent 正在从好玩走向好用。 紧接着两个小节:好用的 AI 应用——生产级 Agent;生产级 Agent 助力企业经营管理突破。
"生产级"这三个字,是全书的核心概念。它指的是一组很具体的要求,书里放在 1.2 节,四个词:
场景化——嵌在一条真实业务流里,有明确入口和出口
流程化——多步骤、有分支、能交接
个性化——认得你的数据、你的规矩
本地化——数据不出门
四个词里,前三个是做出来的效果,第四个是能不能用它的前提。
这也解释了为什么这本书非讲部署不可:如果你的数据不能出门,那么一切"注册即用"的方案,对你都是零分。
所以"好玩"和"好用"的分界,不在它聪不聪明。书里那两句话我印象很深——
好玩的标准是"哇";
好用的标准是"它坏了我能不能修、它贵不贵"。
二、云还是自己搭:判据只有一条
第 2 章讲了 Dify 的两种使用方式:云服务和社区版。
云服务——官网注册,几分钟跑通。省事,代价是数据在别人机器上,能力也受平台约束。
社区版——开源,拿源码自己部署。可以买云服务器装,也可以装在自己电脑上。代价是这些活全归你。
书里的取舍建议其实很克制:能上云的先上云,跑通再谈自建。
而真正逼人走第二条路的,是那一条:数据不能出内网。
金融、医疗、政务、大企业的核心业务——这些场景里,"数据在谁的机器上"不是技术细节,是合规红线。一旦这条线划下来,云端方案再好也只能放弃。
这也是我认为这本书存在的意义:它不是"更好的扣子",它是唯一能进那些机房的选项。
三、三件套:装应用的、搭智能体的、管模型的
第 3 章讲部署,方案有两个:Docker + Dify + Ollama,或者再加一个 Xinference。
三个东西的分工,书里解释得特别省字,我照抄:
Docker 是一组平台即服务(PaaS)产品,基于操作系统层级的虚拟化技术,把软件与其依赖项打包为容器。通俗地理解,Docker 就是一种可以部署各类应用程序的平台。
Dify 是一个 Agent 开发平台,提供开发 Agent 的各种功能。
Ollama 是一个开源的模型管理平台,专为本地机器设计,简化模型的部署和运行过程。通俗地理解,Ollama 是管理各类模型的工具,本身并不是大模型。
最后那句必须画线:Ollama 本身不是大模型。
很多人第一次接触时都以为装个 Ollama 就有模型了,其实它是个"模型的管理器"——装上它,等于有了一个能下载、能切换、能跑各种开源模型的插座。
这三件套的关系,我用一句话概括:
Docker 提供地基,Dify 是房子,Ollama 是屋里的发动机。
而 Xinference 是给企业用的那一档——书里说它提供企业级分布式部署。单机跑不动大模型的时候,才需要它。
四、工作流:节点加边,和真实的业务分流
第 4 章讲工作流,一个具体例子让我看懂了"生产级"到底长什么样。
那是一个客服分流的工作流:第一站是问题分类器节点——选一个模型,把用户那句话当输入变量,然后分成几类:
分类一:禁言解禁处理
分类二:支付问题处理
看到这两类我笑了一下,因为这是真问题——"我的账号为什么被禁言"和"我付了钱没到账",是两套完全不同的处理流程,混在一个对话框里只会互相拖累。
而工作流的第一件事,就是把它们分开。
分开之后,每个分支可以挂不同的模型、不同的知识库、不同的动作。书里提到每个节点都能自己选模型——这一点很实用:分类用小模型就够,写作用大模型,账能省一半。
而节点之间靠什么串?变量。
上游吐出的值塞进变量,下游取用。这一步定不死,整条流就断——这和我在另一本书里读到的"严格定义每一步的输入输出格式",是同一件事。
五、这本书的短板
一是部署章节很快会过期。 Docker 版本、Dify 镜像、Ollama 的模型名,全都绑在具体版本上。书里给的命令,半年后多半要改。
二是截图太多。 216 屏里,界面截图占了很大比例。平台改一次版,这些图就成了历史资料。
三是案例偏单一。 工作流例子主要是一个客服场景,没有给出跨行业的复杂流程,读者很难照着迁移到自己那摊活上。
它的优点是:它把"为什么必须自己部署"讲清楚了。 大多数教程只讲"怎么做",这本先讲了"什么情况下非做不可"——而后者才是决策依据。
六、一句话
扣子给你一间装修好的房子,Dify 给你一张图纸和一堆建材。前者三天能住进去,后者你得先学会看图纸。 但有些活必须自己盖——因为你要在里面放的东西,不能让别人看见。所以这两本书不该二选一:先用云平台把想法跑通,等它真的值钱了,再搬回自己家。
阅读记录:微信读书网页版逐页翻阅,216 屏 / 6 分 30 秒。
本书知识图谱见文中配图,原图地址:https://jiangtian.top/zb_users/upload/kg/dify-production-grade-map.png
发表评论: