
布匹瑕疵检测为什么做不成?拆开只有四层,三层跟算法无关
先看清难题长什么样
布匹瑕疵检测做不成,卡点不在算法。
今天上午刷到一篇公众号文章,讲十多年前浙江海宁的一个布匹质检项目。老板出钱,他们出技术,做到最后一地鸡毛。
我把这个难题重新做了一遍。这次我没有从算法入手,我先把它摊开。
摊开之后是四层。四层里,只有第三层归算法管。
第一层,什么叫瑕疵
客户能接受多大的污点?擦痕多长算退货?同一卷布,布边和布心的标准一样吗?
没有人答得上来。老板说得很实在,看着不舒服的,就给我挑出来。
这一层凉了,后面全凉。“瑕疵”和“正常”之间那条线画不出来,标注工人只能各自发挥,标出来的样本互相打架,模型学到的也是一团模糊。
十年前那个项目,很可能死在第一步。只是当时大家都以为死在了算法。
第二层,瑕疵能不能变成像素
线状擦痕宽度不到一毫米,浅色布面上发白,灰度几乎和经纬纹理重合。
这时候相机分辨率不够、光打得太平、布面张力松了、走布速度太快,任何一项不到位,瑕疵在图像里就不存在。
算法再强,也救不回没有被拍到的东西。这一层决定的是上限,上限一旦被卡住,后面所有努力都在补一个补不回来的洞。
第三层,像素能不能被说成一句话
十年前的路子是这一套,先估计背景,再算残差,然后卡阈值,最后找连通域。核心逻辑二十来行,我照着写了一遍。
然后我造了两张样布。第一张上面是点状污渍,外加一个针尖大的破洞。第二张上面是两道细擦痕,搬运蹭出来的那一种。
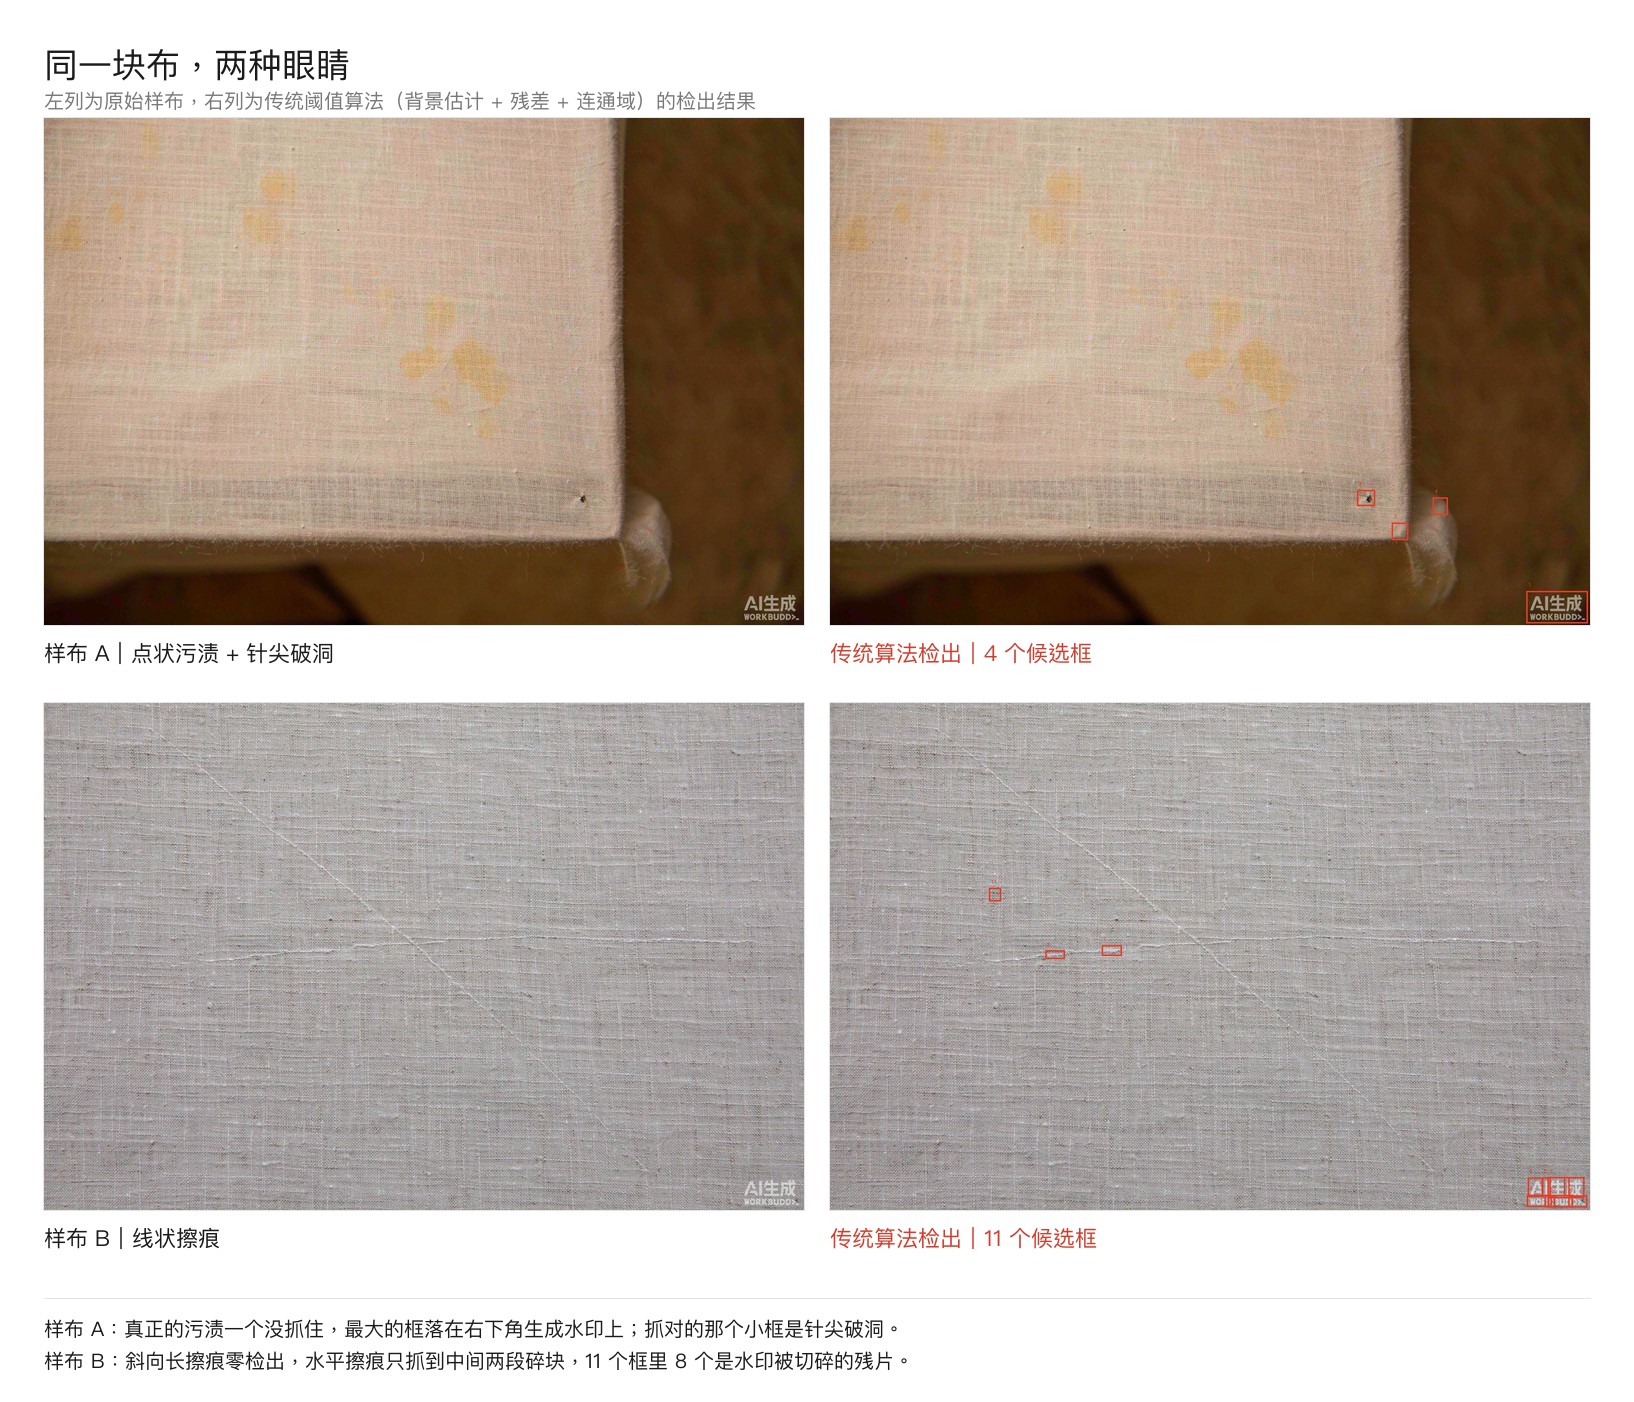
图 1|同一块布,两种眼睛。左列是样布原图,右列是传统阈值算法的检出结果
第一张,算法给出四个框。
只有一个是对的,框住了那个破洞。另外三个,两个压在布边的毛边上,一个框住了右下角的生成水印。
画面上三处最明显的黄褐色污渍,一个都没有抓住。
第二张更难。算法给出十一个框,八个是同一个水印被切成的碎片,一个是噪声,剩下两个框住了水平擦痕中间的一小段。
那道斜穿整个画面的长擦痕,零检出。
误报率七成五,漏检率七成五。那篇文章里说的“误报比人工还多”,我这一下午算是见着了原样。
问题不在参数没有调好。阈值只认一件事,这一点和周围不一样。它不知道不一样的到底是什么东西。
布边是“不一样”,水印是“不一样”,真污渍也是“不一样”。在它眼里,三者没有区别。
换一条路,让模型输出描述,不输出判决。类型、位置、占比、颜色、严重程度,一样一样写清楚,判定交回给人。
这条路要付代价,慢、贵、不稳定。换来的是另一头,不用为每一种瑕疵准备标注样本,长尾的那些也能说上话。
两条路的成本结构完全不一样。
传统路子把成本压在前面,标注、训练、调参全部是一次性投入,推理的时候便宜。代价是没见过的瑕疵直接翻车,客户改一次标准就得重新训练一次。
视觉理解把成本挪到后面,前期几乎不用标注,单张推理贵,同一个瑕疵两次给出的答案还可能不一样。好处是新瑕疵不用重新训练,它能当场描述出来。
选哪一条,看瑕疵种类收不收敛。种类固定、量又大,传统路子仍然更加划算。种类说不清、客户的标准三天两头变,那就不要在标注上死磕。
第四层,一句话能不能撑住一条产线
那篇文章里最诚实的一句是,图像理解速度有点慢,等了大概十五分钟。
产线是每分钟几十米。十五分钟,够走完几千米布。
这一层有五个关口,速度、稳定性、成本、可追溯、闭环。
速度不达标只能抽检。稳定性不够,同一个位置两次给两个答案,工人就不信它。
成本摊到每米布上得算得过人工。报告要能存档,能对客户举证。人工复核的结论要回流成规则,否则三个月之后还是原样。
单张能看,不等于产线能用。谁跳过这一层,谁的演示就停在汇报里。
四层拆完,账就清楚了
十年前卡住的不是算法,是前三层没有搭建好,第四层没有人搭建。
今年变的是第三层。视觉理解把“这一点不一样”升级成了“这是一道细长的搬运擦痕,在布面中段,比周围浅两成”。
三层没有变。定义还得有人来定,光还得有人来打,产线还得有人来守。
四层里三层跟算法无关。这个比例本身就是答案。
这套拆法可以搬走
玻璃、PCB、钢材、纸张,换掉的只是成像参数和瑕疵定义,四层结构原地不动。
下次再遇到“AI 能不能替人看一眼”的问题,先别问模型行不行,先问这四层各归谁管。
最后
那篇文章的结尾我认同,有些答案,你得等时代走到那一步,它才会交到你手里。
我想补一句。时代这次交出来的,只有第三层。剩下三层还在你手上。
· · ·
配图是我按极简纸感做的海报,布片上那道红线不是装饰,是标注。
文中样布全部由 AI 生成,检测数据为本地实测,核心逻辑二十来行,可以复现。
无尘阁日记 · jiangtian.top
江楠
发表评论: