
DeepSeek AI办公实战手册:它说提示词越短越好,又写下 230 屏长模板
微信读书《DeepSeek AI办公实战手册:10倍提升工作效率的方法与技巧》· 抓取 614 屏 / 7 章 / 102 条目录 · 读到书尾
逐字核对 5 屏 · p0006 前言书名条核对为本书 · 2026-11-10
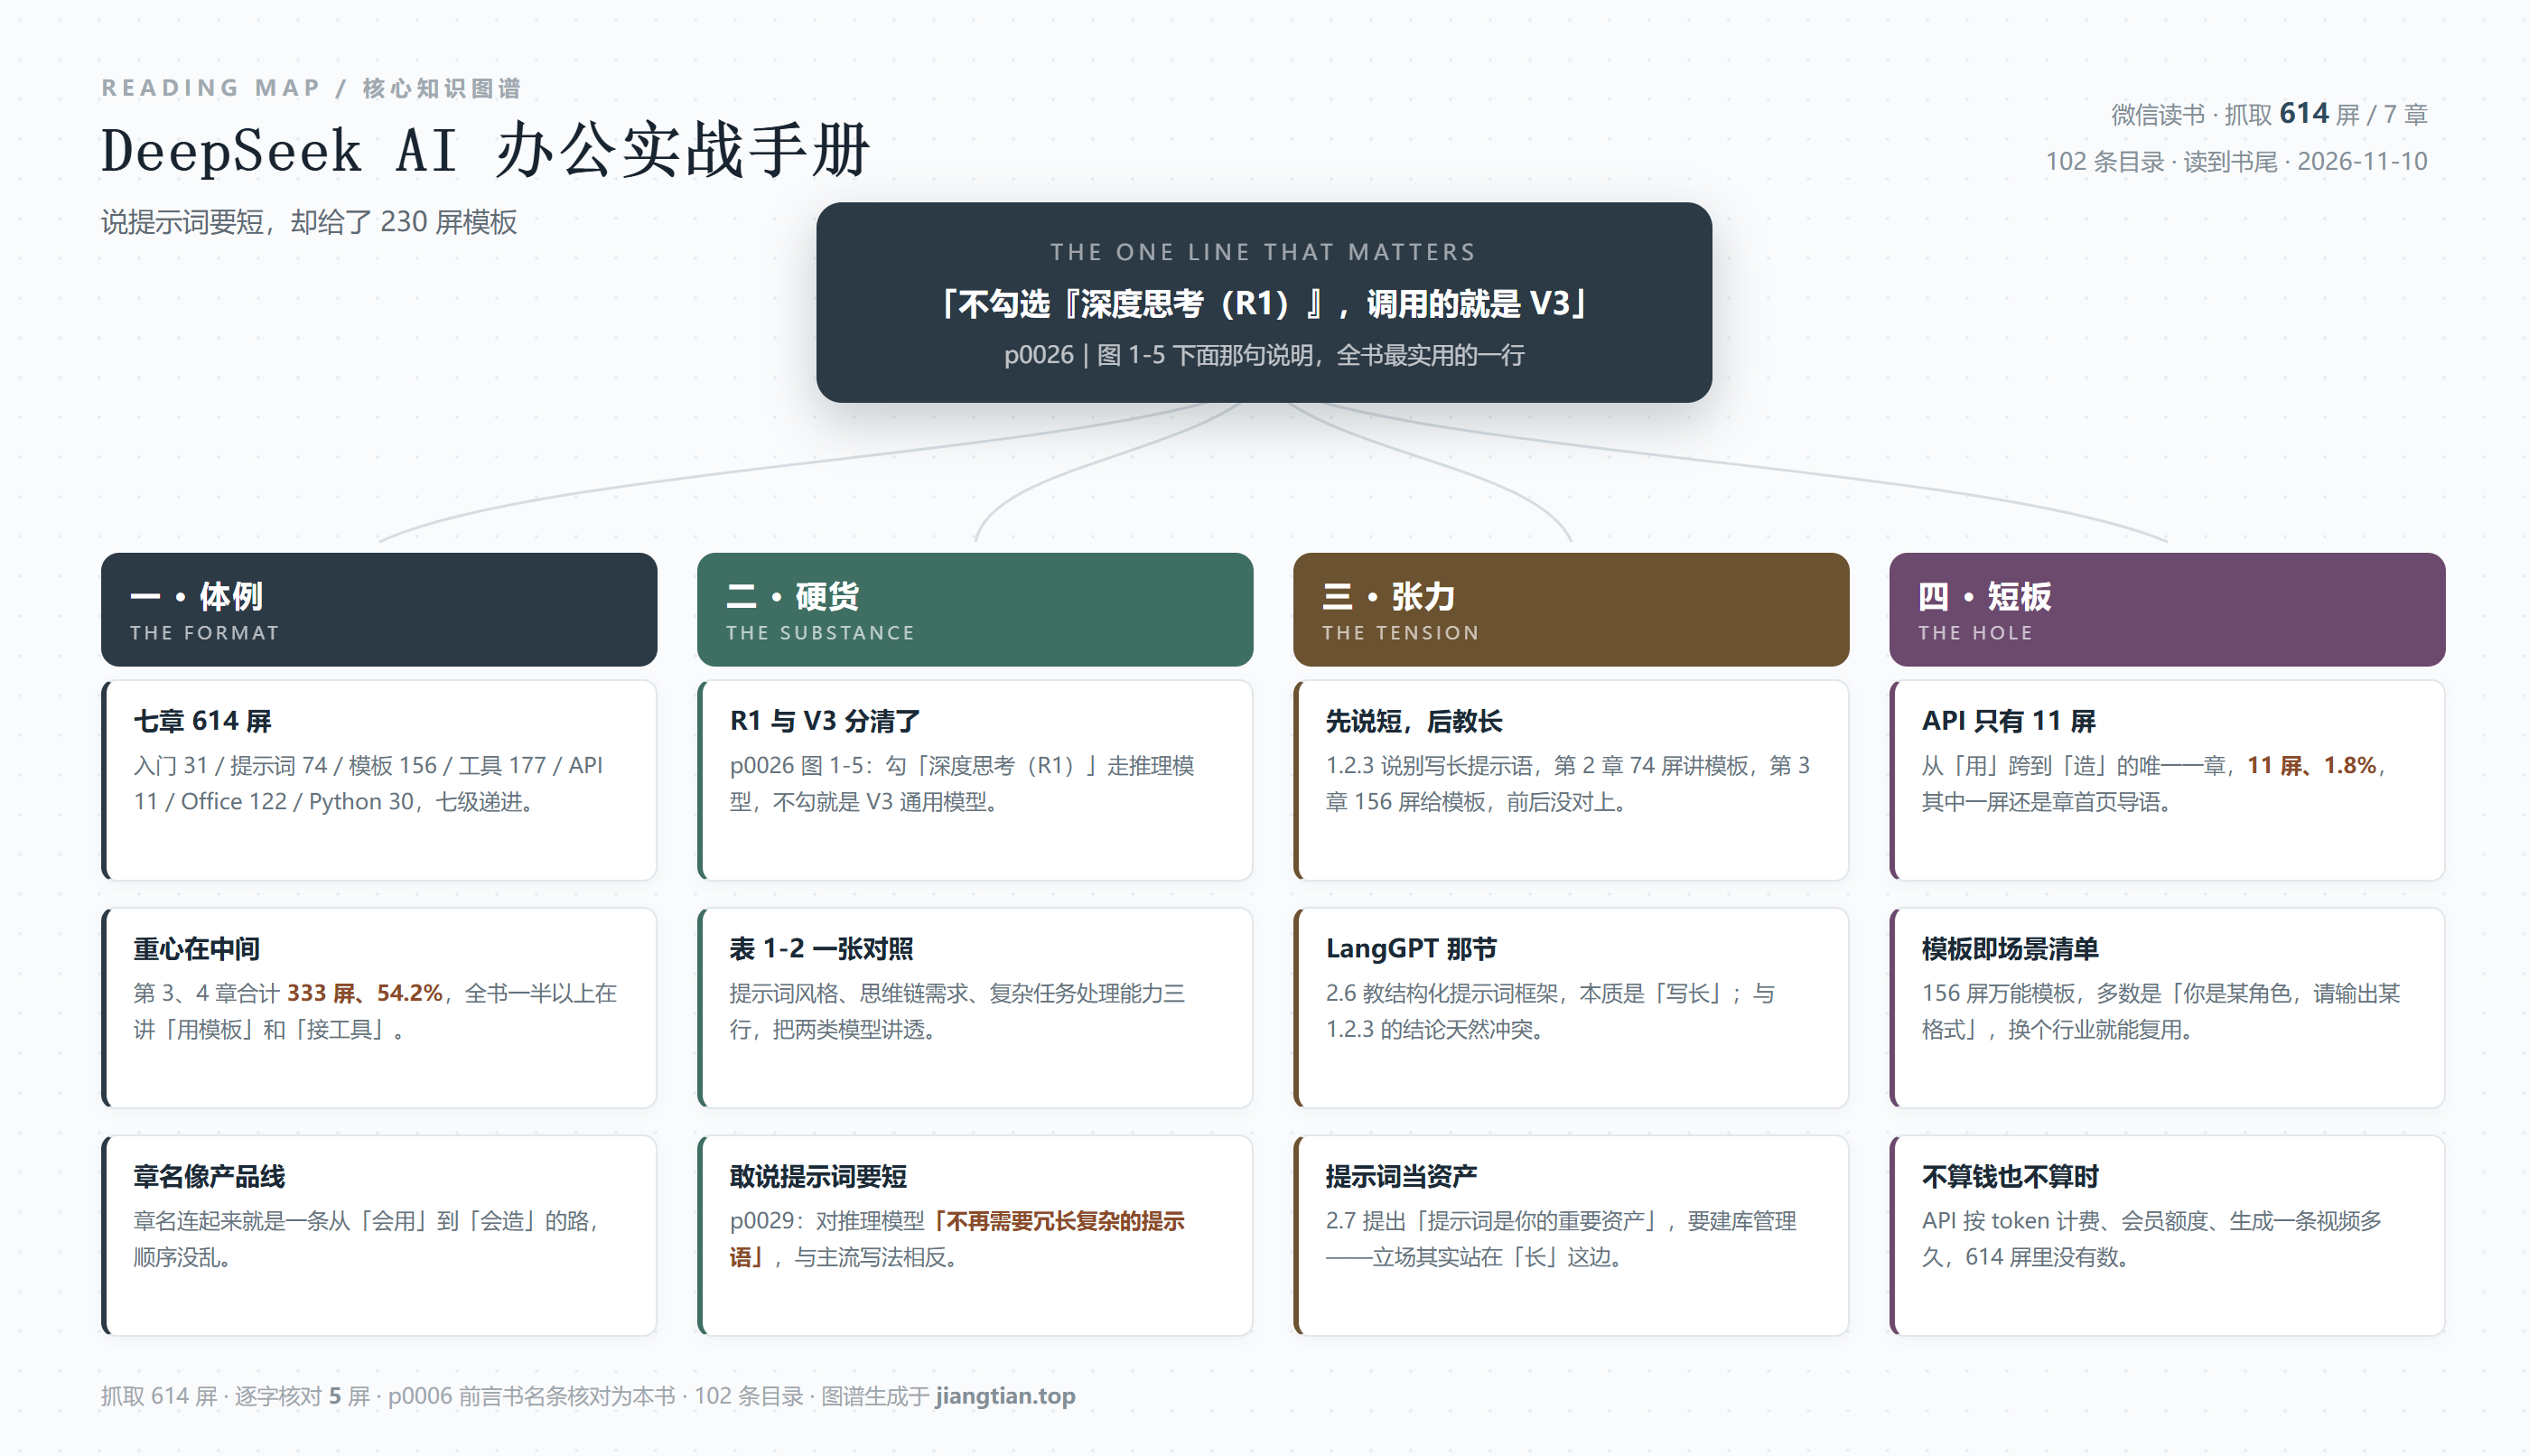
抽样点位的选法:这本书七章的重心严重偏中间(第 3、4 章合计 333 屏、54.2%),但真正有信息量的判断在最前面 1.2 那四节,以及全章最短的第 5 章。所以我放弃了「按篇幅抽样」,改成按「观点密度」抽:p0022(1.2.1 推理模型的优缺点,含周鸿祎那句引用)、p0026(1.2.2 运作机制对比,图 1-5 与 R1/V3 的切换说明)、p0029(1.2.3 提示词设计差异,表 1-2)、p0452(第 5 章章首页),再加 p0006 前言里的章节说明。抽读 5 屏约占 0.8%,重点只压一个问题:这本书的立场到底是「写长提示词」还是「写短提示词」——因为它自己前后说得不一样。
先说我为什么挑这本:DeepSeek 类书这两年出了太多,绝大多数是「一百个场景模板」的堆叠。这本 614 屏、102 条目录,目录排得很像一条能力线——快速入门、提示词、万能模板、热门工具协作、API、Office、Python——从「会用」一路排到「会造」。这个顺序本身说明编者想过读者的成长路径。
读完之后的结论有点拧巴:它最值钱的部分在最前面 1.2 那四节,那四节讲的道理与它后面 230 屏的教法,是相反的。
一、先把这本书的骨架说清:重心在中间
七章的篇幅我逐页算过:第 1 章入门 31 屏(5.0%)、第 2 章提示词 74 屏(12.1%)、第 3 章万能模板 156 屏(25.4%)、第 4 章与热门工具协作 177 屏(28.8%)、第 5 章 API 11 屏(1.8%)、第 6 章结合 Office 122 屏(19.9%)、第 7 章结合 Python 30 屏(4.9%),前置 13 屏。
第 3、4 章加起来 333 屏、54.2%,也就是说这本书一半以上的内容在告诉你「有哪些模板可以用」「DeepSeek 能和哪些工具接起来」。前言里把这一块列得很热闹:Kimi、Mermaid、HTML、豆包、即梦、剪映、天工、可灵、ima.copilot、飞书、Napkin,一串工具名。
这个结构对「买了就要马上用」的读者是友好的——翻到第 3 章任选一节,照着填就能出一份东西。但也正因为重心压在这里,这本书最该被读到的四节(1.2.1 到 1.2.4)被埋在了 31 屏的入门章里。
二、它敢跟主流唱反调:提示词越短越好
p0029 那一页,我读完之后在页边记了一句话:「这句话得罪同行。」
原文写的是「对于推理模型而言,有效的提示词设计至关重要」,然后给了两条核心原则:
直接表达需求:不再需要冗长复杂的提示语,简洁明了地表达需求即可获得理想的结果。
不需要思维链辅助:得益于自身的推理能力,推理模型能够在没有具体思维链指导的情况下独立思考并解决问题。
这两句话在中文 AI 书里是少数派。过去两年最流行的写法是什么?「你是一位有二十年经验的资深律师,请按以下五个步骤思考,第一步……第二步……」,一句话能写成三百字。那种写法的前提是模型不会自己想,所以要人把思路喂进去。而推理模型恰恰相反:它在输出前已经自己走了一遍思维链,你再给它规定步骤,等于给它戴手铐。
这本书敢把这条写出来,而且写得毫不犹豫(「不再需要」「不需要」),这是我对它评价最高的一处。
三、表 1-2 那张对照,是全书信息密度最高的一张表
同样在 p0029,正文下面有一张表 1-2「推理模型与通用模型的提示词差异」,三行对照:提示词风格、思维链需求、复杂任务处理能力。
提示词风格这一行,推理模型写的是「简洁、目标导向,强调最终结果而非中间步骤」,通用模型写的是「详尽、具体、强调步骤和过程指导」。思维链需求这一行,推理模型是「自主生成思维链,不需要用户显式提供每一个步骤」,通用模型是「常常需要显式提供详细的思维链或步骤以确正确执行任务」。复杂任务处理这一行,推理模型「可以直接描述目标,模型会自行规划解决路径」,通用模型则是「通常需要人工将复杂任务拆解成多个子任务」。
这张表的价值在于它可执行。你不需要记住任何理论,只要记住一句话:如果这个模型会自己思考,你就少说;如果它不会,你就把步骤写全。很多读者用不好 AI,问题不在于提示词写得不够花,而在于给推理模型写了三百字的流程说明书,把它的推理空间挤没了。
p0026 那页还补了一个非常具体的操作分界。图 1-5 是 DeepSeek 的对话界面,输入框左下角有两个开关:「深度思考(R1)」和「联网搜索」。正文写得很清楚:勾选「深度思考(R1)」即调用 R1 推理模型;而「DeepSeek-V3 就是非推理模型,在 DeepSeek 聊天框不勾选『深度思考(R1)』,则调用的是 DeepSeek-V3 通用模型」。
这一句抵得上很多章节。它把「我到底在用哪个模型」这件事,落到一个勾选框上。同页还有一段解释为什么推理模型值得用,引了 360 创始人周鸿祎的说法:R1 通过展示完整的思维链条增强了用户的信任感。这个引用选得聪明——它说明推理模型的第一价值不是「更聪明」,而是「更可信」,因为你能看见它怎么想的。
p0022 举的达芬奇例子也是这个路子。问「达芬奇是摄影师吗」,R1 没有直接回答,而是先做四步分析:回顾达芬奇的生平和职业;分析用户的问题是否存在同名混淆;分析达芬奇在光学和视觉研究上的贡献;分析用户是否将《蒙娜丽莎》细腻的光影效果与摄影技术混淆。这四步里,第三步和第四步是真本事——它猜到了用户为什么会问出这个怪问题。
四、可是它自己,又写了 230 屏模板
读到第 2 章中段,我开始觉得不对劲。
1.2.3 刚说完「不再需要冗长复杂的提示语」,2.4 就上了「万能提示词模板」,2.6 又是「LangGPT 结构化提示词框架」,2.7 更进一步,提出「提示词是你的重要资产」,要建库管理。第 3 章 156 屏,整章都是模板:行政文秘一套、市场营销一套、数据分析一套、项目管理一套、人力资源一套、内容运营一套。
LangGPT 那一节尤其说明问题。结构化提示词框架的核心做法,是用「# Role」「## Profile」「## Rules」「## Workflow」这样的段落把提示词组织成一份文档——这恰恰是「写长」的极致。它在通用模型上是有效的,但对 R1 这类推理模型,你在 Rules 里列的每一条,都在压缩它自己规划路径的余地。
书里没有解释这个矛盾。它把两套方法并排放着,一套在第 1 章,一套在第 2、3 章,中间没有一句话说「什么时候用哪套」。读者读完会得到两个互相打架的结论:提示词要短;提示词要结构化、要长、要当资产管理。
我猜编者的真实想法是「都要」,因为在第 2.3 节「AI 办公落地先从『克隆自己』开始」那里,隐约有这个意思——先把自己会的东西写成结构化提示词,让模型替你干。这条路对通用模型成立。但书既然已经把推理模型和通用模型分开讲了,就该在模板章开头加一句分流的说明:这些模板请配 V3 用,配 R1 请砍到三句话。一句都没有。
五、第 5 章只有 11 屏,这是全书最大的遗憾
第 5 章「调用 DeepSeek API 定制智能助手」,11 屏,占 1.8%,是全书最短的一章。
翻开 p0452 那一页,我看到的是章首页:中间只有一段导语,说本章将介绍大模型 API 的基本概念与核心优势、分析 API 调用的关键要素、指导获取 API 并提供具体步骤和注意事项、最后通过实例演示实际使用,底部一个「下一章」按钮。整页没有正文,没有代码。
也就是说,这 11 屏里有一屏是章首页,真正的内容 10 屏。而这件事的分量是:整本书里,只有这一章是从「用工具」跨到「造工具」。前面 570 多屏都在教你怎么在对话框里把活干完,只有这 10 屏告诉你,怎么让别人(或者另一个程序)也能调用它。
这个比例不合理。API 那一步,今天已经不算门槛了——申请一个 key、装一个库、写五行代码,一个下午就能跑通;但它带来的变化是质变:从「我打开网页问它」变成「我的表格里点一下它就干活」。第 6 章讲 Office、第 7 章讲 Python,其实都建立在这 10 屏的地基上。地基只有 10 屏,上面 152 屏的楼就显得悬。
我怀疑这是排期问题:DeepSeek 的 API 在书稿定稿期还在变(模型名、计费方式都调过),编者索性压短了。如果是这样,可以理解,但读者拿到的是一本缺了台阶的书。
六、前言里的六个领域,和正文的分布对不上
p0006 是前言的最后一段,讲了全书四个核心模块:DeepSeek 快速入门与提示词秘籍、万能模板赋能职场办公、DeepSeek + 热门工具打造高效办公生态、API 定制专属智能助手。同时点明第 3 章覆盖的六大职场领域:行政文秘、市场营销、数据分析、项目管理、人力资源、内容运营。
六个领域、156 屏,平均每个 26 屏。这个分配本身没问题,但六个领域的难度差得远:市场营销和内容运营的提示词,本质是「写得好看」;数据分析、项目管理的提示词,本质是「算得对、排得清」。前者宽容度高,生成得差不多就能用;后者错一个数就废。书里用同一种模板写法覆盖这两类,对后一类不够。
还有一个细节:书名写「10 倍提升效率」,正文里没有一个测算。我不反对用倍数做书名——营销需要;但至少该在某一章给一次真实的时间对比:这件事原来做多久、现在做多久、哪一步省下来的。全书没有这样一处。这个数字要么是调研来的,要么是估的,读者无从判断。
七、它的短板
第一,前后立场打架,而且没有交代。1.2.3 说推理模型不需要长提示语,第 2、3 章用 230 屏教长模板,中间没有一句分流说明。读者学完会同时相信两件相反的事。
第二,最关键的一章最短。API 只有 11 屏(含一屏章首页),而它是全书唯一从「用」到「造」的台阶,也是第 6、7 章的地基。地基比楼薄太多。
第三,模板量大但同质。156 屏万能模板,多数可以归纳成「你是一位某角色,请按某格式输出某内容」,换个行业就能复用。真正难的、值钱的模板——比如让模型校验一份合同的风险点、让它对一份数据做交叉验证——很少。
第四,不算钱也不算时间。API 按 token 计费,614 屏里没有一个价格;会员额度、生成一段视频要等多久,也没有。用 API 的人最先撞上的就是账单,书上没提。
第五,没有失败复盘。全书演示都一次成功。可 R1 最常见的毛病是「自信地编」——它会用漂亮的推理过程推到一个错的结论。这种时候怎么发现、怎么验证,书里没有一个案例。
也得承认:在同类 DeepSeek 书里,这本的模型认知是清楚的——它分得清 R1 和 V3,敢说提示词要短,引用的例子也选得准。它的问题不是不懂,是懂了没贯彻到底。
八、一句话
如果你只想读 20 屏,读 1.2 那四节,你会得到一个比大多数教程都准的判断——会思考的模型,少给它规定步骤;如果你想把这本书当模板库用,第 3 章够你抄半年。但它自己没解决那个矛盾:它一边说别写长,一边给了 230 屏长的;它一边把 API 说成「定制专属助手」的关键,一边只给了 10 屏。
抓取:微信读书《DeepSeek AI办公实战手册:10倍提升工作效率的方法与技巧》,614 屏,786 秒,7 章,102 条目录,读到书尾(reached_end=True)。
逐字核对 5 屏:p0006(前言末段:四大核心模块、六大职场领域、工具清单)· p0022(1.2.1 推理模型优缺点、周鸿祎引语、达芬奇四步推理示例)· p0026(图 1-5 深度思考(R1)与联网搜索开关、V3 为非推理模型的说明)· p0029(2 提示词核心原则两条、表 1-2 三行对照)· p0452(第 5 章章首页导语)
说明:各章篇幅由 pages.jsonl 逐页章节映射全量聚合(第 1 章 31 屏 5.0%、第 2 章 74 屏 12.1%、第 3 章 156 屏 25.4%、第 4 章 177 屏 28.8%、第 5 章 11 屏 1.8%、第 6 章 122 屏 19.9%、第 7 章 30 屏 4.9%,前置 13 屏,合计 614 屏);「230 屏模板」= 第 2 章 74 屏 + 第 3 章 156 屏,合计 230 屏、占 37.5%;目录 102 条为 meta.json 全量计数 · 笔记与图谱生成于 2026-11-10
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。 看完整履历海报 → skills 实验室 →
发表评论: